



November 6, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
Muse Sparkは、Meta Superintelligence Labsが提供する初のモデルファミリーであり、Llamaシリーズ(Meta AI)の後継として2026年4月8日に発表されました。バージョン1.3は3回目のイテレーションであり、Metaのドキュメントによると、新規プロジェクトで推奨されるデフォルトモデルとなっています。
2026年9月時点のMeta Model APIモデルページおよび価格ページに基づく仕様は以下の通りです。
特に注目すべき点が3つあります。
オープンウェイトモデルではありません。 これは多くの人が誤解している点ですが、Metaが長年「オープンウェイトの会社」であったことが一因です。Muse Spark 1.3はAPI経由でのみ提供されます。Meta自身のリリースノートの最後には、将来の項目として「Muse Sparkのオープンウェイトリリース」が挙げられており、現時点ではまだ実現していないことが明記されています。現在ダウンロード可能なMetaのウェイトが必要な場合は、以下のモデルをご利用ください。 Muse Glimmer:30Bパラメータ、高密度マルチモーダル、デフォルトコンテキスト128K、Apache 2.0ライセンス。Muse Sparkから蒸留されたモデル(Muse Glimmerドキュメント参照)です。真に寛容なライセンスを持つ、はるかに小規模なモデルであり、両者を混同しないよう注意してください。
1.3では特に音声処理の性能が低下しています。 Metaのモデルページの脚注には、1.3における音声理解は「現在完全にはサポートされていない」ため応答品質が低下する可能性があると記載されており、代わりに1.2または専用のMuse Voice Transcribeモデルの使用が推奨されています。ポイントリリースでこのような性能低下を認めるのは異例であり、音声データをパイプラインに組み込んでいる場合は注意が必要です。
コンテキストウィンドウは一律料金です。 1,048,576トークンまで、Metaの言葉を借りれば「ロングコンテキストによる追加料金なし」で利用可能です。ウィンドウがほぼ空の状態でも満杯に近い状態でも、トークンあたりの料金は変わりません。多くのプロバイダーが一定の閾値を超えると料金を引き上げる中、本モデルはそのような設定を採用していません。
[スクリーンショット:Meta Model API — muse-spark-1.3モデルのエントリとティア選択が表示されたdev.meta.aiダッシュボード]
Metaは1.3を機能の大幅な向上というよりも、ユーザビリティの改善と位置づけており、公開された差分データもその解釈を裏付けています。
出典:Introducing Muse Spark 1.3, Meta AI Research, 2026年9月2日。
効率性の数値は直接的な商業的影響をもたらします。同じ作業でトークン数が25%削減されれば、ルーティングの判断以前にコストが25%削減されることになります。ただし、これはMetaの社内エンジニアリングによる比較であり、第三者による再現ではない点に留意してください。方向性はほぼ間違いなく正しいと言えますが、実際のワークロードにおける効果はご自身で測定する必要があります。
挙動の変化こそが、実はより興味深い側面です。取り返しのつかない操作を行う前に確認を求め、行き詰まったときにはそれを認めるモデルは、自信満々に突き進むモデルとは運用上の性質が異なります。誤ったツール呼び出しが金銭的損失につながるような長期的なエージェント実行においては、ベンチマークのスコア以上に価値のある改善と言えるでしょう。
Metaは、Muse Spark 1.3と、Muse Spark 1.2、GPT-5.6 Sol、Claude Opus 5を比較したベンチマークスコアカードを公開しました。評価対象は、エージェント機能、コーディング、指示追従、長文コンテキストです。Metaの評価手法レポートによると、そのスイートは以下の通りです。
個別のスコアは [VERIFY] です。 Metaはこれらのスコアをリリース記事内の画像としてのみ公開しており、機械可読なテキスト形式では提供していません。そのため、本記事では正確に引用できない数値を書き起こすことはしません。数値を引用する際は、必ずMetaのページにあるスコアカードから直接取得してください。
いずれにせよ、手法レポートのテキストで語られている内容の方がスコアよりも有用であり、数値を引用する際には以下の3つの注意点を考慮すべきです。
比較は異なる努力レベル(effort levels)で行われました。 Muse Spark 1.3、Opus 5、GPT-5.6 Solは「最大推論努力(max reasoning effort)」で評価されましたが、Muse Spark 1.2は「xhigh」で評価されました。したがって、1.2から1.3への差の一部は設定の違いによるものであり、純粋なモデルの性能差ではありません。
OSWorldの比較はバージョンが一致していません。 Muse Spark 1.2を除き、すべてのモデルはOSWorld 2.0のバージョン08.08で評価されましたが、Muse Spark 1.2のみバージョン06.24で実行されました。Metaはこの点を明確に開示しており、その姿勢は評価できますが、この特定の項目については単純比較ができないことを意味します。
スコアは「ソース内ベスト」です。 Metaは「評価、公式リーダーボード、またはモデル提供者が自己報告した結果から得られる、比較可能な最高の主要指標値」を報告しています。すべてのモデルの各項目において利用可能な最良の数値を用いるのは妥当な手法ですが、単一の制御された環境下での実行結果ではありません。
Metaは自社の競合テストの限界についても異例の率直さを見せており、その実行結果は「独自モデル向けに調整されておらず、各提供者が最適化した最高のパフォーマンスを反映していない可能性がある」と注記しています。これは誠実な免責事項であり、ベンダーのスコアカード(本件を含む)を結果としてではなく、仮説の出発点として扱うべき正当な理由です。ルーティングの判断を確定させる唯一のベンチマークは、実際のプロンプトを用いた自社のトラフィックによる検証であり、導入を決定する前に独自の評価を行うべき理由もそこにあります。
Metaは2つのティアを提供しており、その価格差こそが本記事で最も重要な事実です。
出典:Meta Model APIの価格およびレート制限、2026年9月。
Contributorティアは、入力で92%、出力で95%安価に設定されています。Metaはこの取引について完全に透明性を保っており、大幅な割引トークンと引き換えに「プロンプトと補完結果を将来のMetaモデルのトレーニングに使用する許可」を求めています。モデルIDは muse-spark-1.3-contributor と muse-spark-1.3 のように明確に区別されているため、アカウント設定の奥深くではなく、呼び出し時に明示的に選択する形となっています。
この透明性は優れた慣行ですが、同時に特定の運用上のリスクも生じさせます。これについては後述します。
価格に関する2つの補足事項です。ウェブ検索グラウンディングはトークン料金とは別に1,000クエリあたり2.50ドルかかるため、web_searchツールを使用する場合は追加コストが発生します。また、最大推論(max reasoning)はStandardティアでのみ利用可能であり、安価なティアでは見出しのベンチマークを生み出したモードを利用できません。
以下の4つの失敗モードは、一般的なモデル導入に伴うものではなく、今回のリリース特有のものです。
Contributorティアは、設定を1行書き換えるだけでデータインシデントを引き起こしかねません。 92%の割引は、エンジニアがコスト削減の検討中に文の後半を読まずに適用してしまうような類のものですが、2つのモデルIDはサフィックスが1文字違うだけです。もし開発者が予算目標を達成するために本番環境のサービスをmuse-spark-1.3-contributorに向けてしまうと、顧客のプロンプトはMetaの学習データとして利用されることになり、アプリケーション上では何も変化がないように見えてしまいます。これはすべてのリポジトリで確実に対処できるわけではないため、中央で強制的に制御する必要があります。
レート制限はキーごとではなく、チームごとに適用されます。 Metaは、チーム内のすべてのキーが3,000 RPMおよび4M TPMの予算を共有することを明示しています。サービスごとにキーを発行しても容量を分割することはできないため、動作の悪いバッチジョブが1つあるだけで、対話型プロダクトの処理が停止してしまう可能性があります。Metaは、x-ratelimit-remaining-tokensヘッダーを読み取り、制限に達する前に速度を落とすよう推奨していますが、これはスタック内のどこかで実際にその制御を行う必要があることを意味します。
クローズドウェイトのモデルでは、データの保存場所に関する議論は早々に打ち切られます。 オープンウェイトのモデルであれば、どこで実行するかを議論できます。しかし、ここでは答えは1つ、プロンプトはMetaのAPIに送信されます。何が許容されるかは法務部門が決定しますが、重要なのは、Muse Glimmerには存在するセルフホスティングという逃げ道が、Muse Sparkには存在しないということです。
バージョンの入れ替わりは非常に高速です。 2026年4月から9月の間に3つのバージョンがリリースされ、1.2から1.3までの間隔は約4週間、さらにポイントリリースでは文書化された音声機能の回帰も発生しました。モデル名をハードコードしている統合は、計画サイクルが想定するよりも早く見直しが必要になるでしょう。それこそが、 仮想モデル名と段階的な切り替え の役割です。
クローズドモデルは、ゲートウェイの目的を変えます。オープンウェイトのリリースではゲートウェイの役割は移植性ですが、ここでは制御、帰属、そして方針を変更できる柔軟性が求められます。
ティアを単なる好みではなく、ポリシーとして設定してください。 Contributorに関する決定は、責任者が一度だけ行い、その後は強制適用されるべきです。ゲートウェイレベルでの ポリシー強制 により、muse-spark-1.3を本番サービスに公開しつつ、Contributorバリアントをサンドボックスに制限したり、完全にブロックしたりすることが可能になります。アプリケーションはモデル名をリクエストし、ゲートウェイがその解決先を決定します。
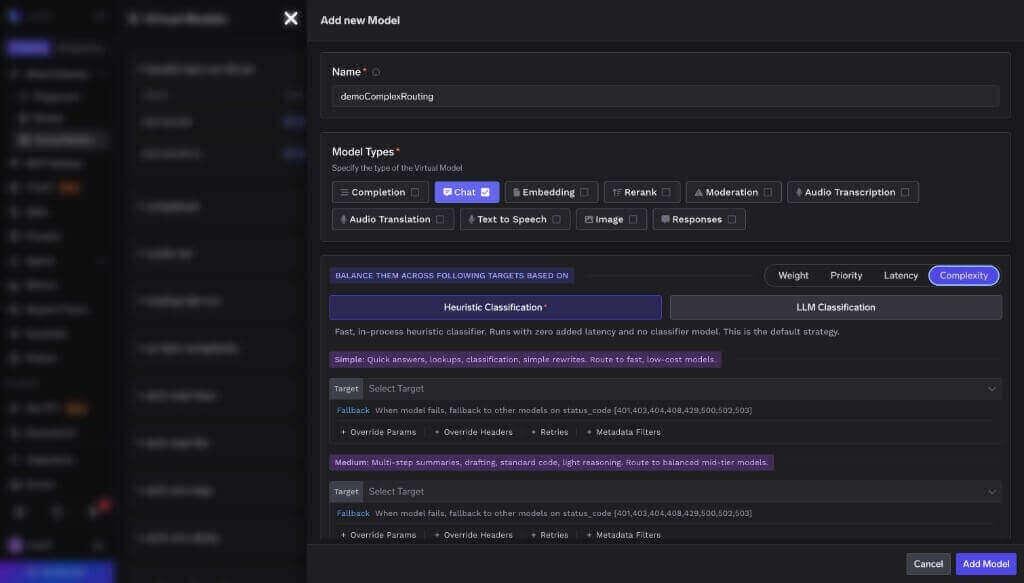
ベンダーへの忠誠心ではなく、タスクに基づいてルーティングしてください。 Meta自身のスコアカードでは、1.3はOpus 5やGPT-5.6 Solに対して、すべての面で勝っていると主張するのではなく、それらと競合する位置付けとなっており、これは複数のモデルを組み合わせた運用を支持する根拠となります。長期的なエージェント実行や100万トークンのコンテキスト処理はMuse Sparkに、その他の処理はより適したモデルに振り分けます。TrueFoundryの550のプロンプトを用いた自動ルーティングベンチマークでは、このようにリクエストをティア分けすることで、ベースラインの品質を98%維持しながらコストを69%削減し、平均レイテンシを7.6秒から4.0秒に短縮しました。本番環境に近いトラフィックでは、削減率は80%に達しました。
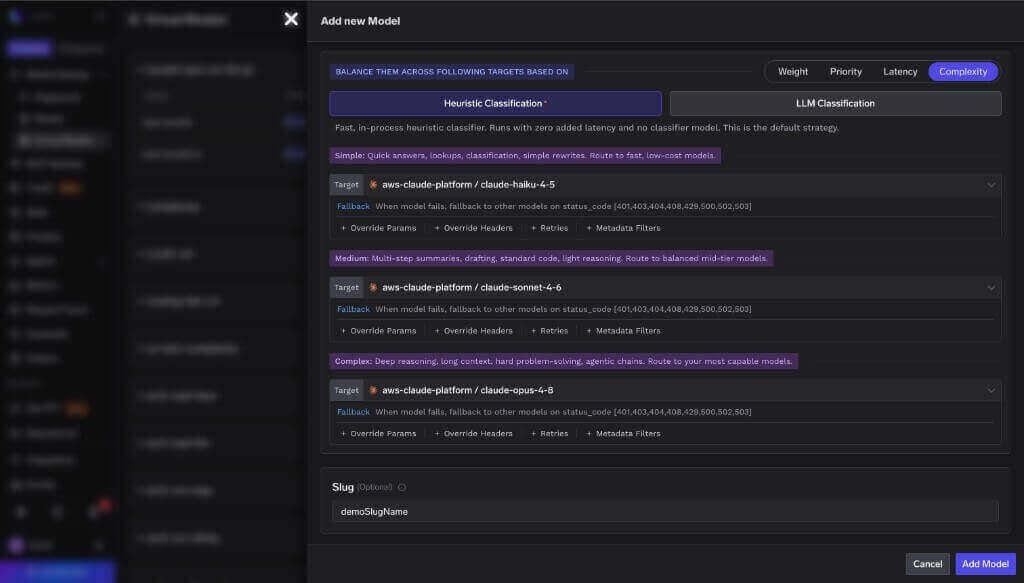
共有レート制限を吸収する。 Metaのクォータはチーム単位で設定されるため、ゲートウェイで管理するのが自然です。チームごとのレート制限、キューイング、そして 別のプロバイダーへのフェイルオーバー Metaから429エラーが返された際に行います。共有予算を一元管理するには、それを把握できる場所が一つ必要です。
独自のガードレールを維持する。 Metaは1.3でプロンプトインジェクションへの耐性が向上したと報告していますが、これは歓迎すべきことである一方、ユーザー自身が制御できるものではありません。ゲートウェイのガードレールは、どのプロバイダーが応答したかに関わらずリクエストとレスポンスの経路で実行されるため、モデルを変更してもポリシーは変わりません。

効率性の主張を検証する。 Metaは1.3で1.2よりもトークン消費量が約25%削減されたとしています。これを鵜呑みにするのではなく、チームごとのリクエスト単価やトークン使用量を追跡することで、実際のトラフィックでその効果を確認できます。

2026年9月時点での要約:

[SCREENSHOT: Muse Code — Muse Spark 1.3でのエージェント実行を示すターミナルセッション]
Muse Spark 1.3は、地味ながらも堅実なリリースであり、その「地味さ」こそが重要です。Metaは新たなフロンティアを謳うのではなく、ツール呼び出しの削減、トークン消費の抑制、長文スレッドでの挙動改善、そして不可逆的なアクションに対する判断力の向上を強調しました。これらは、エージェントの実行がスムーズに完了するか、あるいは無駄な時間を費やすかを左右する要素です。すでに複数のプロバイダーを使い分けているチームにとって、100万トークンのウィンドウを定額で提供するこのモデルは、長期的なエージェント作業における有力な第4の選択肢となります。
どこで劣るのかを冷静に見極める必要があります。ウェイトはクローズドであるため、オープンウェイトモデルの利点であるポータビリティやデータレジデンシーの議論は当てはまりません。もしMetaのオープンモデルを求めているのであれば、それはより小規模なMuse Glimmerです。今回のリリースでは音声機能が後退しました。また、主要なスコアは画像として公開されており、一部の設定が不一致な状態で測定された「ベストケース」の数値である点にも注意が必要です。さらに、最も安価に実行する方法は、プロンプトの提供を条件としています。
率直に結論を言えば、何を手元に残したいかという点に尽きます。Metaの最高性能モデルを使いたいのであれば、Metaの条件に従って利用することになります。ここで重要なのは、モデルを採用するかどうかではなく、ティアポリシーをどこで管理し、誰が変更権限を持つかという点です。チームが直接組み込む前にゲートウェイを導入しておけば、Muse Spark 1.3の追加は大規模な移行作業ではなく、設定変更だけで済むようになります。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.




Muse SparkはMeta Superintelligence Labsのモデルファミリーで、2026年4月8日に発表され、現在はMetaのLlamaシリーズの後継となっています。2026年9月2日にリリースされたMuse Spark 1.3が現行バージョンで、コンテキストウィンドウは1,048,576トークン、テキスト、画像、動画、PDFの入力に対応しています。
いいえ。Muse Spark 1.3はクローズドで、APIでのみ提供されています。Metaのリリース記事では、オープンウェイトでの公開は今後のロードマップ項目として挙げられています。現在利用できるMetaのオープンウェイトモデルはMuse Glimmerで、パラメータ数は300億、ライセンスはApache 2.0、Muse Sparkから蒸留されており、既定のコンテキストウィンドウは128Kです。
Standardティアでは、入力100万トークンあたり1.25ドル、キャッシュされた入力が0.15ドル、出力100万トークンあたり4.25ドルで、長いコンテキストに対する割増はありません。Contributorティアは入力0.10ドル、出力0.20ドルですが、プロンプトと生成結果を学習に利用することを許可する必要があります。
Metaは1.3を、Muse Spark 1.2、Claude Opus 5、GPT-5.6 Solと比較して、GDPVal-AA v2、JobBench、OSWorld 2.0、DeepSearchQA、AutomationBench、DeepSWE v1.1、SWE-Atlas Codebase QnA、Terminal-Bench 2.1、MRCR v2、および社内の指示追従指標で評価しています。個々のスコアはMetaのリリース記事内の画像でのみ公開されているため、二次的な報道ではなく、そちらで確認してください。
TrueFoundryのAI Gatewayが追加するのはおよそ3〜4ミリ秒で、1 vCPUで350 RPS以上を処理できます。数秒かかる生成時間と比べれば、無視できる水準です。
いいえ。上記のベンチマークのばらつきが、その反証です。オープンモデルとクローズドモデルをタスクの種類に応じてルーティングするほうが、1つに標準化するよりも通常は安く、結果も良くなります。






















