



November 16, 2026
|
5 min read


Updated: November 3, 2026
Published: July 2, 2026

Blazingly fast way to build, track and deploy your models!
大規模言語モデル(LLM)の選択は、1〜2年前よりも遥かに複雑になっています。頻繁に新しいモデルがリリースされ、既存のモデルは大規模なアップグレードを受け、それぞれがより優れた推論、迅速な応答、より大きなコンテキストウィンドウ、または低コストを提供すると主張しています。選択肢が増えるのは良いことですが、適切なモデルを選択することが極めて困難になっています。
現実には、すべてにおいて優れている単一のLLMは存在しません。コーディングで非常に優れたパフォーマンスを発揮するモデルが、カスタマーサポートにおいて最も費用対効果が高いとは限らないのです。別のモデルは推論に優れているかもしれませんが、レイテンシやツール呼び出しに関しては物足りないかもしれません。そのため、ベンチマークスコアや評判だけに頼るのでは不十分です。
ここで重要になるのがLLM機能比較です。「どのモデルが最も優れているか?」と尋ねる代わりに、「自分のユースケースに最も適したモデルはどれか?」と問う方が適切です。
このガイドでは、LLM機能とは何か、どのように比較すべきか、そしてなぜそれを比較することが重要なのかについて説明します。
LLM機能とは、大規模言語モデルができることや、タスクをどの程度うまく実行できるかを決定する個々の能力のことです。LLMは言語を理解して生成するように設計されていますが、その機能はトレーニング方法、トレーニング中に使用されたデータ、および基礎となるアーキテクチャによって異なります。
LLM機能比較は単なる技術的な作業ではなく、アプリケーションを本番環境に移行する前にリスクを軽減するための方法です。モデルが今日の機能要件を満たし、拡張に合わせてアプリケーションをサポートし続けられるかどうかを検証するのに役立ちます。
開発の途中で制限に気づく代わりに、早期にそれらを特定し、情報に基づいたトレードオフを行うことができます。
機能比較によって達成できることは以下の通りです。
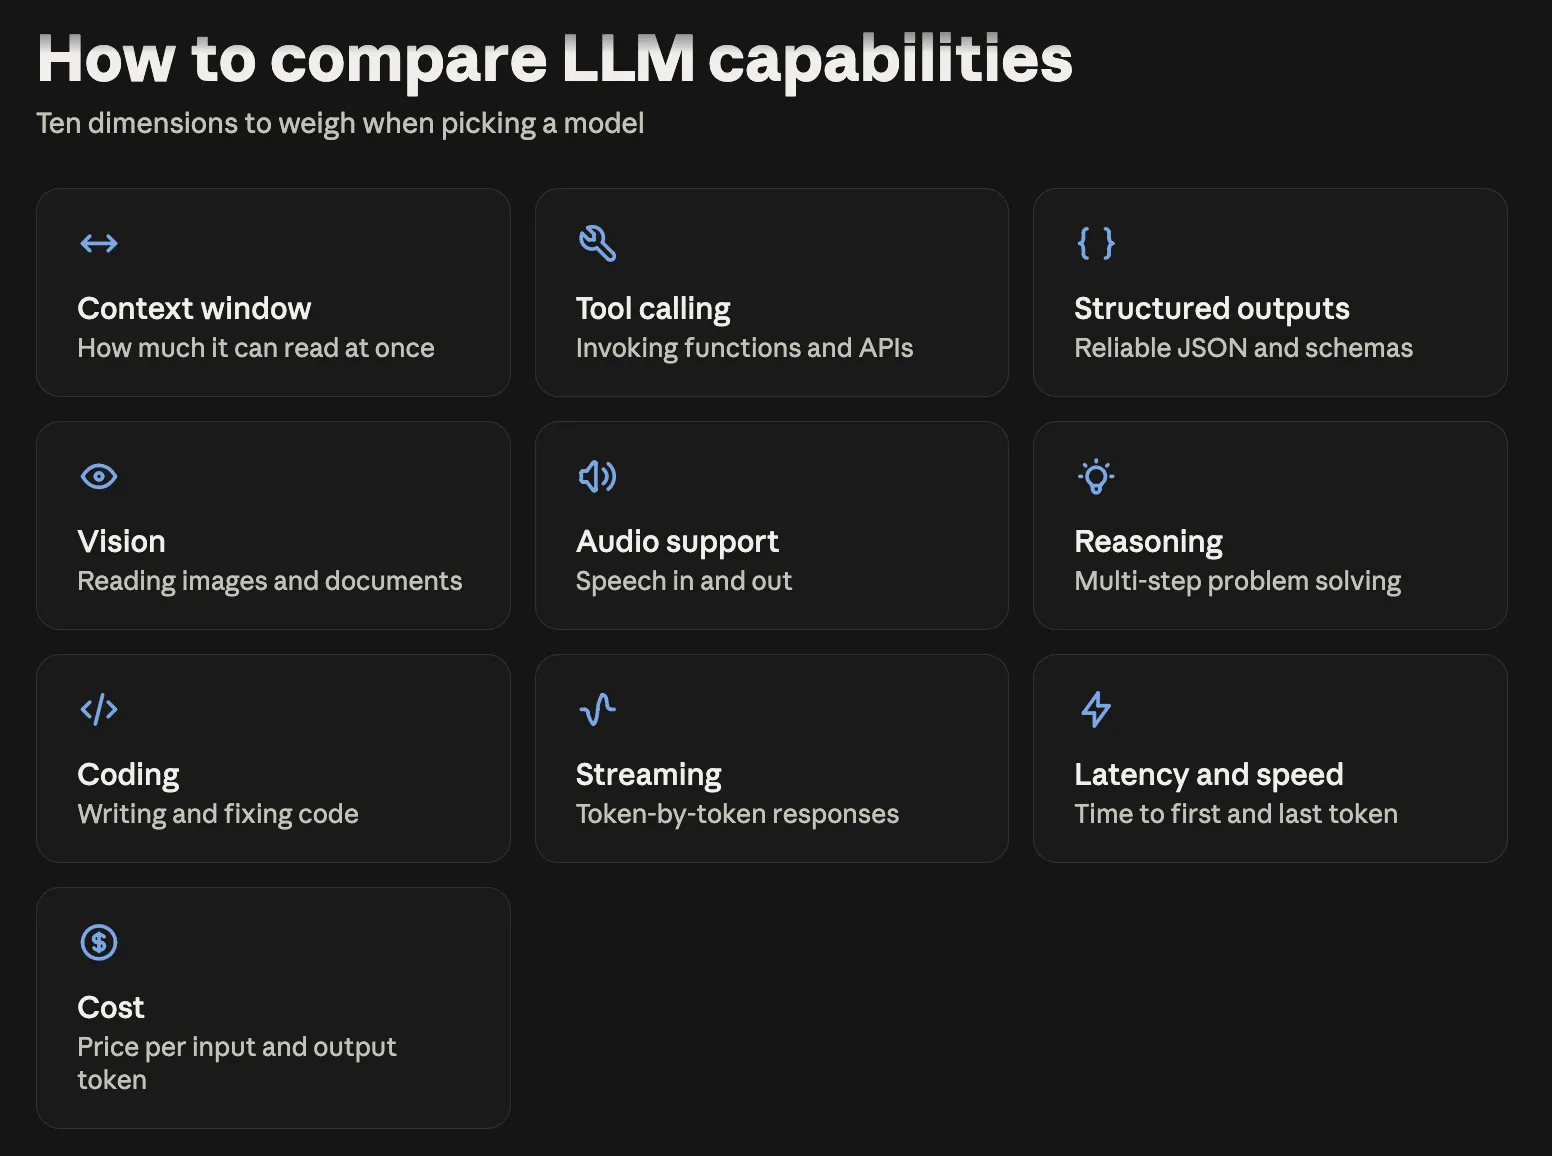
効果的なLLM機能比較は、アプリケーションに直接影響を与える機能に焦点を当てます。ベンチマークスコアだけに頼るのではなく、モデルがユースケースで必要とされる機能をサポートしているかどうかを評価してください。
各モデルがアプリケーション要件にどれだけ適合しているかを理解するために、以下の機能を比較してください。
コンテキストウィンドウが大きいほど、モデルは単一のリクエストで長いドキュメント、会話、またはコードベースを処理できるようになります。サポートされているコンテキスト長と、より大きな入力でのパフォーマンスの両方を比較してください。
ツール呼び出しにより、LLMはAPI、データベース、その他の外部システムと相互作用できるようになります。モデルがこれらのアクションをどれほど確実に実行できるかを評価します。
アプリケーションがJSONなどのフォーマットに依存している場合は、モデルが構造化されたスキーマ準拠の応答をどれだけ一貫して生成できるかを比較します。
ビジョン対応モデルは、画像、PDF、グラフ、スクリーンショットを分析できます。サポートされている入力タイプと視覚的理解の品質を確認してください。
音声ベースのアプリケーションの場合は、モデルが音声入力、文字起こし、または音声生成をサポートしているかどうかを比較します。
推論機能は、モデルがマルチステップの分析、計画、および問題解決をどれだけ適切に処理できるかを決定します。実際のワークロードに似たタスクを使用してテストしてください。
開発者ツールを構築している場合は、モデルがさまざまな言語にわたってコードをどれだけ適切に生成、説明、およびデバッグできるかを評価します。
ストリーミングは生成された応答を逐次返すため、チャットボットやその他のリアルタイムアプリケーションの応答性が向上します。
インタラクティブな体験には低レイテンシが不可欠です。公表されている数値だけに頼るのではなく、現実的なワークロードの下での応答時間を比較してください。
トークン価格設定をパフォーマンスとともに考慮し、予期される使用量に対してモデルの費用対効果が高いかどうかを判断します。
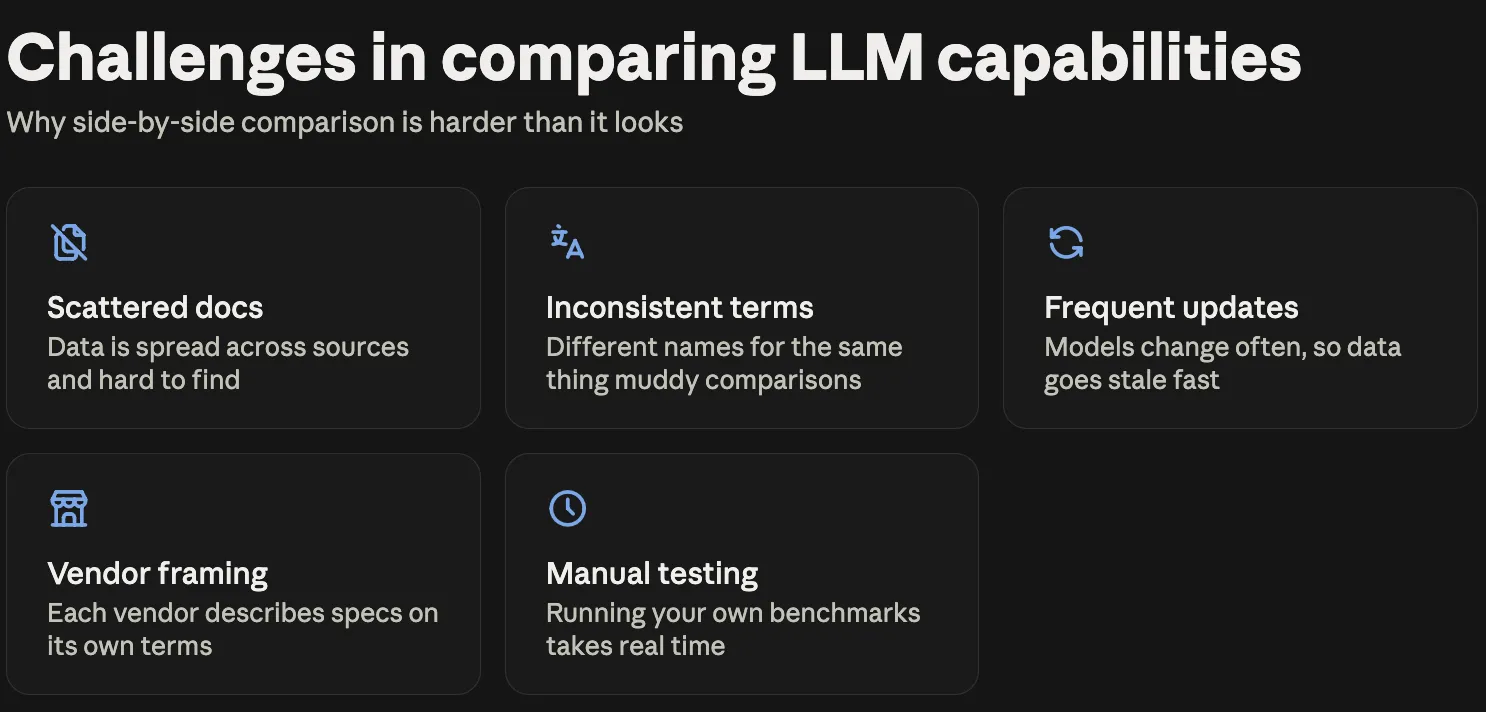
LLM機能の評価は、見た目以上に困難です。ドキュメント標準の相違や頻繁なモデルのアップデートにより、正確な比較を行うことが難しくなっています。
重要な機能が判明したら、それらをモデル間で比較する簡単な方法が必要になります。さまざまなプロバイダーからのドキュメントを検索する代わりに、モデルプロファイルを使用して標準化された単一の形式で情報を取得できます。
モデルプロファイルは、LLMの機能カードのようなものだと考えてください。ドキュメントを読み込んだり、モデルが何に対応しているかを推測したりする代わりに、標準化された形式でその機能を閲覧できます。
モデルプロファイルには、コンテキストウィンドウ、ツール呼び出し、構造化出力、ビジョンサポート、オーディオ機能、およびLLM機能比較で重要となるその他の主要な機能などの情報が含まれます。すべてのモデルが同じ構造に従っているため、プロバイダーを並べて比較することが遥かに容易になります。
データは、OpenAI、Anthropic、Googleなどのプロバイダーのモデル全体の機能を追跡するオープンソースプロジェクトであるmodels.devから提供されます。これらのプロファイルはLangChainパッケージを通じて利用可能であり、開発者はコード内で機能情報に一貫した方法でアクセスできます。
あるモデルがビジョンをサポートしていることを読み、それに基づいて画像分析機能を構築したとします。数週間後、ビジョンサポートはプレビューリリースでのみ利用可能であったか、特定のAPI構成が必要であったことが判明します。突然、実装が機能しなくなります。バグのためではなく、機能のミスマッチが原因です。
あるいは、新しいプロジェクトのために5つの異なるモデルを比較しているケースもあります。複数のプロバイダーのドキュメントを開き、スプレッドシートを作成し、ツール呼び出し、ファンクション呼び出し、API統合といった用語がすべて同じ機能を指しているのかを判断しようとします。やがて、モデルを比較すること自体が、評価するよりも時間がかかるようになってしまいます。
モデルプロファイルは、このような事態を回避するのに役立ちます。ベンダー固有のドキュメントを翻訳する代わりに、各モデルがサポートしている内容の標準化されたビューが得られます。機能を使用する前にアプリケーションがプログラムで機能をチェックすることもできるため、開発中の予期せぬトラブルが減り、LLM機能比較がより迅速かつ一貫性のある、信頼性の高いものになります。
LLMの選択には、ドキュメントページ間の多くの往復が伴うことがよくあります。モデルプロファイルは、各モデルができることのクイックビューを提供することでこれを簡素化します。
LLMの選択は、多くの場合長い疑問のリストから始まります。ツール呼び出しに対応しているか?どのくらいのコンテキストを処理できるか?画像を処理できるか?複数のプロバイダーにわたってこれらの回答を見つけるには、多大な時間がかかる可能性があります。
モデルプロファイルを使用すると、開発者は必要な機能に基づいてモデルをすばやくフィルタリングできます。たとえば、カスタマーサポートボットを構築しているチームは、注文の照会用にツール呼び出しをサポートし、進行中の会話に対して十分なコンテキスト容量を持つモデルを迅速にチェックできます。これにより、基本機能の検証ではなく、モデルのパフォーマンスのテストにより多くの時間を費やすことができます。
現代のアプリケーションは、異なるタスクに複数のモデルを使用することがよくあります。あるモデルが複雑な推論を処理し、別のモデルがより低いコストで単純なリクエストを管理する場合があります。
モデルプロファイルを使用すると、リクエストを送信する前に、モデルが必要な機能をサポートしているかどうかをアプリケーションが確認できます。これにより、必要に応じてモデル間を切り替えることができ、予期しないエラーを発生させることなく変更を処理できるシステムを構築しやすくなります。
多くのチームは、信頼性が高く使い慣れているという理由で、最も強力なモデルをデフォルトで使用しています。しかし、すべてのタスクに最高機能のモデルが必要なわけではありません。
モデルプロファイルを比較することで、開発者はアプリケーションが必要とする機能をサポートしながらも、より小規模でコスト効率の高いモデルを特定できます。これにより、チームはさまざまなワークロードに必要なパフォーマンスを維持しながら、コストを最適化できます。
モデルプロファイルは、コードを書く開発者だけでなく、AI導入に関する決定を下すチームにとっても有用です。モデル機能の標準化されたビューを提供することにより、エンジニアリングチームがより信頼性の高いアプリケーションを構築し、プロダクトチームが選択肢をより迅速に評価するのに役立ちます。
モデルプロファイルはLLMの比較を容易にしますが、それが最終的な答えではありません。モデルが何をサポートしているかは示されますが、独自の特定のユースケースに対するパフォーマンス、コスト、適合性を評価する必要があります。
比較のためにモデルプロファイルを使用する際は、以下の制限事項に留意してください。
構造化されたアプローチにより、LLMの比較がより効果的になります。人気やベンチマークスコアだけでモデルを選択するのではなく、アプリケーションのニーズにどれだけ適合するかに重点を置きます。以下のプラクティスは、これらの要件に対してモデルを評価するのに役立ちます。
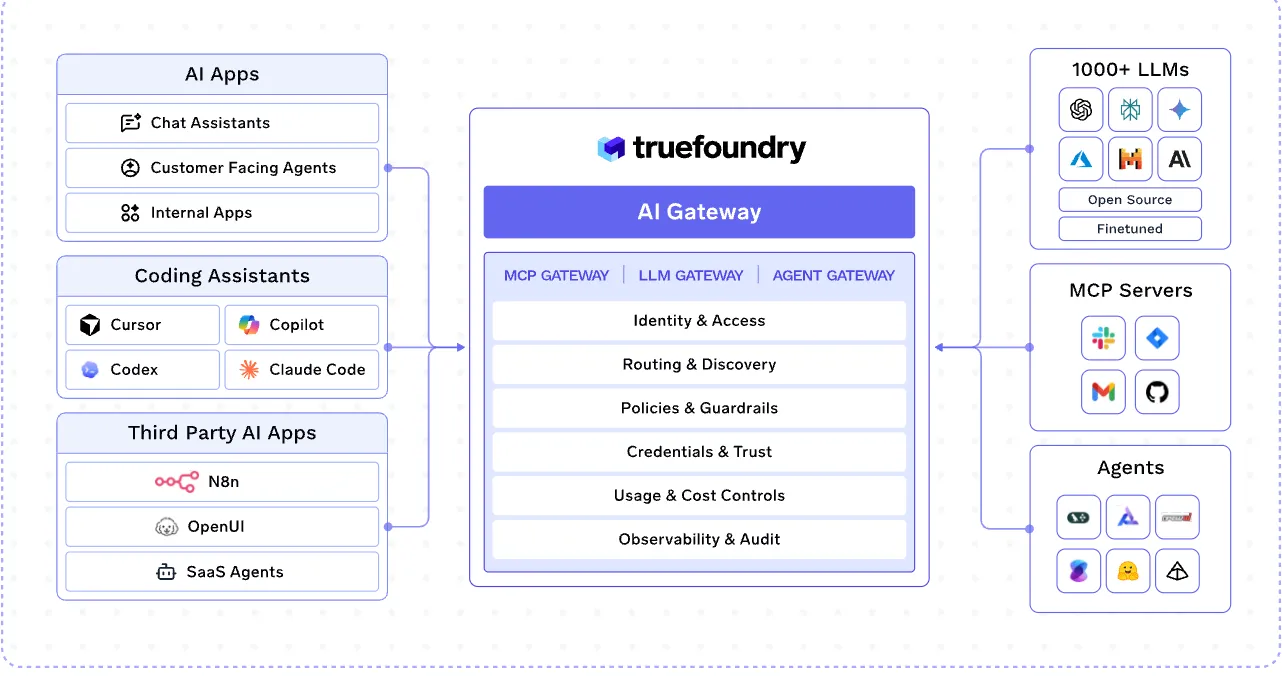
手動でのLLMの比較は、すぐに時間のかかるプロセスになりがちです。決定を下す前に、さまざまなプロバイダーのWebサイトを確認し、多様な機能説明を理解し、独自の比較フレームワークを作成しなければなりません。
TrueFoundryのModel Comparisonアプリは、LLM機能を単一の標準化されたビューにまとめることで、このプロセスを簡素化します。TrueFoundry AI Gatewayを搭載しており、OpenAI、Anthropic、Googleなどのプロバイダーのモデルを、コンテキストウィンドウ、ツール呼び出し、ビジョンサポート、構造化出力などの重要な機能にわたって比較できます。
このツールを使用すると、以下のことが可能です。
独自の比較スプレッドシートを維持する代わりに、Model Comparisonアプリを使用して、アプリケーションが実際に必要とする機能によってモデルを絞り込みましょう。
LLMの環境はかつてないほど急速に変化しており、モデルを評価する方法もそれに合わせて進化する必要があります。あるワークロードで機能するモデルが、別のワークロードで同じ結果をもたらすとは限りません。そのため、柔軟性と継続的な評価が長期的なAIの成功に重要となります。
最新のモデルリリースを追いかけるのではなく、新しい機能、プロバイダー、ユースケースが登場した際に適応できるAIシステムの構築に焦点を当ててください。最終的に適切なLLMの選択とは、目標をサポートし、運用上のニーズに適合し、時間をかけて一貫した価値を提供するものになります。
モデルの選択肢を絞り込む準備はできていますか?Model Comparisonアプリをお試しいただき、1つの標準化されたビューでプロバイダー全体のLLM機能を比較してください。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























