



November 6, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
DeepSeek-V4-Proは2026年4月24日にプレビューに入り、4か月足らずの2026年8月13日に一般提供(GA)が開始されました。APIのモデル名は変更されておらず、依然としてdeepseek-v4-proを呼び出します。GAビルドはその背後にあるプレビュー版を単純に置き換えた形となります。
2026年9月時点のDeepSeekのModels & PricingページおよびGA model cardからの仕様は以下の通りです:
パラメータ数以上に重要な細部が2つあります。
第1に、ウェイトが真にオープンである点です。GAのチェックポイントはdeepseek-ai/DeepSeek-V4-Pro-0813にてMITライセンスの下で公開されています。収益制限や利用分野の制限が付いた独自のコミュニティライセンスではありません。MITはこれ以上ないほど寛容なライセンスです。この単一の事実こそが、本記事の残りの部分を執筆する価値のあるものにしています。
第2に、効率化への取り組みがアーキテクチャ上の核心である点です。プレビュー版のmodel cardには、Compressed Sparse AttentionとHeavily Compressed Attentionを組み合わせたハイブリッドアテンション設計が記載されており、1Mトークンのコンテキストにおいて、V4-ProはDeepSeek-V3.2と比較して単一トークン推論FLOPsの約27%、KVキャッシュの約10%しか必要としないと報告されています。ここでは長文コンテキストがコストを抑えて提供可能となっており、これはV3世代にはなかった特徴です。まさにこの点が、セルフホスティングの経済性計算を興味深いものにしています。
[SCREENSHOT: DeepSeek chat — appおよびwebでV4-ProにルーティングするExpert Modeセレクター]
DeepSeekはこの点について極めて率直です。GAのモデルカードには、V4-Pro-0813が「DeepSeek-V4-Pro (Preview)のモデル構造をベースに構築され、DSpark投機的デコーディングモジュールが追加されている」と記載されています。つまり、ベースモデルは同じであり、事後トレーニング(post-training)とデコーディングパスが変更されています。
公開されているプレビューからGAへの変更差分は以下の通りです:
出典:DeepSeek-V4-Pro-0813 model card(2026年9月)
これらの読み方について1つ注意点があります。DeepSeekは、コードエージェントのスコアが独自のDeepSeek Harnessを使用してミニマルモード、max reasoning effort、temperature = 1.0、top_p = 0.95で測定されたものであると注記しています。DeepSWEでの5倍近い跳ね上がりは、ベンダー独自のハーネスの下で測定された事後トレーニングの結果であり、第三者による再現実験ではありません。方向性が本物であることは明らかですが、その伸び幅についてはご自身での評価(eval)が必要です。
モデルと並行して、GAではワンクリックのCodex構成を備えたネイティブのOpenAI Responses APIサポートが追加され、バイナリの思考切り替えに代わる3段階のreasoning_effortコントロールが導入されました。
GAのモデルカードには、オープンおよびクローズドの競合他社との直接比較表が掲載されています。以下は誰もが引用する部分と、ほとんどの記事が取り上げない部分です。
出典:DeepSeek-V4-Pro-0813 model card(2026年9月)
V4-Proが優れている点。 ターミナル型の能力を発揮するエージェント作業やセキュリティ領域のコーディングです。Terminal Bench 2.1、DeepSWE、Cybergym、AutomationBenchにおいてOpus-4.8を上回っています。ダウンロード可能なモデルとして、これは真の実力と言えます。
クローズドモデルが依然として勝っている点。 純粋な知識領域や、より高度なリポジトリ操作のタスクです。Opus-4.8はNL2Repoで8ポイント以上の差をつけて勝利しており、DSBench-Hard、Toolathlon-Verified、ツールなしのHLEでもリードしています。フォールバックありのFable-5も同様の領域で大半をリードしています。ワークロードが複数ファイルに及ぶ難度の高いリポジトリ変更や広範な知識問答によって占められている場合、フロンティアなクローズドモデルの方が依然として優れており、いくらライセンスに熱狂してもその事実は変わりません。
他のオープンモデルの立ち位置。 Kimi K3はTerminal Bench 2.1とDeepSWEでV4-Proをわずかに上回っています。「最高のオープンウェイトモデル」がどれであるかは議論の最中にあり、決定していません。ここでの興味深い主張はより限定的かつ持続的なものです。つまり、ダウンロード可能なモデルがフロンティアに十分に近づいたため、デプロイの選択肢が現実的な検討課題になったということです。
DeepSeekはGAに合わせてピーク時およびオフピーク時の課金を導入し、2026年8月16日16:00 UTCより適用を開始しました。オフピーク料金はピーク料金のちょうど半分です。ピーク時間帯は月曜日から金曜日(中国の祝日を除く)の01:00〜04:00および06:00〜10:00 UTCであり、週末を含むそれ以外のすべての時間帯がオフピークとなります。
出典:DeepSeek Models & Pricing(2026年9月)
注目すべき点が3つあります。キャッシュヒット時の価格はキャッシュミス時の30分の1であるため、安定したシステムプロンプトを持つ運用ではプロンプト構造が極めて重要になります。ピーク/オフピークの分割は割引というよりもスケジューリングのレバーとして機能し、バッチ処理をオフピークに移動させるだけで請求額が半減します。また、DeepSeekはGA時にプレビュー時よりも値上げを行いましたが、プレビュー時の公開料金は[VERIFY]状態です(すでに価格設定ページには掲載されておらず、二次情報からの引用は控えます)。
運用上の注意点として、deepseek-v4-proのAPI並列処理上限は500です。またDeepSeekは2026年9月10日に、2026年9月14日以降も請求設定を変更せずにV4 Pro APIの提供を継続することを確認しました(変更 履歴)。
[SCREENSHOT: DeepSeek Platform — ピーク時 vs オフピーク時のトークン消費額を示す利用状況ダッシュボード]
オープンウェイトのフロンティアモデルでは4つの失敗パターンが繰り返し発生しますが、V4-Proにはその4つすべてが当てはまります。
セルフホスティングの費用はGPU単体ではなくノード単位である。 モデルカードにあるDeepSeekのリファレンス提供コマンドは、vLLMを介した単一の4ノードGB300構成をターゲットとしており、FP8 KVキャッシュ、Expert Parallelism、DSpark投機的デコーディングが有効化されています。1.7TパラメータのMoEは、余っているA100で手軽に起動できるようなものではありません。オープンウェイトはセルフホスティングという選択肢を提供するものであり、その経済計算が出力100万トークンあたり$1.98を下回るかどうかは、完全に稼働率に依存します。相当高い定常負荷を下回る場合、APIの方がコスト面で勝利します。
Chat Templateが存在しない。 GAリリースにはJinjaのチャットテンプレートが同梱されていません。代わりにDeepSeekは、OpenAI形式のメッセージをモデルへの入力に変換し、出力を逆パースするためのPythonスクリプトで構成されたエンコーディングフォルダを提供しています。スタック内でtokenizer.apply_chat_templateを前提としている部分は修正が必要になります。
V4-ProにはVision機能がない。 Vision機能はProではなくFlashラインに存在します。マルチモーダルを前提とした単一モデル戦略はここで破綻するため、計画的であったかどうかに関わらず、少なくとも2つ以上のモデル間でルーティングを行うことになります。
データ所在地とAPIの利用は別の決断である。 api.deepseek.comにプロンプトを送信することと、ご自身のVPC内で同じウェイトを実行することは、データフローの観点から全く異なる問いとなります。チームは「DeepSeek V4を使用できる」ことと「DeepSeek APIを呼び出せる」ことを混同しがちですが、セキュリティレビューではそれぞれ異なる回答が出されます。何が許容されるかは貴社の法務判断によりますが、重要なのはオープンウェイトによって両方の運用パスが技術的に利用可能になるという点です。
オープンウェイトのフロンティアモデルが経済性をもたらすのは、それを実際にどこかに配置できる場合のみです。まさにその部分をTrueFoundryが担います。
ご自身のVPC内でセルフホスト。 AI Gatewayは、ホスト型プロバイダーと並んでセルフホスト型オープンウェイトモデルを登録します。vLLMまたはSGLangを使用して独自のKubernetes上にV4-Proをデプロイし、ゲートウェイをエンドポイントに向けることで、他のAPIモデルと同じルーティング、レート制限、コスト追跡、可観測性を備えた形でモデルカタログに表示されます(セルフホスト型モデルドキュメント)。vLLMとSGLangはどちらもデフォルトでOpenAI互換のAPIを提供するターンキー仕様となっているため、ゲートウェイ側でDeepSeek専用のアダプターを用意する必要はありません。
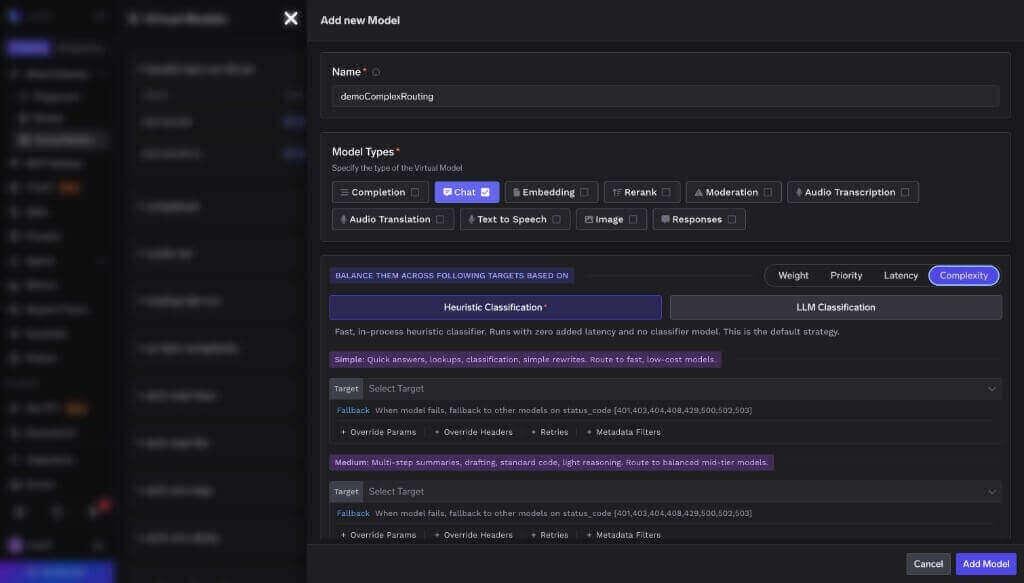
TrueFoundry AI Gatewayモデルカタログへのセルフホスト型モデルの追加
または、APIを呼び出しつつ将来の選択肢を保持。 まだセルフホストの準備ができていない場合は、ゲートウェイ経由でDeepSeekのAPIにルーティングし、後からセルフホストデプロイに移行する際と同じ呼び出しパスを維持します。ホスト型エンドポイントからご自身のクラスターへの切り替えは、アプリケーションの書き換えではなく設定の変更だけで完了します。
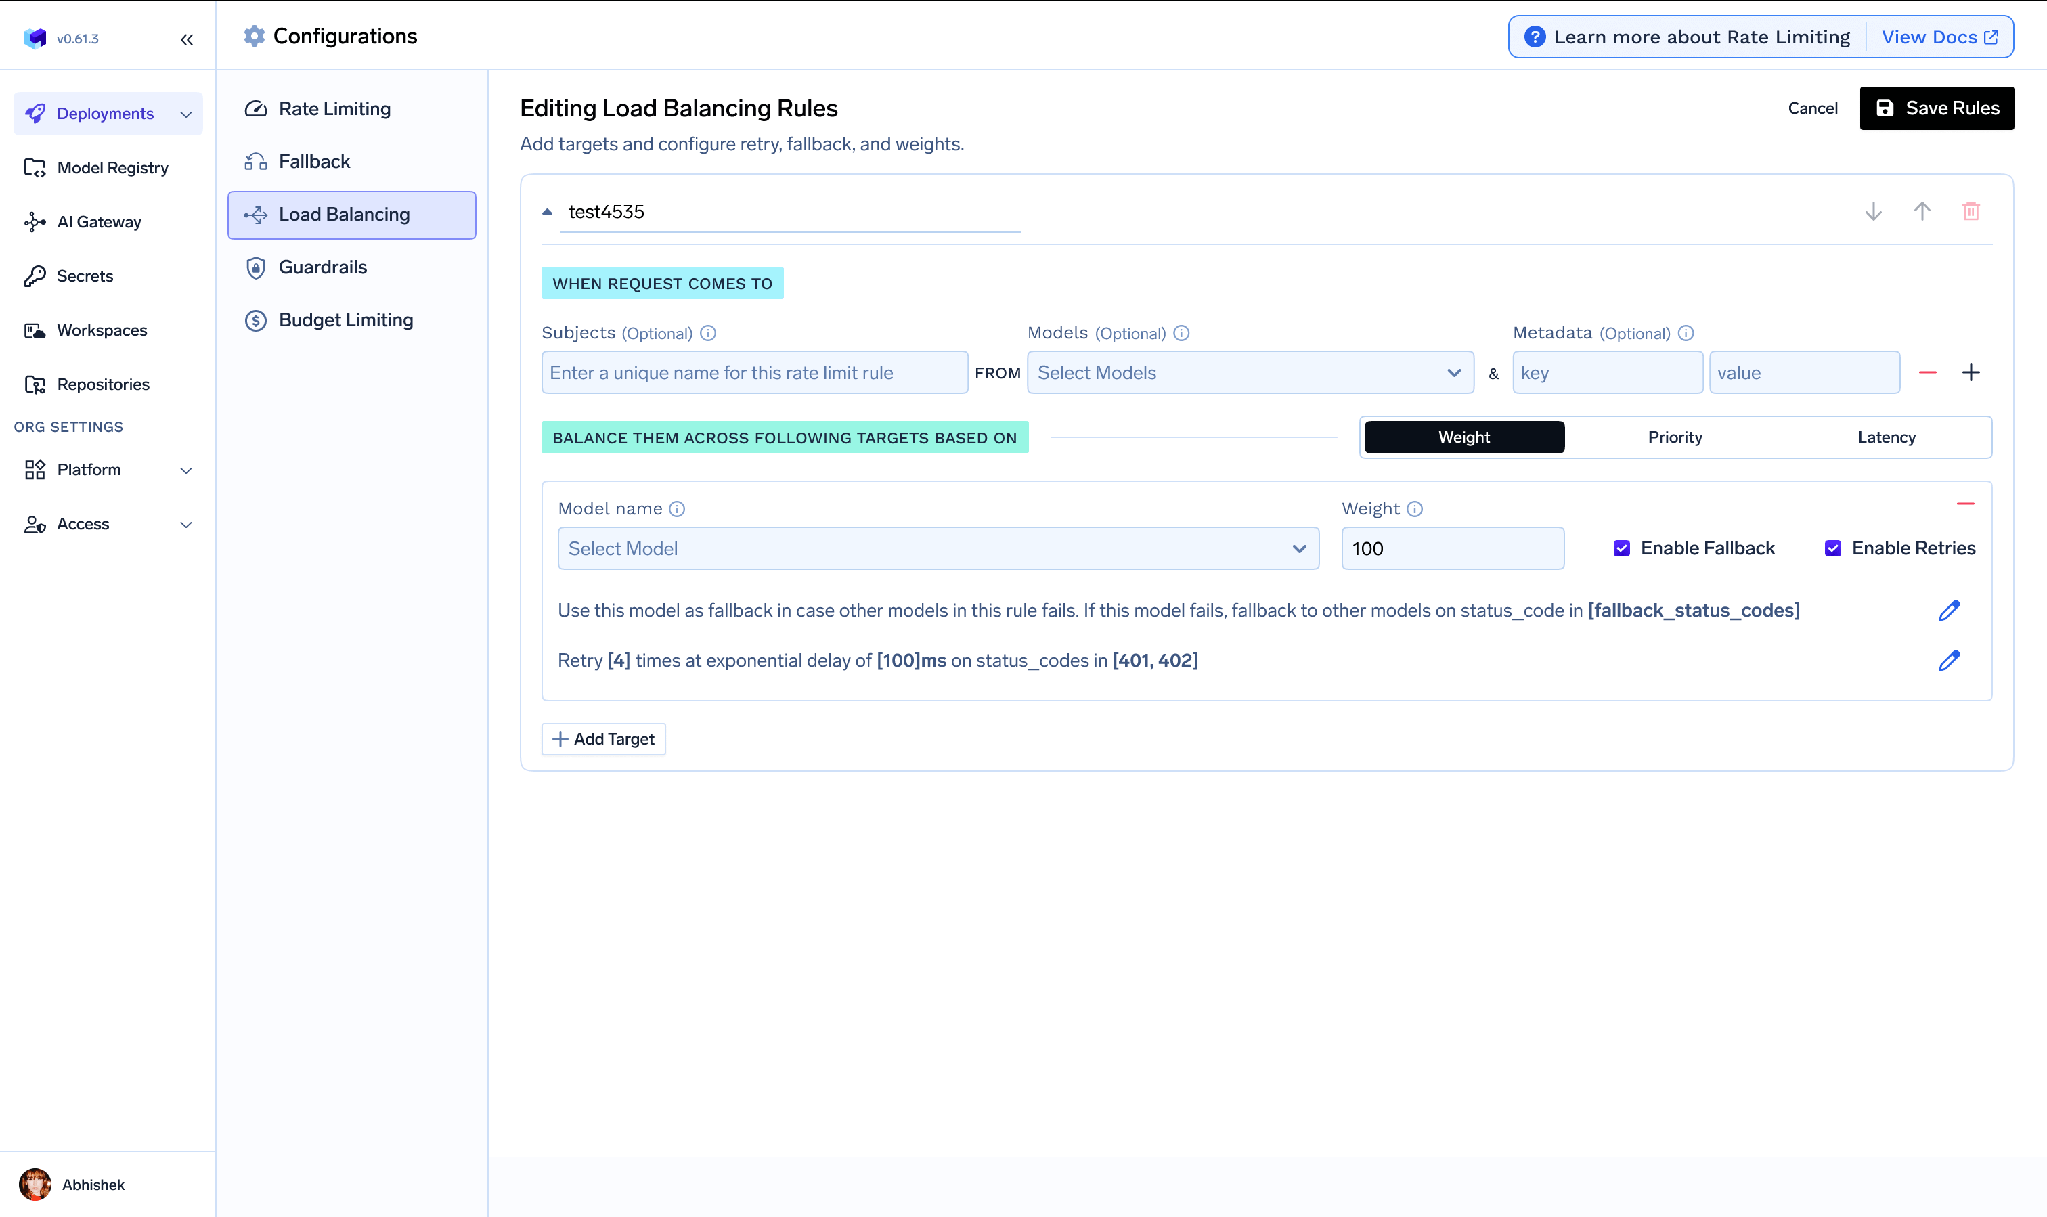
TrueFoundry AI Gatewayにおけるルーティング構成
習慣ではなく複雑さに基づいてルーティング。 上記のベンチマーク表は完全な移行ではなく、マルチモデル運用の正当性を提示するものであり、コストおよび品質を考慮したルーティングこそがそれを実践する方法です。難度の高いリポジトリ作業はOpus-4.8へ、ターミナル型のエージェント実行はV4-Proへ、分類や抽出はより安価なモデルへ振り分けます。550個のプロンプトを使用したTrueFoundry独自のAuto Routingベンチマークでは、リクエストの層別化によりベースラインの品質を98%維持しながらコストを69%削減し、平均レイテンシは7.6秒から4.0秒へ低下しました。本番環境に似たトラフィックパターンでは削減率は80%に達しました。
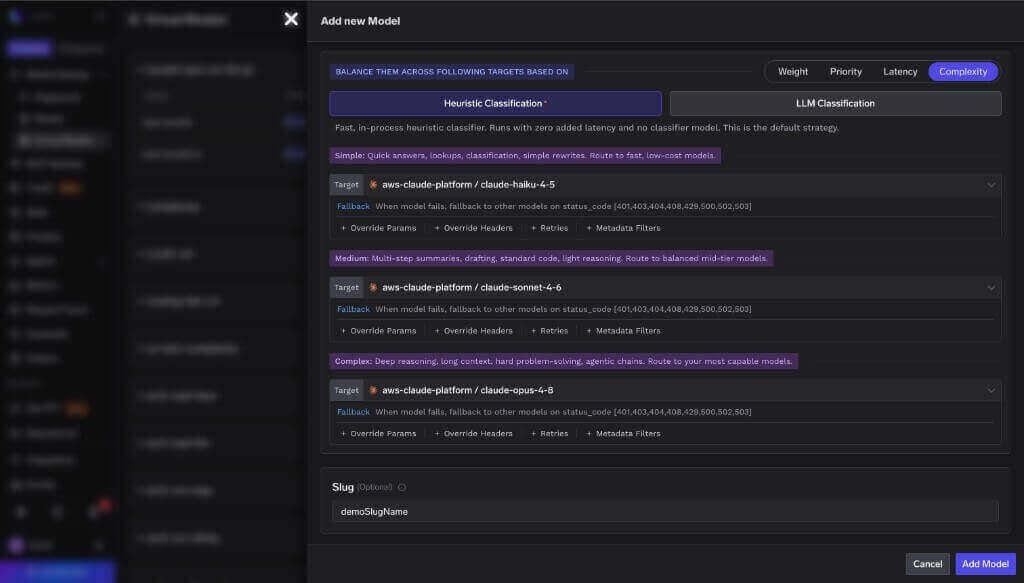
複雑さに基づくルーティング階層とターゲットモデル
どちらの経路でも同じガードレールを適用。 セルフホスト型モデルはプロバイダーのセーフティスタックを自動的には継承しません。モデルがDeepSeekのエンドポイントであろうとご自身のポッドであろうと、ゲートウェイレベルのガードレールがリクエストおよびレスポンスのパス上で動作します。

AI Gateway経由のリクエストおよびレスポンスパスに適用されるガードレール
導入前に測定を実施。 チームごとのリクエスト単位のコストとレイテンシを測定することこそが、V4-Proのオフピーク価格やセルフホスト型ノードが現在運用している構成よりも実際に優れているかを確認する唯一の方法です。

TrueFoundryにおけるモデルごとのコスト、トークン、レイテンシメトリクス
2026年9月時点の簡潔な手順は以下の通りです:

DeepSeek V4-ProのGAリリースは、単なるベンチマークの話題にとどまりません。DeepSeek自身が公開している数値によれば、一部のエージェントタスクではOpus-4.8を上回るものの、より難度の高いリポジトリ作業や知識問題では敗北しており、Kimi K3もオープンモデル内での首位を争っています。リーダーボードのエントリとして見れば、ムラのある成績を持った優れたモデルの1つに過ぎません。
しかし、ライセンスとして見た場合、意味合いは大きく変わります。フロンティアに十分に近く、実用的な選択肢となり得る1MコンテキストのモデルがMITライセンス下で公開されたことで、デプロイに関する議論はもはや机上の空論ではなくなりました。運用に耐えうる強力なノードを用意するだけの利用量があり、インフラスタックを自社で管理する準備があるならば、ご自身のVPC内で実行し、制御下のインフラ内でプロンプトを保持し、トークンではなくコンピュートに対して費用を支払うことが可能です。ただし、現時点の大半のチームにとってはコストが見合わないため、セルフホストへの道を確保しつつAPIへルーティングするのが適切な選択となります。
これが直視すべき結論です。すべてはご自身が何を所有・管理したいかに帰着します。モデルの運用を他社に委ねたい場合、クローズドなフロンティアモデルが依然として最も手軽な道であり、極めて高度なタスクにおいて最善の選択です。一方で、アプリケーションを書き換えることなくモデルをご自身のセキュリティ境界内に移動させる将来の選択肢を保持したい場合、ゲートウェイの背後でオープンウェイトモデルを運用することこそが低コストでその選択肢を買う方法であり、必要になる前に確保しておくべきアプローチです。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.




DeepSeek V4は、DeepSeekのmixture-of-expertsモデルファミリーです。V4-ProとV4-Flashを含むV4のプレビュー版は2026年4月24日に公開されました。DeepSeek-V4-Proは、2026年8月13日にDeepSeek-V4-Pro-0813として一般提供が開始されました。
重みとリポジトリは、Hugging Faceのdeepseek-ai/DeepSeek-V4-Pro-0813にてMITライセンスで公開されています。対象は重みとコードであり、学習データは含まれないため、「オープンソース」よりも「オープンウェイト」と呼ぶほうが正確です。
2026年9月時点で、キャッシュミス時の入力は100万トークンあたりオフピークで0.66ドル、ピーク時で1.32ドル、キャッシュヒット時は0.022ドルと0.044ドル、出力は100万トークンあたり1.98ドルと3.96ドルです。ピーク時間帯は、平日の01:00〜04:00および06:00〜10:00(UTC)です。
はい。DeepSeekはvLLMとSGLang向けのサービング手順を公開しています。ただし、規模については現実的に考えてください。パラメータ数1.7兆のモデルであり、モデルカードに記載されたリファレンス構成はマルチGPUのGB300ノードです。
TrueFoundryのAI Gatewayが追加するのはおよそ3〜4ミリ秒で、1 vCPUで350 RPS以上を処理できます。数秒かかる生成時間と比べれば、無視できる水準です。
いいえ。上記のベンチマークのばらつきが、その反証です。オープンモデルとクローズドモデルをタスクの種類に応じてルーティングするほうが、1つに標準化するよりも通常は安く、結果も良くなります。






















