



November 6, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
OWASP Top 10 for Large Language Model Applicationsは、OWASP GenAI Security Projectが維持している、LLMを活用したソフトウェアにおける最も重大なセキュリティリスクに関する合意済みのリストです。現在のバージョンは、genai.owasp.org/llm-top-10で公開されている2025年版リストです。2023/24年のv1.1リストもそこにアーカイブされており、現在も広く引用されています。記事内でモデルの盗用(Model Theft)や過度な依存(Overreliance)に言及している場合は、旧バージョンを説明していることになります。
OWASPが公開している2025年版のリストは以下の通りです:
変更点を見ると、セキュリティの関心がどこへ移行したかがよくわかります。システムプロンプトの漏洩とベクターおよび埋め込みの脆弱性が新しく追加されました。モデルのサービス拒否(DoS)は、より広範な概念である無制限の消費に統合されました。不安全なプラグイン設計は、ツール呼び出しの標準化がMCPなどのプロトコルに収束したため、サプライチェーンと過剰な自立性に統合されました。モデルの盗用は項目から完全に削除されました。
これこそが、ほとんどの解説記事が見落としているポイントです。Top 10はリスクを一覧化したものであり、リスクそのものは製品の機能ではありません。リストのうち4つのリスクはゲートウェイが位置する推論パスに属し、3つはアプリケーションコードに属し、残り3つはゲートウェイの関知しないパイプラインに属します。
ゲートウェイの適用範囲に完全に収まるものが4つ、一部対応可能なものが3つ、他の場所で対応すべきものが3つあります。もしお使いのAIセキュリティフレームワークで、LLM04とLLM08に対してゲートウェイの行が割り当てられているなら、その行は形骸化しています。
ゲートウェイがLLM01、LLM02、LLM06、LLM10を適切にカバーできるのは、これら4つがすべてリクエストパス上の問題だからです。つまり、プロンプトが送信された瞬間やツールが実行された瞬間に発生するため、ゲートウェイが監視できる唯一のタイミングに合致しています。残りのリスクは、推論より数週間前の学習実行時やインデックス作成ジョブの段階で決定してしまっています。
リストをコンプライアンスのチェックリストとして扱うこと。 OWASPが公開しているのはリスク分類体系(タクソノミー)と緩和策のガイドラインであり、認証基準ではありません。OWASP LLM Top 10の監査というものは存在せず、合格証を発行する組織もありません。単一のツールで10項目すべてを「カバーしている」と主張するマトリックスは、攻撃を防ぐためではなく、会議を乗り切るためだけに作られたものです。
出力検証を誤った場所に配置すること。 LLM05は、アプリケーションがモデルの出力をどのように扱うかという問題です。ゲートウェイは、レスポンスにos.systemやエスケープされていないscriptタグが含まれていることを検知できますが、サービスがその文字列をシェルの実行エンジンに渡すのを止めることはできません。この制御は出力を消費する場所に配置すべきであり、ゲートウェイでのチェックは多層防御の一環に過ぎません。
インジェクションの「検出」を「防止」だと思い込むこと。 検出エンジンは分類器(クラシファイア)であり、分類器には偽陰性(見落とし)が存在し、攻撃者はそれを回避するために手法を反復改良します。LLM01に対する持続可能な緩和策は、「インジェクションは時として成功する」と前提を置き、被害を防げる構造を作ることです。これは本質的にLLM06(過剰な自立性)の問題です。ツールのアクセス表面を限定しておけば、インジェクションが成功したとしても、危険な機能を実行できなくなります。
LLM10を単なる請求上の懸念として無視すること。 ループに陥ったエージェントは、自社の予算に対するサービス拒否(DoS)攻撃となり、大量のクエリ実行はモデル抽出攻撃の手法でもあります。これは最も塞ぎやすい穴でありながら、最も放置されがちな脆弱性でもあります。
TrueFoundryのAI Gatewayは、これらの制御機能をリクエストパスのフック上に配置されたガードレールとして実装しています。フックは4つあり、どのリスクに対処できるかは使用するフックによって異なります。
LLMリクエスト向け:プロンプトがモデルに届く前のinput、モデルが応答した後のoutput。

MCPツール呼び出し向け:ツールが実行される前のmcp_pre_tool、ツールが結果を返した後のmcp_post_tool。
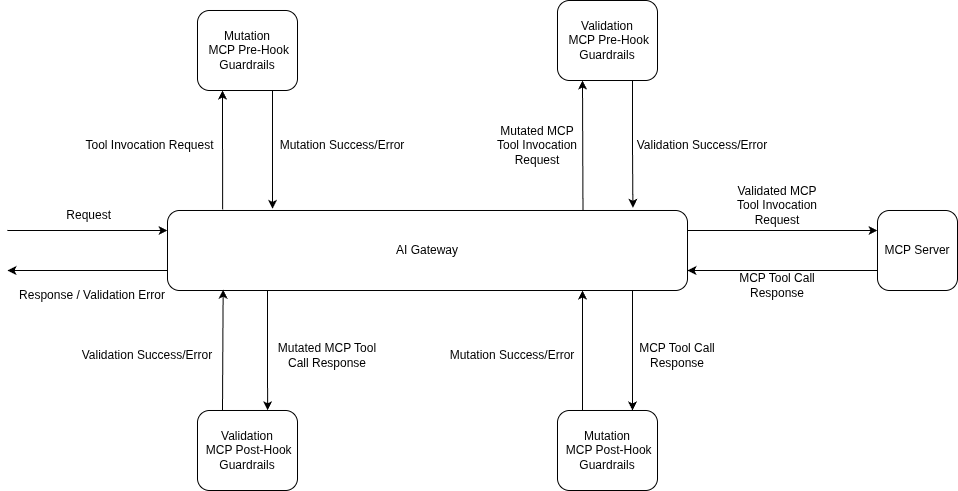
これらのMCPフックにより、owasp mcpへの懸念に対処しやすくなります。ガードレールはツール呼び出しごとに個別に実行されます。例えば、ツールを連続で5回呼び出した場合、5組のチェックが実行されます。pre_toolで失敗した場合、ツールは実行されません。post_toolで失敗した場合、結果の返却が停止されます。
各ガードレールには、Operation Mode(操作モード)(validateは検査とブロックを実行、mutateは書き換えも実行)と、違反時やエラー時の動作を定めるEnforcement Strategy(強制戦略)が用意されています:
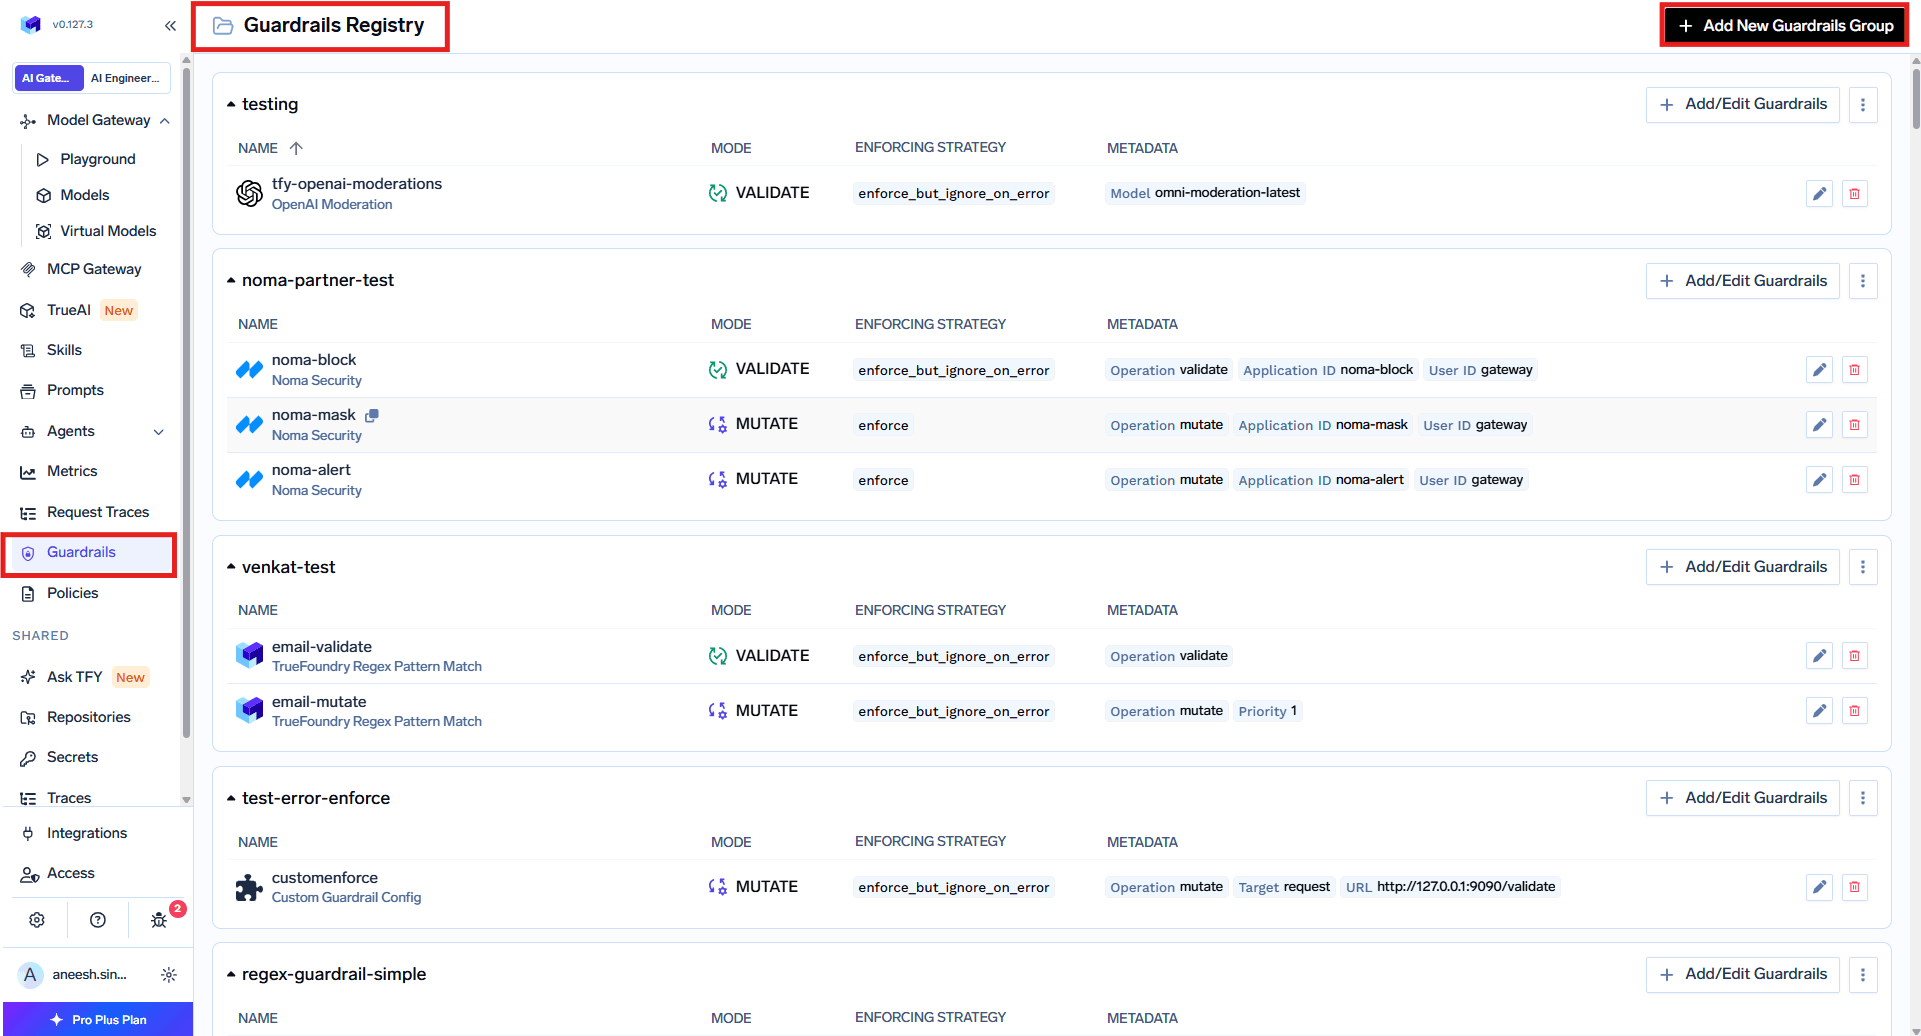
組み込みのPrompt InjectionガードレールはAzure Prompt Shieldを利用しており、サードパーティのキーを準備することなくTrueFoundryによって管理されます。ユーザープロンプトと、検索されたドキュメントやコンテキストの内容を個別に分析するため、直接的な「これまでの指示をすべて無視しろ」という指示だけでなく、取得ドキュメント内に潜む間接的なインジェクションも検知します(Validate-onlyモード)。Guardrailsセクションから追加できます:
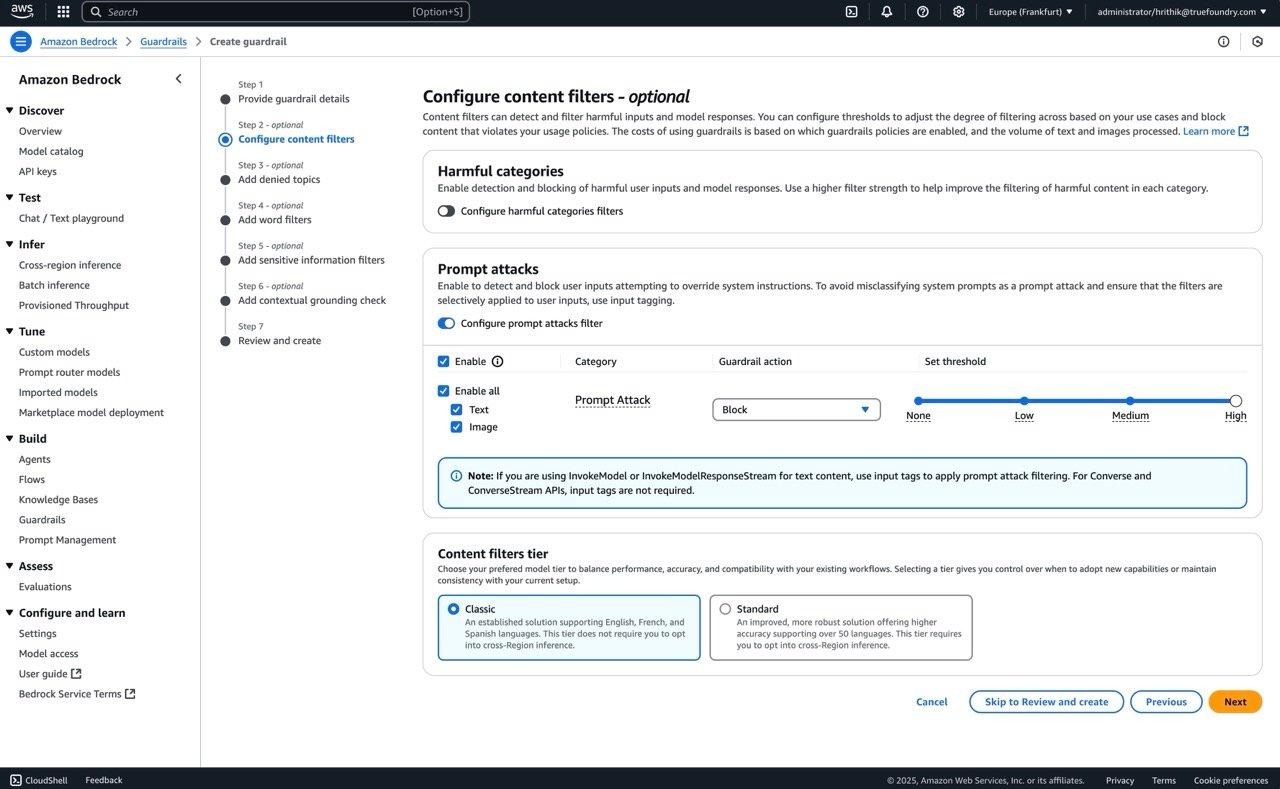
このガードレールはLLM InputおよびMCP Pre Toolで動作し、ツールの引数内に含まれるインジェクションも監視します。独自のベンダー認証情報を使用したい場合は、AWS Bedrock Guardrailsでも同等の機能を実現できます。Prompt Attackを有効化し、アクションをBlockに設定して登録します:
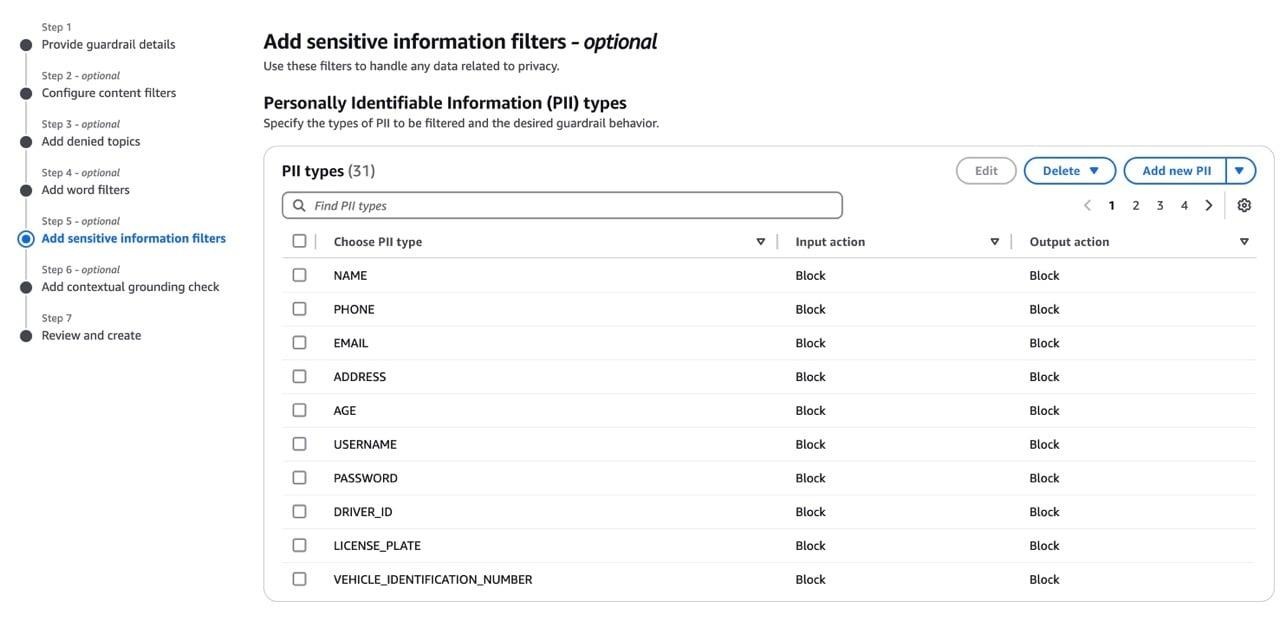
2つの組み込みガードレールがこの問題の大部分をカバーします。PII / PHI Detectionは、設定可能なエンティティカテゴリに基づいて氏名、住所、社会保障番号、診療記録番号を検出します。Secrets Detectionは、AWSキー、OpenAIおよびAnthropicのAPIキー、GitHubおよびGitLabのトークン、JWT、秘密鍵、データベース接続文字列、さらにはapi_keyなどのキーワード付近にある高エントロピー文字列を検知します。
特に重要なのがSecrets Detectionです。これは4つのフックすべてで動作する唯一の組み込みガードレールであり、各フックで異なる失敗パターンを防ぎます。
外部APIの呼び出しを行わずにゲートウェイ内部で実行され、mutateモードでは検出された文字列を設定可能な文字列(デフォルトは***REDACTED***)に置換します。セルフホスト環境でPII検知を行う場合は、自社のキーを使用したAzure PII、カスタムガードレール経由のPresidio、またはBedrockのフィルターがすべて利用可能です。
ここでMCPフックが真価を発揮します。SQL Sanitizerは、WHERE句のないDROP、TRUNCATE、DELETE、UPDATE文や、危険な文字列挿入(補間)を検知します。Code Safety Linterは、eval、exec、os.system、subprocessの呼び出し、および危険なシェルコマンドをフラグ付けします。CedarおよびOPAは、MCPツール呼び出しに対してデフォルト拒否(default-deny)の細粒度ポリシーを適用します。
その基盤となるのがアクセスモデルであり、これがLLM06対策のより重要な側面です。ツールを無効化してtools/listに表示されないようにすることや、機密性の高い呼び出しにMCP Server Approver(承認者)を必須とすること、ユーザーごとのOAuthを導入して、共有トークンではなく操作を実行するユーザーの実際の権限を上位システムで評価させることができます。詳細はMCPアクセス制御の記事で解説しています。
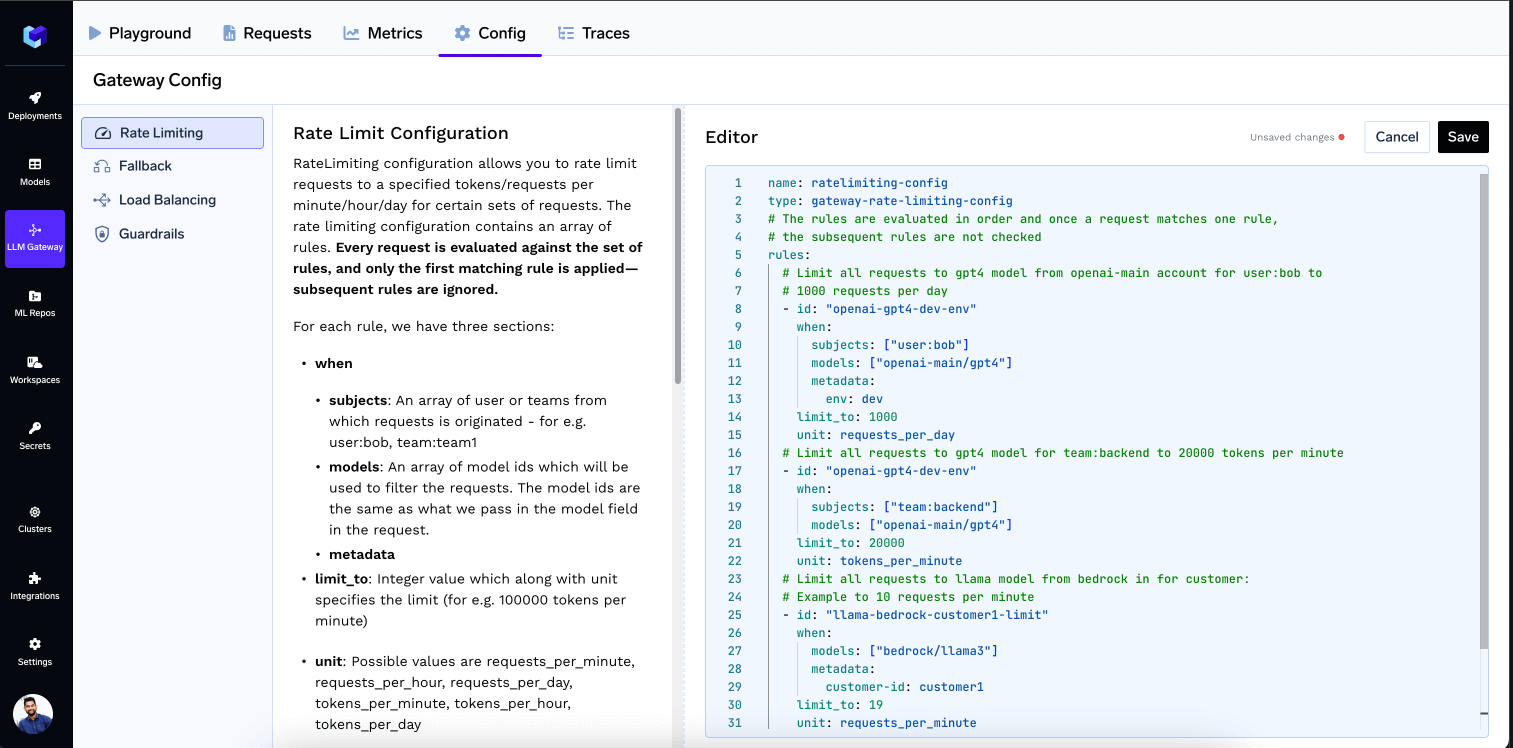
これはガードレールではなく、レート制限および予算設定機能であり、本リストの中で最も完全なカバレッジを提供します。ルールは主体(subject)、モデル、メタデータにマッチし、分、時間、日単位でリクエスト数やトークン数を制限します:
rate_limit_applies_perは、user、virtualaccount、model、またはmetadata.*を受け入れ、1つのルールにつき最大2つまで設定できます。これにより、各エンティティは共通の制限枠を奪い合うことなく、個別のカウンターを持つことができます。強制にはスライディングウィンドウ方式が使用され、制限を超えた場合は、適用されたルール名を記述したx-tfy-applied-rulesヘッダーとともにHTTP 429が返されます:
LLM09 誤情報は、外部プロバイダーを利用して部分的に対処可能です。Patronus AIやFiddlerは、outputフックでハルシネーションや応答の忠実性を検証するエバリュエーターを提供しています。これらは完全な修正策ではなく、検知シグナルとして扱ってください。
LLM05 不適切な出力ハンドリングには、outputフックでのCode Safety LinterとSecrets Detectionが役立ちます。ただし、どちらもアプリケーションコード内での適切な検証処理を完全に代替するものではありません。
LLM03、LLM04、LLM08は、ゲートウェイの適用範囲外です。サプライチェーンは調達とビルドパイプラインの問題であり、ゲートウェイができる唯一の貢献は、レジストリ内に存在するモデルとMCPサーバーを制御することだけです。汚染は学習中に発生します。ベクターの脆弱性は、ゲートウェイが介在しないRAGパイプライン内に存在します。もし「対応可能」と主張するベンダーがいれば、その制御機能がどのフックで実行されるのか確認することをお勧めします。
顧客チケットを読み取り、MCP経由で本番データベースを検索するサポートエージェントを例に考えてみましょう。10のリスクのうち4つが該当し、それぞれ異なる4つの制御が必要です。
ステップ1:ガードレールの登録。 ガードレールグループを作成し、Prompt Injection、PII Detection、Secrets Detectionを追加します。組み込み機能で対応できない場合は、独自のHTTPSエンドポイントを指すCustom Guardrailを作成します:
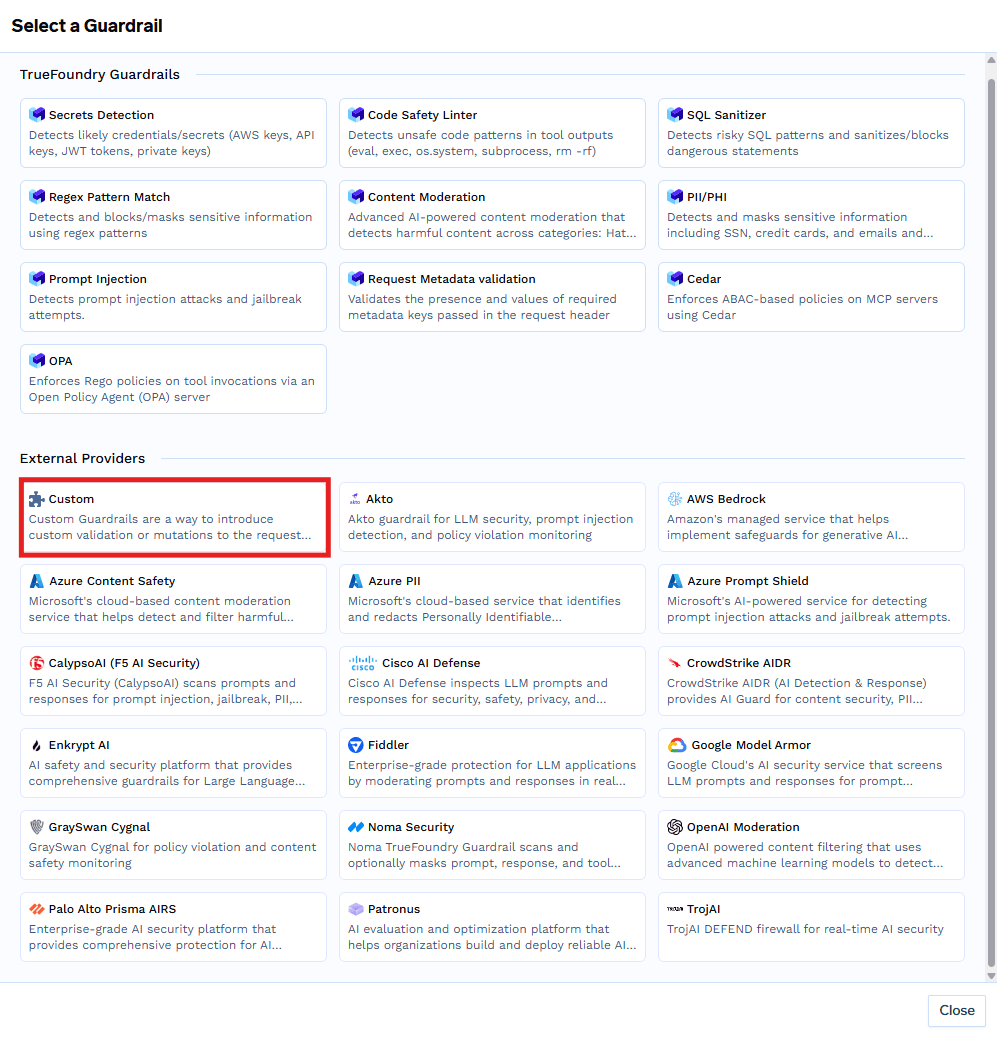
カスタムガードレールは、OpenAI形式のrequestBody、フォームで設定されたconfigオブジェクト、および呼び出し元の主体情報を含むcontextを受け取ります。MCPツールのガードレールの場合、context.metadataには呼び出し元のJWTから検証されたクレームを含むclaimsオブジェクトも含まれるため、アプリケーションやスコープ単位での認可が可能です:
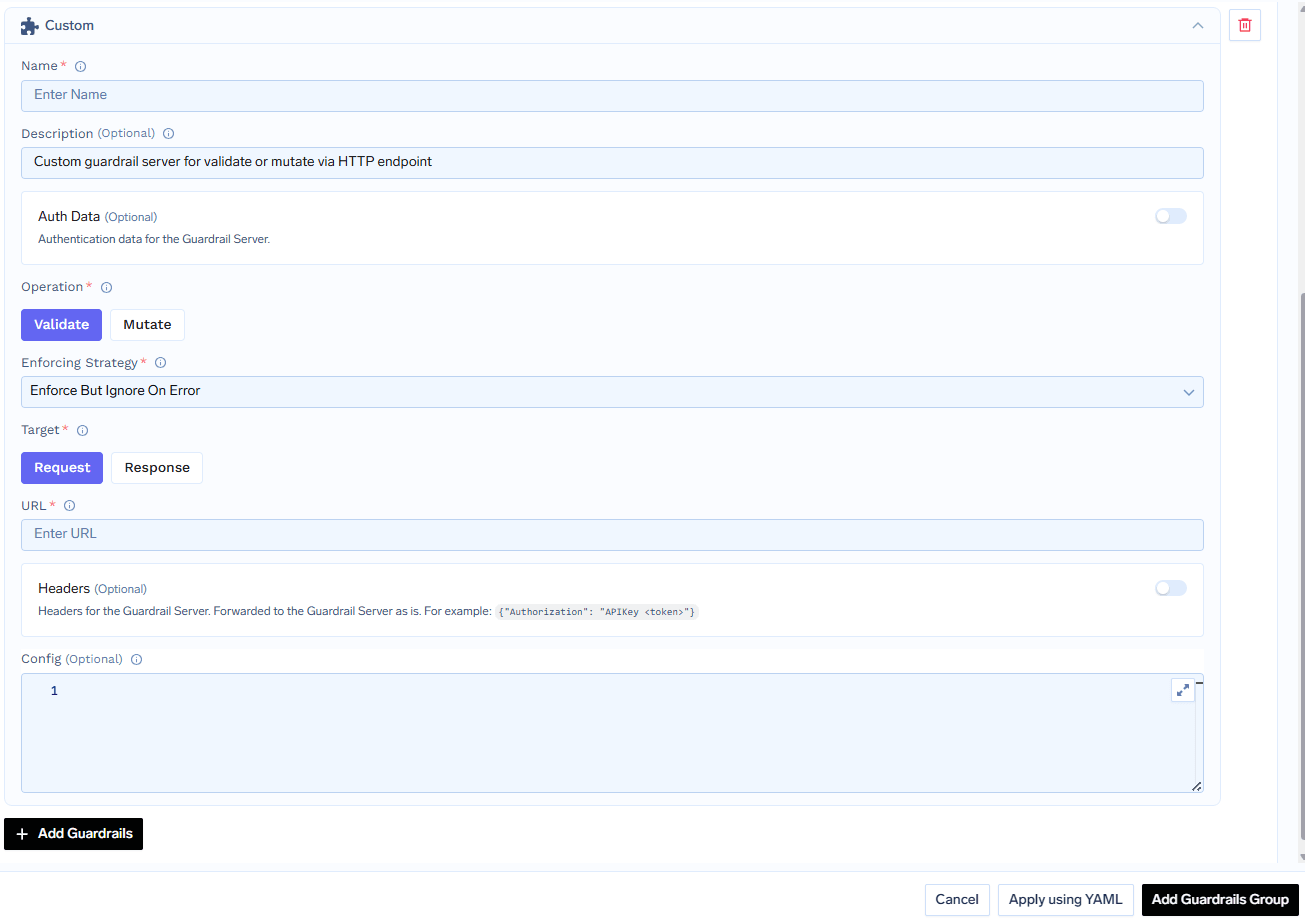
1つ注意が必要な仕様があります。要求を拒否する場合は、verdict: false を含む HTTP 2xxを返してください。400を返すと実行時エラーとして解釈され、enforce_but_ignore_on_errorが有効な場合、リクエストの通過が許可されてしまいます。
ステップ2:ポリシーの記述。 ガードレールを登録しただけでは、何も適用されません。Policies → Guardrailsで、どのモデル、MCPサーバー、主体、メタデータに対し、どのフックでどのガードレールを実行するかを規定するルールを作成します。
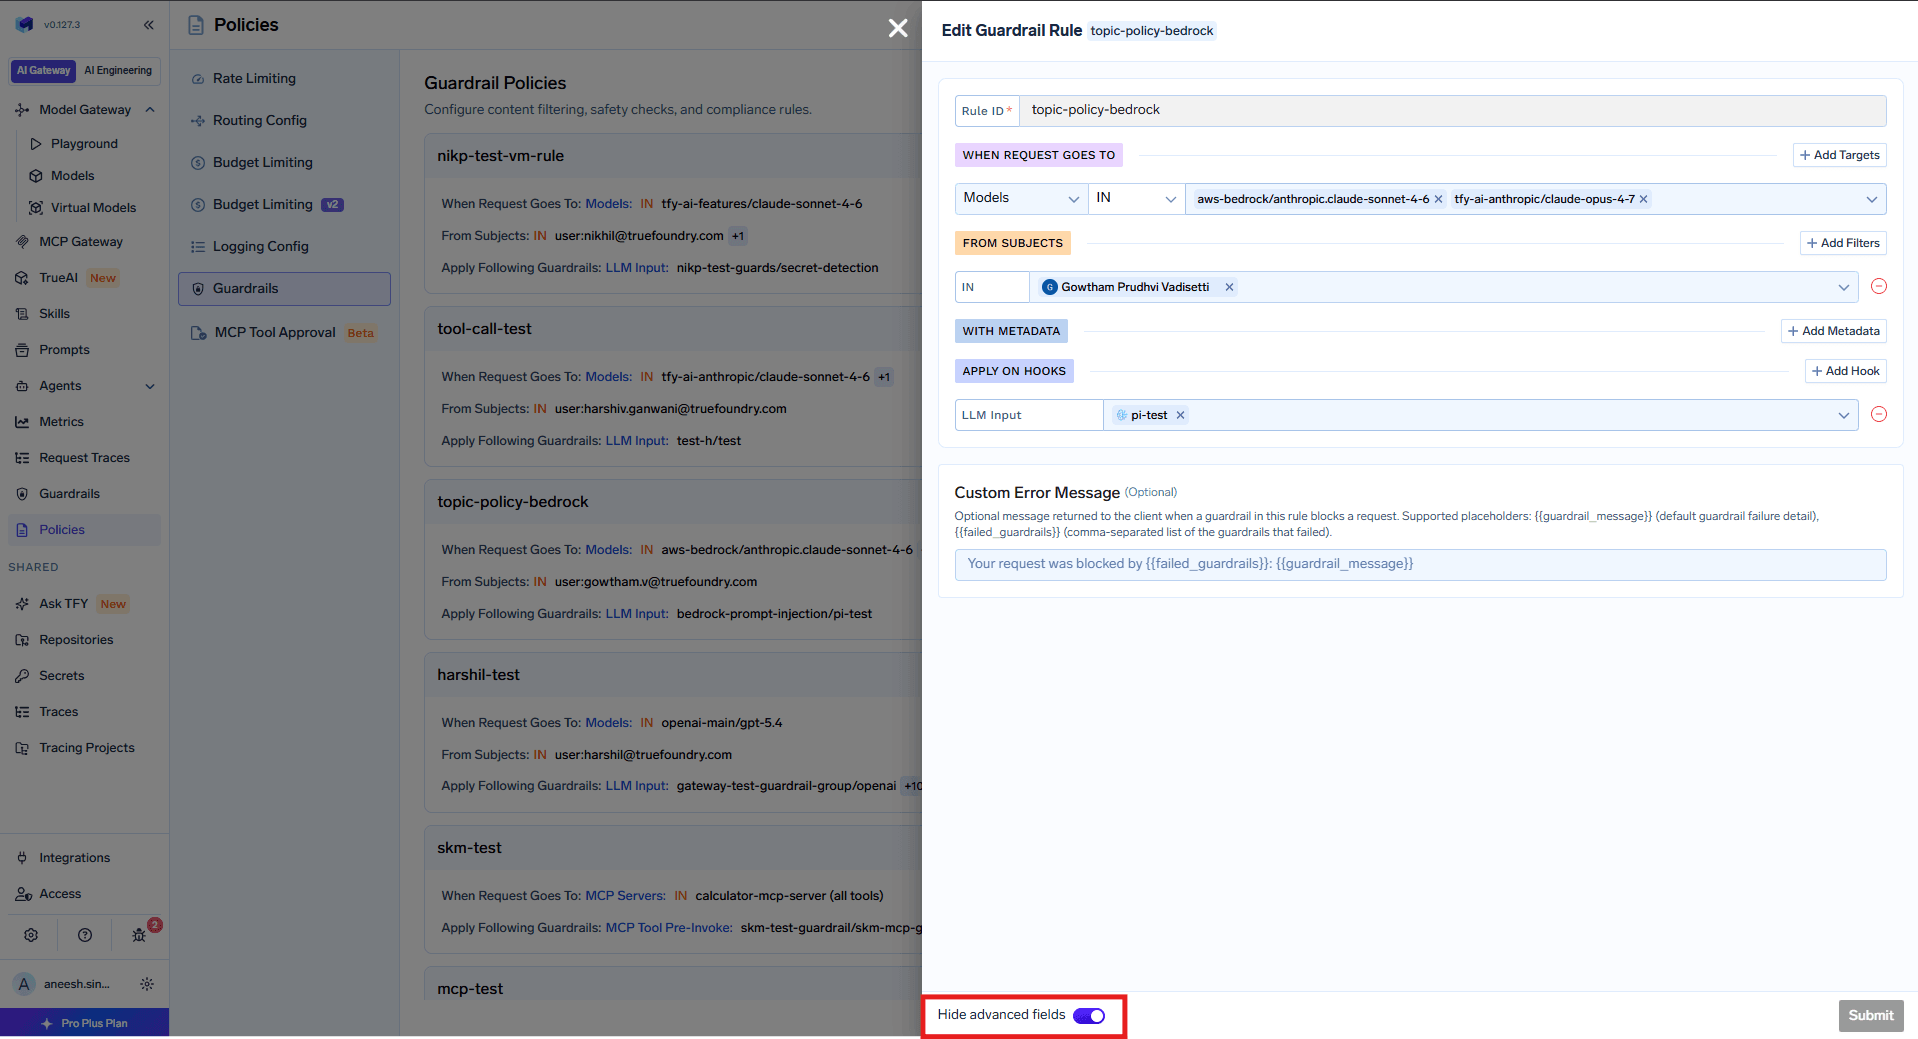
このエージェントの場合:LLM InputでのPrompt Injection(LLM01)、InputでのPII DetectionとOutputでのSecrets Detection(LLM02)、MCP Pre-InvokeでのSQL SanitizerとPost-InvokeでのSecrets Detection(LLM06)を設定します。さらに、rate_limit_applies_per: ['user'] を設定したレート制限ルールによりLLM10をカバーします。
すべてのルールはリクエストごとに評価され、条件に合致するルールはフックごとに統合されるため、ベースラインルールとより厳格な本番用ルールの両方を同時に適用できます。{{failed_guardrails}}を使用したCustom Error Messageを設定することで、プロバイダーの生の出力を隠し、適切なエラーを返せます。
ステップ3:運用前の事前確認。 すべてのガードレールを最初はAuditモードで開始します。各ガードレールはMonitor → Request Traces内で独立したスパンとして表示され、レイテンシ、結果、スコープ、検知内容を確認できます:
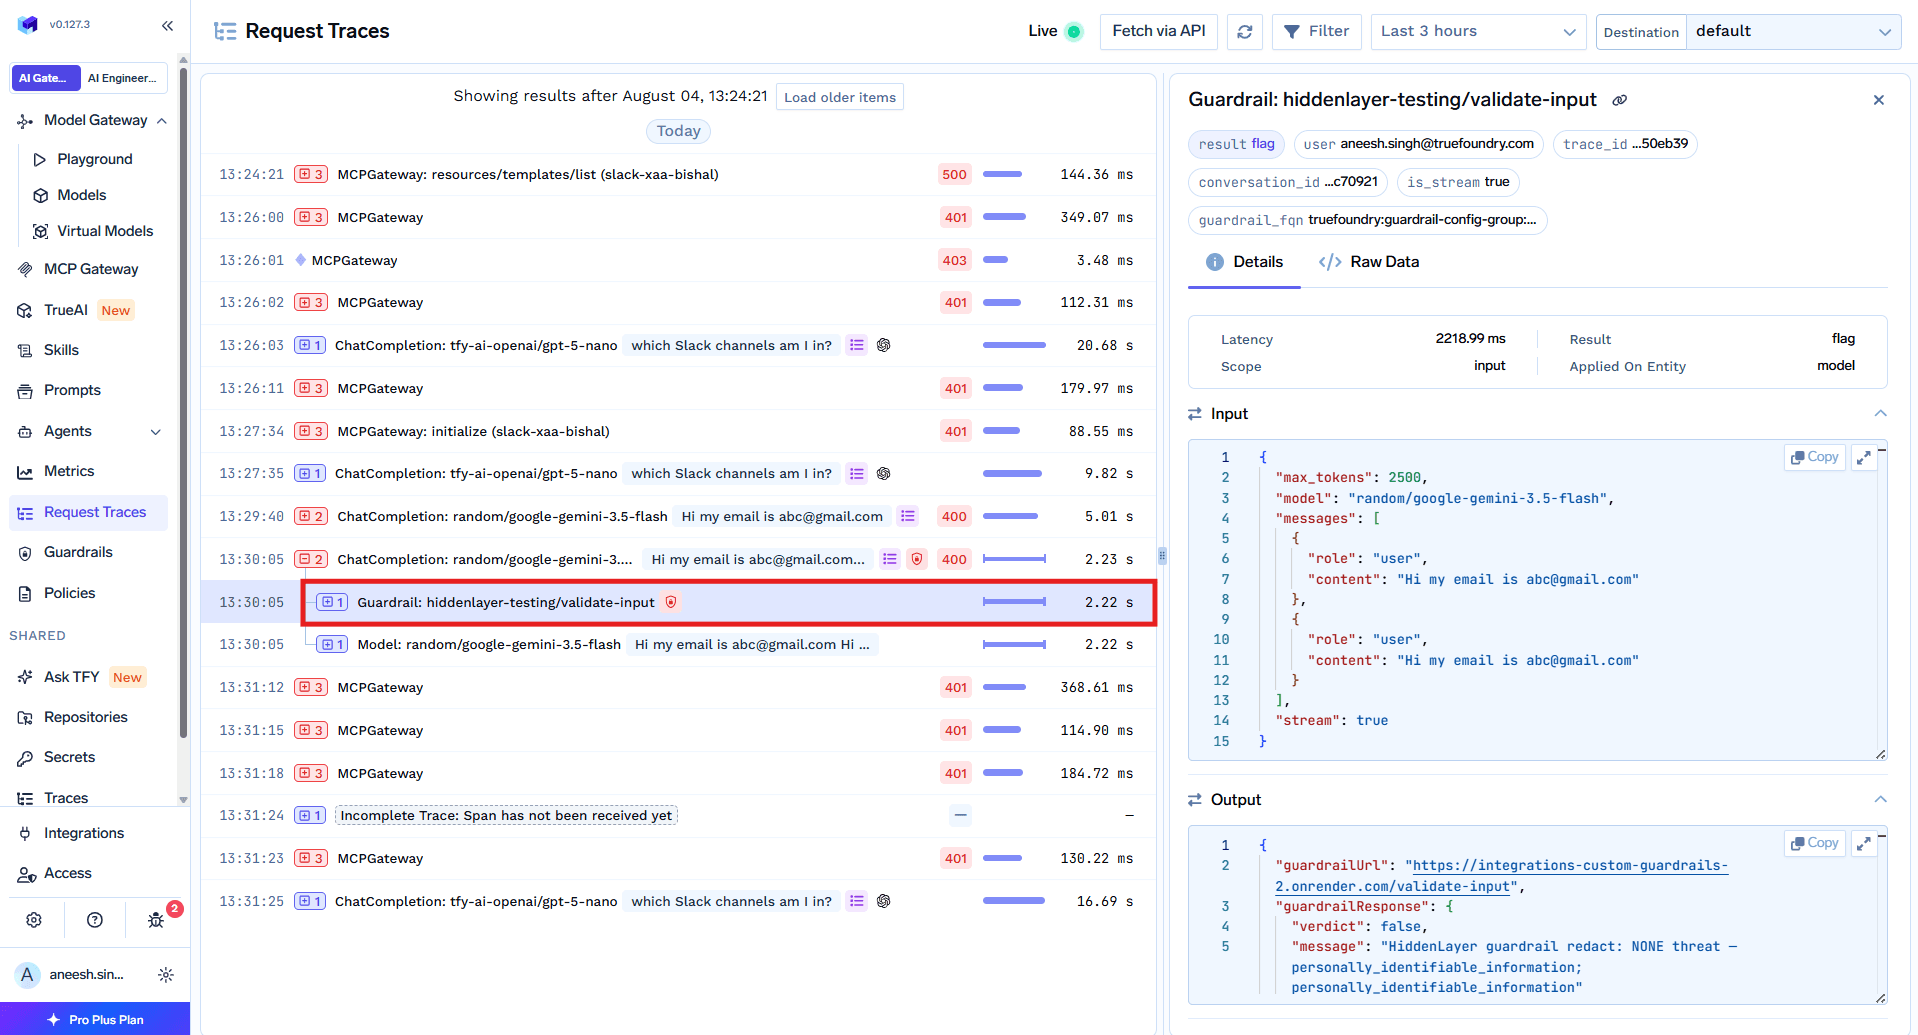
動作を確認できたら、プロバイダーの障害によるアプリの停止を防ぎつつ違反を拒否できるEnforce But Ignore On Errorに移行します。完全なEnforceモードは、コンプライアンス上厳密に必要な場合にのみ使用してください。
出力ガードレールはストリーミングレスポンスでは実行されません。 stream: true の場合、出力ガードレールは完全にスキップされます。レスポンスの評価にはテキスト全体が必要ですが、ストリーミングは生成されたトークンを順次配信するためです。チャットインターフェースの多くはデフォルトでストリーミングを使用するため、これはLLM02とLLM05のカバレッジに影響します。出力チェックが重要な場所ではstream: false に設定するか、クライアント側で検証するか、あるいは出力フックの制御が適用されないことを許容する必要があります。なお、入力ガードレールに影響はありません。
システムプロンプトはデフォルトでガードレールの対象外となります。 ゲートウェイはガードレールにコンテンツを送信する前にシステムプロンプトを除去するため、検査、ブロック、マスキングの対象になりません。唯一の例外はCrowdStrike AIDRで、システムプロンプトを参照しますが変更は行いません。LLM07の観点で重要なのは、ゲートウェイはプロンプトそのものではなく、入力時の窃取試行と出力時のシークレット漏洩を監視する点です。
検証失敗時のコスト発生タイミング。 入力検証はモデルへのリクエストと並行して実行されます。検証が失敗した場合、ゲートウェイは送信中の呼び出しをキャンセルするためコストは発生しません。一方、出力検証はレスポンスが到着した後に実行されます。ブロック処理によってユーザーは保護されますが、トークン消費コストは発生します。
3つの組み込み機能はSaaS限定です。 Content Moderation、PII / PHI Detection、Prompt Injectionは、セルフホスト環境では利用できません。インジェクション対策にはAzure Prompt ShieldやPalo Alto Prisma AIRS、PII対策にはAzure PIIやCrowdStrike、モデレーションにはOpenAI ModerationsやBedrock Guardrailsといった代替手段が存在しますが、独自の認証情報が必要となります。
OWASP LLM Top 10は優れたリスク分類ですが、誤った使い方をされることが少なくありません。タクソノミー(分類体系)としては、どのような問題がどのような優先順位で発生するかを教えてくれます。しかし、一度の製品購入でチェックを埋めるためのリストとして扱うと、見た目だけ完成していて実際には何も防げないコントロールマトリックスが出来上がってしまいます。
真に問いかけるべきは、「この製品がTop 10をカバーしているか」ではなく、「10のリスクのうちリクエストパス上で発生するものはどれで、そこで何が監視を行っているか」です。それに該当するのは4つです。ゲートウェイはその4つに対処する最適な場所であり、10のアプリケーションチームに個別の実装を頼るのではなく、すべてのモデル、チーム、エージェントにわたって一元的にセキュリティを適用できる唯一の場所です。
残りの6つのリスクについては、責任者(オーナー)を明確にしてください。サプライチェーンはモデルを承認する担当者の領域です。汚染は学習を実行する担当者の領域です。ベクターの脆弱性はインデックスを構築した担当者の領域です。リスクの横にそれらの担当者の名前を書き込んでください。そのドキュメントは、当社を含むいかなるベンダーの網羅性アピールよりも価値のあるものになります。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.




OWASP GenAI Security Projectがまとめた、LLMアプリケーションにおける最も重大な10のセキュリティリスクのコンセンサスリストです。現行版は2025年版で、プロンプトインジェクション、機密情報の漏えい、サプライチェーン、データおよびモデルのポイズニング、不適切な出力処理、過剰な権限、システムプロンプトの漏えい、ベクトルと埋め込みの弱点、誤情報、無制限の消費が挙げられています。これはガイダンスであって認証制度ではなく、合格すべき監査はありません。
いいえ。ゲートウェイはリクエスト経路上に位置するため、プロンプトインジェクション、機密情報の漏えい、過剰な権限、無制限の消費といったリクエスト経路上のリスクにはよく対処できます。不適切な出力処理、誤情報、サプライチェーンについては部分的に役立ちます。ポイズニングやベクトルに関する弱点は、ゲートウェイが関与しない学習や検索のパイプラインで発生します。
主にLLM06 Excessive AgencyとLLM01 Prompt Injectionを通じて適用されます。MCPのツール呼び出しは、侵害されたプロンプトが実際のアクションに変わる場所であるため、重要な制御はツールの経路上に置かれます。実行前に引数を検証するmcp_pre_toolフック、モデルが結果を見る前にそれを無害化するmcp_post_toolフック、ツール単位の許可リスト、破壊的な呼び出しに対する承認です。TrueFoundryは、ガードレールを会話ごとに1回ではなく、ツール呼び出しごとに個別に実行します。
はい。TrueFoundryはお客様のVPC、オンプレミス、エアギャップ環境、ハイブリッド環境で動作するため、多数のプロバイダーにまたがってルーティングする場合でも、プロンプトとレスポンスがお客様のドメインの外に出ることはありません。
はい。MCP Gateway、Agent Gateway、そしてツール単位のアクセス制御を備えたMCP & Agents Registryが含まれています。LangGraph、CrewAI、AutoGen、または独自のフレームワークで構築されたエージェントを、すべて一元的に統制できます。
はい。ゲートウェイはOpenTelemetryに準拠しており、Grafana、Datadog、Prometheus、またはお好みのスタックに接続できます。プロンプトからツール、モデルの実行まで、すべてのリクエストを追跡するため、既存のシステムを大幅に変更することなく、統合されたロギングを実現できます。






















