



November 6, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
3つのチームに「LLM ルーターは何をするのか」と尋ねると、重複しない3通りの回答が返ってきます。あるチームは Azure と OpenAI の両方で GPT-4o を運用しており、障害時にもトラフィックを維持したいと考えています。別のチームは請求額を見て、簡単な70%のリクエストをより安価なモデルで処理したいと考えています。さらに別のチームはドイツの子会社を抱えており、プロンプトが EU 域外に出ないようにする必要があります。3つのチームすべてが異なる設定を必要としており、2つのチームは他のチームが構築したものから何の恩恵も得られません。
この分類を正確に提示することは重要です。なぜなら、これこそが多くの LLM ルーティング関連コンテンツで省略されている部分だからです。
判断材料として何を読み取るかが決定的な違いです。ロードバランシングはインフラストラクチャの状態を読み取り、モデル選択はリクエストボディを読み取り、データルーティングはメタデータとアイデンティティを読み取ります。3つの入力に対して3つの機能が存在し、これらは相反するものではなく組み合わせが可能です。
これは「ルーティング」という言葉の最も歴史が古く、最も単純な意味合いであり、それゆえに最も信頼性の高い機能です。同じ機能を提供する複数のルート(azure/gpt-4o と openai/gpt-4o、または異なる地域の2つのデプロイメント)が存在し、単一の障害が自社のシステム停止に繋がらないよう、リクエストを分散させたい場合に使用します。
前提条件として、すべてのターゲットが正確性の面で同等であることが挙げられます。どのターゲットでもリクエストを処理できるため、利用可能性、容量、および速度に基づいて選択します。これにより、LLM ロードバランシングの自動化が安全に行えます。また、プロバイダーのレイテンシは無視できるほど安定しておらず、モデル、地域、プロバイダー、時間帯によって変動します。
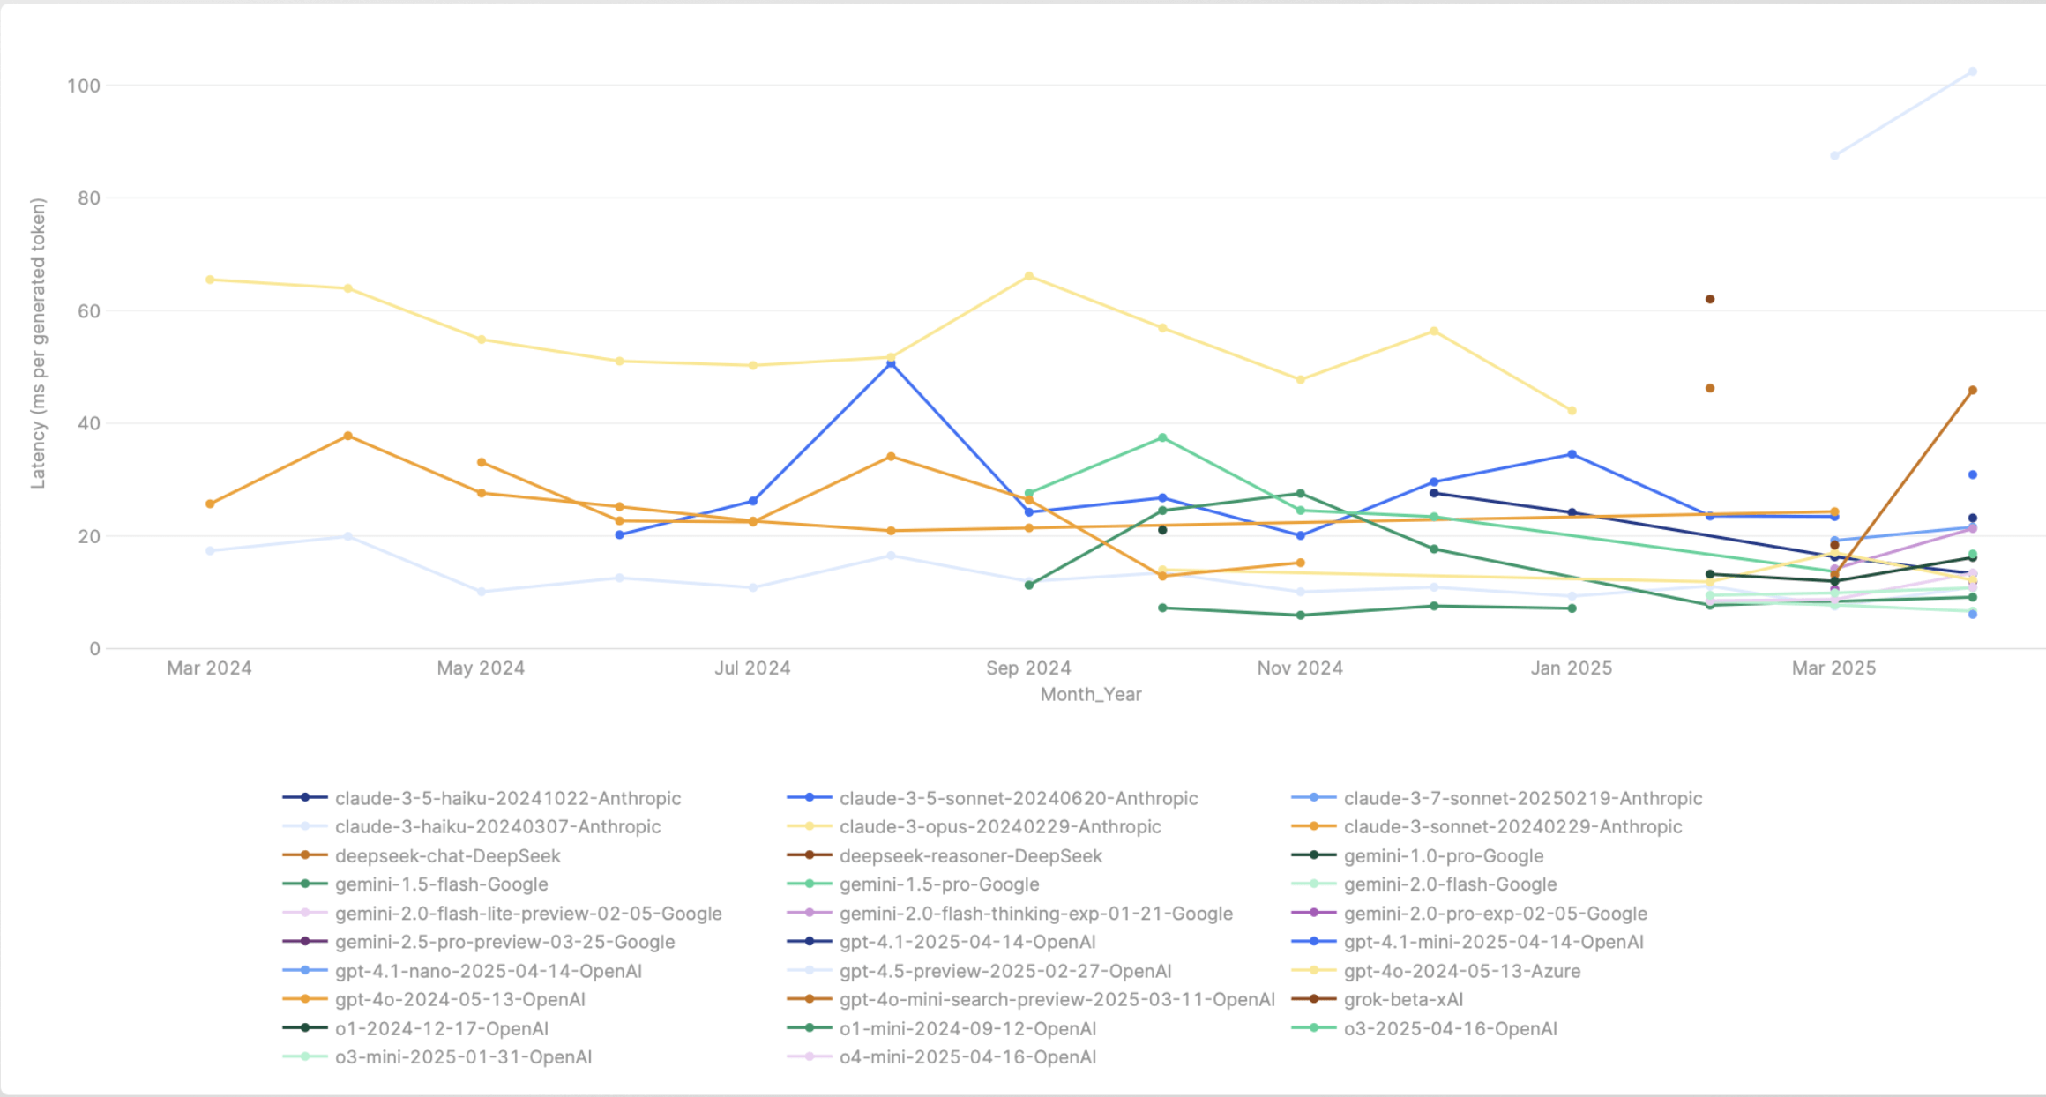
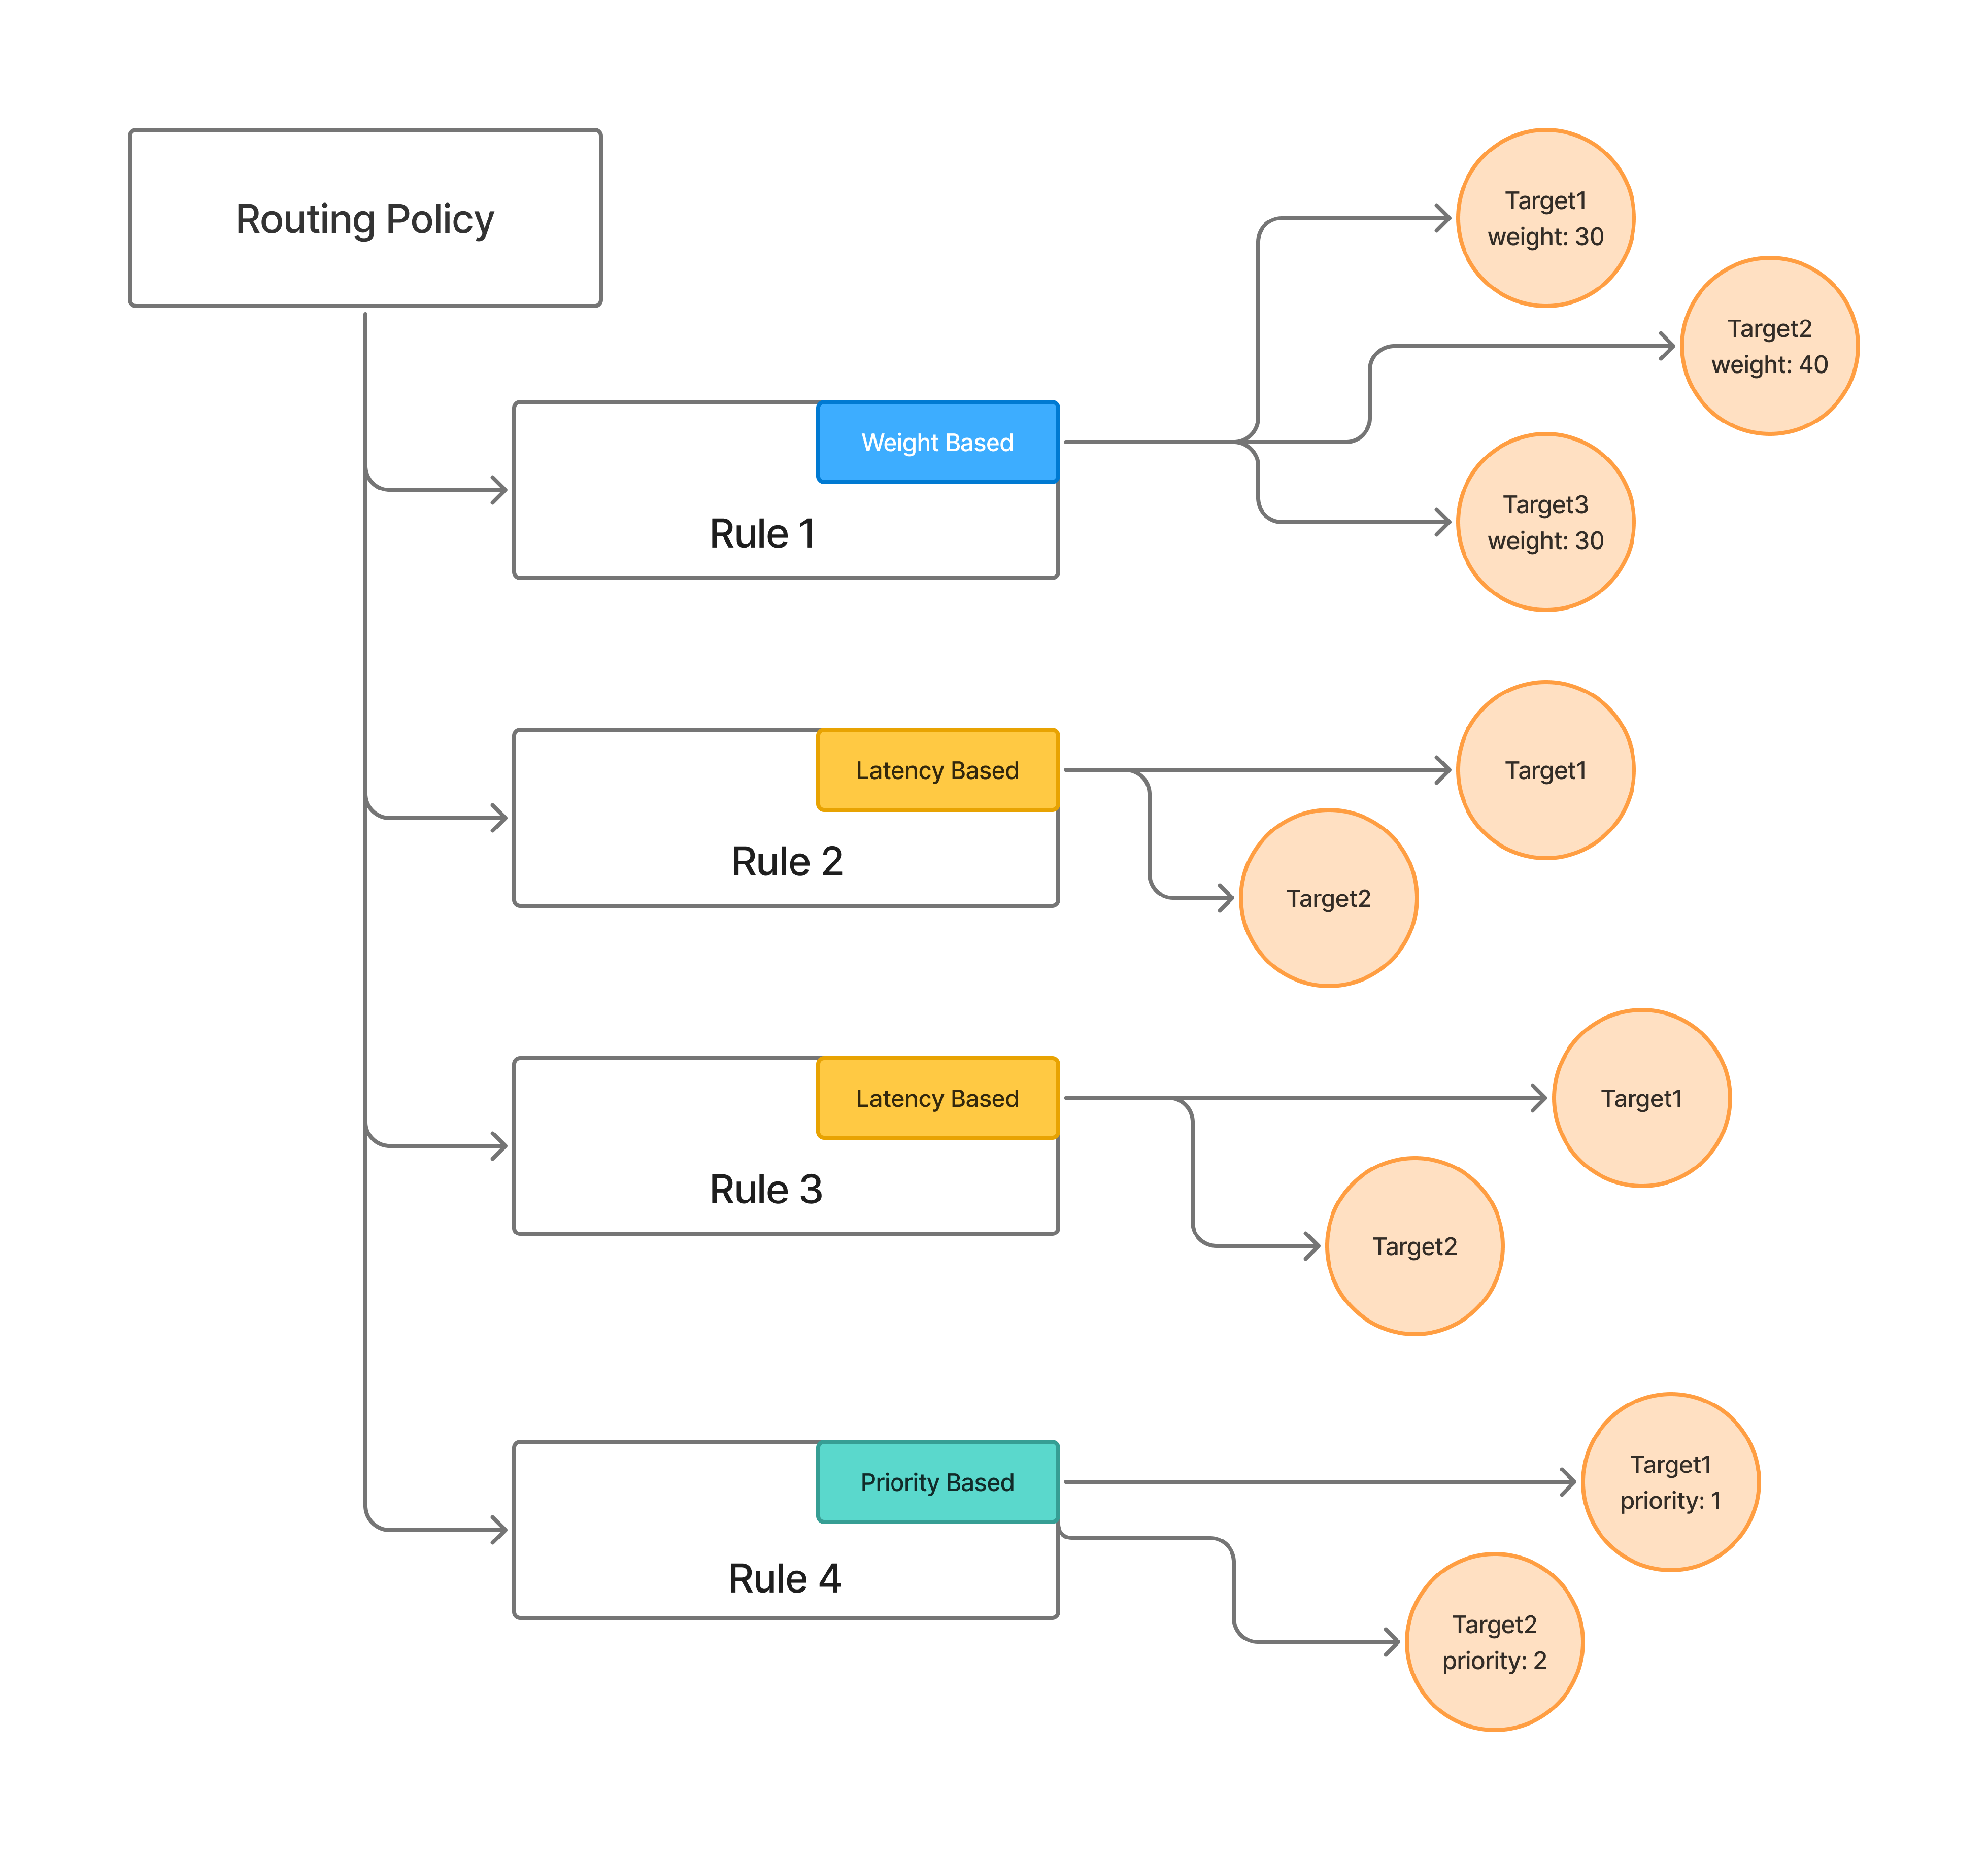
TrueFoundry では、これを仮想モデル上で設定します。仮想モデルとは、my-group/production-chat のようなアプリケーションが呼び出す名称であり、1つのルーティング戦略とその背後にある実際のターゲットリストで構成されます。以下の3つの戦略がロードバランシングに該当します。
これらを単純なラウンドロビンと区別する2つの詳細事項があります。
レイテンシベースのルーティングは、設計上スティッキーに機能します。 ゲートウェイは、過去20分間の各ターゲットの出力トークンあたりの時間を測定し、呼び出し元ごとに10分間のエポック期間固定されるターゲットを選択します。多数の呼び出し元全体ではトラフィックはレイテンシに反比例して分散されますが、個々の呼び出し元はプロンプトキャッシュの効果が得られるのに十分な期間、同じターゲットにアクセスし続けます。これを特別な設定なしで自動的に適用するのが、この戦略の仕組みです。
健全性は継続的に追跡されます。 2分間のローリングウィンドウ内で 5xx、429、401、または 403 を2回返したターゲットは非健全とマークされ、リストの最後に移動します。これらのエラーが期限切れになると復旧します。優先度ベースのルーティングには、オプションの SLA カットオフが追加されます。これは、出力トークンあたりの時間または最初のトークンまでの時間の閾値であり、3分間のローリング平均がこれを超えるとターゲットの優先順位が下がります。
ルールはテナントレベルの YAML として記述することもでき、記述された順序で評価され、最初に一致したルールが適用されます。
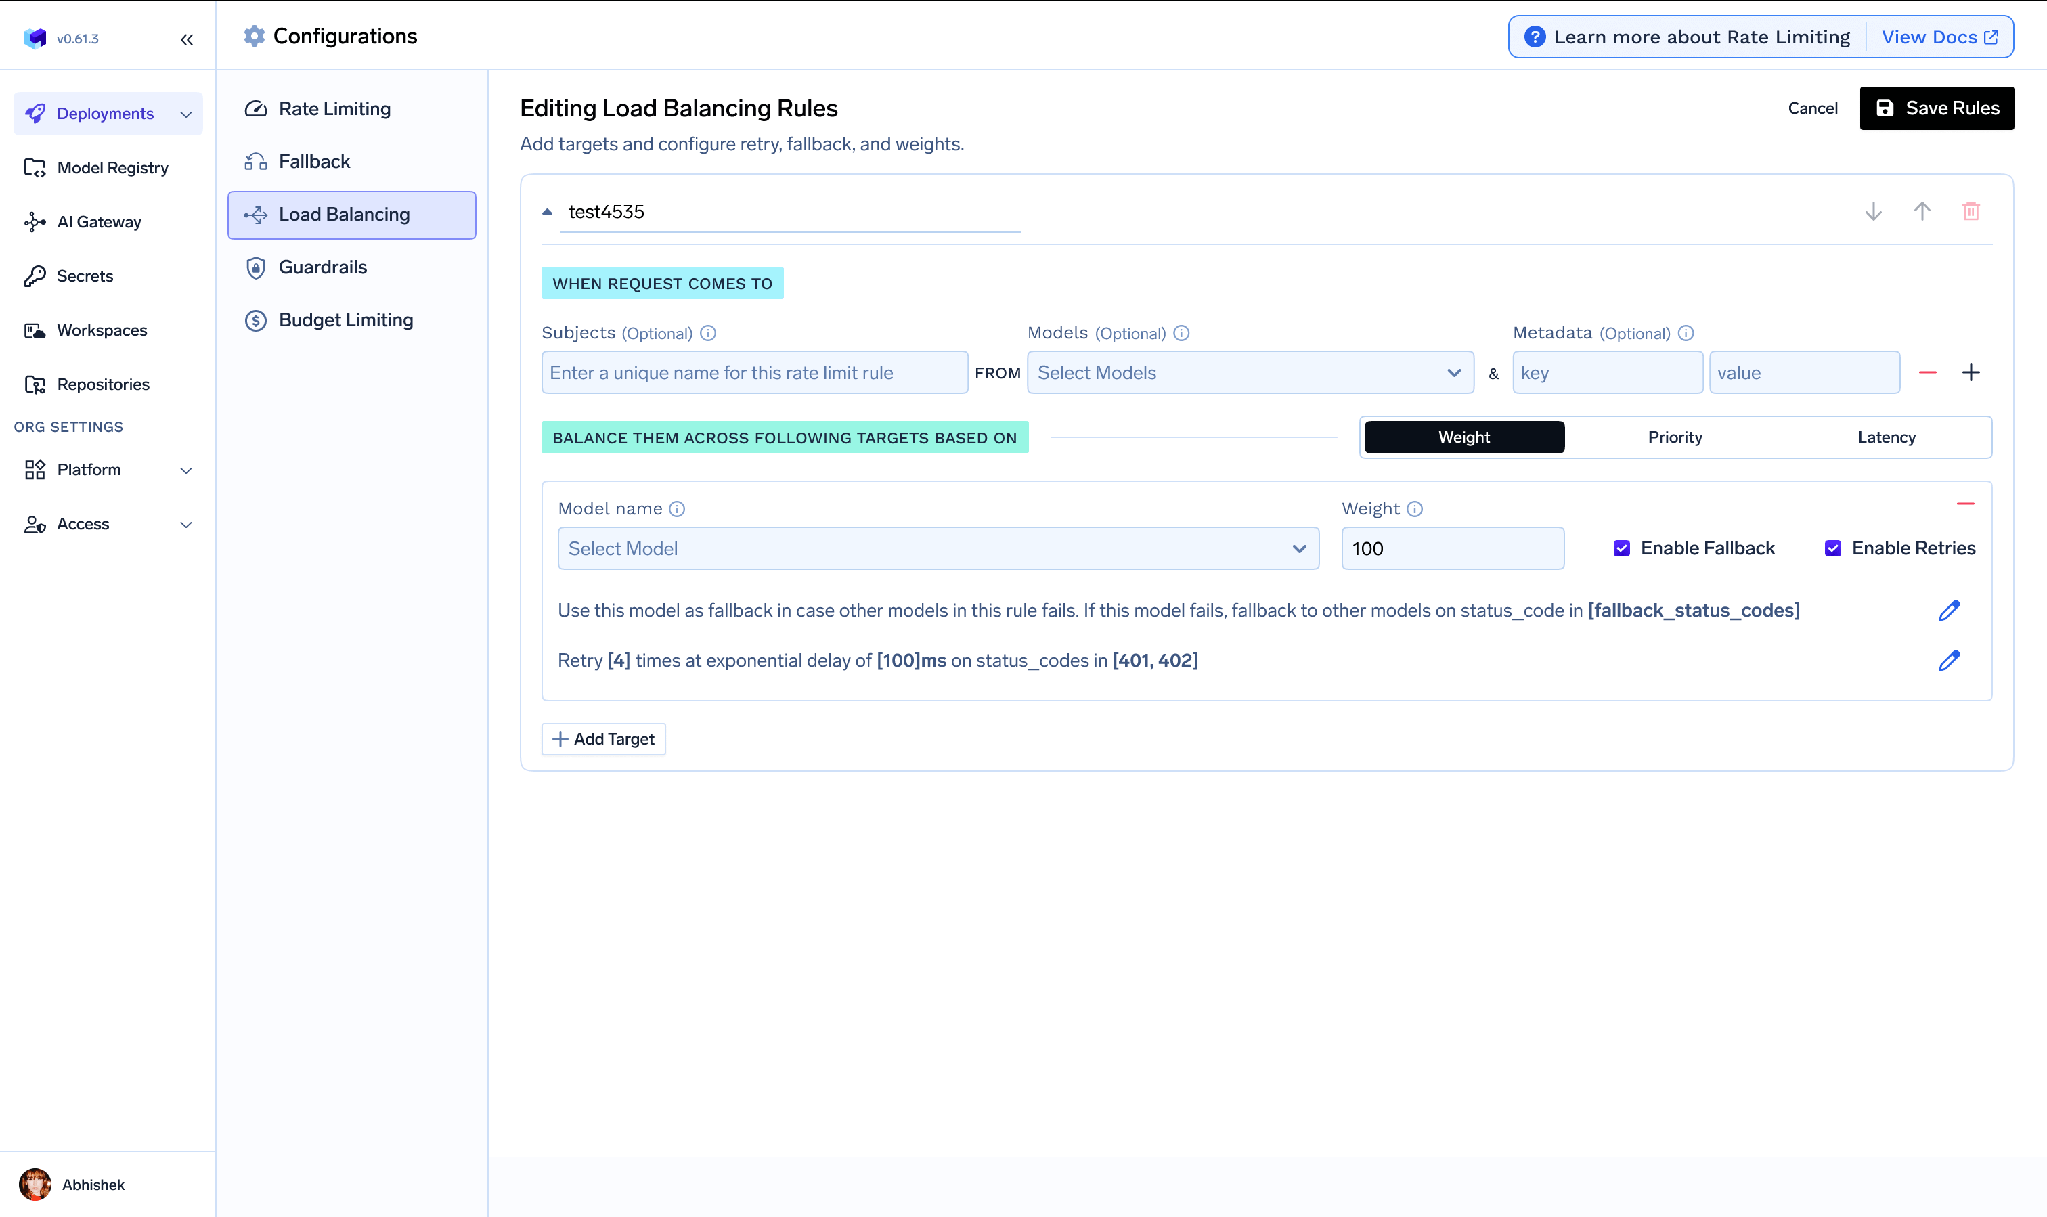
レート制限時にフェイルオーバーする優先度チェーンの例:

この YAML は AI Gateway → Configs → Routing Config に配置され、Git で管理して tfy apply で適用できるため、ルーティングの変更時に PR レビューを受けることができます。1つ注意点として、新規設定の場合、TrueFoundry では仮想モデルの使用を推奨しています。既存のデプロイメントに対して YAML は引き続き機能しますが、仮想モデルを使用することで、所有権とアクセス制御がより明確になります。
これは、人々が最適な LLM ルーターを検索する際に想定している意味合いであり、前述とは本質的に異なる課題です。ここでのターゲットは相互に交換可能ではありません。安価なモデルとフロンティアモデルは両方とも回答を生成しますが、同等の品質ではありません。ルーターは容量ではなく、品質に関する判断を行っています。
この経済的合理性は明白です。プロダクション環境のトラフィックの難易度は均一ではありません。挨拶、事実の検索、分散レートリミッターの設計リクエストがすべて同じエンドポイントに届くため、3つすべてを最も強力なモデルで処理すると、容易な大部分のリクエストに対しても最高ランクの価格を支払うことになります。
TrueFoundry の Auto Routing は、各リクエストを3つのティアのいずれかに分類し、そのティア用に設定されたターゲットに送信します。アプリケーションは単一の仮想モデル名を呼び出し続けるだけで対応可能です。
仮想モデルを作成する際、ルーティングタイプとして Complexity(複雑度)を選択します。
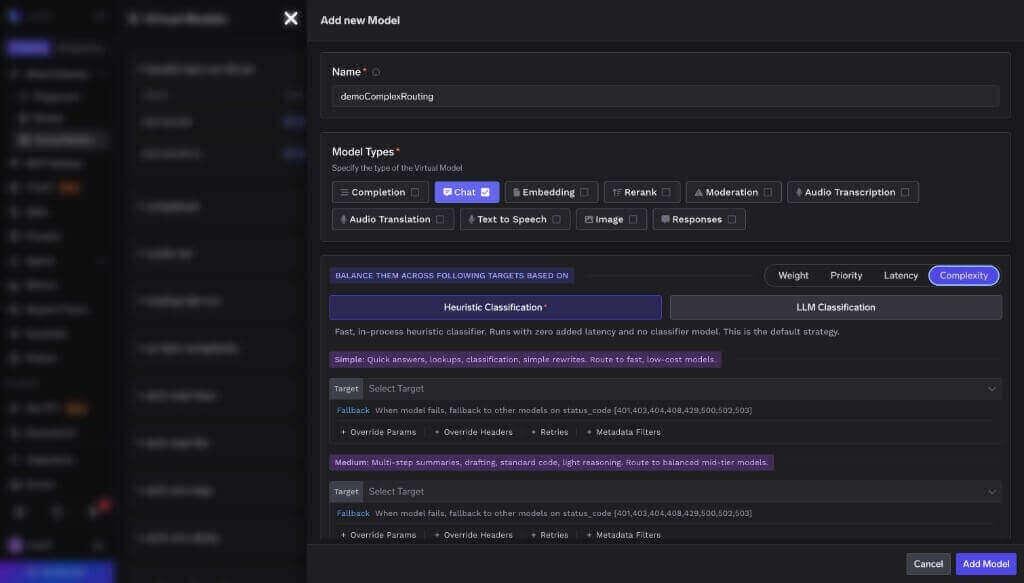
次に、リクエストの分類方法を選択します。デフォルの Heuristic(ヒューリスティック)は、インプロセスで実行され、追加のコストやレイテンシを発生させず、完全に決定的です。コードのキーワード、「ステップ・バイ・ステップ」などの推論フレーズ、技術用語、プロンプトの長さ、複数ステップの構造など、固定されたシグナルをスコアリングします。他の条件が何であれ、2つの明確な推論フレーズが含まれている場合、常に complex にルーティングされます。
LLM classifier(LLM 分類器)は、語彙によって難易度が判別できないトラフィックに対して、代わりに小型で高速なモデルを呼び出します。
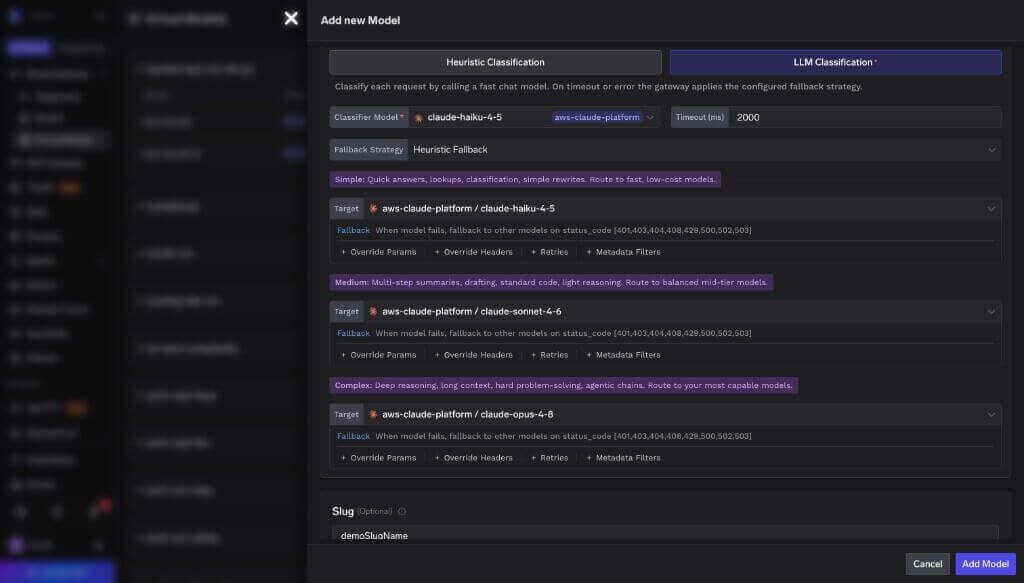
このコストについては明確に理解しておく必要があります。分類器の各呼び出しは、課金対象となるゲートウェイリクエストです。 ログに記録され、そのトークンはトリガーとなったリクエストと同じテナントおよび主体に帰属し、実際のモデルが呼び出される前に1ホップが追加されます。ヒューリスティックは無償ですが精度は大まかであり、分類器は曖昧なプロンプトに対してより正確ですが、料金とミリ秒単位の処理時間の両方でコストが発生します。分類器のタイムアウトによってリクエストが失敗しないよう、fallback_strategy の設定が必須となります。
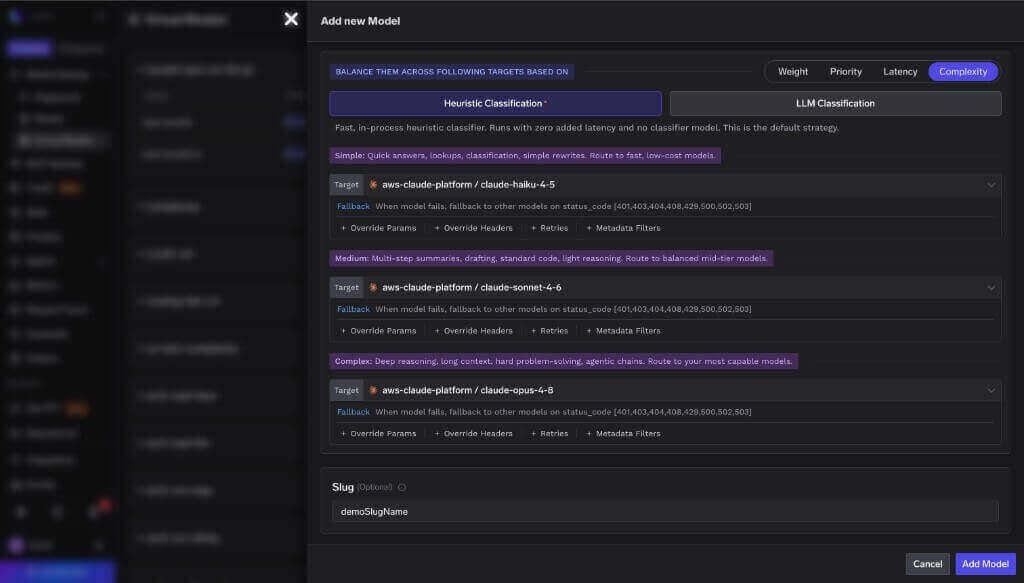
最後に、各ティアにモデルを割り当てます。
TrueFoundry は、すべてのリクエストを1つの最高機能モデルに送信した場合と Auto Routing を比較したベンチマークを実施しました。回答は決定論的に評価されました(生成されたコードは単体テストに対して実行され、数学や多肢選択問題は解答キーと照合されました)。
ほとんどのリクエストが最高機能の推論モデルをスキップするため、平均レイテンシは概ね 7.6秒から 4.0秒に低下しました。[検証要 — レイテンシの数値は公開ドキュメントに記載されておらず、Auto Routing が「全体として高速であった」とだけ述べられています。]
98% という数値を客観的に評価してください。これは下位ティアへのルーティングに一切の犠牲がないという意味ではありません。これは、約3分の2のコスト削減と引き換えに、採点された合格率のうち失われた2%という測定されたサイズを示しています。ワークロードによっては非常に合理的なトレードオフとなりますが、そうでない場合もあります。そのため、この数値は「品質低下なし」と丸められることなく公表されています。前世代のトップモデルと比較した場合、削減率は 50% に近くなり、無償のヒューリスティックでは、短くても高難度なプロンプトに対する精度が低下します。2026年8月測定。
3つ目の意味合いは、コストやスループットとは関係がありません。ドイツの子会社からのリクエストは EU 内のデプロイメントで処理される必要があり、その記録は EU 内のバケットに保持される必要がある場合があります。どのような重み調整を行っても、この条件を表現することはできません。データルーティングと呼ばれる機能には2つの側面があり、TrueFoundry ではこれらを異なる機能で実装しています。
処理に関しては、ターゲットが metadata_match ブロックを保持し、すべてのペアがリクエストの解決されたメタデータと一致する場合にのみターゲットが候補として残ります。SaaS ゲートウェイでは、すべてのリクエストに、12以上のリージョンのうち処理を行った場所から tfy_gateway_region と tfy_gateway_zone が自動的にタグ付けされるため、クライアント側で何か送信する必要はありません。
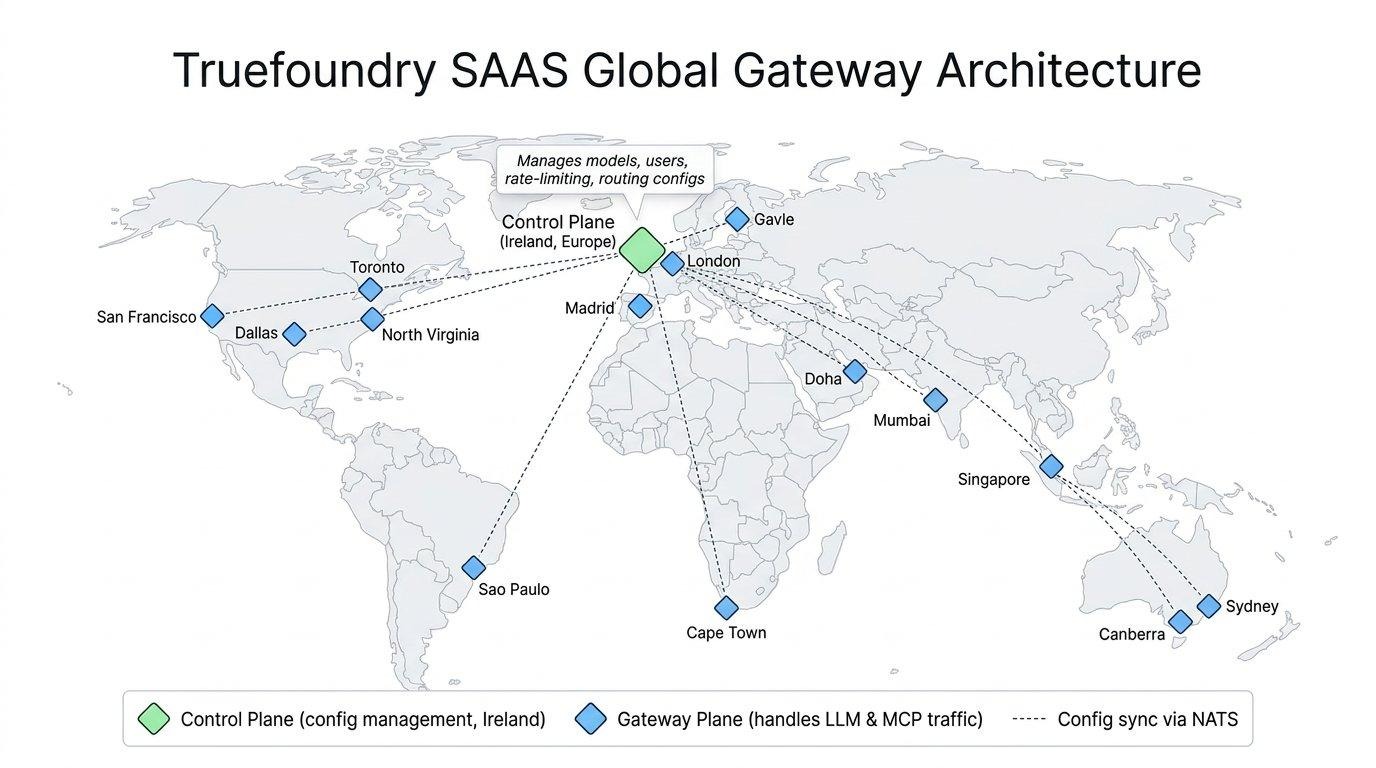
フィルタリングはロードバランシングの順序が計算される前に実行されるため、一致しないターゲットが処理に参加することはありません。この順序が重要です。データルーティングによって候補セットが絞り込まれ、ロードバランシングはその中で適切なターゲットを選択します。
保存に関しては、AI Gateway → Controls → Data Routing に独立した Data Routing ページが存在します。
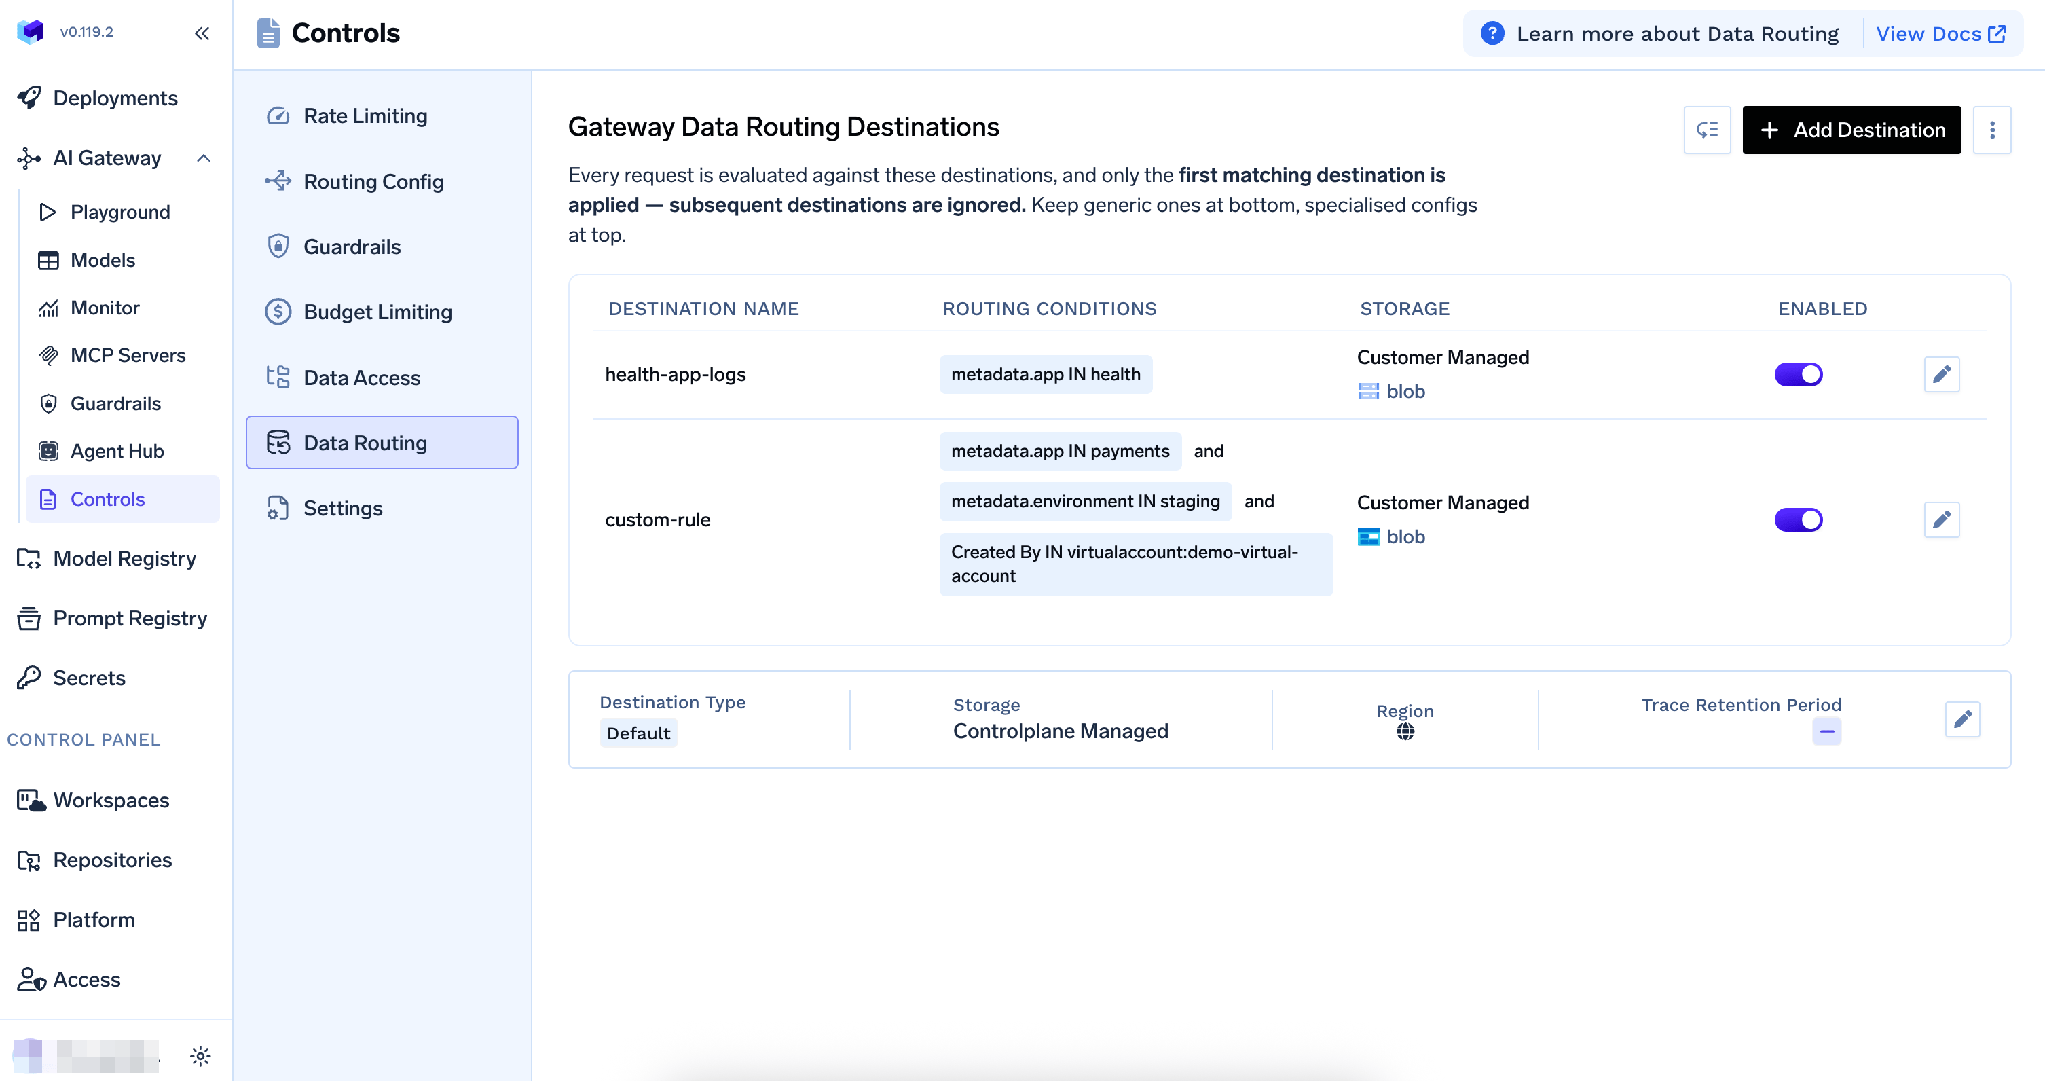
カスタム送信先は Enterprise 機能であり、条件(metadata.app などのユーザー定義メタデータやリクエストの作成者)に基づいてトレースをルーティングします。送信先は上から下に評価され、最初に一致したものが適用されるため、特定ルールは汎用ルールの上に配置してください。
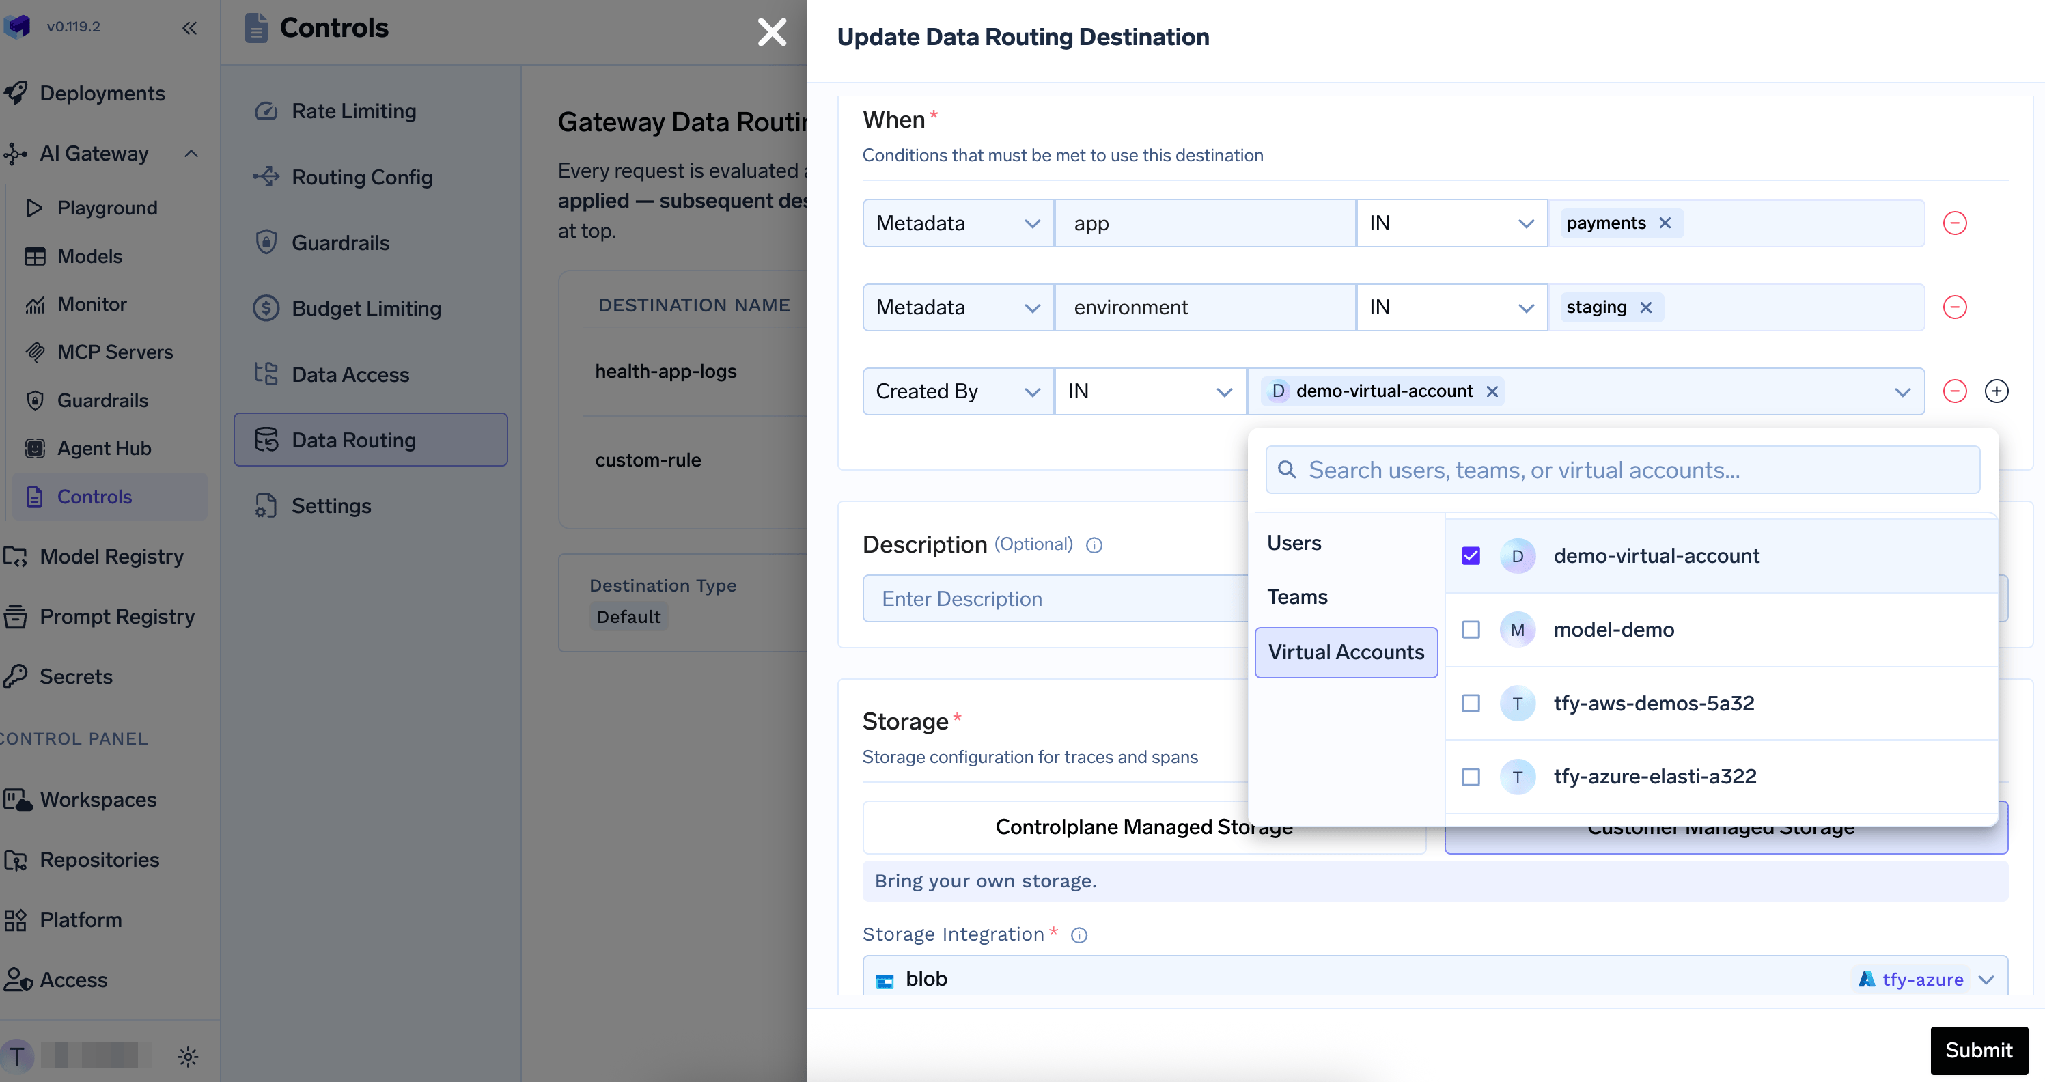
各送信先は、データレジデンシー用に SaaS 上でリージョンを選択できるコントロールプレーン管理のストレージ、または自社の S3、GCS、Azure Blob バケットのいずれかになります。
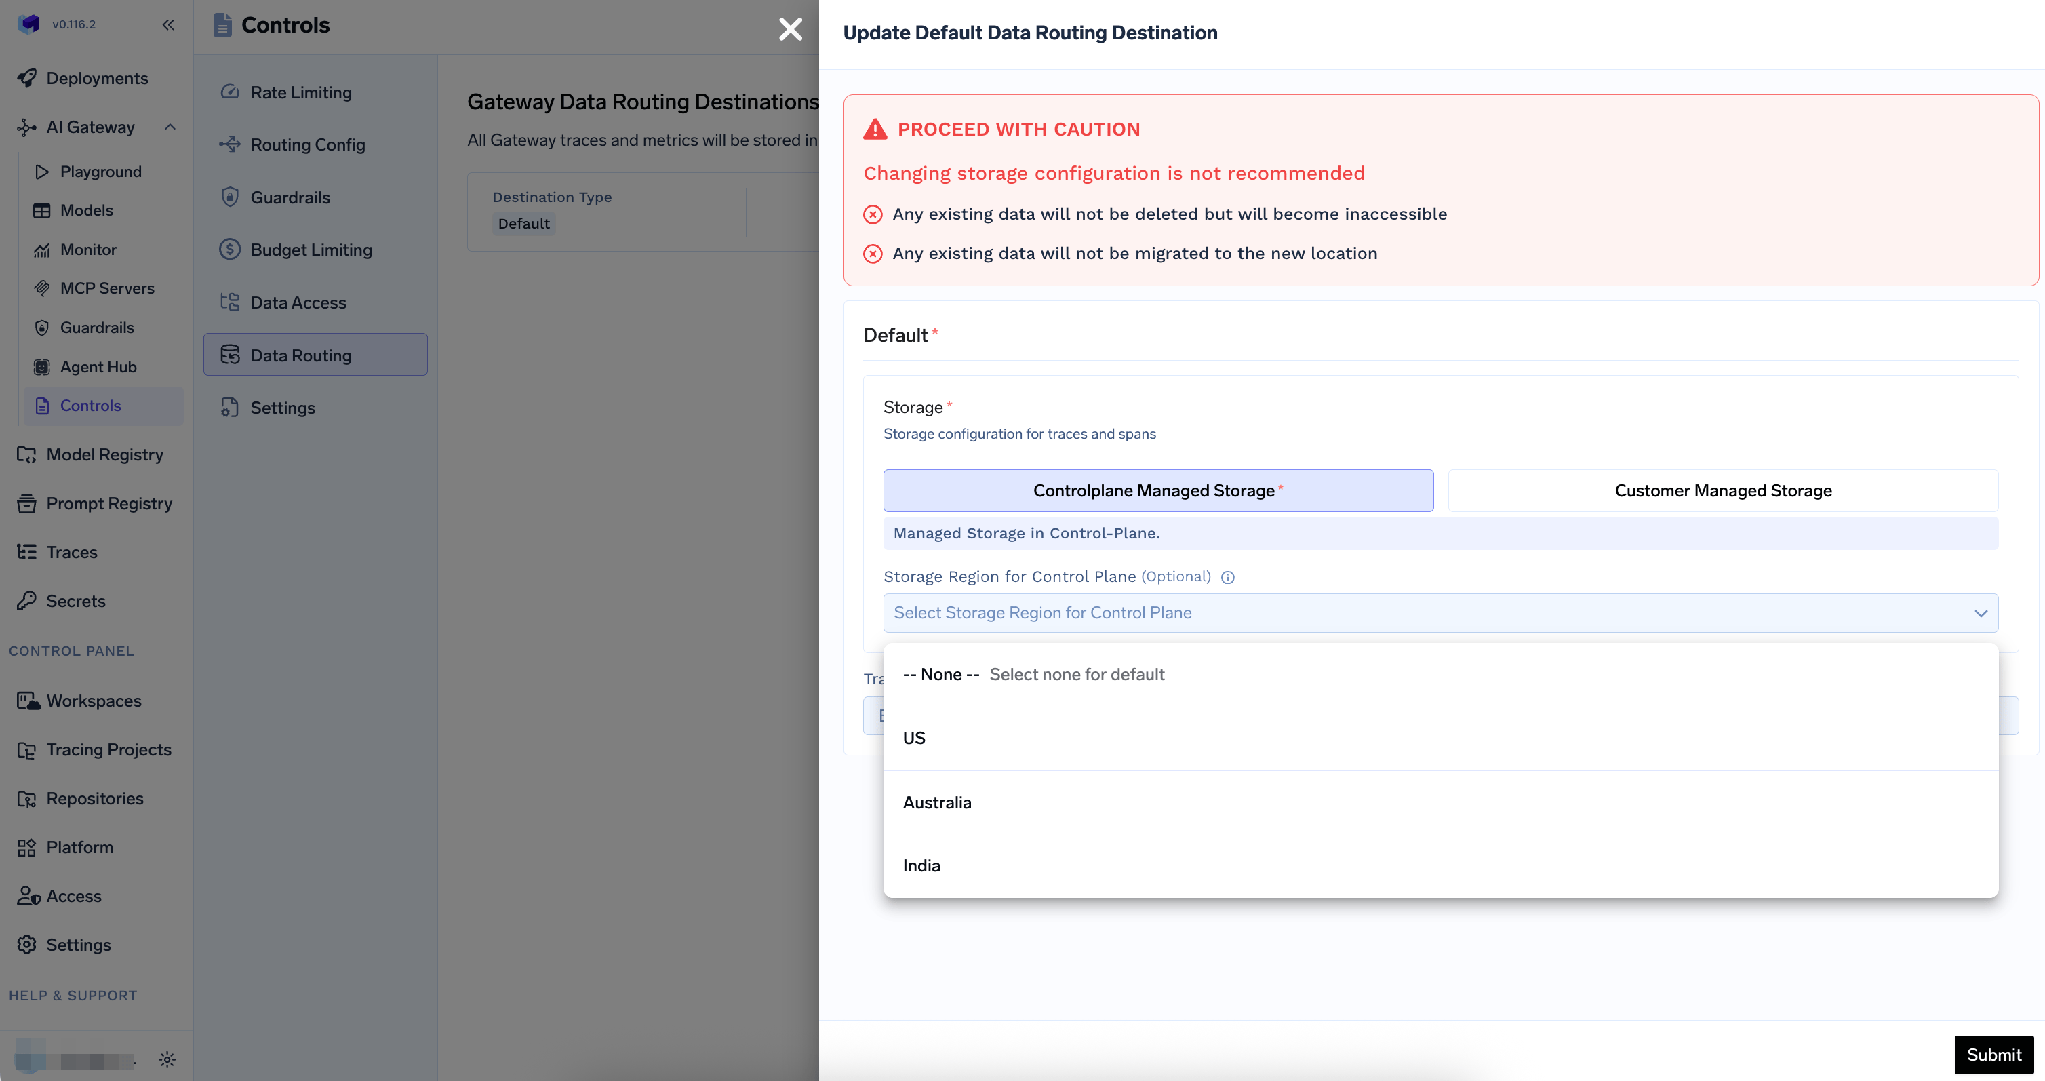
設計上で考慮すべき2つの制約があります。メトリクスは常にデフォルトの送信先に移動し、永続的に保持されます(カスタムルーティングが可能なのはトレースのみです)。また、ストレージ設定を変更しても既存データは移行されません。既存データは削除されませんが、新しい場所からはアクセスできなくなります。
間違った課題を解決しようとしている。 コストを懸念しているチームが、3つのプロバイダー間で重み付け分散を構築するケースがあります。重み付けはどのリクエストが高難度かを認識しないため、請求額はほとんど変わりません。障害を懸念しているチームが Complexity ルーティングを有効にし、プロバイダー障害時にシステムがダウンして驚くケースもあります。メカニズムを選択する前に、解決すべき課題を明確に特定してください。
健全性の低下による格下げが普遍的であると思い込んでいる。 重み付け、優先度、およびレイテンシルーティングでは、障害が発生したターゲットはリストの最後に移動(格下げ)されます。Auto Routing ではこれは適用されず、ターゲットの順序は常にティア順であり、エスカレーションチェーンがフェイルオーバーのパスとなります。ターゲットごとのリトライ、フォールバックステータスコード、レート制限、および予算の設定は引き続き適用されますが、クールダウン動作は適用されません。
分類器が無償であると考えている。 ヒューリスティックは完全に無償です。一方、LLM 分類器は、固定されていないすべてのターンに対して実行される2つ目のモデル呼び出しであり、通常のリクエストと同様に課金され、トレースされます。多くの場合、その分の価値はありますが、不意の請求とならないようコストモデルに組み込んでおく必要があります。
支出上限を設定せずにルーティングを行っている。 コスト意識の高いルーティングは、リクエストあたりの平均コストを下げますが、総支出額を制限するわけではありません。エージェントのループ処理が1回暴走するだけで、コスト削減効果は吹き飛んでしまいます。モデルルーティングは勾配の調整であり、予算ルールは上限の設定です。両方を組み合わせて管理する必要があります。
サポート製品において、すべてのリクエストを最高機能モデルに送信しているケースを考えます。請求額が高額になり、先月はあるプロバイダーの障害が発生し、法務チームからは EU の顧客とのやり取りがどこで処理されているか問われています。1つのアプリケーションで3つの課題すべてが存在する状態です。
ステップ1:モデル選択。 Complexity ルーティングを使用して仮想モデル support/assistant を作成します。simple を高速な小型モデルに、medium を中位モデルに、complex を最高機能モデルに割り当て、ヒューリスティック分類器を有効にします。アプリケーション側で変更するのはモデル名の文字列1つだけです。
マルチターンの動作に追加設定は不要です。各ターンが分類され、ピン留めは上方のみに動作(ラチェット構造)します。4ターン目の難易度が高くなれば会話は上のティアに移動し、5ターン目が「ありがとう」であっても、そのティアにとどまります。ピン留めは10分間の非アクティブ状態で解除され、ターンごとにリセットされます。会話が一度 complex に達すると、それ以降のターンでは分類自体がスキップされます。
ステップ2:ティア内のロードバランシング。 complex ティアに別のプロバイダーの2つ目のターゲットを指定します。同じティア内のターゲットはエスカレーション前に宣言順で試行されるため、最高機能モデルにはフェイルオーバー用のペアが存在することになります。ダッシュボードでは1つのティアにつき1つのターゲットしか指定できないため、この構成には tfy apply または API を使用します。
ステップ3:データルーティング。 EU にデプロイされたターゲットに metadata_match: { tfy_gateway_region: EU } を追加し、その下にキャッチオールを設定します。次に、metadata.region が eu のトレースを EU のバケットに送信する Data Routing 送信先を追加します。
ステップ4:上限(上限設定)。 仮想モデル ID にスコープされた予算ルールにより、ルーティングの動作にかかわらず支出が制限されます。
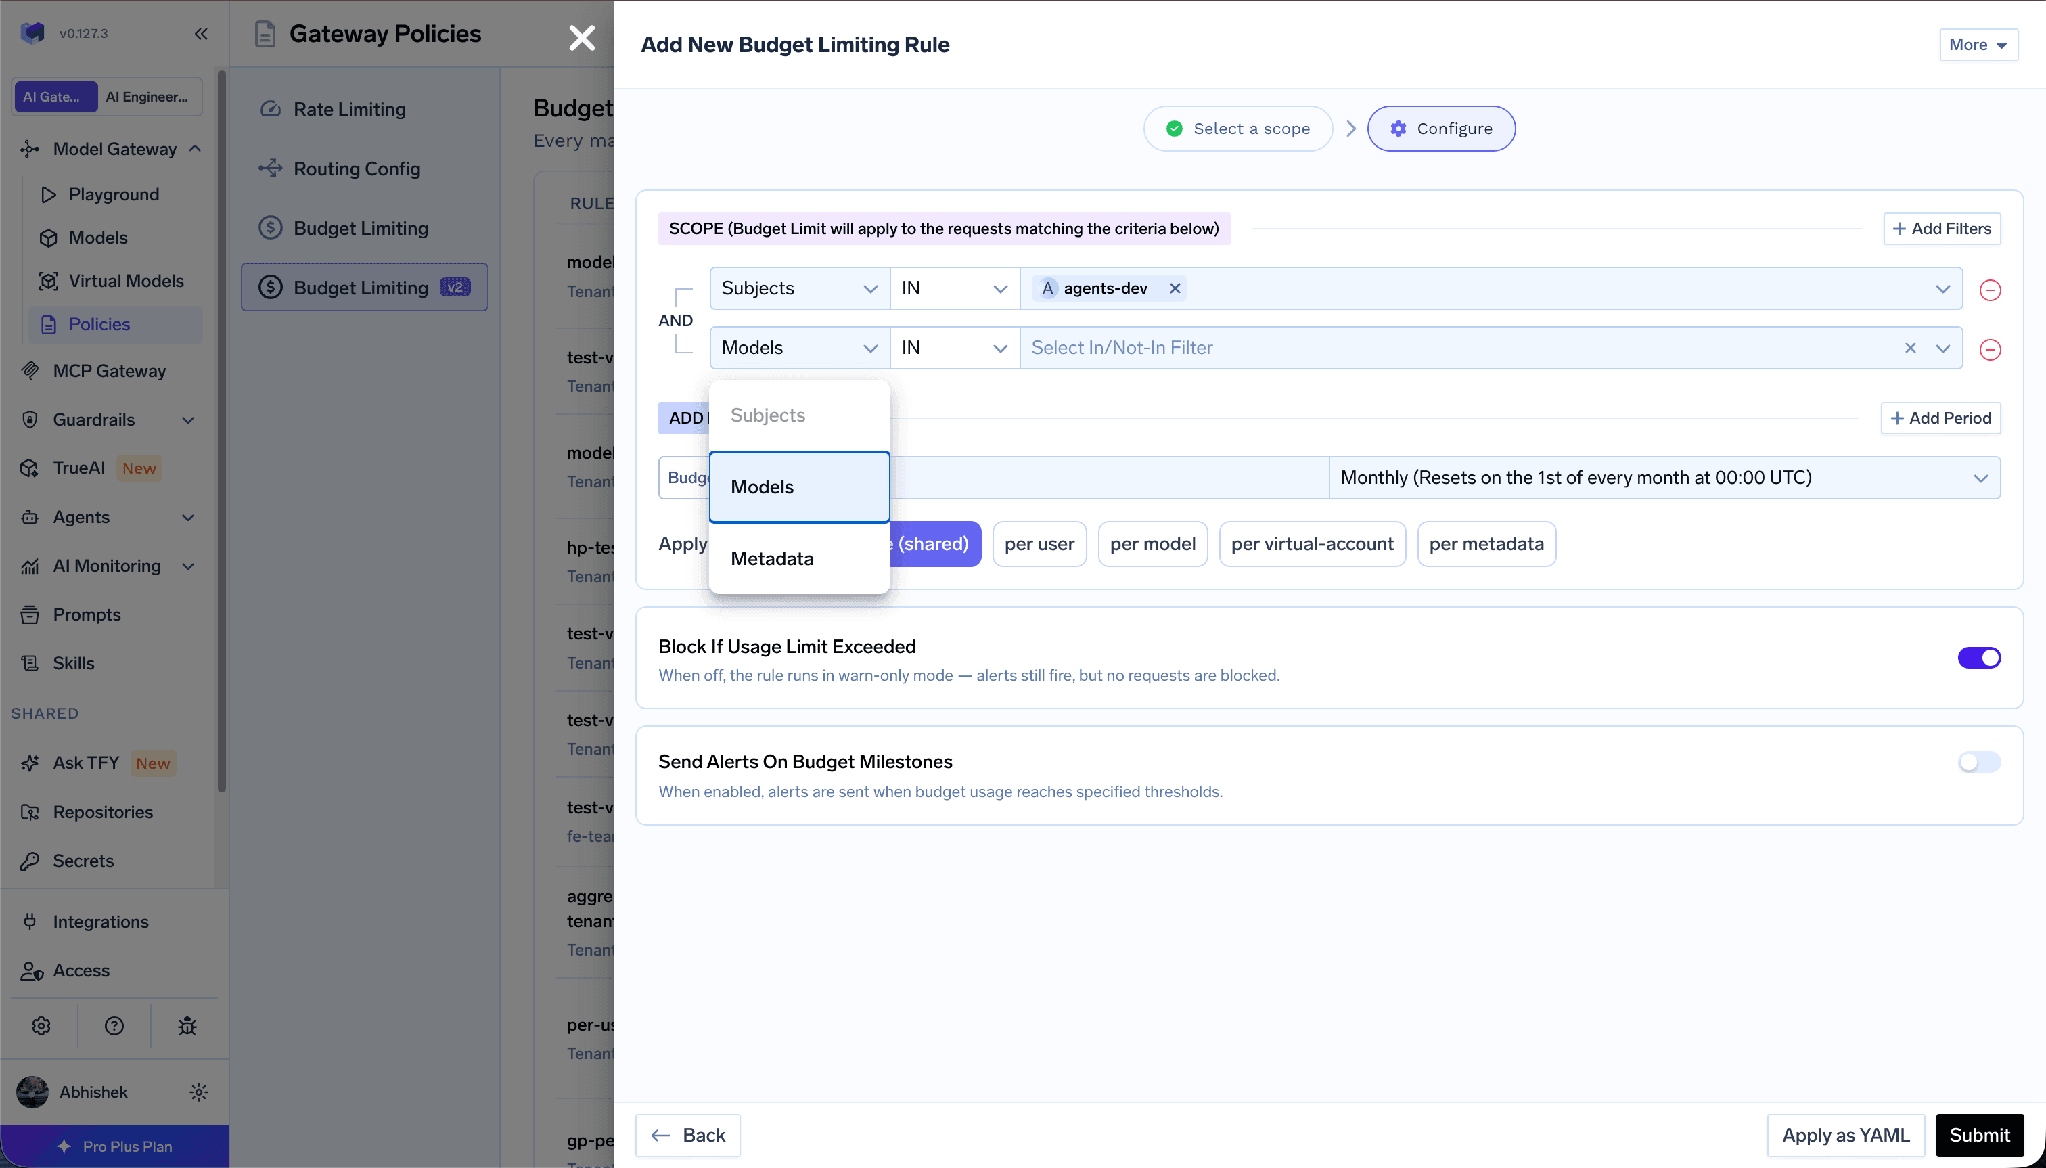
Subjects、Models、Metadata 条件を使用した予算ルールのスコープフィルター
このようなルールは、仮想モデル ID とそれが解決する具体的なターゲットの両方に一致しますが、2つの動作は大きく異なります。適用モードで限界を超えた仮想モデルの予算は、バックエンドが実行される前にリクエスト全体をブロックし、フォールバックターゲットも試行されません。限界を超えた具体的なターゲットの予算は、そのターゲットのみをスキップし、仮想モデルは別のターゲットにフォールバックします。同じ機能であっても、影響範囲は対照的です。
ステップ5:検証。 すべてのレスポンスには、適用されたティア、原因、完全に順序付けされたチェーンを含む x-tfy-applied-rules と、応答したモデルを示す x-tfy-resolved-model が付与されます。カウンター ai_gateway_complexity_routing_decisions_total は、decided_tier、resolved_tier、および cause ごとに分類されます。カタログ値ではなく、実際の削減額を算出するには、各ティアのトラフィックシェアに実際の価格差を乗算してください。
Auto Routing は仮想モデル専用です。 テナントレベルのルーティング YAML 内では有効なルールタイプではなく、埋め込み、画像、音声、リランク、モデレーションモデルタイプでは拒否されます(チャット、補完、レスポンスのみ対応)。混合リストも不可であり、チャットと埋め込みの両方を宣言すると保存時に拒否されます。
エスカレーションは設定されていないティアにも適用されます。 simple と complex のターゲットのみが設定されている場合、medium に分類されたものは complex にエスカレーションされ、ヘッダーにそれが報告されます。これはサポートされている2ティア構成ですが、decided_tier と resolved_tier が session_pin 以外の理由で乖離し続ける場合は、ティアが不足しているか設定が誤っている可能性があります。
分類器は直近の2つのメッセージのみを読み取ります。 読み取られるのは、最後のユーザーメッセージと最後のシステムまたは開発者メッセージ(それぞれ 8,000文字と 2,000文字に制限)のみです。それ以前のターン、アシスタントの返答、ツールメッセージは無視されます。会話全体を通じた一貫性は、履歴の全読取りではなく、ピン留め機能によって維持されます。
「LLM ルーター」という言葉が曖昧に感じられるのは、3つの異なるカテゴリが1つのラベルで呼ばれているためです。ロードバランシングは利用可能性を高めるためのツールであり、ターゲットは相互に交換可能です。モデル選択はコストを最適化するためのツールであり、ターゲットは明確に区別されます。データルーティングはコンプライアンスのためのツールであり、他の2つが機能する前に候補の範囲を制限します。
これらを分離して考えれば、選択はシンプルになります。障害によるリクエストの損失を防ぎたいのか、簡単なリクエストに過剰な費用を支払っているのか、それともデータの保持場所に関する要件に対応したいのか。最初の課題には優先度チェーン、2つ目には複雑度ティア、3つ目にはメタデータマッチングとストレージ送信先の設定が必要です。多くのチームにとって、まずどれか1つが緊急の課題となり、残りは追って必要となります。
コスト削減の手法を採用する際は、公表されている数値を過大評価も過小評価もせず捉えてください。69%の削減効果は実証されています。そして同時に、2%の品質低下というトレードオフが存在することも事実です。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.




LLMルーターは、アプリケーションとモデルの間に位置し、各リクエストをどのモデルまたはデプロイで処理するかを決定します。この用語は3つの異なる役割を含みます。スループットとフェイルオーバーのために互換性のあるターゲット間で行うロードバランシング、安価なモデルと高性能なモデルの間で行うモデル選択、そしてリクエストを処理できる場所とログの保存先を制限するデータルーティングです。それぞれ参照する入力が異なるため、最初に確認すべきなのは、どれが必要なのかという点です。
モデル選択のルーティングでは削減できますが、ロードバランシングとデータルーティングでは通常は削減できません。TrueFoundryのAuto Routingは、採点済みの550件のプロンプトで品質の98%を維持しながら69%のコスト削減を記録し、本番に近いトラフィックでは最大80%に達しました。削減額はトラフィックの構成によって変わります。ルーティング判断のメトリクスを解決された階層ごとに分解し、各階層の割合に価格差を掛けて算出してください。
無料のヒューリスティック分類器を使い、1つの仮想モデルに対して複雑さベースのルーティングを行う構成です。アプリケーションの変更も、分類器の費用も不要だからです。障害によって実際に損失が出たら、2つのプロバイダーにまたがる優先度チェーンを追加してください。データの行き先を尋ねられるようになったら、データルーティングを追加してください。
はい。VPC、オンプレミス、エアギャップ環境、ハイブリッド、複数のクラウドのいずれにもデプロイでき、データがお客様のドメインの外に出ることはありません。
オーバーヘッドはおよそ3〜4ミリ秒で、単一のvCPUで350 RPS以上を処理し、1,000以上のLLMに対応しています。例外はオプションのLLM分類器で、リクエストを転送する前に実際のモデル呼び出しが1回加わります。
はい。ゲートウェイはOpenTelemetryに準拠しており、Grafana、Datadog、Prometheusに接続できます。LLM分類器の呼び出しごとに個別のスパンが生成されるため、分類器のレイテンシを、提供されるモデルのレイテンシとは別に確認できます。






















