


novembre 21, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Travailler avec cinq fournisseurs de modèles signifie utiliser cinq SDK, cinq clés d'API, cinq factures et cinq jeux de limites de débit. OpenRouter simplifie tout cela en un seul point de terminaison. Il vous suffit de faire pointer le SDK OpenAI vers une autre URL de base, de modifier la chaîne du modèle, et le même client peut appeler Claude, Gemini, Llama ou DeepSeek.
Voilà pour la prise en main rapide. En réalité, OpenRouter fonctionne comme une place de marché. La plateforme choisit quelle entreprise traite chaque requête, conserve vos fonds et rémunère les fournisseurs. Nous avons analysé tout le parcours entre votre code et le modèle, chiffres à l'appui issus de nos propres tests.
OpenRouter est une API HTTP hébergée qui achemine les requêtes d'inférence vers des fournisseurs de modèles tiers via un point de terminaison et un identifiant uniques, et vous facture par défaut en fonction de votre utilisation des modèles. Elle accepte trois formats de requête : OpenAI Chat Completions, l'API OpenAI Responses, et l'API Messages d'Anthropic sur /api/v1/messages. Des SDK clients sont disponibles pour TypeScript, Python et Go, mais ils constituent simplement une couche typée au-dessus de la même API REST. Ainsi, le SDK OpenAI standard utilisé avec un baseURL modifié fonctionne tout aussi bien.
OpenRouter fonctionne comme une plateforme biface. D'un côté, la solution recrute des fournisseurs, définit le contrat d'intégration qu'ils doivent respecter et les rémunère. De l'autre, elle conserve vos crédits prépayés et centralise la facturation pour l'ensemble des services. Elle se place ainsi sur le parcours de vos paiements tout comme sur celui de vos requêtes, ce qui la rend très pratique, mais explique aussi pourquoi en repartir nécessite plus qu'un simple changement d'URL.
En l'utilisant, vous louez l'accès à des modèles appartenant à d'autres entreprises. Il n'existe pas de version d'OpenRouter auto-hébergée ou isolée du réseau (air-gapped), et le cœur du produit est propriétaire. Seuls les SDK et la documentation sont publics. À l'origine, le projet était une extension Chrome appelée Window permettant d'utiliser plusieurs modèles simultanément. Depuis, la plateforme s'est enrichie d'outils côté serveur tels que la recherche web, la récupération de pages web et l'exécution de commandes dans un environnement sécurisé (sandbox shell) que les modèles peuvent appeler en cours de requête.
Une requête suit les étapes suivantes :
https://openrouter.ai/api/v1 avec une clé d'API unique, dans l'un des trois formats pris en charge.vendor/model, est résolue en une liste de points de terminaison de fournisseurs hébergeant ce modèle.sort, de order, de only et de politique de données prévalent sur ce comportement.attempt dans la réponse constitue la seule indication intégrée qu'un basculement a eu lieu.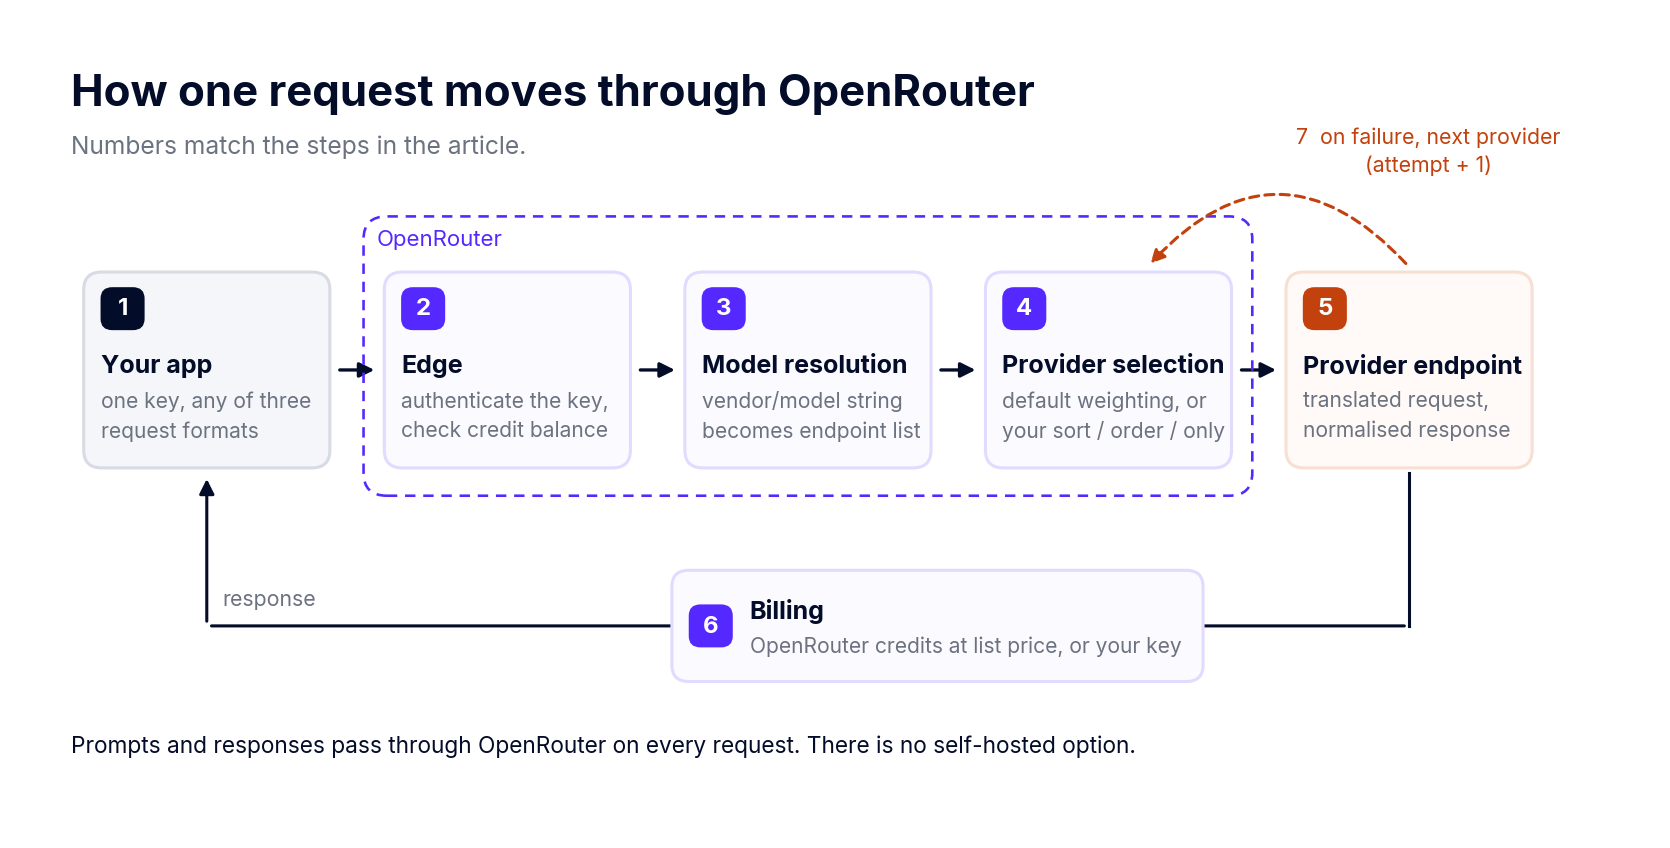
La chaîne identifiant le modèle n'indique pas qui l'exécute réellement. Le préfixe du fournisseur indique à qui appartient le modèle, pas sur quels serveurs il est hébergé. Lors de nos tests sur anthropic/claude-3-haiku, le service était assuré par Amazon Bedrock.
Pour les modèles open-weight, l'écart est encore plus marqué. Le 5 octobre, l'API d'OpenRouter listait 11 points de terminaison pour meta-llama/llama-3.3-70b-instruct. Entre ces 11 options :
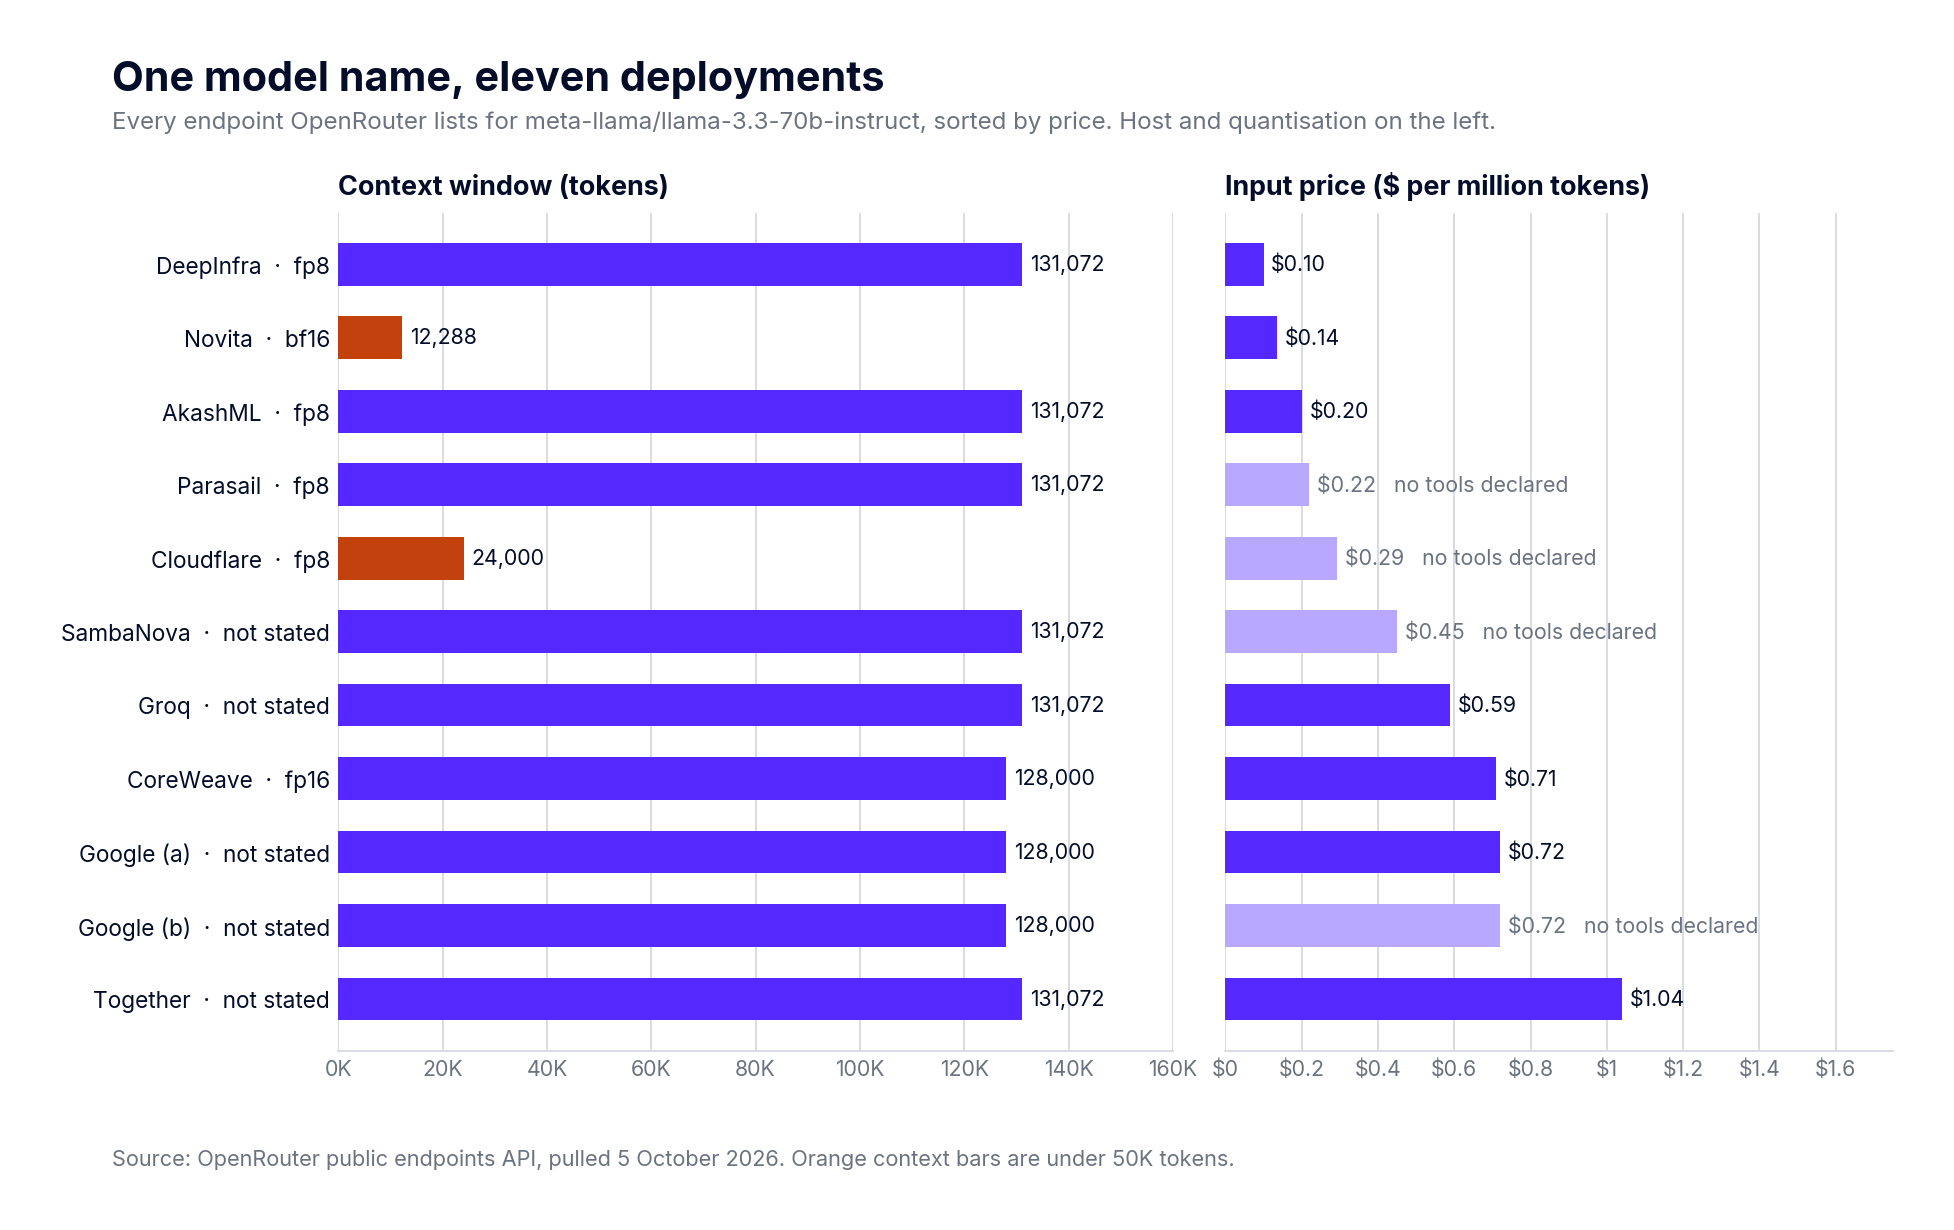
Un même nom peut ainsi masquer des produits très différents. Si vos prompts sont longs, le point de terminaison à 12K et celui à 131K ne sont pas interchangeables, et le routeur par défaut effectue son choix en partie sur la base du prix. OpenRouter filtre les options en fonction des fonctionnalités requises : lorsque nous avons envoyé huit requêtes avec tool_choice: required sans verrouiller de fournisseur, chacune a été dirigée vers un hôte déclarant la prise en charge des outils. Cependant, une fonctionnalité déclarée ne garantit pas son bon fonctionnement. Un hôte qui affichait le support des outils n'a renvoyé aucun appel d'outil lorsque nous avons forcé son utilisation en le sélectionnant spécifiquement.
Consultez la documentation /api/v1/models/{model}/endpoints avant de vous fier à une chaîne de modèle, et pensez à verrouiller ou filtrer les fournisseurs dès que la quantification, la longueur de contexte ou le comportement des outils sont critiques pour votre usage.
L'API d'OpenRouter comptait 466 modèles répartis sur 65 espaces de noms de fournisseurs au 5 octobre, contre 428 lors de notre premier relevé le 8 septembre. Les modèles d'embedding disposent d'un point de terminaison distinct, /api/v1/embeddings/models, qui en référençait 33 de plus. En additionnant l'ensemble, on s'approche des "500+ modèles" annoncés sur la page des tarifs d'OpenRouter. Le décompte des fournisseurs est moins direct : le point de terminaison des fournisseurs renvoyait 112 entrées (dont une nommée FakeProvider), alors que le support marketing en annonce "80+". Interrogez directement l'API plutôt que de vous fier aux chiffres d'un article de blog, y compris celui-ci.
La route par défaut répartit le trafic sans chercher à optimiser spécifiquement le prix ou la vitesse. Lors de nos tests en septembre sur Llama 3.3 70B, avec huit requêtes par stratégie, le choix par défaut s'est avéré le plus lent avec une médiane de 935 ms, pour un coût deux fois supérieur à celui de sort: price. La stratégie sort: throughput a été la plus rapide (289 ms), devant sort: latency (347 ms), tandis qu'un rapport de 1 à 10 séparait la stratégie la moins chère de la plus coûteuse pour un prompt identique. Évaluer huit requêtes suffit à vérifier que les directives fonctionnent et produisent des résultats différents, mais cet échantillon reste trop réduit pour établir un classement définitif des hôtes. Si le coût ou la vitesse sont prioritaires pour vous, définissez un critère de tri explicite.
Deux précisions concernant les mécanismes de secours (fallbacks) : si un identifiant de fournisseur est mal orthographié dans order, il est ignoré silencieusement au lieu d'être rejeté, ce qui restreint simplement votre liste d'options. De plus, comme indiqué précédemment, le champ attempt est le seul indicateur signalant qu'un basculement a eu lieu.
Le SDK OpenAI s'intègre de manière transparente, ce qui suffit pour la majorité du trafic de chat. Les rares exceptions concernent des paramètres non pris en charge par une route spécifique : ceux-ci sont généralement acceptés avec un code 200 mais ignorés lors du traitement. Nous avons transmis le paramètre prediction d'OpenAI à GPT-4o mini, qui indique le prendre en charge, et avons reçu une réponse standard sans qu'aucun élément ne confirme sa prise en compte réelle. Si un paramètre influe sur le résultat ou sur votre facturation, vérifiez systématiquement dans la réponse qu'il a bien été appliqué.
Vous payez le tarif public du fournisseur par token, sans surcoût appliqué par OpenRouter sur l'utilisation. La marge du service provient des frais prélevés lors de l'achat de crédits : 5,5 % sur la formule Standard (avec un minimum de 0,80 $), 8 % sur la formule Business, et 5 % pour les paiements en cryptomonnaie. Si vous utilisez votre propre clé fournisseur, aucun frais n'est appliqué sur les premiers 25 000 $ d'utilisation mensuelle au tarif public, puis une commission de 5 % s'applique au-delà. Les crédits peuvent expirer un an après leur achat. La grille tarifaire ayant évolué à deux reprises en quatorze mois, vérifiez la page des tarifs d'OpenRouter avant d'établir vos prévisions financières. Vous trouverez plus de détails dans notre analyse de la tarification d'OpenRouter.
Les prompts et les réponses transitent systématiquement par OpenRouter. Il n'est pas possible d'héberger le service vous-même ni de le faire fonctionner en réseau isolé. Sur la version hébergée, les options de contrôle disponibles incluent le routage sans rétention de données, un filtre data_collection: "deny" garantissant que les requêtes ne sont envoyées qu'à des fournisseurs ne collectant pas vos données, et le routage régional. Auparavant réservé aux contrats Enterprise, le routage régional est accessible depuis septembre sur le forfait Business en libre-service : en envoyant vos requêtes vers eu.openrouter.ai ou us.openrouter.ai, celles-ci sont traitées exclusivement dans la région ciblée, ou renvoient une erreur si aucun point de terminaison local n'est disponible. Notez les contraintes associées : les fonctionnalités de journalisation des prompts et réponses d'OpenRouter sont désactivées sur les points de terminaison régionaux, et les traitements en lot (Batch), la recherche web, le sandbox shell, la gestion de fichiers/images ainsi que l'Auto Router y sont indisponibles.
Ces deux sujets font l'objet d'articles dédiés. Notre guide sur les limites de débit d'OpenRouter explique pourquoi le plafond d'utilisation des modèles gratuits dépend de votre historique de paiement, tandis que l'article sur le prompt caching sur OpenRouter détaille pourquoi cette fonction de mise en cache affiche neuf niveaux de prix différents.
La documentation d'OpenRouter indique que le service fonctionne en edge afin de réduire le surcoût au minimum. La page d'accueil affichait autrefois une valeur indicative d'environ 25 ms, reprise dans de nombreux guides. Depuis le 5 octobre, le site mentionne simplement une "latence minimale". La documentation apporte toutefois une précision : lorsque votre solde de crédits devient bas, OpenRouter invalide plus fréquemment ses caches en edge afin de maintenir une facturation exacte, ce qui génère de la latence jusqu'au réapprovisionnement de votre compte.
Nous avons mesuré cet impact en envoyant une même série de 100 prompts selon trois modalités : directement au fournisseur, via OpenRouter en utilisant des crédits, et via OpenRouter avec notre propre clé fournisseur. Les requêtes ont été entrelacées et associées par prompt pour neutraliser l'effet du contenu sur les écarts mesurés, chaque requête étant verrouillée sur le fournisseur officiel du modèle et vérifiée individuellement.
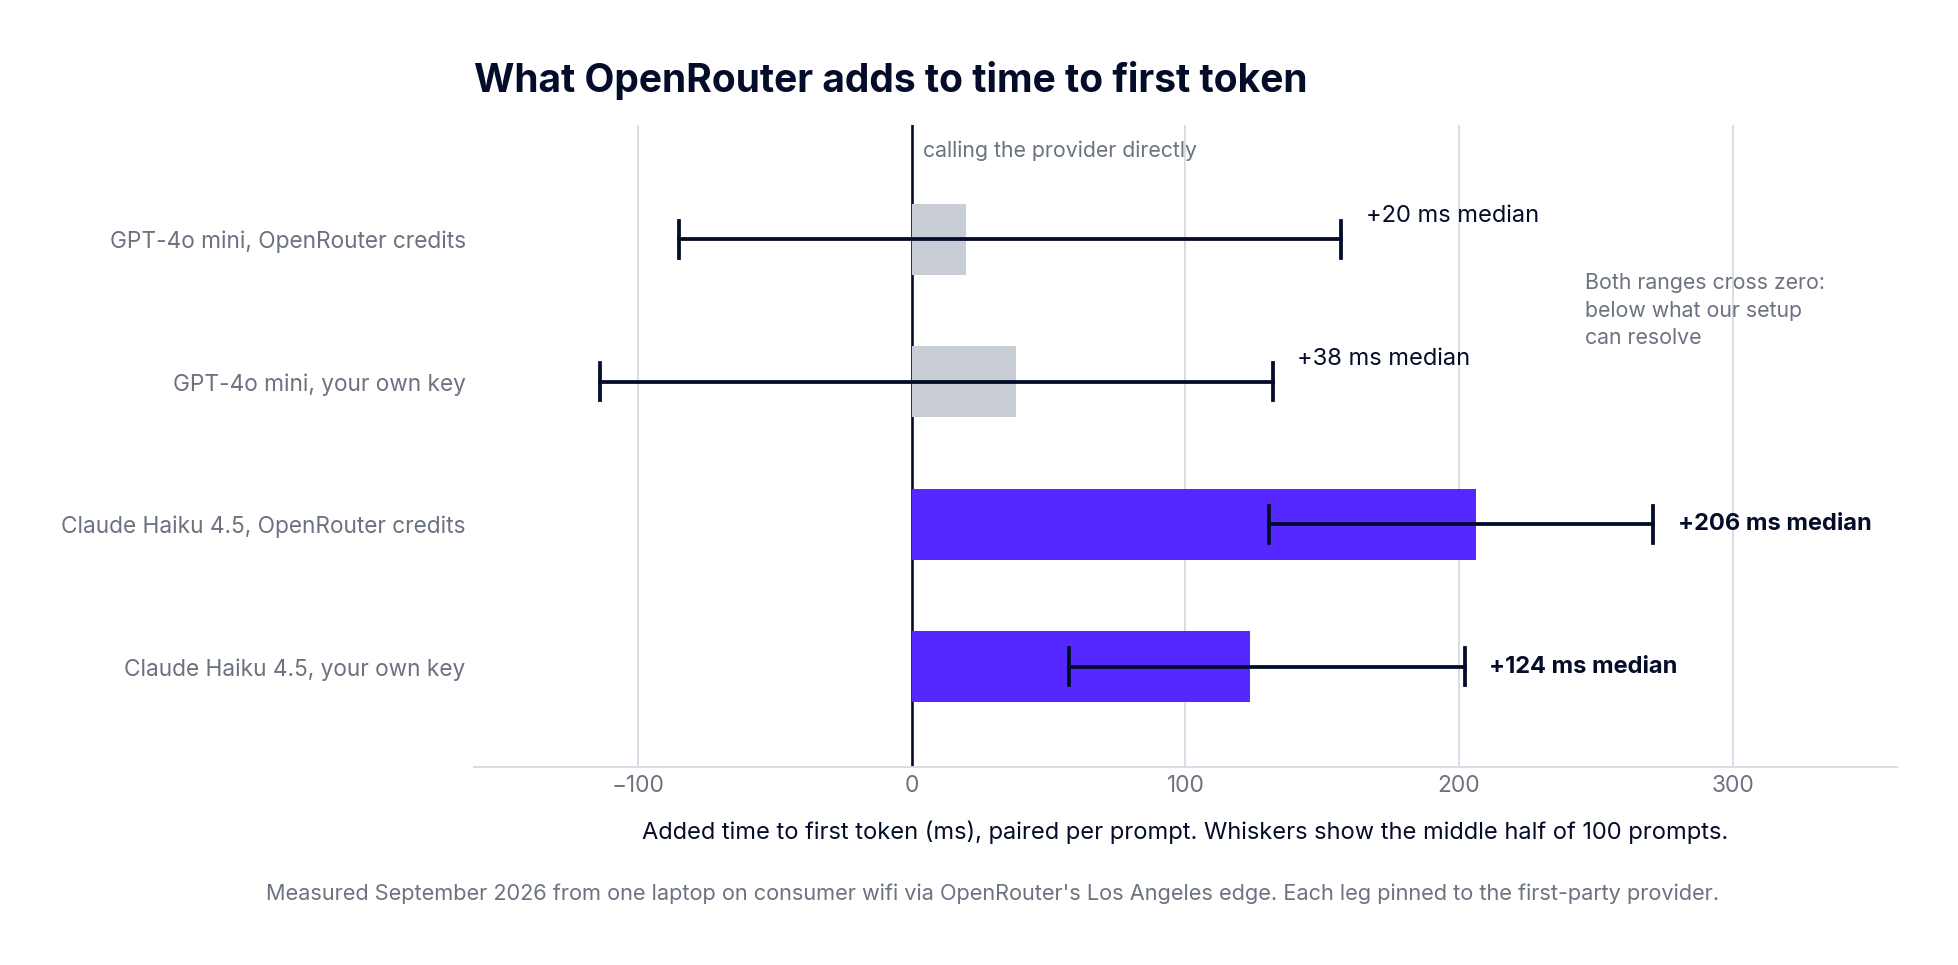
Sur GPT-4o mini, aucun surcoût mesurable n'a été constaté. Le temps supplémentaire médian jusqu'au premier token s'est élevé à 19,7 ms avec l'utilisation de crédits, mais la moitié centrale des résultats s'échelonnait de -85 ms à +157 ms, ce qui place la valeur réelle en dessous du seuil de résolution de notre protocole. Sur Claude Haiku 4.5, l'effet est très net : 206 ms ajoutées avec les crédits et 124 ms avec notre propre clé, l'écart interquartile restant nettement supérieur à zéro. Sans streaming, sur deux séries de tests, l'utilisation des crédits a ajouté 837 ms et 883 ms au temps de réponse global, tandis qu'avec notre propre clé, l'écart par rapport à l'accès direct n'a pas dépassé 42 ms.
Les requêtes basées sur des crédits et celles utilisant une clé personnelle empruntent la même passerelle et les mêmes étapes de traduction. La différence provient donc du compte amont utilisé. Notre hypothèse principal – découlant de nos observations – pointe vers une saturation de la capacité Anthropic partagée d'OpenRouter. Sur un fournisseur très sollicité, utiliser votre propre clé vous permet d'optimiser la latence tout en conservant le contrôle de votre facturation.
L'ensemble de ces mesures a été réalisé en septembre 2026 depuis un poste unique sur une connexion grand public, via le point de terminaison d'OpenRouter à Los Angeles. Les écarts constatés reflètent des tendances réelles, tandis que les valeurs absolues restent spécifiques à notre environnement de test.
OpenRouter a été fondé en 2023 par Alex Atallah, ancien cofondateur d'OpenSea. Le 19 août 2026, Stripe a annoncé avoir conclu un accord en vue de son acquisition. Début octobre, la finalisation de la transaction n'avait pas encore été officialisée et aucun montant n'a été rendu public par les deux entreprises, la presse évoquant une valorisation supérieure à 7 milliards de dollars. OpenRouter a indiqué que son offre de produits et ses engagements resteraient inchangés.
Le modèle d'affaires d'OpenRouter reposant sur une commission sur les paiements, sa grille tarifaire sera définie par un spécialiste du secteur bancaire, et la neutralité de la plateforme envers les différents fournisseurs relève d'une orientation stratégique affichée plutôt que d'une contrainte d'architecture. Toute équipe prévoyant de s'appuyer sur cette infrastructure pour les deux prochaines années gagnera à intégrer ces éléments dans son évaluation, au même titre que les performances de routage et de latence, avant d'arrêter sa décision.
OpenRouter est souvent comparé aux passerelles LLM auto-hébergées comme LiteLLM ou la nôtre. Bien que ces deux approches unifient l'accès à de multiples modèles derrière une API unique, elles répondent à des besoins différents. Notre guide expliquant ce qu'est une passerelle LLM détaille les principes généraux de cette architecture.
Deux points méritent une précision. Le plan de contrôle et le plan de données d'OpenRouter reposent sur le même système : en cas d'interruption du service, l'ensemble des modèles sous-jacents devient inaccessible. Le blog technique d'OpenRouter fait ainsi état d'une panne de base de données d'environ 50 minutes en août 2025 ayant interrompu le routage, tout en soulignant que la disponibilité globale reste supérieure à celle d'un fournisseur unique. Lors de nos propres bancs d'essai sur environ 4 300 requêtes, nous n'avons rencontré aucune erreur 4xx ou 5xx. Concernant la gestion des accès, les clés d'API sont rattachées au compte de leur créateur ; désactiver cet utilisateur via SCIM révoque l'ensemble de ses clés, un fonctionnement adapté aux utilisateurs individuels mais qui peut poser problème pour des charges de travail en production.
OpenRouter est particulièrement adapté au prototypage sur un large panneau de modèles, lorsqu'il est préférable d'utiliser une seule clé et une facture unique plutôt que de souscrire des contrats auprès de chaque fournisseur. La solution convient également à l'utilisation de modèles open-weight, pour lesquels sélectionner l'hébergeur selon le prix ou le débit permet de réaliser des économies substantielles, à condition que vos prompts puissent sortir de votre réseau (avec ou sans contraintes régionales).
À l'inverse, la solution n'est pas recommandée si vos prompts doivent impérativement rester sur votre réseau privé, si vos applicatifs nécessitent des identités machines plutôt que des clés rattachées à des personnes, ou si le risque qu'une panne globale rende l'ensemble de vos modèles indisponibles est inacceptable. Ces réserves s'appliquent également si la latence est critique sur un fournisseur très sollicité et que vous ne pouvez pas utiliser votre propre clé, ou si vos règles d'achats imposent des contrats directs avec chaque fournisseur.
La passerelle TrueFoundry AI Gateway s'exécute directement dans votre VPC, sur site ou dans un environnement isolé (air-gapped), et communique avec les fournisseurs via vos propres contrats et clés d'API. Elle donne accès à plus de 1 000 LLM à travers une API unique compatible OpenAI, n'ajoute qu'environ 3 à 4 ms de latence et traite plus de 350 RPS sur un seul vCPU.
Vous pouvez parfaitement conserver OpenRouter dans cette architecture. La plateforme est prise en charge comme fournisseur dans TrueFoundry, ce qui vous permet de garder l'accès à son catalogue pour vos expérimentations tout en appliquant vos propres règles de débit, de budget, de contrôle d'accès et de journalisation en amont. Pour les équipes exploitant déjà OpenRouter, cette approche constitue généralement la transition la plus sûre.
OpenRouter propose une API unique connectée à une place de marché. La plateforme choisit le fournisseur de chaque requête, gère votre solde de crédits et rémunère les intervenants. Avant de considérer une chaîne de modèle comme un composant immuable, prenez le temps d'analyser la liste des points de terminaison, de configurer vos critères de tri et de mesurer la latence réelle sur les fournisseurs que vous sollicitez.
Si vous souhaitez déployer cette API unique au cœur de votre propre infrastructure, découvrez le fonctionnement de TrueFoundry AI Gateway.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.




OpenRouter is a hosted, OpenAI-compatible API that gives you access to hundreds of AI models from many providers through one endpoint and one API key. It picks which provider serves each request, bills you at the provider's list price, and charges a fee when you buy credits. You cannot run it yourself, so prompts always pass through OpenRouter's infrastructure.
Partly. OpenRouter offers free variants of some models, capped at 20 requests per minute and 50 requests per day, rising to 1,000 a day once you've bought at least 10 credits. Paid models are billed at the provider's list price, plus a fee on each credit purchase. Our post on OpenRouter rate limits has the detail.
It depends on the provider. In our paired testing, the added time to first token on GPT-4o mini was too small to measure, while Claude Haiku 4.5 on OpenRouter credits added about 206 ms, or about 124 ms with our own Anthropic key. OpenRouter itself no longer publishes an overhead figure.
Oui. TrueFoundry s'exécute dans votre VPC, on-premise, en environnement air-gapped ou en hybride, de sorte que les prompts et les réponses ne quittent jamais votre domaine, même lorsque vous routez vers de nombreux fournisseurs.



Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception















