



novembre 20, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Published: novembre 20, 2026

Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Si vous faites tourner Slack via un agent sur Opus, voici un chiffre inconfortable. Sonnet 4.6 en effort élevé, doté d'un fichier de skill de 55 lignes, a réussi 56 tâches sur 63. Soit 88,9 %. Opus 4.8 en effort élevé sans aucun skill a également réussi 56 tâches sur 63. L'exécution de Sonnet a coûté 4,28 $. Celle d'Opus a coûté 6,81 $. La tâche médiane était également 12 % plus rapide sur Sonnet.
Le réflexe évidents consiste donc à fournir le même fichier à Opus et à le regarder prendre le large. C'est ce que nous avons fait. Opus avec le skill a réussi 55 tâches sur 63. Fable 5, qui avait démarré au-dessus de 90 %, a fini à 85,7 %. Sur un prompt donné, Opus est passé de 3 réussites sur 3 sans le skill à 0 sur 3 avec. Et l'échec n'est pas subtil : il a listé les membres d'un canal, a récupéré leurs ID d'utilisateur, puis s'est arrêté parce que le fichier indiquait « faites un seul appel, puis arrêtez-vous ». Sonnet a lu la même ligne mais a tout de même continué pour rechercher les noms.
Voilà qui résume l'ensemble des résultats. Un skill vaut exactement l'écart qu'il comble. Sur un modèle plus modeste, l'écart est large et un court index comble la majeure partie du retard, pour un coût inférieur à celui du grand modèle livré à lui-même. Sur un modèle proche du plafond, l'écart est étroit, et une règle rédigée pour les cas ambigus est suivie avec le plus de zèle par le modèle qui en avait le moins besoin.
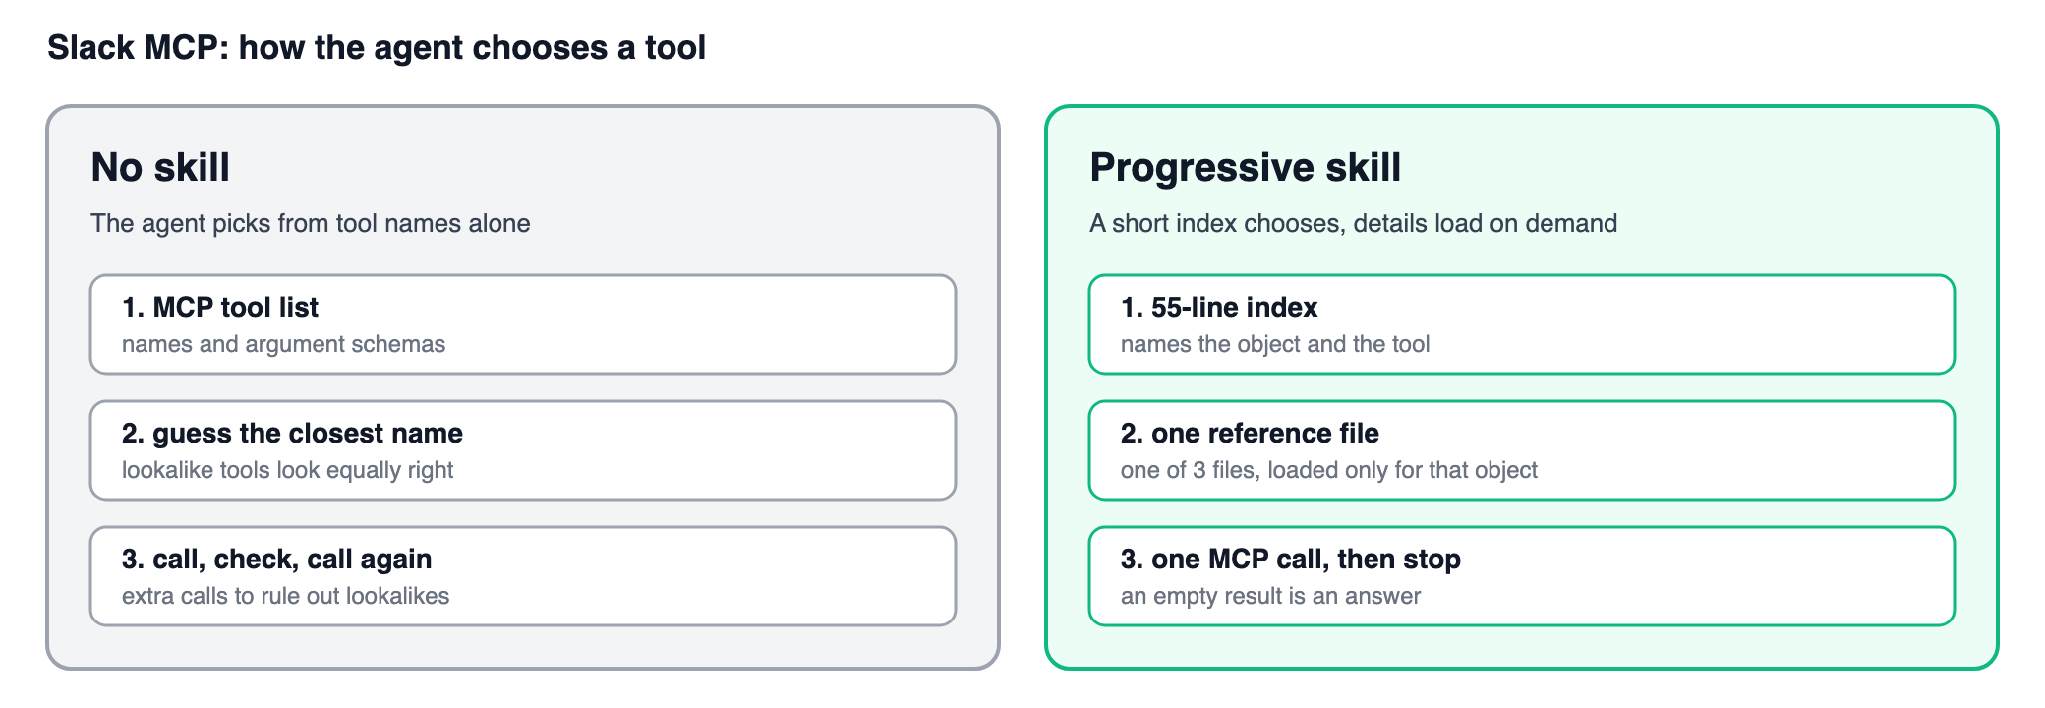
Lorsqu'une équipe constate qu'un skill améliore la précision sur un serveur MCP, deux idées reçues s'imposent souvent. Premièrement, que les directives n'ont aucun inconvénient, qu'il faut rédiger des règles larges et les faire lire à chaque modèle. Deuxièmement, que le modèle le plus puissant en bénéficie le plus, car il suit mieux les instructions. Slack contredit ces deux affirmations.
La première idée fausse s'effondre parce qu'un skill n'aide que là où le modèle manquait d'un élément de distinction. La plupart des outils de Slack sont faciles à différencier. Envoi, brouillon et programmation sont explicites dans le nom des outils, et un modèle performant les a utilisés correctement presque à chaque fois sans aucune aide. Lorsque la liste des outils fait déjà le travail, un skill n'apporte aucune précision supplémentaire. Il ne fait qu'ajouter une règle dont le modèle n'avait pas besoin, et une règle peut être suivie de façon trop rigide.
La seconde idée reçue échoue pour la même raison, prise à l'envers. Le modèle qui suit le mieux les instructions est aussi celui le plus susceptible d'obéir aveuglément à la consigne « faites un appel, puis arrêtez-vous », précisément au moment où il s'apprêtait à accomplir une action utile. Opus avait déjà cherché les noms des membres de sa propre initiative. Fable avait déjà franchi le filtre des DM de lui-même. Le skill ne leur a rien appris. Il leur a fourni une ligne générale succincte, et ils l'ont suivie au pied de la lettre, plus qu'ils ne l'auraient fait de leur propre chef.
L'aspect financier découle directement de cela. La question n'est pas de savoir si un skill rembourse ses tokens. L'agent optimisé a consommé légèrement moins de tokens d'entrée et a passé environ un tiers d'appels en moins, le fichier s'est donc rentabilisé sur le simple critère du coût. La question est de savoir de quel modèle vous avez réellement besoin au départ. Si un index de 55 lignes permet à Sonnet d'égaler Opus, le skill ne fait pas que vous faire économiser des tokens sur une exécution : il modifie la catégorie de modèle requise pour votre charge de travail.
L'exemple. « Qui est membre de mcp-gateway ? » La liste des membres renvoie des ID d'utilisateur. Une réponse utile recherche ces ID et fournit des noms. Opus 4.8 en effort élevé, sans skill : 3 réussites sur 3, en listant les membres puis en lisant les profils pour répondre avec les noms. Même modèle, même prompt, avec le skill : 0 réussite sur 3. Une tentative a recherché le canal, listé les membres deux fois, puis s'est arrêtée. La réponse contenait des ID d'utilisateur, sans aucun nom. Sonnet 4.6 avec le même skill a réussi 3 essais sur 3 et a mené à bien la recherche des noms.
Les chiffres. 21 tâches Slack, six configurations Claude, trois exécutions chacune. Tous modèles confondus, la précision est passée de 83,3 % à 86,5 %. En effort élevé, Sonnet avec le skill est passé de 66,7 % à 88,9 %, soit le même résultat qu'Opus sans skill, pour 4,28 $ contre 6,81 $. Opus avec le skill a atteint 87,3 %. En effort moyen, Sonnet est passé de 74,6 % à 84,1 % et Opus est resté stable à 87,3 %. Fable est passé de plus de 90 % à 85,7 % dans les deux configurations, soit une baisse de 3 ou 4 exécutions sur 63 ; l'ampleur exacte reste incertaine, mais les échecs spécifiques sont bien réels. Le nombre d'appels d'outils par tâche a chuté de 2,52 à 1,71. Le coût total du benchmark est passé de 46,10 $ à 44,01 $.
Ce qu'il faut en retenir. Adaptez le skill au modèle, puis élaguez-le. Un skill apporte de la valeur là où le modèle ne percevait pas une nuance : une fonctionnalité absente du serveur, un périmètre de recherche, une consigne d'écriture explicite de l'utilisateur. Lorsque les noms d'outils suffisent à clarifier le choix, un modèle performant y arrive seul, et une règle trop générale risque de bloquer un travail qu'il aurait mené à terme. Rédigez chaque règle de manière ciblée pour corriger une confusion précise, et testez toute nouvelle règle sur votre modèle le plus robuste avant de la valider.
Même méthodologie que pour le test Linear. Une seule variable modifiée.
Les tâches. 21 prompts Slack conçus autour de la portée de recherche, des fils de discussion, des brouillons et programmations, des canvases, des listes, des imports de fichiers, des fonctionnalités manquantes et du consentement. « Qu'avons-nous décidé ? » peut impliquer une recherche dans tout le workspace, dans les derniers messages d'un canal, ou dans les réponses d'un unique message. « Envoie ceci » peut signifier un envoi immédiat, un brouillon à valider, ou un message programmé pour demain. « Rédige ceci » peut désigner un canvas, une liste ou un fichier. Nous avons sélectionné ces tâches pour leur caractère ambigu, ce qui les rend plus difficiles que le trafic Slack ordinaire.
Les données. Les réponses de Slack provenaient d'un enregistrement figé. Les deux groupes ont traité des données strictement identiques, et aucune écriture n'a touché un véritable workspace.
Les modèles. Sonnet 4.6, Opus 4.8 et Fable 5, chacun évalué en effort moyen et élevé. Soit six configurations, trois exécutions par tâche, dans un environnement réinitialisé à chaque fois. 378 exécutions avec le skill et 378 sans.
Les deux groupes.
Le skill. Un index SKILL.md de 55 lignes consulté en permanence par l'agent. Il répertorie les objets, une méthode rapide pour choisir entre eux, un tableau de paires similaires et les limites du serveur. Trois fichiers de référence détaillent les arguments pour la recherche, la rédaction et les artefacts. Lors d'une tâche type, l'agent identifie l'emplacement du contenu (un sujet sans ancrage unique relève de la recherche globale, les récents messages d'une conversation relèvent de l'historique du canal, les réponses à un message précis relèvent d'un thread), convertit les noms de canaux en ID, ouvre le fichier de référence concerné si nécessaire, effectue un seul appel, puis s'arrête.
La notation. Une tâche est considérée comme réussie uniquement si l'agent a sélectionné les bons outils dans le bon ordre, respecté les consignes de sécurité et fourni une réponse finale exacte. Un juge distinct basé sur Opus 4.8 a évalué les réponses sans savoir si un skill était activé. Trois essais par tâche constituent un échantillon restreint, deux des critères de validation reposent sur une évaluation automatisée par le modèle, et l'utilisation de données réexploitées élimine la latence réelle des API.
Les tâches, les skills, les grilles d'évaluation et la procédure de reproduction sont accessibles dans le dépôt public mcp-skillbench.
La précision globale a légèrement progressé, passant de 83,3 % à 86,5 %. L'évolution intéressante s'observe au niveau de chaque modèle.
Par modèle et par niveau d'effort.
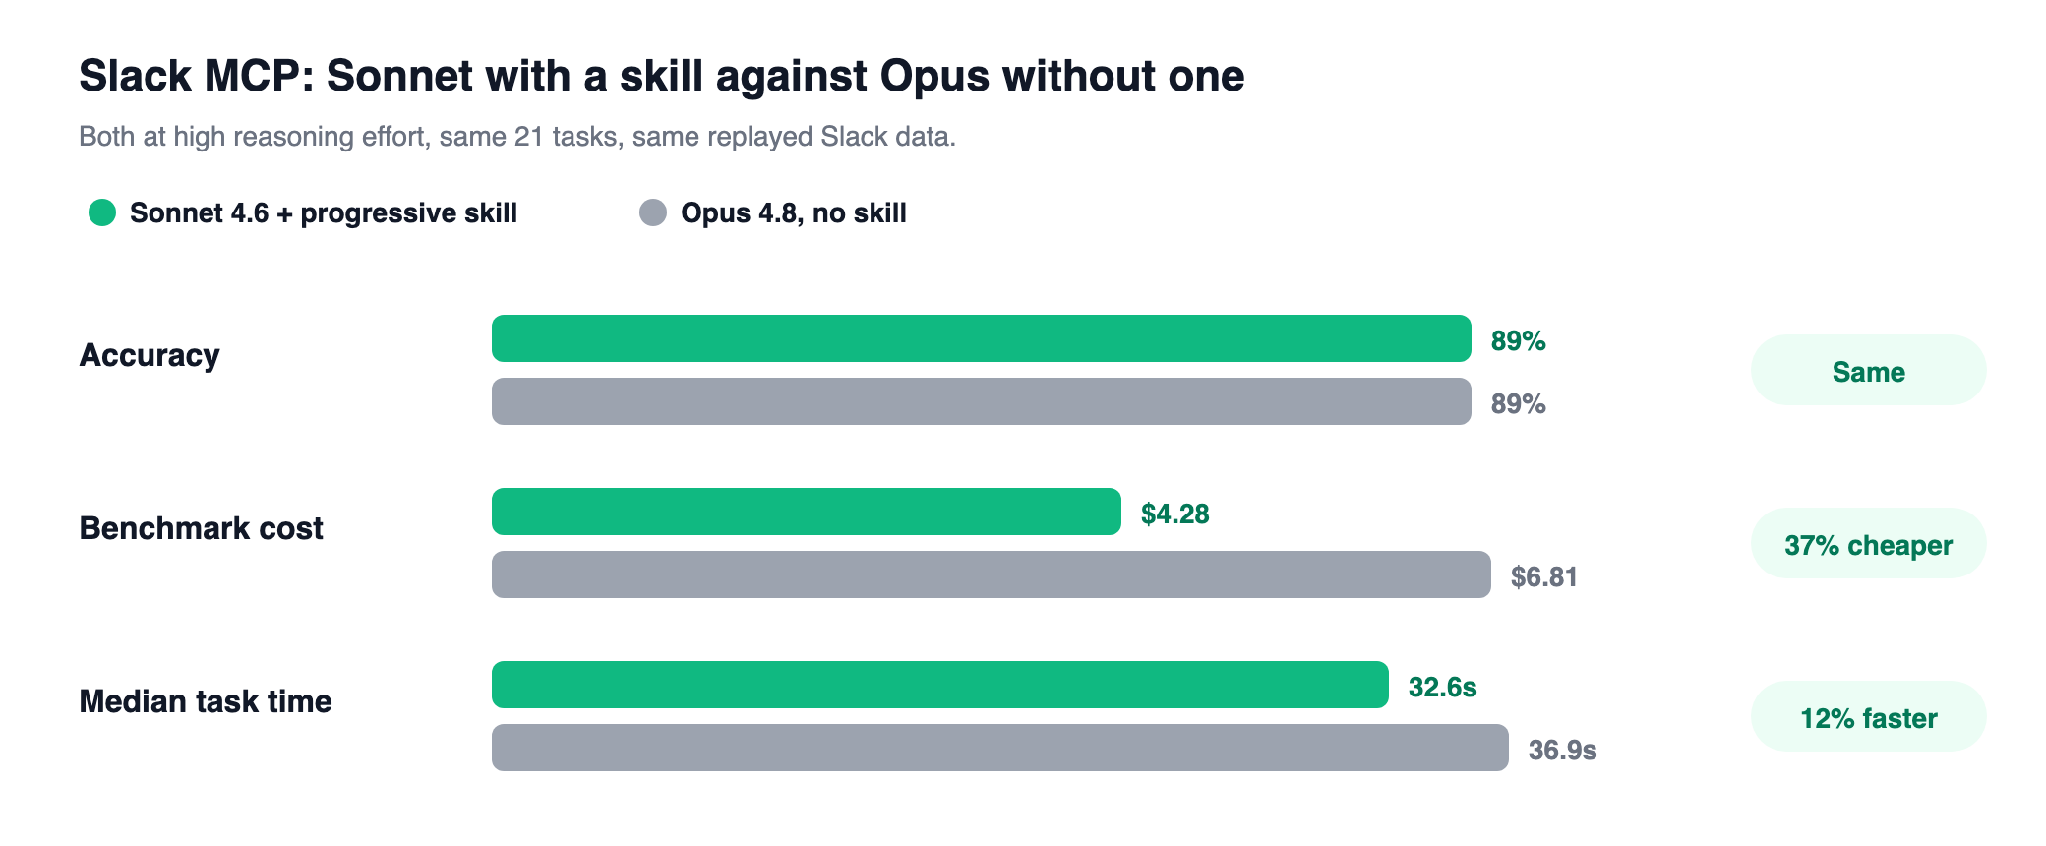
Se fier à la moyenne serait une erreur. En effort élevé, Sonnet est passé de 42 sur 63 à 56 sur 63 — égalant ainsi le score d'Opus sans skill — pour un coût de 4,28 $ contre 6,81 $ et une durée médiane de 32,6 secondes contre 36,9. Opus a conservé l'avantage sur les cas d'exécution très lents. La baisse observée sur Fable équivaut à 3 ou 4 exécutions sur 63 par configuration, ce qui, si près du plafond, peut intégrer une part d'aléa. Les échecs détaillés ci-dessous sont néanmoins avérés. L'ampleur exacte du recul demeure moins certaine.
Même sans skill, l'agent fonctionnait déjà de manière fiable sur les cas d'usage évidents. La distinction entre envoyer, rédiger un brouillon ou programmer, l'ajout d'une réaction et la vérification de ses propres canaux étaient correctement exécutés la plupart du temps. Quelques tâches se sont montrées plus complexes, et c'est sur ces dernières que le modèle intermédiaire a progressé.
Les lignes correspondantes dans l'index sont courtes :
Un prompt, quatre exécutions. « Qui est membre de mcp-gateway ? » La liste des membres renvoie des ID d'utilisateur. Une réponse utile recherche ces ID et fournit des noms. Effort élevé sur l'ensemble. La seule variable dans chaque ligne est la présence du skill.
Le modèle le plus compact est parvenu au bout de la recherche des noms. Le modèle supérieur a appliqué la consigne « faites un appel, puis arrêtez-vous » et a interrompu prématurément la tâche.
Deux autres prompts illustrent ce même blocage, à chaque fois sur Fable en effort élevé, faisant passer le résultat de 3 sur 3 à 1 sur 3. « Avec mon accord, cherche dans les canaux privés et les DM ce qui concerne __mcp_skill_eval_no_match__. » La recherche incluant le domaine privé était l'outil approprié. Sans skill, l'agent appliquait un filtre ciblant les canaux privés, les DM de groupe et les DM. L'index indiquant que cette recherche « inclut les canaux privés et les DM », certaines exécutions avec skill ont pris la phrase au pied de la lettre, omis le filtre, puis affirmé que les DM avaient été consultés. Également : « Lis toute la discussion sous [lien vers un message]. » La première page ne contient qu'une partie des réponses, et les agents la présentaient souvent comme la discussion complète. Ce cas était difficile dans les deux configurations, et le skill en a dégradé la résolution.
Dans chaque cas, l'agent disposait du bon outil ou n'était qu'à une recherche d'obtenir la réponse complète. Il s'est pourtant conformé à une directive générale courte de l'index de manière plus rigide qu'il ne l'aurait fait en toute autonomie.
L'index restant concis et les fichiers de référence ne se chargeant qu'à la demande, l'agent configuré avec le skill a consommé légèrement moins de tokens d'entrée que la version standard. Les appels d'outils ont baissé d'environ un tiers, passant de 2,52 à 1,71 par tâche (contre un parcours optimal à 1,24). Cette réduction découle principalement du comportement de Sonnet, dont les séries sans skill multipliaient les recherches et lectures redondantes. La latence médiane s'est légèrement améliorée (de 37,6 à 35,1 secondes) et les 5 % de cas les plus longs sont passés de 75 à 65 secondes environ. Le coût total du benchmark s'élève à 44,01 $ avec skill, contre 46,10 $ sans.
N'utilisez pas de skill pour la lecture courante sur un modèle puissant. Si votre agent s'appuie sur Opus ou Fable pour interroger des canaux publics et lire l'historique, la liste d'outils suffit amplement. Un skill réduira certes quelques appels, mais il n'améliorera pas la précision et pourra même dégrader le taux de réussite sur un modèle déjà au niveau optimal.
Ajoutez un skill si vous utilisez un modèle plus intermédiaire, ou si vos cas d'usage touchent aux périmètres de recherche, aux fonctions non prises en charge ou aux consignes d'écriture explicites. La progression de Sonnet en effort élevé (de 66,7 % à 88,9 %) justifie à elle seule cette approche. Dans ce contexte, le skill dépasse le cadre du prompt engineering : il détermine directement si vous devez recourir à Opus ou si un modèle plus léger suffit.
Consolidez ensuite votre skill. Limitez l'index aux arbitrages essentiels, chargez le détail à la demande et analysez les échecs. Si une règle interrompt un traitement que le modèle effectuait correctement de lui-même (comme la recherche des noms après la liste des membres), restreignez sa portée ou retirez-la. Un skill condensé s'avère plus simple à exécuter, y compris dans les situations où sa stricte application est contre-productive.
Validez toute nouvelle règle sur votre modèle le plus avancé avant de la déployer. Le modèle intermédiaire fait apparaître les gains de performance. Le modèle supérieur met en évidence les cas de sur-application des consignes.
Un skill influe sur l'outil Slack sélectionné. Il n'intervient pas sur les autorisations d'accès aux canaux privés, sur le jeton d'authentification associé à l'appel, ni sur les journaux d'activité.
Le TrueFoundry Skills Registry permet de versionner et de partager ce type de skill. Les skills sont hébergés au sein d'un dépôt aux côtés des prompts et des modèles. Ce dépôt définit les autorisations de consultation, de modification et d'association, tout en conservant l'historique des versions et le journal d'audit. Chaque publication génère un numéro de version distinct : lorsqu'une règle est révisée pour corriger une régression, l'ensemble des agents bénéficie automatiquement de la mise à jour, avec la possibilité de verrouiller une version antérieure en cas d'anomalie. Une même version peut être associée à un agent TrueFoundry ou importée dans Claude Code et Cursor. Ce skill Slack comprenant un index et trois fichiers de référence, il est déployé sous forme de bundle via l'interface en ligne de commande (CLI) ou via des flux GitOps avec tfy apply.
La passerelle TrueFoundry MCP Gateway s'intercale en amont du serveur MCP Slack. Elle gère l'authentification, le contrôle d'accès au niveau des outils et le suivi détaillé de chaque appel. L'impact sur la latence est de 3 à 4 ms, pour une capacité de traitement supérieure à 350 requêtes par seconde sur un vCPU. Ce benchmark ayant été réalisé à partir de données réexploitées localement, il ne mesure pas directement les performances de la passerelle. Le skill détermine l'appel à effectuer ; la passerelle valide si cet appel est autorisé.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception





