


novembre 21, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
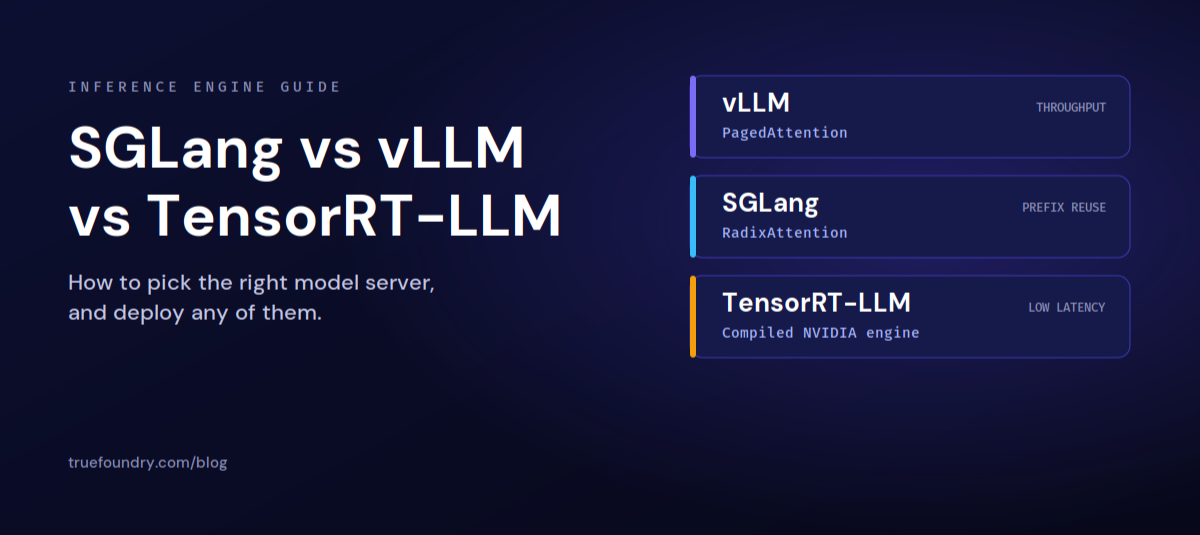
Le moteur d'inférence détermine l'efficacité avec laquelle votre GPU fournit les tokens. Un même modèle sur le même matériel peut offrir des performances très différentes en termes de débit, de latence et de coût selon le moteur utilisé et la façon dont son batching et son caching sont configurés.
Il n'y a pas de gagnant universel. vLLM, SGLang et TensorRT-LLM sont tous développés activement et convergent sur de nombreuses techniques, notamment le continuous batching, le KV cache paginé, le prefix caching et la quantization. Le bon choix dépend de votre modèle, de votre GPU, de la longueur de vos séquences, de la taille de batch et du niveau de concurrence.
vLLM repose sur PagedAttention, qui gère le cache key-value de l'attention dans des pages non contiguës, à la manière dont un système d'exploitation gère la mémoire virtuelle. Cela réduit la fragmentation de la mémoire et permet au serveur de regrouper davantage de séquences concurrentes sur un seul GPU.
C'est un choix solide et polyvalent pour une mise en production à haut débit avec du continuous batching, un support étendu de modèles et un serveur facile à utiliser, compatible OpenAI. Choisissez-le lorsque vous souhaitez une large prise en charge de modèles et un débit performant sans étape de compilation. Pour en savoir plus, consultez notre guide expliquant vLLM.
SGLang repose sur RadixAttention, qui réutilise le cache KV entre les requêtes partageant un préfixe grâce à un arbre radix. Cela bénéficie particulièrement aux charges de travail avec un fort partage de prompts, comme le few-shot prompting, les longs prompts système partagés, les conversations d'agents multi-tours et le tree-of-thought.
Il intègre également des sorties structurées rapides et fiables, incluant le JSON, les regex et le décodage contraint par grammaire, ce qui facilite les pipelines complexes de prompting et de tool calling. Optez pour SGLang lorsque la réutilisation de préfixes et la génération contrainte dominent votre trafic.
TensorRT-LLM est la bibliothèque de NVIDIA qui compile les modèles en moteurs optimisés pour une cible GPU spécifique, en utilisant des fused kernels, une attention optimisée, la quantization sur le matériel compatible et l'in-flight batching via Triton.
Il vise généralement la latence la plus basse et la meilleure efficacité par GPU sur les GPU NVIDIA, au prix d'une étape de build explicite et de moteurs étroitement liés au type exact et au nombre de GPU pour lesquels ils ont été conçus. Comme le précise la documentation, TRT-LLM optimisant le modèle pour le type et le nombre de GPU cibles, il est essentiel que le type et le nombre de GPU correspondent lors du déploiement.
| Moteur | Concept clé | Idéal pour | Compromis |
| --- | --- | --- | --- |
| vLLM | PagedAttention KV cache | Haut débit général, large support de modèles | Excellent choix par défaut, pas toujours la latence la plus basse |
| SGLang | RadixAttention prefix reuse | Prompts partagés, agents, sorties structurées | Les plus gains nécessitent la réutilisation de préfixes |
| TensorRT-LLM | Moteurs NVIDIA compilés | Latence la plus basse sur GPU NVIDIA | Étape de build, moteur lié au GPU |
Toutes les métriques de performance dépendent de la charge de travail. Effectuez des tests de benchmark sur votre propre trafic avant de vous engager. TrueFoundry prend en charge les trois moteurs afin que chacun puisse être adapté à la charge de travail correspondante.
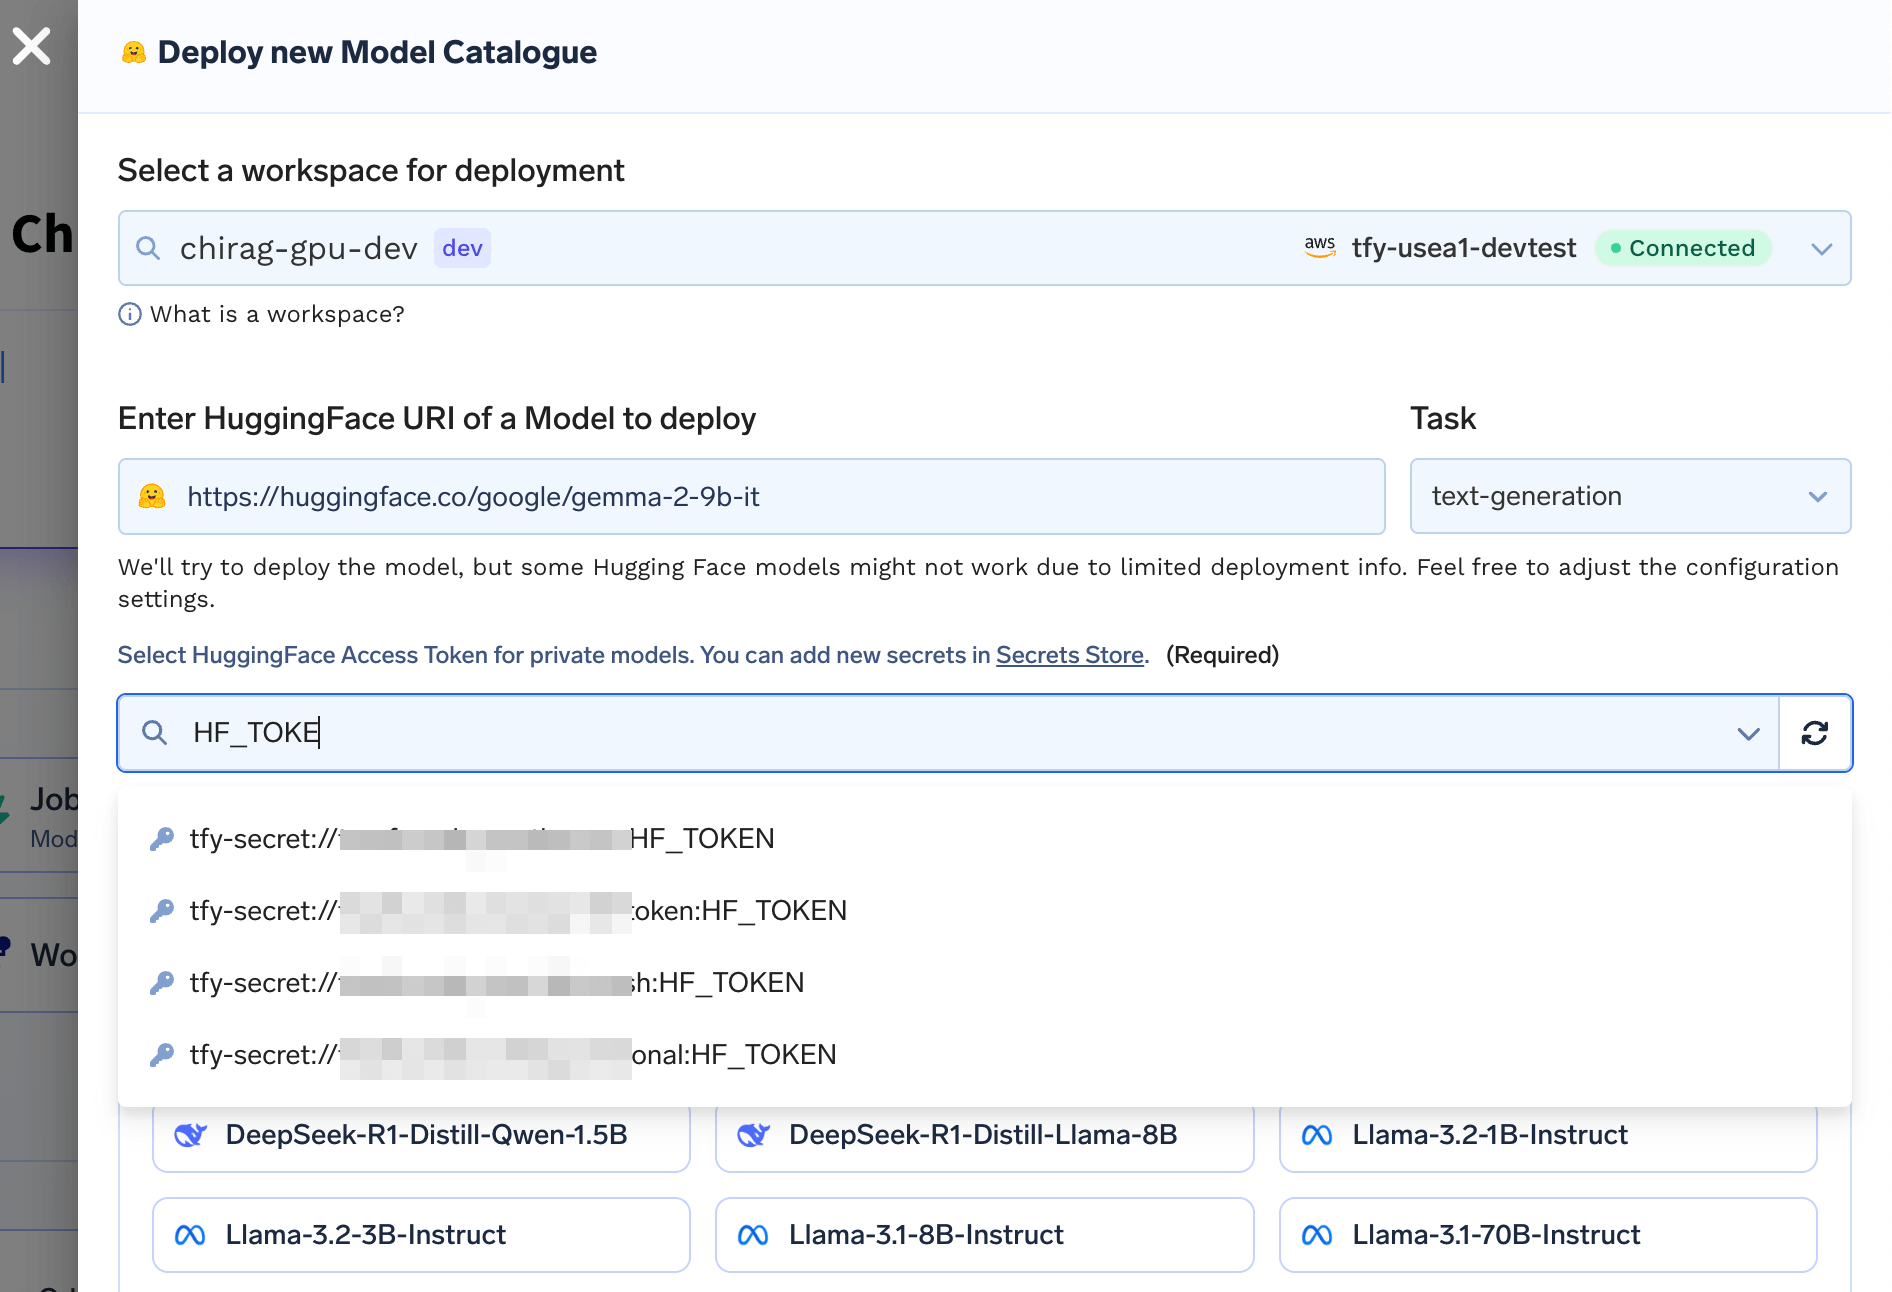
Pour vLLM et SGLang, la procédure passe par le catalogue de modèles. Comme l'indique la documentation, TrueFoundry simplifie le processus de déploiement d'un LLM en déterminant automatiquement la méthode la plus optimale pour le déployer et en configurant le jeu de GPU approprié.
Vous pouvez soit choisir l'un des modèles du catalogue LLM, soit coller l'URL d'un modèle Hugging Face. TrueFoundry analyse les tags et les fichiers du modèle pour comprendre le framework de déploiement et générer les manifestes de déploiement. Vous conservez une flexibilité totale dans le choix du serveur de modèles le plus optimal, ce qui garantit une inférence plus rapide. La plateforme utilise également le streaming et le caching d'images, offrant des temps de téléchargement 3 fois plus rapides pour les images vLLM et SGLang.
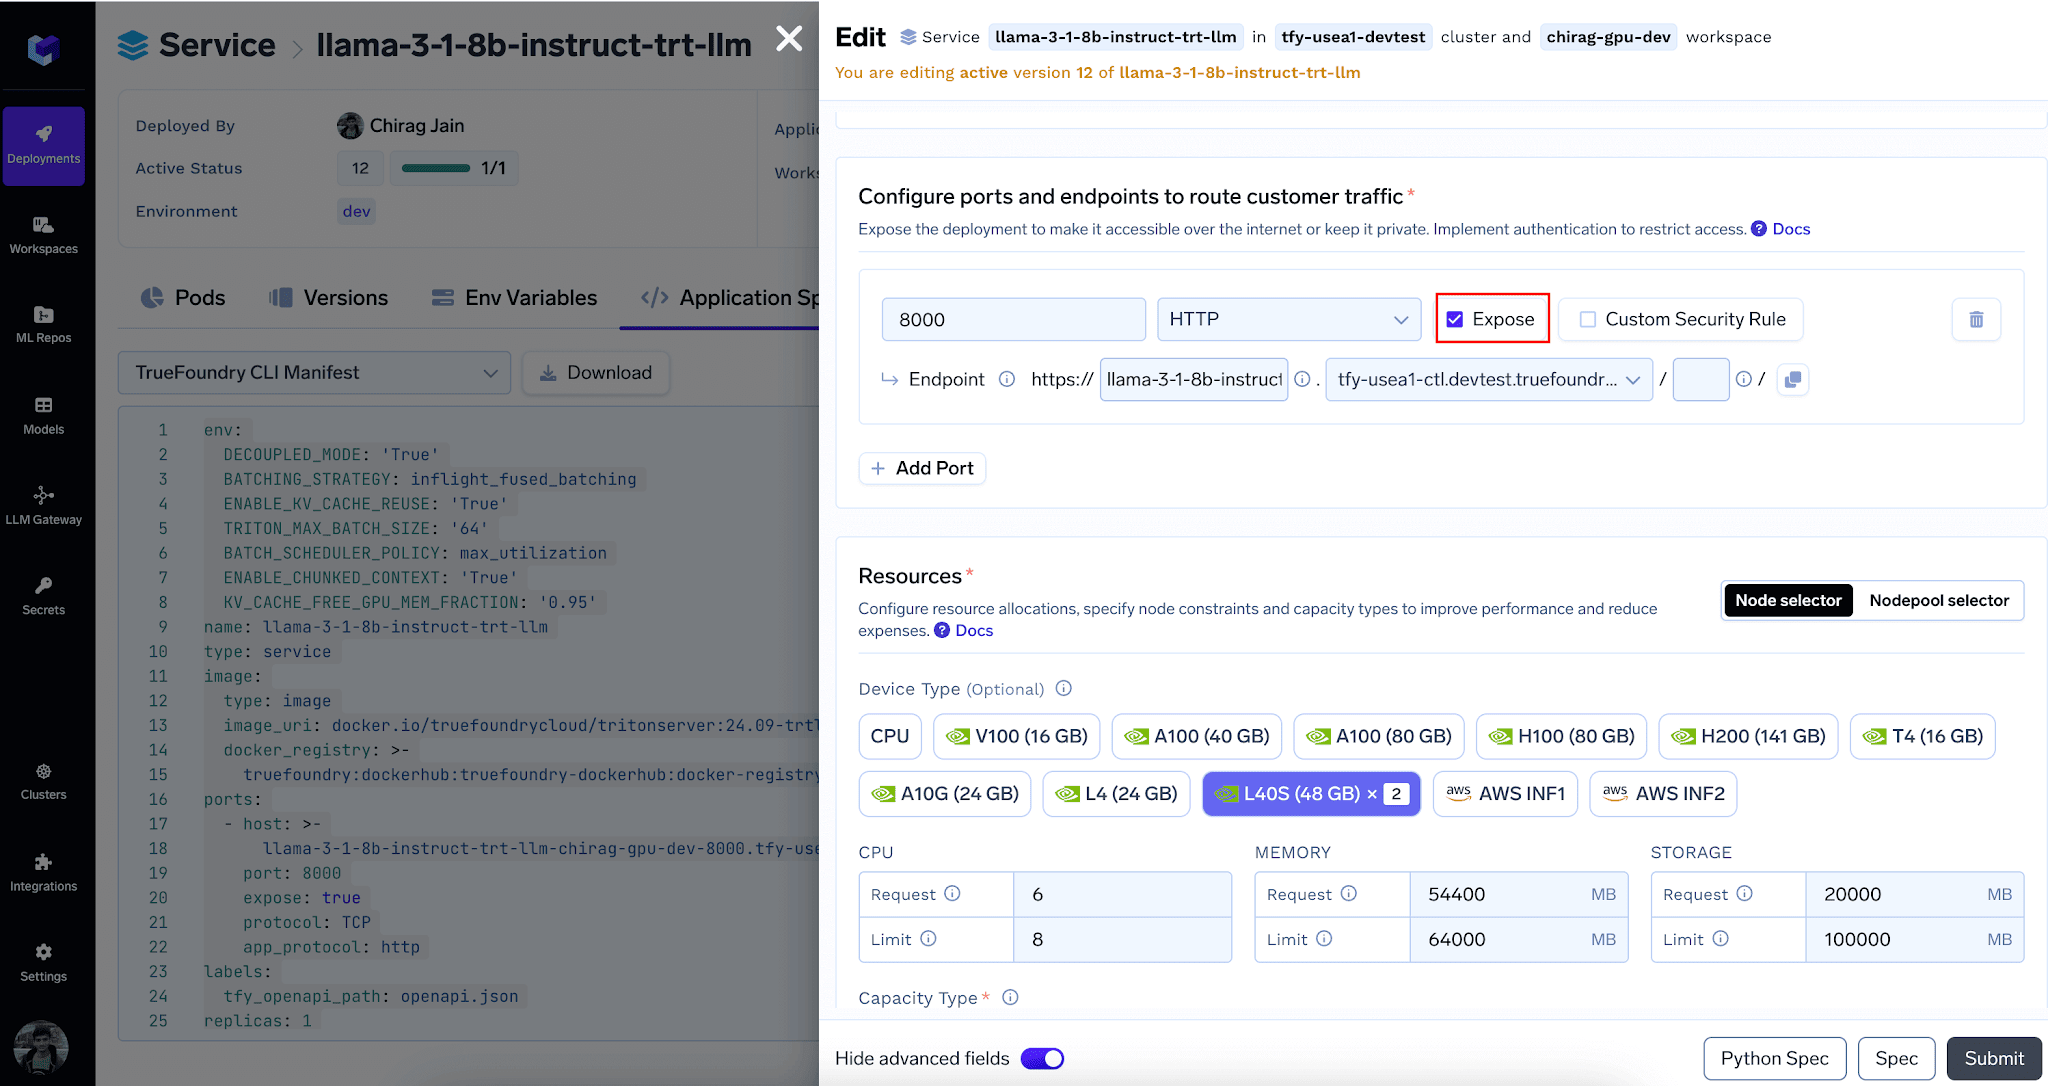
TensorRT-LLM ne se résume pas à un simple bouton à basculer, car les moteurs doivent être compilés pour le GPU cible. Le guide dédié utilise un flux de build puis de mise en service (serve).
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.




It depends on the model, GPU, and workload. TensorRT-LLM often reaches lower latency on NVIDIA GPUs because it compiles a model specific engine, while vLLM offers excellent throughput and broader model coverage with no build step. Benchmark both on your own traffic.
Choose SGLang when your prompts share long prefixes, such as shared system prompts or agentic multi turn flows, or when you need fast, reliable structured outputs like JSON or grammar constrained decoding. Its RadixAttention is designed for prefix reuse.
Yes. TrueFoundry supports vLLM, SGLang, and TRT-LLM as model servers. vLLM and SGLang are selectable in the catalogue flow, and TensorRT-LLM has a dedicated build and serve guide. Any OpenAI compatible endpoint can be added to the AI Gateway.
Because TensorRT-LLM compiles the engine for a specific GPU type and count, the serving deployment must use the same GPU type and count as the builder job. This is what lets it reach its latency and efficiency targets.



Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception















