


novembre 21, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Notre banc d'essai indiquait que le prompt caching d'OpenRouter fonctionnait sur les modèles Anthropic. Notre compte-rendu rédigé quelques jours plus tard affirmait le contraire. Les deux avaient tort.
Le test a envoyé un long bloc de texte de référence à Claude Haiku 4.5 avec cache_control dessus, exactement là où la documentation d'OpenRouter indique de le placer. Le banc d'essai a détecté des champs de cache dans la réponse et a marqué la fonctionnalité comme fonctionnelle. Lorsque nous avons examiné les chiffres plus tard, cache_write_tokens était à zéro, nous l'avons donc considéré comme abandonné. La réponse figurait pourtant dans la documentation depuis le début : Haiku 4.5 ne met pas en cache les prompts de moins de 4 096 tokens, et le nôtre en comptait environ 3 600.
La plupart des problèmes de prompt caching sur OpenRouter se manifestent de la même manière. La requête réussit et la fonctionnalité est activée. Simplement, la réponse ne vous indique pas clairement quand la mise en cache n'a pas eu lieu, ou quand elle a eu lieu et a coûté plus cher qu'elle n'a fait économiser.
OpenRouter utilise ce terme pour deux fonctionnalités qui n'ont presque rien en commun.
Le prompt caching du fournisseur appartient à ce dernier. Il stocke le préfixe traité de votre prompt afin que la requête suivante possédant le même préfixe n'ait pas à le relire, et facture ces tokens avec une réduction. Le modèle s'exécute toujours et génère une réponse fraîche. La mise en cache des réponses appartient à OpenRouter. Elle stocke l'intégralité de la réponse et la renvoie en cas de requête identique, sans que le modèle ne s'exécute du tout.
Les prix, les seuils minimaux et les TTL ci-dessous concernent le prompt caching des fournisseurs. Si vous hésitez entre la mise en cache de réponses par correspondance exacte ou sémantique, notre guide pour savoir quand des questions similaires doivent partager une réponse traite de ce sujet. La mise en cache des réponses d'OpenRouter dispose de sa propre section vers la fin.
OpenRouter transmet la tarification du cache de chaque fournisseur sans appliquer de marge par token. Ses frais s'appliquent plutôt sur les achats de crédits, ce que détaille notre analyse des tarifs d'OpenRouter. Les coefficients ci-dessous sont relatifs au prix d'entrée normal du modèle.
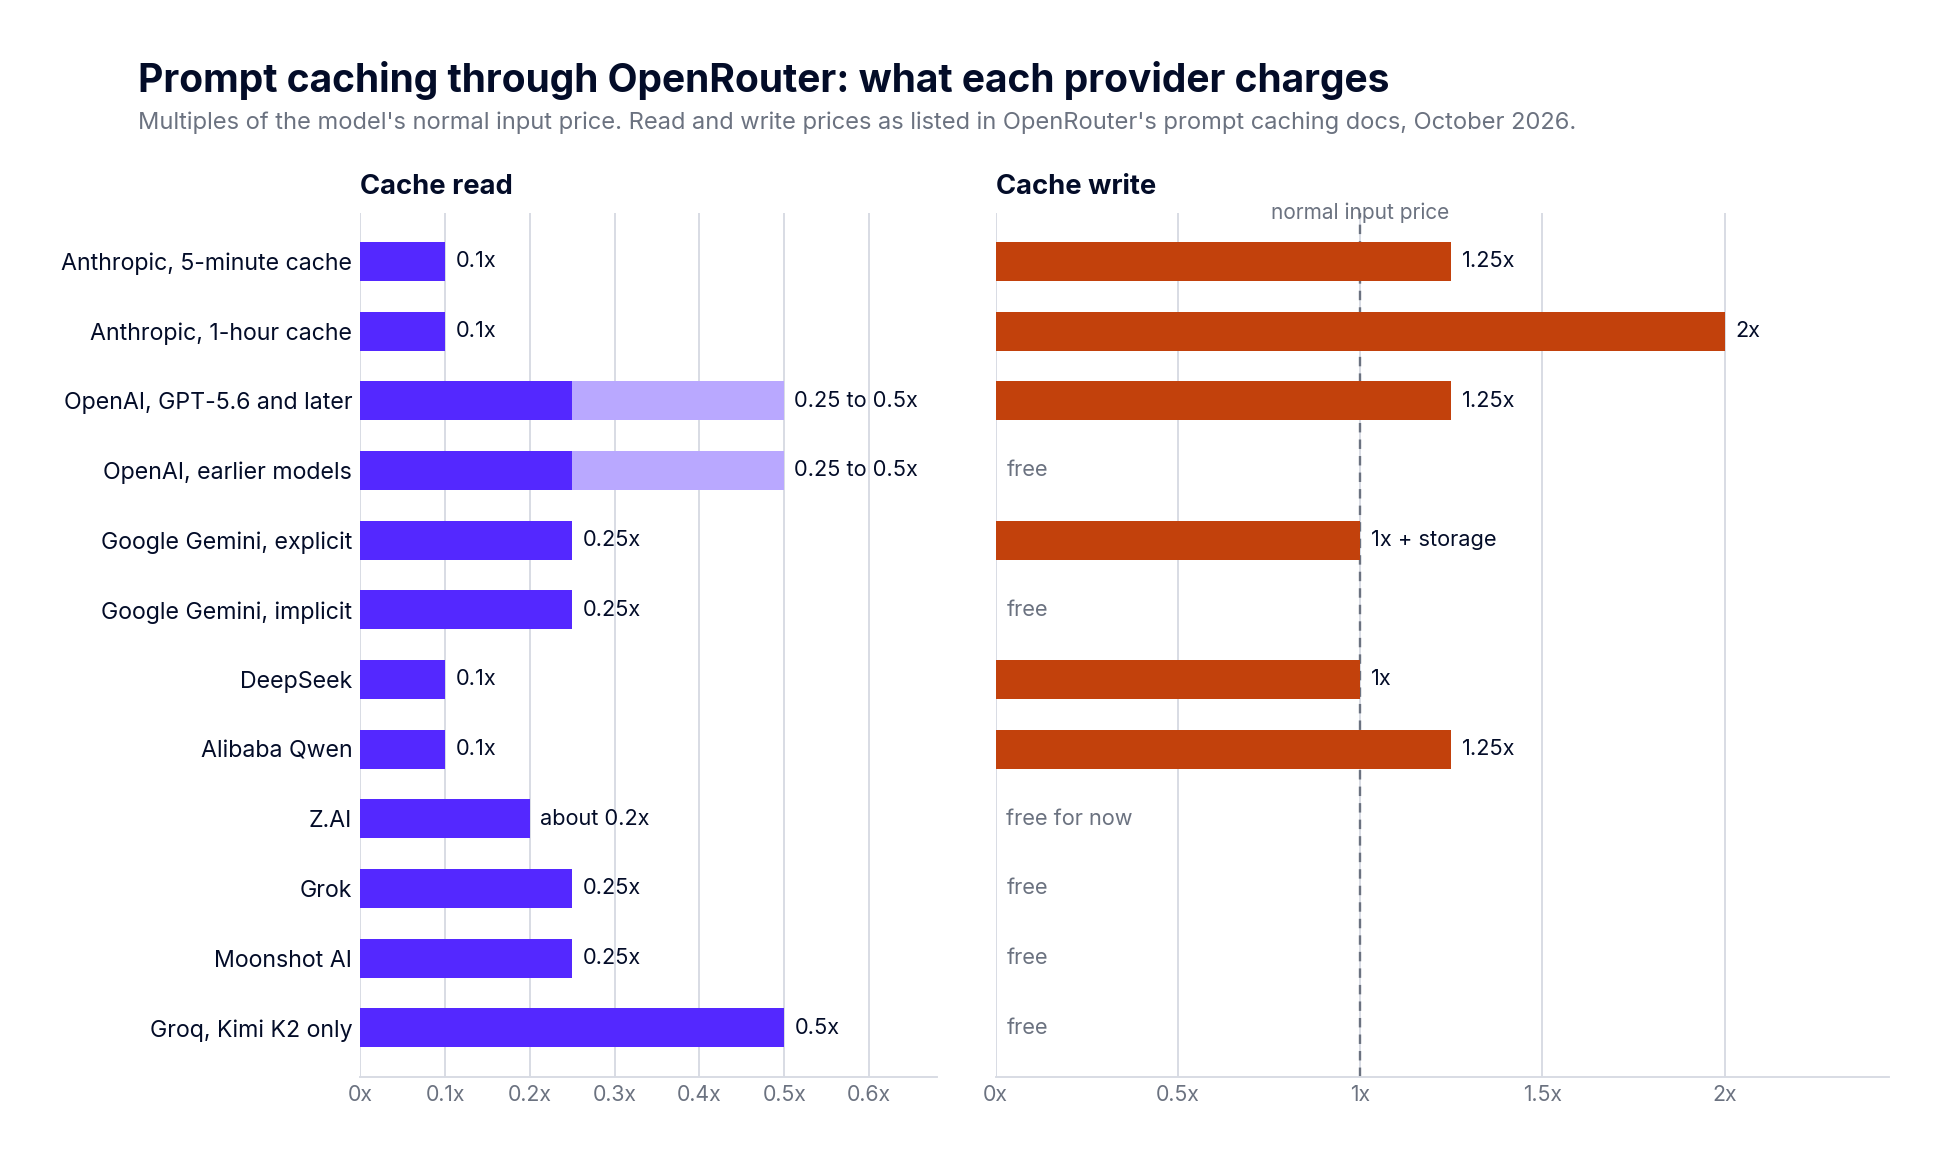
Les lectures vont d'un dixième du prix d'entrée à la moitié, et les écritures varient de gratuites au double. Cinq des neuf fournisseurs n'ont aucune longueur minimale de prompt répertoriée dans la documentation d'OpenRouter. De plus, avec les basculements automatiques de modèles (fallbacks) ou l'Auto Router, une requête peut atterrir sur une ligne différente de la précédente, avec un cache froid.
Savoir si la mise en cache permet d'économiser de l'argent dépend du nombre de fois où le même préfixe est envoyé pendant que le cache est encore chaud. En utilisant les coefficients ci-dessus et en ne comptant que la partie mise en cache du prompt :
Le reste de chaque requête — la question de l'utilisateur et tout ce qui suit le dernier bloc mis en cache — est facturé de la même manière dans les deux cas, de sorte que ces ratios s'appliquent uniquement au préfixe.
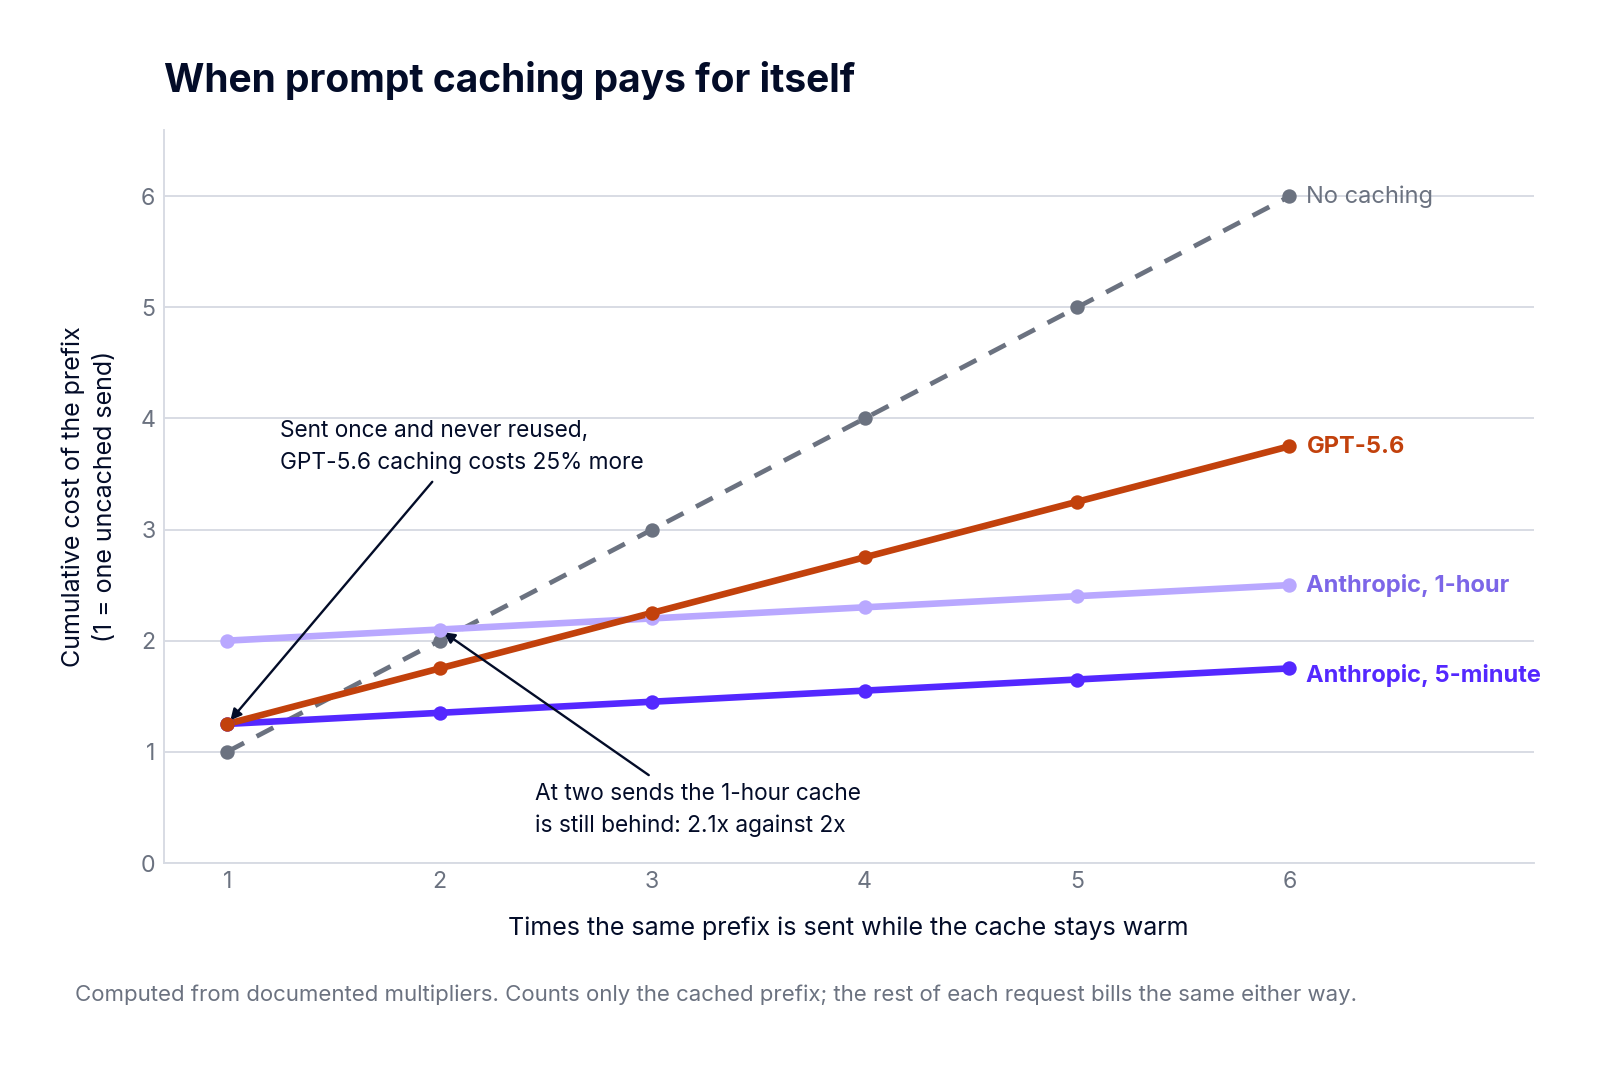
Pour la majeure partie du tableau, l'écriture en cache est gratuite ou presque, la mise en cache est donc une option sans risque financier. GPT-5.6 a changé la donne pour OpenAI. À partir de cette famille de modèles, les écritures en cache sont facturées 1,25x le prix d'entrée, même avec la mise en cache automatique, et cette dernière est activée que vous l'ayez demandée ou non. Tout prompt de 1 024 tokens ou plus envoyé une seule fois paye pour l'écriture et ne rentabilise jamais la lecture.
Prenons un prompt de 2 000 tokens envoyé une seule fois. Sans mise en cache, il est facturé comme 2 000 tokens d'entrée. Avec la mise en cache activée, vous payez presque ce que coûterait un prompt de 2 500 tokens. Sur une tâche nocturne résumant un million de documents longs et uniques, où le document vient en premier et où rien au début ne se répète jamais, cela représente un surcoût de 25 % sur la majorité de vos données d'entrée.
Le correctif se fait à l'envers. Réglez prompt_cache_options.mode sur "explicit" et ne marquez aucun bloc de contenu avec prompt_cache_breakpoint. Le mode explicite désactive les points d'arrêt automatiques d'OpenAI, et en l'absence de points explicites, il n'y a aucun préfixe mis en cache, donc rien n'est écrit. cache_write_tokens revient à zéro, ce qui est le seul endroit de cet article où un zéro signifie exactement ce que vous voulez.
Voyons maintenant l'autre côté. Claude Sonnet 4.6 avec un prompt système de 5 000 tokens, 100 requêtes réparties sur une journée de travail, arrivant par 20 rafales de cinq requêtes espacées d'environ 20 minutes. En comptant uniquement le prompt système, en tokens facturés au prix d'entrée normal :
Le cache de 5 minutes permet d'économiser deux tiers du coût. Le cache de 1 heure permet d'économiser 88 %, car un intervalle de 20 minutes réinitialise le cache court à chaque fois et n'atteint jamais la fin du cache long. Anthropic rafraîchit la durée de vie du cache à chaque lecture, l'entrée de 1 heure reste donc chaude toute la journée.
Modifiez le profil du trafic et la réponse changera. Si ces 100 requêtes arrivaient de manière régulière, une toutes les quatre minutes environ, le cache de 5 minutes n'expirerait pas non plus, et l'option de 1 heure obligerait à payer 10 000 pour une écriture que le cache court gère à 6 250. Choisissez le TTL en fonction des intervalles entre vos requêtes, et non du volume total envoyé.
Chaque fournisseur définit une longueur minimale de prompt en dessous de laquelle rien n'est mis en cache. Pour Claude, selon la documentation d'OpenRouter :
Le seuil d'OpenAI est de 1 024 tokens. Celui de Gemini est de 1 024 sur 2.5 Flash et de 4 096 sur 2.5 Pro. En dessous de ce seuil, la requête réussit, est facturée au tarif d'entrée plein, et revient avec ses champs de cache définis à zéro. Pas d'erreur, pas d'avertissement.
Deux conséquences de ce fonctionnement sont faciles à manquer.
Les modèles récents ont des seuils plus élevés. Un prompt système de 3 000 tokens est mis en cache sur Sonnet 4.6 mais cesse de l'être le jour où vous le migrez vers Opus 4.7, sans changement de code et sans que rien dans la réponse ne vous l'indique. Passer de Haiku 3.5 à Haiku 4.5 produit le même effet pour tout ce qui se situe entre 2 048 et 4 096 tokens. Une mise à niveau de modèle étant une modification de la mise en cache, vérifiez votre taux de réussite de cache (hit rate) après chaque changement.
De plus, vous ne pouvez pas vérifier la mise en cache simplement en recherchant les champs de cache. C'est ce qui a piégé notre propre test. OpenRouter renvoie cached_tokens et cache_write_tokens sur les réponses de chaque fournisseur, y compris ceux où la mise en cache n'est pas native : la présence de ces champs ne prouve donc rien. Les valeurs à zéro ne prouvent pas grand-chose non plus. Elles signifient que le marqueur a été ignoré ou que le prompt était en dessous du seuil — et sur Haiku 4.5 à 3 600 tokens, c'était une question de seuil.
Un test qui apporte une vraie confirmation :
cache_write_tokens supérieur à zéro lors du premier appel. Attendez-vous à un cached_tokens supérieur à zéro lors du second.cache_discount dans le corps de la réponse. Cette valeur est négative lors d'une écriture Anthropic et positive lors d'une lecture.OpenRouter traduit les marqueurs de cache entre les fournisseurs, ce qui est pratique. Un bloc de texte avec un style Anthropic cache_control devient un prompt_cache_breakpoint lorsqu'il est routé vers un modèle GPT-5.6, et un prompt_cache_breakpoint devient un cache_control par défaut sur Anthropic ou Google.
Le TTL n'est cependant pas conservé. Un ttl sur cache_control est ignoré lors de l'acheminement vers OpenAI. prompt_cache_options, où se trouve le TTL d'OpenAI, ne s'applique qu'à OpenAI. prompt_cache_breakpoint ne possède pas de champ TTL, donc quoi qu'il devienne du côté d'Anthropic, il obtiendra la valeur par défaut de 5 minutes.
Les durées de vie se comportent également différemment une fois définies. Celle d'Anthropic se rafraîchit à chaque lecture. Le cache explicite de Gemini dure cinq minutes à compter de l'écriture et ne se rafraîchit pas. Le cache implicite de Gemini est documenté comme durant trois à cinq minutes en moyenne, de manière variable. Ainsi, un corps de requête demandant une heure peut obtenir une heure, cinq minutes fixes ou ce qu'OpenAI applique, selon l'endroit où elle atterrit. L'API Responses ajoute une contrainte supplémentaire : elle n'expose pas le cache_control par bloc d'Anthropic, utilisez donc Chat Completions ou le endpoint Messages si vous avez besoin d'un TTL sur un bloc spécifique.
Un cache n'est utile que si votre requête suivante atteint le fournisseur qui le détient. OpenRouter gère cela avec le routage persistant par fournisseur : après une requête utilisant la mise en cache, les requêtes de suivi pour le même modèle sont dirigées vers le même endpoint de fournisseur.
La persistance est suivie par compte, par modèle et par conversation, où une conversation est identifiée en hachant votre premier message système et votre premier message non-système. Elle expire après 10 minutes sans requête.
Les agents ont tendance à briser ce comportement par défaut, car leurs messages d'ouverture changent entre les tours. Passez un session_id dans le corps ou un en-tête x-session-id et OpenRouter l'utilisera comme clé de persistance à la place, en démarrant dès la première requête réussie plutôt qu'en attendant un hit de cache. Le prompt_cache_key d'OpenAI sert de clé de secours si vous l'envoyez déjà.
Définir provider.order désactive le routage persistant et votre liste devient prioritaire. Tant que votre premier choix est fonctionnel, cela coûte peu, car une sélection fixe (pin) vous maintient de toute façon sur un seul fournisseur. La différence apparaît après un basculement (failover) : le routage persistant suivrait le fournisseur qui vous a servi, alors qu'une sélection fixe recommencerait à partir du haut de votre liste. Fixer un fournisseur reste le bon choix lorsque vous avez besoin d'une capacité prévisible, comme nous l'avons développé dans notre article sur les limites de débit d'OpenRouter. L'Auto Router présente une caractéristique similaire : si le modèle qu'il a choisi est retiré des candidats lors d'un tour ultérieur, le cache est perdu avec lui.
Indépendamment de tout ce qui précède, OpenRouter peut mettre en cache des réponses entières si vous envoyez X-OpenRouter-Cache: true. Un hit renvoie la réponse stockée sans appeler de fournisseur, ne facture rien et ne compte pas dans les limites de débit des fournisseurs.
Nous l'avons mesuré sur trois séries de 100 nouvelles requêtes identiques chacune, sur GPT-4o mini et Claude Haiku 4.5. Chaque nouvelle requête s'est soldée par un hit. La latence médiane était de 2 867 ms lors d'un miss et de 59 ms lors d'un hit, les hits sur Haiku étant plus rapides (39 ms contre 64 à 69 ms pour GPT-4o mini). Sur la série facturée sur des crédits, 100 misses ont coûté 0,0174 $ et 100 hits n'ont rien coûté.
Les entrées sont indexées sur la clé API ainsi que sur le modèle, le type de endpoint, le mode de streaming et le corps complet de la requête ; ainsi, des services utilisant des clés distinctes ne partagent rien et toute modification de paramètre entraîne un miss. Notre test de TTL, à raison d'un échantillon par intervalle, a révélé des entrées encore actives à 120 secondes et disparues à 300. Il n'y a pas de TTL publié, pas de correspondance sémantique et pas de purge documentée. Cela permet d'absorber les réessais et les soumissions en double. Une répétition toutes les heures entraînera un miss.
Notre gateway met en cache au niveau de la couche de réponse selon deux modes. La correspondance exacte renvoie une réponse stockée pour une requête identique. Le mode sémantique vectorise (embed) le dernier message et renvoie une réponse stockée lorsqu'une requête antérieure était suffisamment proche. Il sert également les hits par correspondance exacte : vous n'exécutez donc qu'un seul mode, pas les deux. Il s'active via un en-tête de requête, s'appuie sur Redis et se combine avec le prompt caching du fournisseur : en cas de miss sur la gateway, le cache de préfixe propre au fournisseur s'applique toujours.
Sur l'offre SaaS, le modèle d'embedding est text-embedding-3-small avec 1 536 dimensions et n'est pas configurable ; en environnement on-premise, vous le choisissez pour l'ensemble de la gateway. La correspondance sémantique présente un mode de défaillance que la correspondance exacte n'a pas. Notre guide de la mise en cache sémantique commence par cet exemple : deux clients se renseignent sur leur livraison à quelques minutes d'intervalle, les questions génèrent des vecteurs presque identiques, et le second client reçoit une réponse concernant la commande du premier. C'est un bug d'isolation des données (scope bug). Modifier le seuil de similitude ajuste la fréquence à laquelle cela se produit, mais cela n'isole pas un cache partagé entre plusieurs clients.
La recherche dans le cache ajoute environ 3 à 4 ms, et la gateway gère plus de 350 RPS sur un seul vCPU.
session_id pour les sessions d'agents afin que le routage reste sur le fournisseur détenant votre cache.cached_tokens non nul, jamais par la simple présence du champ.Le prompt caching d'OpenRouter fonctionne, et la documentation est plus claire ici que pour de nombreuses autres fonctionnalités environnantes. Vous devez néanmoins jongler avec neuf grilles tarifaires, des seuils qui augmentent sur les modèles récents, des durées de vie qui changent lors des traductions, et une réponse qui semble identique, que la mise en cache ait eu lieu ou non. Vérifiez le seuil, placez le texte stable en premier et validez avec des chiffres plutôt qu'avec la présence de champs.
Pour configurer la mise en cache une fois pour toutes chez chaque fournisseur, avec une correspondance sémantique au-dessus du cache de préfixe du fournisseur, découvrez comment la gateway IA de TrueFoundry gère le cache.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.




It's OpenRouter passing through each provider's prompt caching, where a repeated prompt prefix is stored and billed at a discount on later requests. Some providers cache automatically, while Anthropic and Alibaba need cache_control markers on the content you want cached. Prices differ by provider, from free writes and 0.1x reads to 2x writes on Anthropic's 1-hour cache.
Yes, as long as the prompt clears the model's minimum length. Claude Haiku 4.5 and Opus 4.5 and later need 4,096 tokens, and Sonnet 4.x needs 1,024. Below that floor the request succeeds at full price with cache fields at zero, which looks exactly like the marker being ignored.
Most likely you're paying for cache writes on prompts that never get reused. GPT-5.6 and later bill writes at 1.25x even under automatic caching, and Anthropic's 1-hour cache bills writes at 2x. If the prefix doesn't repeat while the cache is warm, you pay for the write and never get the discount.
Oui. TrueFoundry s'exécute dans votre VPC, on-premise, en environnement air-gapped ou en hybride, de sorte que les prompts et les réponses ne quittent jamais votre domaine, même lorsque vous routez vers de nombreux fournisseurs.



Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception















