



novembre 20, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Published: novembre 20, 2026

Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
La question « quel est le meilleur modèle ? » est une mauvaise question, et elle coûte silencieusement de l'argent aux équipes. La réponse honnête est qu'un modèle de pointe est un outil assorti d'un prix, et le bon outil dépend de ce que vous lui demandez de faire. Envoyer une tâche de classification d'avis produits à un modèle de raisonnement de premier plan équivaut à louer une grue pour accrocher un cadre photo. Cela fonctionne. Mais cela coûte aussi 40 fois plus cher que nécessaire, et c'est plus lent.
En cette fin d'année 2026, la frontière s'est élargie en différents niveaux (tiers). Chaque grand fournisseur propose au moins trois modèles : un modèle phare (flagship) optimisé pour le raisonnement complexe, un modèle intermédiaire performant optimisé pour le prix et le débit, et un petit modèle conçu pour être rapide et presque gratuit. Les décisions intéressantes ne sont plus « OpenAI ou Anthropic ». Elles sont « quel niveau, pour quelle requête, à quel coût, avec quel plan de secours ». C'est un problème de routage, et les problèmes de routage se résolvent par des politiques, pas par une fidélité à une marque.
Cet article poursuit deux objectifs. D'abord, un panorama par fournisseur structuré autour des forces réelles de chaque modèle. Ensuite, un cadre de décision qui associe vos types de tâches à un niveau de modèle et une posture de coût, tout en montrant comment une passerelle AI (AI gateway) vous permet d'appliquer ce cadre sans réécrire votre application à chaque fois qu'un fournisseur publie une nouvelle version.
Vous souhaitez router chaque requête vers le bon modèle selon la tâche et le coût ? Réservez une démo.
Les benchmarks mesurent un modèle sur un test fixe. Votre trafic de production n'est pas un test fixe. C'est un mélange : un flux massif d'appels économiques et répétitifs (extraire le numéro d'une facture, classifier un ticket, décider de l'invite/prompt à exécuter en aval) et un mince filet de requêtes réellement complexes (déboguer une condition de concurrence/race condition sur cinq fichiers, raisonner sur un contrat de 200 pages). Un modèle « unique » idéal doit être tarifé et dimensionné pour le flux complexe, ce qui vous fait surpayer pour le flux massif.
Trois facteurs rendent la logique du modèle unique très coûteuse :
La solution consiste à traiter la sélection du modèle comme une simple configuration. Définissez la politique une fois (« l'extraction va au niveau économique, le codage va au niveau intermédiaire, le raisonnement complexe monte vers un modèle phare, et tout bascule sur un second fournisseur en cas d'erreur »), exprimez-la au niveau d'une passerelle, et modifiez-la sans publier de code. Pour en savoir plus sur les mécanismes sous-jacents, consultez qu'est-ce qu'un routeur LLM et sélection de modèles axée sur le coût et la qualité.
Les seuls chiffres ci-dessous confirmés directement par l'éditeur sont ceux de Claude. Tout le reste provient de rapports tiers agrégés en date de novembre 2026 et doit être vérifié sur les pages de tarification et de modèles du fournisseur avant d'être utilisé en production. Les spécifications des modèles changent fréquemment.
La gamme de fin 2026 de Claude s'appuie sur une fenêtre de contexte de 1M de tokens avec 128K en sortie et une date de fin d'entraînement fixée à juin 2026. Les niveaux sont bien définis :
La structure intéressante ici repose sur la répartition tripartite : un petit modèle presque gratuit, un modèle intermédiaire équilibré et un modèle agentique premium. Vous pouvez construire pratiquement n'importe quelle politique de routage à partir de ces trois rôles.
La génération GPT-6 d'OpenAI suivrait la même structure de niveaux. GPT-6 Astra est rapporté à 10 $ / 50 $ et positionné pour le raisonnement de haut niveau. GPT-6.1 Sol est rapporté à 2 $ / 10 $ et décrit comme le modèle de codage et de recherche le plus puissant de la famille, avec un Coding Index rapporté d'environ 54. GPT-6.1 Terra, rapporté à 1 $ / 5 $ et sorti aux alentours du 26 octobre 2026, afficherait un contexte d'environ 1,05M et un Coding Index proche de 48, ce qui le situe à la moitié du prix de Sol pour une grande partie de ses capacités de codage. GPT-6 Luna, rapporté à 0,10 $ / 0,50 $, est le modèle de classification et de routage à fort volume, avec un Coding Index rapporté autour de 31.
Considérez ces chiffres de Coding Index comme indicatifs et non absolus. Ils proviennent d'agrégations tierces et sont susceptibles d'évoluer.
La gamme de Google est la plus difficile à cerner en raison de rapports contradictoires. Gemini 3.1 Pro est rapporté à 2 $ / 12 $ et ciblerait le raisonnement le plus complexe. Gemini 3.6 Flash est rapporté à 1,50 $ / 7,50 $, sorti vers juillet 2026, avec une fenêtre de contexte de 1M, un Intelligence Index rapporté proche de 50, SWE-Bench Pro rapporté à environ 58,7 %, et un débit rapporté d'environ 280 tokens par seconde, ce qui le positionne comme un modèle de codage économique mais très capable. Gemini 3.1 Flash-Lite est rapporté autour de 0,25 $ / 1,50 $ pour le niveau le plus bas. Si vous ne pouvez pas confirmer 3.6 Flash dans votre compte, l'alternative sûre reste Gemini 3.5 Flash, disponible pour tous.
Le système de versions de Grok reste instable. Grok 4.3, à environ 1,25 $ / 2,50 $, est la configuration la plus souvent citée, et son faible coût de sortie est notable. Des versions plus récentes Grok 4.6 et Grok 5 sont rapportées mais non stabilisées. Considérez cette version comme incertaine et vérifiez directement auprès de xAI avant d'y router du trafic de production.
Pour les équipes souhaitant l'auto-hébergement ou cherchant à réduire au maximum les coûts : Meta Llama 4 Maverick est rapporté autour de 0,20 $ / 0,60 $ et Scout autour de 0,11 $ / 0,34 $, tous deux open-weight et auto-hébergeables. DeepSeek V4 est rapporté dans une fourchette d'environ 0,22 $ à 0,66 $ et positionné pour le codage et le raisonnement économiques. Mistral Large 3 est rapporté autour de 0,50 $ / 1,50 $. Ces options sont particulièrement pertinentes lorsque la résidence des données ou l'économie unitaire brute guident vos choix.
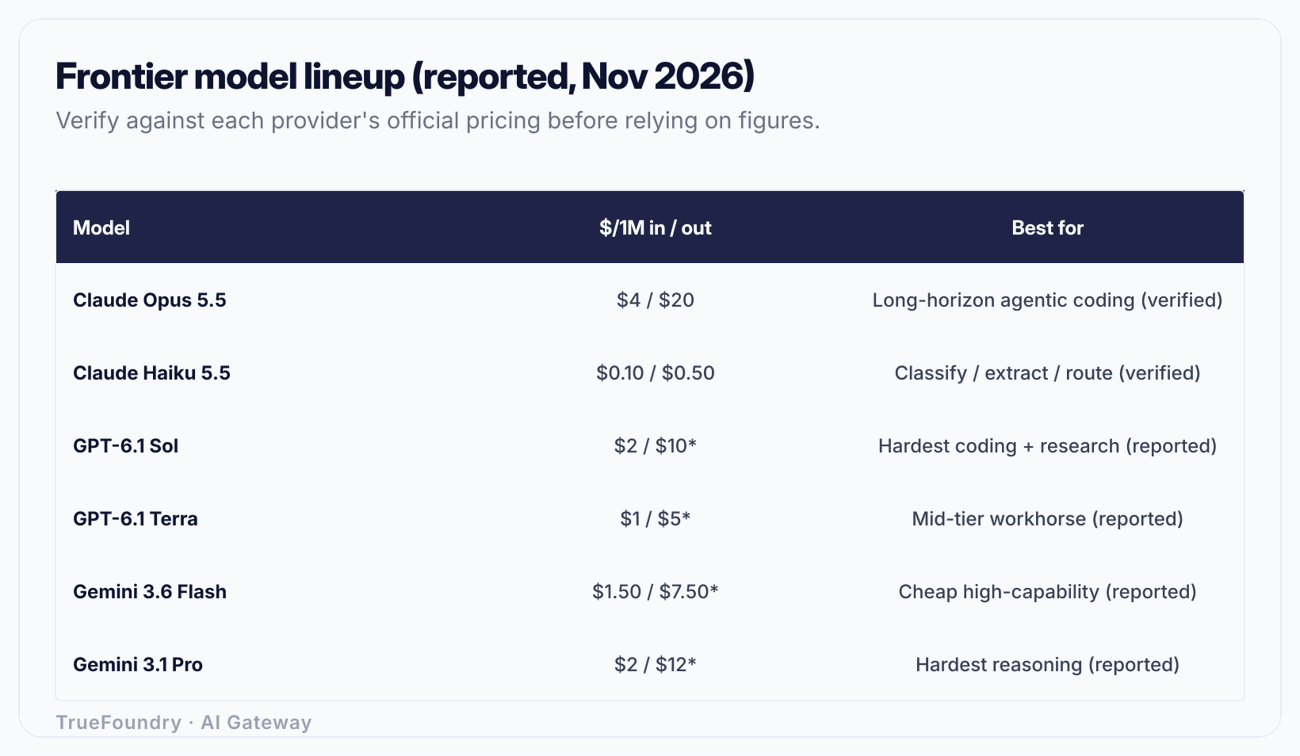
Tarifs et benchmarks rapportés en date de novembre 2026 ; vérifiez sur la page tarifaire officielle de chaque fournisseur avant de vous y fier — les spécifications évoluent fréquemment.
Cessez de choisir un modèle unique. Commencez par classifier votre trafic, puis associez chaque classe à un niveau de modèle et à une posture de coût. Quatre catégories couvrent la quasi-totalité des besoins.
Il s'agit de tâches à fort volume et faible ambiguïté : étiqueter un ticket, extraire une date d'un document, décider de la branche de prompt à exécuter. Elles ne nécessitent pas de modèle phare. Un petit modèle (Haiku 5.5, GPT-6 Luna, Gemini 3.1 Flash-Lite) d'environ 0,10 $ à 0,25 $ par million de tokens d'entrée s'en charge très bien, et comme la sortie est courte, le coût par requête reste minime. Posture de coût : minimiser. C'est ici que le routage vers le niveau économique est le plus rentable.
Le chat destiné aux utilisateurs nécessite une bonne qualité et une faible latence, mais rarement le raisonnement le plus profond. Un modèle intermédiaire (Sonnet 5.5, GPT-6.1 Terra, Gemini 3.6 Flash) constitue le point d'équilibre idéal. Posture de coût : équilibrer. Surveillez attentivement le prix des tokens de sortie, car le chat en génère beaucoup.
Le codage multi-étapes, où le modèle planifie, appelle des outils, lit des fichiers et conserve un objectif à travers plusieurs échanges, est le domaine où les écarts de capacité se font sentir. Pour les travaux agentiques les plus difficiles, Opus 5.5 est la valeur sûre confirmée ; GPT-6.1 Sol est rapporté comme un équivalent solide. Pour le codage quotidien qui ne nécessite pas une vision à très long terme, un modèle intermédiaire (Terra, Gemini 3.6 Flash, Sonnet 5.5) offre généralement 90 % de l'efficacité pour une fraction du coût. Posture de coût : segmenter par difficulté. Routez les modifications courantes vers le niveau intermédiaire et réservez le niveau phare aux exécutions agentiques complexes.
Analyse juridique, synthèse de recherche, raisonnement sur de volumineux documents. C'est le seul cas où il est justifié de payer pour un modèle phare (Astra, Gemini 3.1 Pro, Opus 5.5 ou Fable 5.1 pour les cas extrêmes). Posture de coût : payer pour la qualité, mais filtrer à l'entrée. Seule une infime partie du trafic doit atteindre ce niveau ; le filtre est assuré par la règle de routage.
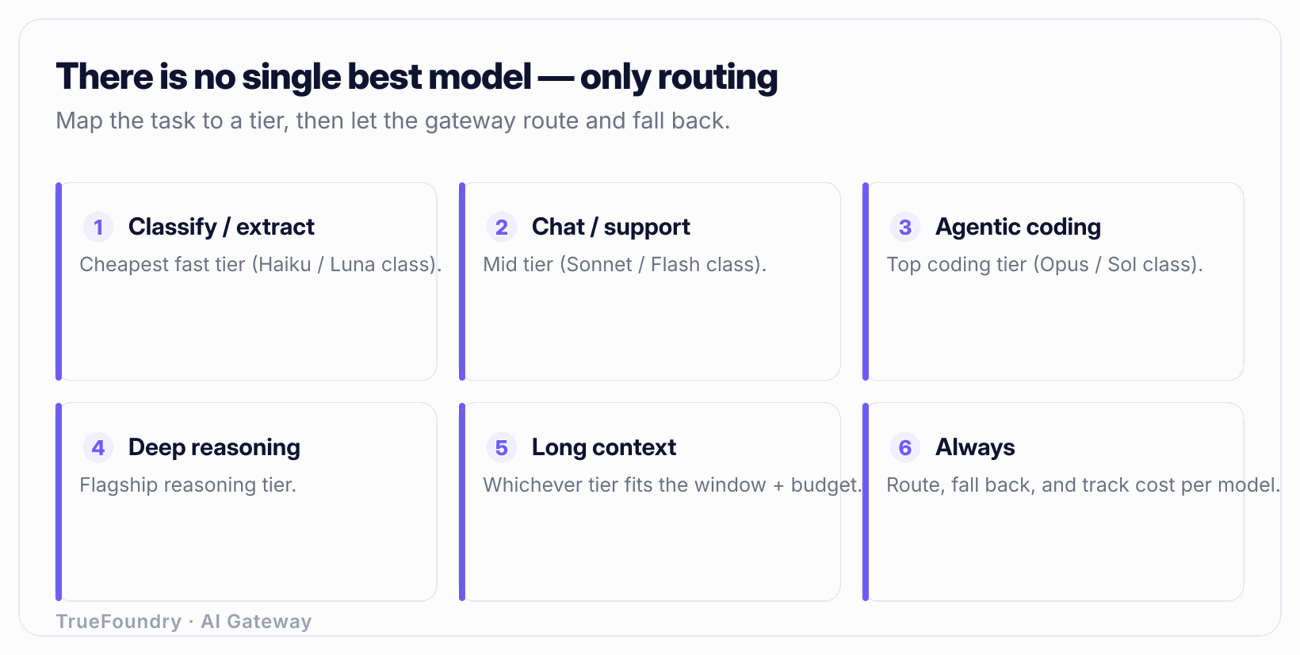
Tarifs et benchmarks rapportés en date de novembre 2026 ; vérifiez sur la page tarifaire officielle de chaque fournisseur avant de vous y fier — les spécifications évoluent fréquemment.
Découvrez comment TrueFoundry route, gère le secours (fallback) et suit les coûts pour chaque modèle. Réservez une démo.
Imaginons un produit qui génère 10 millions de requêtes par mois. Prenons une répartition 80/15/5 : 80 % de tâches simples (classification, extraction, routage), 15 % de chat et codage quotidien, 5 % de raisonnement complexe et codage agentique. Comptez en moyenne 500 tokens d'entrée et 200 tokens de sortie par requête pour les niveaux simple et chat, et davantage pour le niveau complexe.
Si vous routez tout vers un modèle phare unique à 4 $ / 20 $, vous payez le tarif fort sur l'ensemble des 10M de requêtes, y compris les 8M qu'un modèle à 0,10 $ aurait traitées de manière identique. Routez plutôt par tâche :
Le niveau simple, qui représente le gros du volume, coûte désormais environ 1/40e par token d'entrée par rapport au modèle phare. Sur la plupart des charges de travail réelles, cela réduit la facture totale de plus de la moitié tout en conservant les requêtes complexes sur le modèle exact dont elles ont besoin. Le chiffre exact dépend de votre volume de tokens, ce qui confirme le principe : vous mesurez par niveau, ce qui exige une visibilité des coûts par modèle. Consultez l'attribution des coûts LLM et les budgets d'équipe pour savoir comment appliquer cette rigueur à vos équipes.
Le cadre ci-dessus n'est utile que si vous pouvez l'appliquer sans redéployer votre code à chaque changement. C'est précisément le rôle d'une AI gateway. Une passerelle expose une API unifiée compatible OpenAI à votre application. Derrière ce point d'accès unique, vous configurez le modèle réel vers lequel chaque requête est dirigée. L'application envoie toujours la même structure de requête ; la passerelle décide de la destination.
Ce découplage apporte quatre avantages directs en lien avec le cadre :
L'avantage d'une API unique est plus important qu'il n'y paraît. Lorsqu'un nouveau modèle sort (Terra est apparu fin octobre ; un autre arrivera en décembre), vous l'ajoutez comme cible et vous redirigez le trafic par une simple modification de configuration. L'application ne s'en aperçoit même pas. Pour découvrir l'architecture sous-jacente, consultez qu'est-ce qu'un proxy LLM et comment choisir une AI gateway.
En cette fin d'année 2026, la frontière de l'IA n'est pas un sommet unique avec un vainqueur incontesté. C'est un ensemble de niveaux, et les équipes qui gèrent le mieux leurs dépenses sont celles qui associent chaque segment de leur trafic au bon niveau, au lieu de payer des tarifs de modèles phares pour faire de la simple classification. Les noms des fournisseurs continueront de changer, les prix de bouger et les classements de se réorganiser. Mais le cadre d'analyse demeure : classifiez votre trafic, associez chaque classe à un niveau et une posture de coût, et filtrez l'accès au niveau le plus cher pour que seules les requêtes complexes l'atteignent.
Transformez ce cadre en politique de routage au niveau d'une passerelle, et la question du « choix du modèle » cessera d'être un débat permanent pour devenir une simple ligne de configuration modifiable en quelques minutes. Vous routerez par tâche et par coût, basculerez en secours si un fournisseur flanche, mettrez en cache les doublons et suivrez exactement ce que chaque modèle coûte par requête. C'est la meilleure méthode pour rester à la pointe de la technologie sans jamais vous retrouver verrouillé auprès d'un seul acteur.
Ne vous enfermez plus dans un seul modèle — routez de l'un à l'autre. Réservez une démo.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception





