



October 10, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Published: October 10, 2026
Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Deux chiffres dominent la plupart des discussions comparant Claude Sonnet 4.5 et GPT-5. Anthropic facture Claude Sonnet 4.5 à 3 $ par million de jetons en entrée et 15 $ par million de jetons en sortie. OpenAI facture GPT-5 à 1,25 $ et 10 $. GPT-5 l'emporte haut la main sur la grille tarifaire publiée.
Les grilles tarifaires ne règlent pas grand-chose en production. Un agent de codage qui relance deux fois une tâche échouée a déjà dépensé les économies réalisées sur les jetons. Un pipeline de résumé avec un préfixe stable de 40 000 jetons se comporte différemment d'un agent qui réécrit le contexte à chaque tour.
Les deux fournisseurs ont également évolué au-delà de ces versions. OpenAI décrit GPT-5 comme son précédent modèle de raisonnement et oriente les développeurs vers GPT-5.6. Anthropic positionne désormais des modèles Claude plus récents au-dessus de Claude Sonnet 4.5 pour de nombreux besoins de développement. Les équipes qui codent en dur le nom de l'un ou l'autre modèle créent une dette de migration précoce.
Les deux modèles ciblent des charges de travail d'IA générative avancées, bien que leurs conceptions diffèrent. Lire le positionnement de chaque fournisseur en dit plus aux acheteurs qu'un simple classement. La décision pratique entre Claude Sonnet 4.5 et GPT-5 commence par le cas d'utilisation principal.
Anthropic a positionné Claude Sonnet 4.5 autour du travail de codage exigeant, des agents à exécution longue et de l'utilisation informatique. La note de lancement le décrit comme une version majeure pour les agents du monde réel, avec une tarification maintenue aux mêmes taux de 3 $ et 15 $ que Claude Sonnet 4. L'identifiant du modèle API est `claude-sonnet-4-5-20250929`, un instantané figé plutôt qu'un pointeur mobile.
GPT-5 est le modèle de raisonnement d'OpenAI pour le codage et les tâches agentiques dans divers domaines, accessible via les API Chat Completions et Responses. Son instantané est `gpt-5-2025-08-07`. Le modèle accepte des entrées textuelles et visuelles et renvoie du texte, avec une prise en charge des jetons de raisonnement et un paramètre `reasoning.effort` acceptant les valeurs `minimal`, `low`, `medium` et `high`.
Une différence pratique apparaît immédiatement. GPT-5 ne prend pas en charge le réglage fin (fine-tuning) ni les sorties prédites, selon la documentation du modèle d'OpenAI. Claude Sonnet 4.5 expose des contrôles agentiques, y compris une réflexion entrelacée via un en-tête bêta pour le raisonnement connecté aux outils.
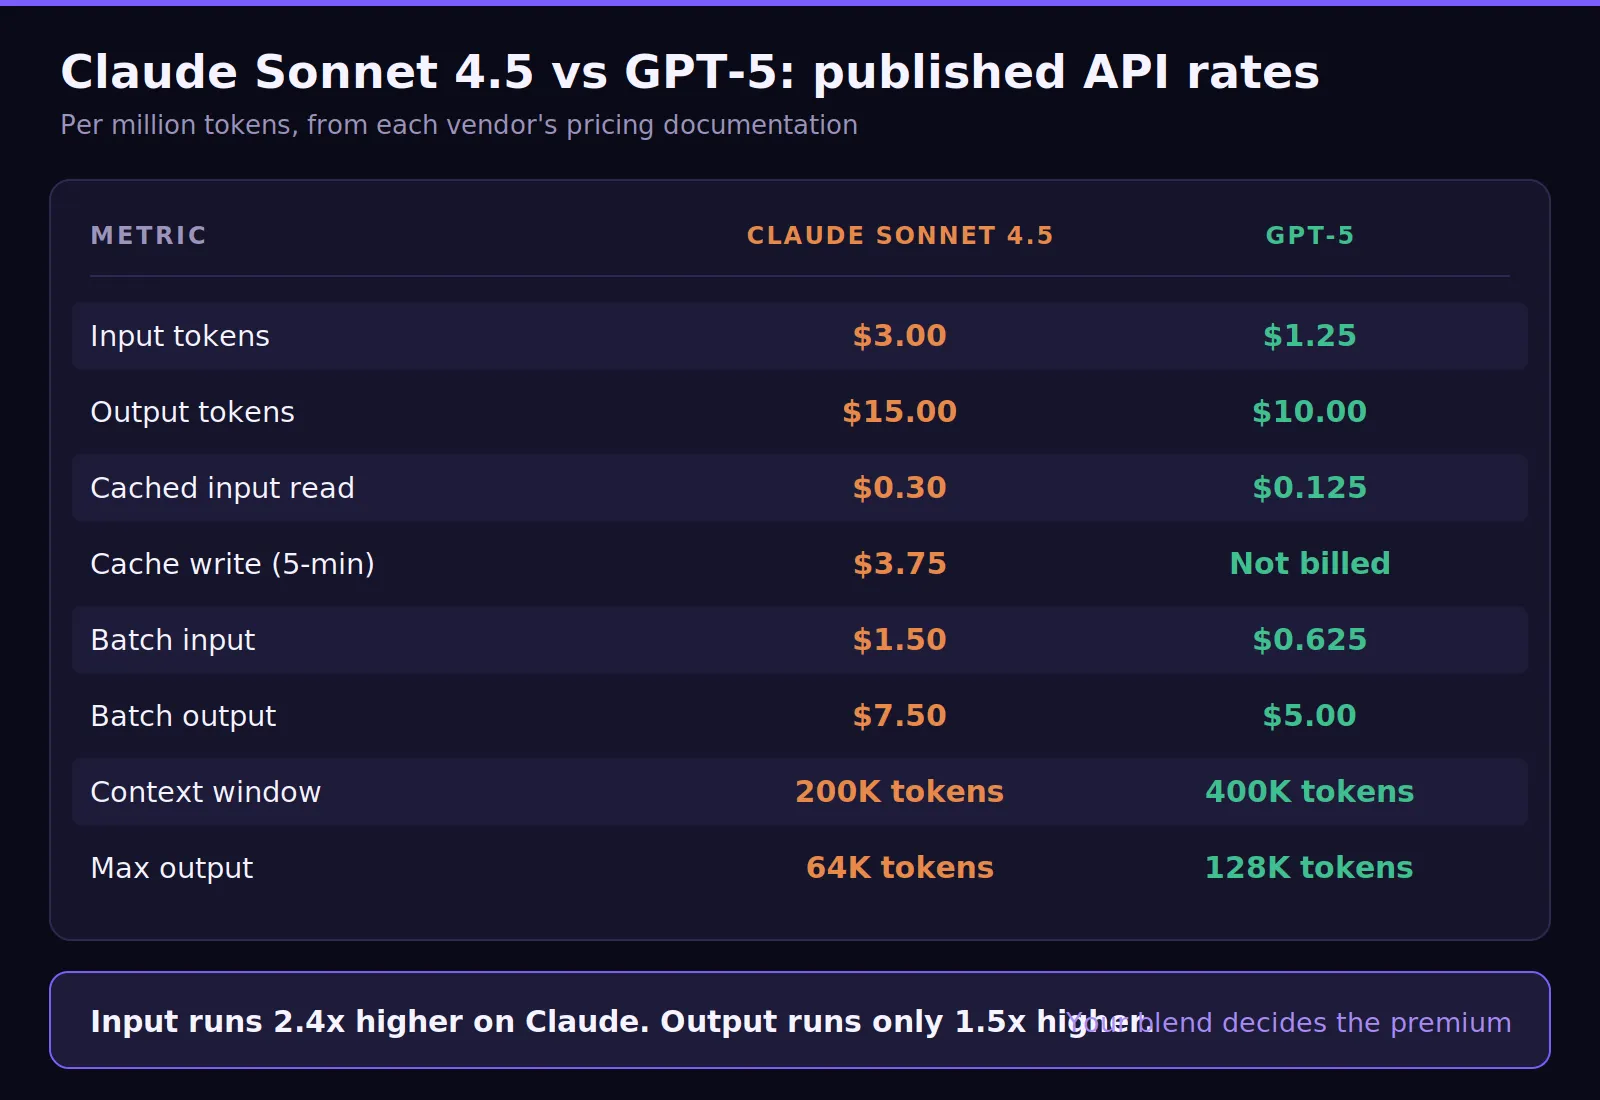
La tarification est le point où les deux modèles se distinguent le plus nettement. Chaque tarif ci-dessous provient de la documentation tarifaire publiée par les fournisseurs. Les acheteurs doivent tout de même modéliser les coûts par charge de travail, car les coûts d'entrée, la longueur de sortie, le comportement du cache et les tentatives de relance affectent la facture finale.
Deux ratios comptent plus que les chiffres absolus. L'entrée coûte 2,4 fois plus cher sur Claude Sonnet 4.5. La sortie coûte 1,5 fois plus cher. Comme ces écarts diffèrent, la prime globale dépend du nombre de jetons que votre charge de travail consomme et génère.
Prenons 1 000 requêtes avec 30 000 jetons d'entrée et 2 000 jetons de sortie chacune, sans mise en cache. Claude Sonnet 4.5 coûte 90,00 $ pour l'entrée et 30,00 $ pour la sortie. GPT-5 coûte 37,50 $ pour l'entrée et 20,00 $ pour la sortie.
Cela crée une comparaison de 120,00 $ contre 57,50 $. Claude coûte 2,09 fois plus cher dans cet exemple. L'avantage en termes de coûts pour GPT-5 est clair sur l'économie brute des jetons, en particulier pour les flux de travail à haut volume de support, de classification et de gestion de contenu.
Servons maintenant 90 % de cette entrée depuis le cache. Claude Sonnet 4.5 tombe à 8,10 $ pour les lectures en cache, 9,00 $ pour l'entrée fraîche et 30,00 $ pour la sortie. GPT-5 atteint 27,13 $. La prime diminue car la mise en cache réduit le côté entrée.
La comptabilité du cache est le piège à souligner. Anthropic facture les écritures en cache de cinq minutes à 1,25 fois le tarif d'entrée de base. La grille tarifaire publiée de GPT-5 par OpenAI ne mentionne aucun frais distinct pour l'écriture en cache. Le prix des jetons de réponse et le renouvellement du cache peuvent donc modifier le meilleur choix.
Le coût répond à une question. La capacité d'un modèle d'IA à conserver la tâche en mémoire assez longtemps pour la terminer en répond à une autre, plus complexe. Dans le duel Claude Sonnet 4.5 vs GPT-5, la fenêtre de contexte, les limites de sortie et les contrôles de raisonnement méritent une lecture attentive.
L'écart de contexte est facile à sous-estimer. GPT-5 accepte deux fois plus d'entrées et émet deux fois plus de sorties maximales. Cela compte pour les refontes importantes, les pages de texte, les flux de travail complexes et les longues traces d'agents qui arrivent sous forme d'une seule grande tâche.
Sonnet 4.5 répond avec une fonctionnalité qui manque à GPT-5. La gestion du contexte d'Anthropic injecte le budget restant du modèle directement dans la requête, sous la forme `<budget:token_budget>200000</budget:token_budget>` dans le prompt système, accompagnée d'un `<system_warning>` dynamique après chaque appel d'outil. Les plans du modèle reposent sur la capacité réelle restante plutôt que sur une estimation.
Claude Sonnet 4.5 prend également en charge le raisonnement entrelacé avec les outils via un en-tête bêta. Cela facilite les tâches de raisonnement complexe, l'analyse scientifique, l'analyse financière, le raisonnement mathématique et les opérations métier autonomes où les résultats des outils influencent l'étape suivante.
GPT-5 prend en charge différents niveaux d'effort de raisonnement via un mode standard et des paramètres de raisonnement avancés. Cela offre aux équipes un levier supplémentaire pour ajuster la latence, la qualité analytique et la rentabilité. Le choix du modèle dépend toujours de la qualité mesurée au sein de la charge de travail cible.
Les benchmarks peuvent guider une première sélection, bien qu'ils ne doivent pas remplacer les tests internes. Artificial Analysis publie un indice d'intelligence et des comparaisons de modèles, tandis que d'autres sources couvrent les performances ART, l'intelligence d'analyse et les scores de raisonnement spécialisés. Considérez ces éléments comme des indicateurs de départ, et non comme des preuves définitives pour vos achats.
Le positionnement d'Anthropic se concentre sur l'ingénierie logicielle, l'utilisation d'outils et le travail autonome de longue durée. Cela rend Claude Sonnet 4.5 pertinent pour le codage assisté par agent, la génération de code, la revue de code et l'exécution autonome. Le modèle est particulièrement intéressant lorsque la qualité permet de réduire les cycles de révision.
Considérez la qualité du modèle comme étant spécifique à votre charge de travail. Les benchmarks de codage mesurent des tâches publiques, alors que vos ingénieurs travaillent dans des dépôts privés. Les conventions de dépôt, les graphes de dépendances, la culture de revue et la structure des tests déterminent si Claude Sonnet offre des performances supérieures.
Testez les deux modèles sur les 20 mêmes tickets internes, puis évaluez-les avec une grille de notation fixe. Comptez les tentatives infructueuses, les prompts de suivi, les erreurs d'outils et les pull requests acceptées. Un modèle plus coûteux par appel peut rester rentable s'il nécessite moins de révisions.
La comparaison la plus pertinente ne provient que rarement d'un classement universel. Une équipe peut constater une avance nette pour Claude sur un dépôt et pour GPT-5 sur un autre. C'est pourquoi la réponse au duel Claude Sonnet 4.5 vs GPT-5 doit découler d'essais sur des charges de travail réelles.
La tarification par jeton publiée pour GPT-5 est inférieure à celle de Claude Sonnet 4.5 pour les entrées, les sorties, les lectures en cache et l'utilisation par lots. Cela modifie l'équation économique pour les charges de travail de production à haut volume. L'automatisation du support, la classification, les contrôles de qualité du langage naturel et les outils internes penchent souvent en faveur de GPT-5.
La fenêtre de contexte plus large de 400 000 jetons aide pour une autre catégorie de charges de travail. Les pipelines de traitement de documents peuvent tenir dans un seul appel plutôt que de nécessiter un découpage et une fusion des réponses. Moins de segments signifie moins de fusions, moins d'échecs et moins de complexité opérationnelle.
Le coût ne doit pas être le seul critère de décision. La qualité de sortie, le comportement en cas de nouvelle tentative, le taux de réussite du cache et la revue humaine affectent les dépenses totales. La date de coupure des connaissances de GPT-5 est également antérieure à celle de Claude Sonnet 4.5, ce qui peut être important pour les frameworks, API et flux de travail d'entreprise récents.
GPT-5 peut également convenir à un public général et à des cas d'utilisation larges sur des plateformes d'IA. Il peut prendre en charge des contenus similaires pour le support, les résumés, l'analyse et les flux de travail CMS. Pour l'ancrage dans la recherche Google, Gemini 3 Pro, Cosmic AI ou un autre modèle spécialisé pourraient faire l'objet d'une comparaison distincte.
La plupart des équipes voient cette décision comme un choix unique et définitif. C'est généralement une erreur. La meilleure approche consiste à segmenter par charge de travail, puis à se demander si un seul modèle doit tout gérer. Cela rend la comparaison entre GPT-5 et Claude Sonnet 4.5 plus utile sur le plan opérationnel.
Choisissez Claude Sonnet 4.5 lorsque :
Choisissez GPT-5 lorsque :
Choisissez une couche de modèle gouvernée lorsque :
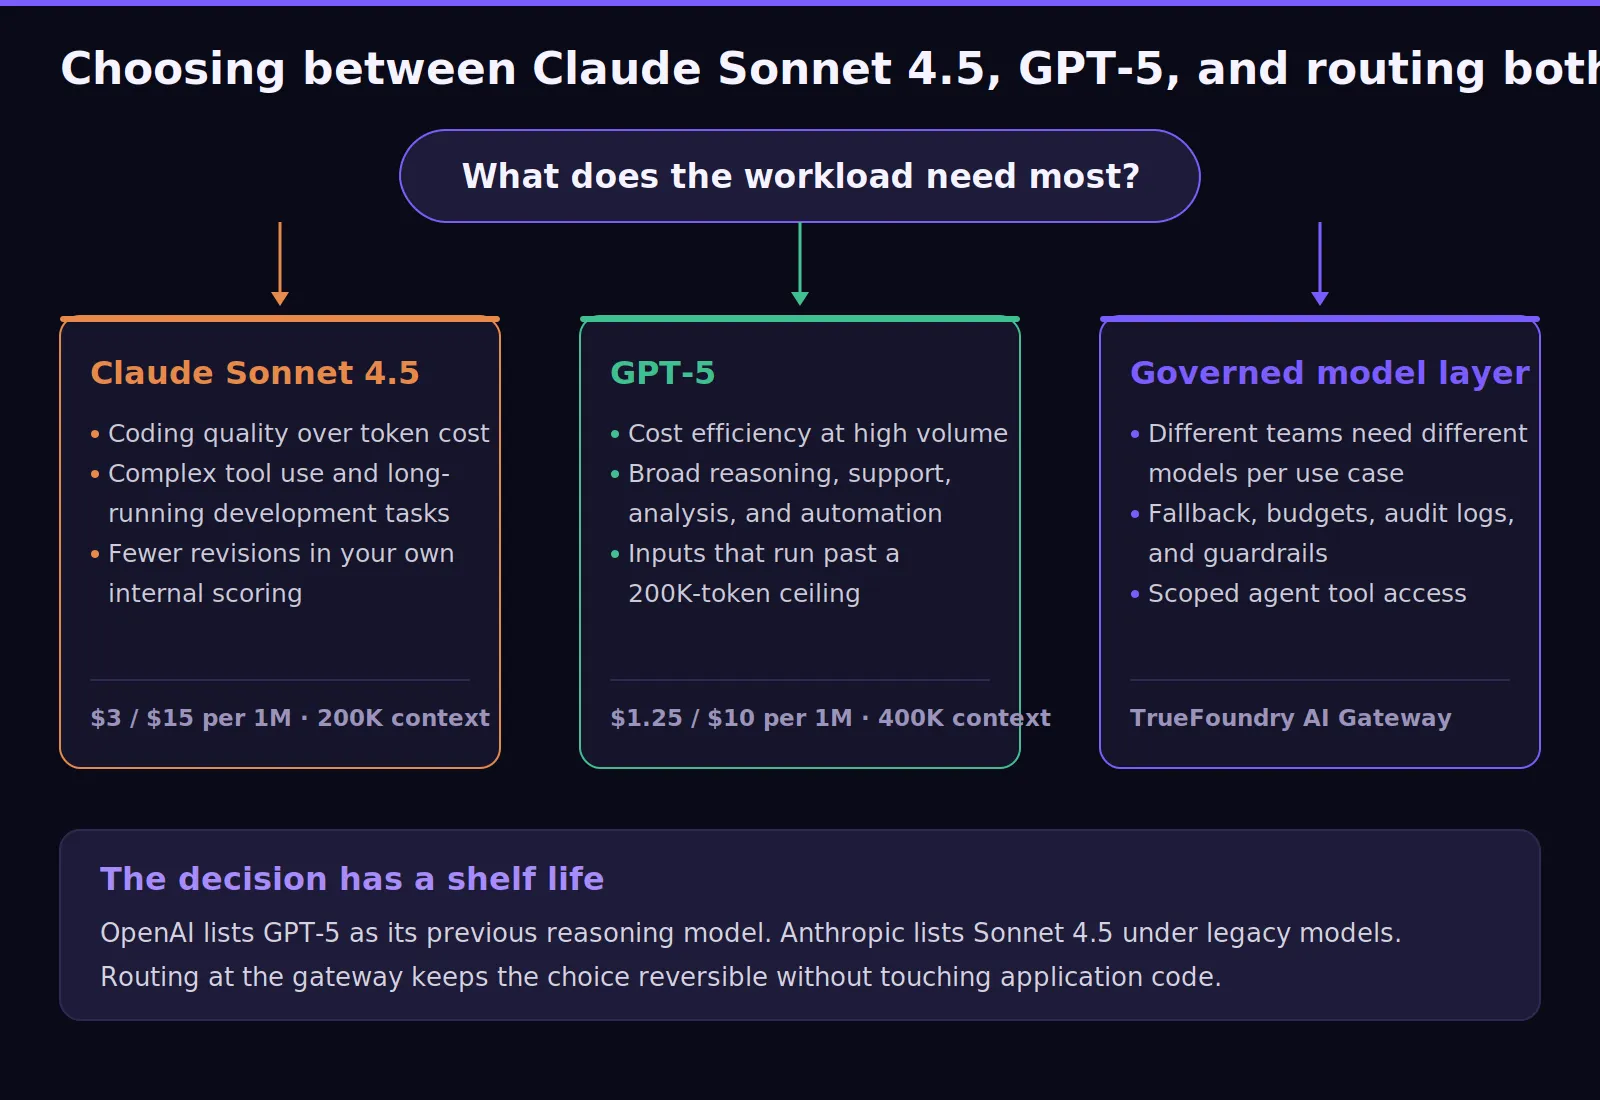
La comparaison ci-dessus a une durée de vie limitée. GPT-5 porte déjà l'étiquette d'un modèle précédent. Anthropic propose des modèles plus récents que Claude Sonnet 4.5. Le paysage de l'IA évolue rapidement, et TrueFoundry permet d'isoler le roulement des modèles du code applicatif.
Les équipes peuvent évaluer Claude Sonnet 4.5 et GPT-5 en fonction de la qualité, du coût, de la latence et de la profondeur de raisonnement. La couche de gouvernance reste indépendante des deux fournisseurs. Différents groupes peuvent ainsi utiliser des modèles distincts pour le codage, l'automatisation du support, l'analyse et les copilotes internes.
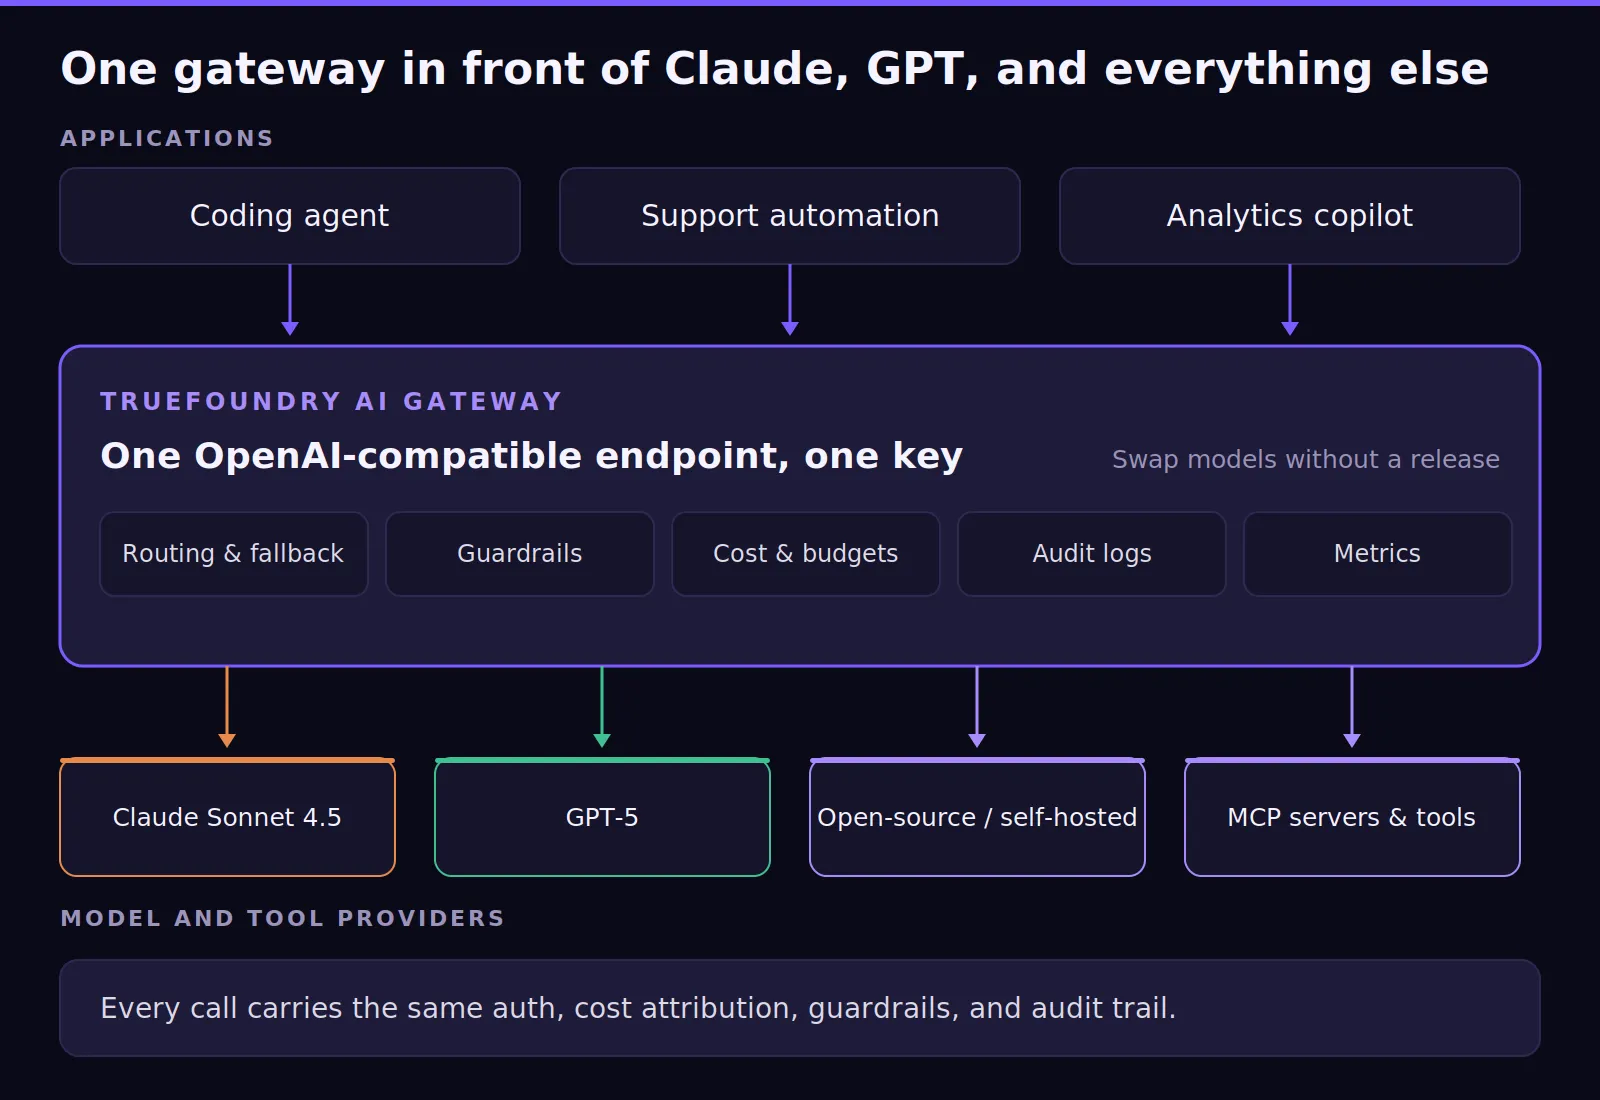
La passerelle IA s'interpose entre les applications et les fournisseurs de modèles. Elle expose un point de terminaison compatible avec OpenAI tout en appliquant l'authentification, la journalisation, des garde-fous et un contrôle des coûts. Cette même couche peut gérer des modèles Claude, GPT, open-source ou auto-hébergés.
from openai import OpenAI

client = OpenAI(
    api_key="your-truefoundry-pat",
    base_url="https://{your-gateway-host}/api/llm/api/inference/openai",
)

# Same client, same call shape, different backend model.
for model in ["anthropic-main/claude-sonnet-4-5", "openai-main/gpt-5"]:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "Refactor this handler for idempotency."}],
        extra_headers={"X-TFY-METADATA": '{"team":"platform","environment":"staging"}'},
    )
    print(model, response.usage)
Passerelle LLM pour le routage multi-modèles. La passerelle LLM achemine les requêtes vers différents fournisseurs via une interface unique. Ainsi, GPT-5 peut gérer le résumé de gros volumes de données tandis que Sonnet 4.5 prend en charge le codage et les parcours des agents. Un modèle virtuel leur attribue à tous un nom stable unique, faisant du changement de cible une simple modification de configuration plutôt qu'une nouvelle mise en production.
routing_config:
  type: priority-based-routing
  load_balance_targets:
    - target: anthropic-main/claude-sonnet-4-5
      priority: 0
      retry_config:
        attempts: 2
        delay: 100
        on_status_codes: ["429", "500", "503"]
      fallback_status_codes: ["429", "500", "502", "503"]
    - target: openai-main/gpt-5
      priority: 1
      fallback_candidate: true
Les règles sont évaluées dans l'ordre et la première correspondance est retenue. La configuration `retry_config` par cible gère les échecs temporaires pour un même modèle, tandis que `fallback_status_codes` transfère la requête lorsque les tentatives de nouvelle connexion sont inutiles. TrueFoundry détecte également une cible défaillante à partir de ses requêtes, jetons et échecs par minute, puis la met en retrait pour une période de refroidissement.
Passerelle MCP pour un accès sécurisé aux outils. La passerelle MCP régit la manière dont les applications et les agents accèdent aux outils, aux API, aux bases de données et aux systèmes métier. L'accès délimité est essentiel dès lors qu'un agent propulsé par Claude ou GPT peut récupérer des enregistrements, appeler des services ou déclencher des flux de travail.
Passerelle d'agents pour une gouvernance au niveau des flux de travail. La passerelle d'agents ajoute une gouvernance au niveau des flux de travail pour les tâches autonomes. Elle permet de contrôler les comportements en plusieurs étapes, les limites d'exécution, la messagerie inter-agents et le suivi des sessions. Les boucles infinies et les actions non sécurisées deviennent des données de télémétrie plutôt que des mauvaises surprises en fin de mois.
Garde-fous, contrôle des coûts et pistes d'audit. Ils transforment GPT-5 et Claude Sonnet 4.5 en une solution de production encadrée. Le tableau de bord des métriques permet de suivre la latence, le temps jusqu'au premier jeton, le coût d'inférence, les jetons d'entrée et de sortie, les métriques de cache et les blocages liés aux limites budgétaires.
Cette capacité transforme la comparaison en une réponse opérationnelle plutôt qu'en une simple opinion ponctuelle. Diriger 10 % du trafic vers un autre modèle et analyser le coût par tâche résolue est bien plus efficace que de relire une grille tarifaire. Cela aide également les équipes à prendre des décisions éclairées.
Gardez une flexibilité dans le choix des modèles tout en maintenant une gouvernance de production cohérente. Réserver une démo pour découvrir comment TrueFoundry orchestre Claude, GPT, les modèles open-source et personnalisés via une passerelle IA unifiée et sécurisée.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception




















