



October 9, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Published: October 9, 2026

Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Lorsqu'un appel LLM est lent, coûteux ou erroné, vous devez comprendre ce qui s'est réellement passé. Un garde-fou a-t-il modifié le prompt ? Combien de temps le modèle a-t-il pris par rapport au réseau ? Qu'est-ce que la passerelle a envoyé au fournisseur ? La journalisation et le traçage des requêtes sur la Passerelle IA répondent à ces questions pour chaque appel.
Comme chaque requête transite déjà par la passerelle, vous bénéficiez de cette visibilité sans avoir à instrumenter manuellement chaque application.
Ladocumentation sur la journalisation des requêtes vous permettent de contrôler quelles requêtes sont journalisées. Le contrôle le plus simple s'effectue par requête, en utilisant l'en-tête X-TFY-LOGGING-CONFIG avec une valeur JSON sous forme de chaîne. Définissez « enabled » sur « true » pour journaliser la requête ou sur « false » pour l'ignorer.
Un point important à noter : la valeur de cet en-tête est un JSON sous forme de chaîne de caractères, et non un objet JSON brut, car la plupart des SDK sérialisent les en-têtes sous forme de chaînes. Les anciens modes de journalisation globale sont remplacés par une configuration de journalisationbasée sur des règles, qui vous permet de contrôler la journalisation par sujet, modèle ou métadonnée, et de masquer les valeurs sensibles.
Pour consulter les requêtes journalisées dans l'interface, accédez à AI Gateway, puis à Monitor, et enfin à Requests. Vous obtiendrez la liste de tous les appels journalisés, que vous pourrez ouvrir pour inspecter chaque requête en détail.
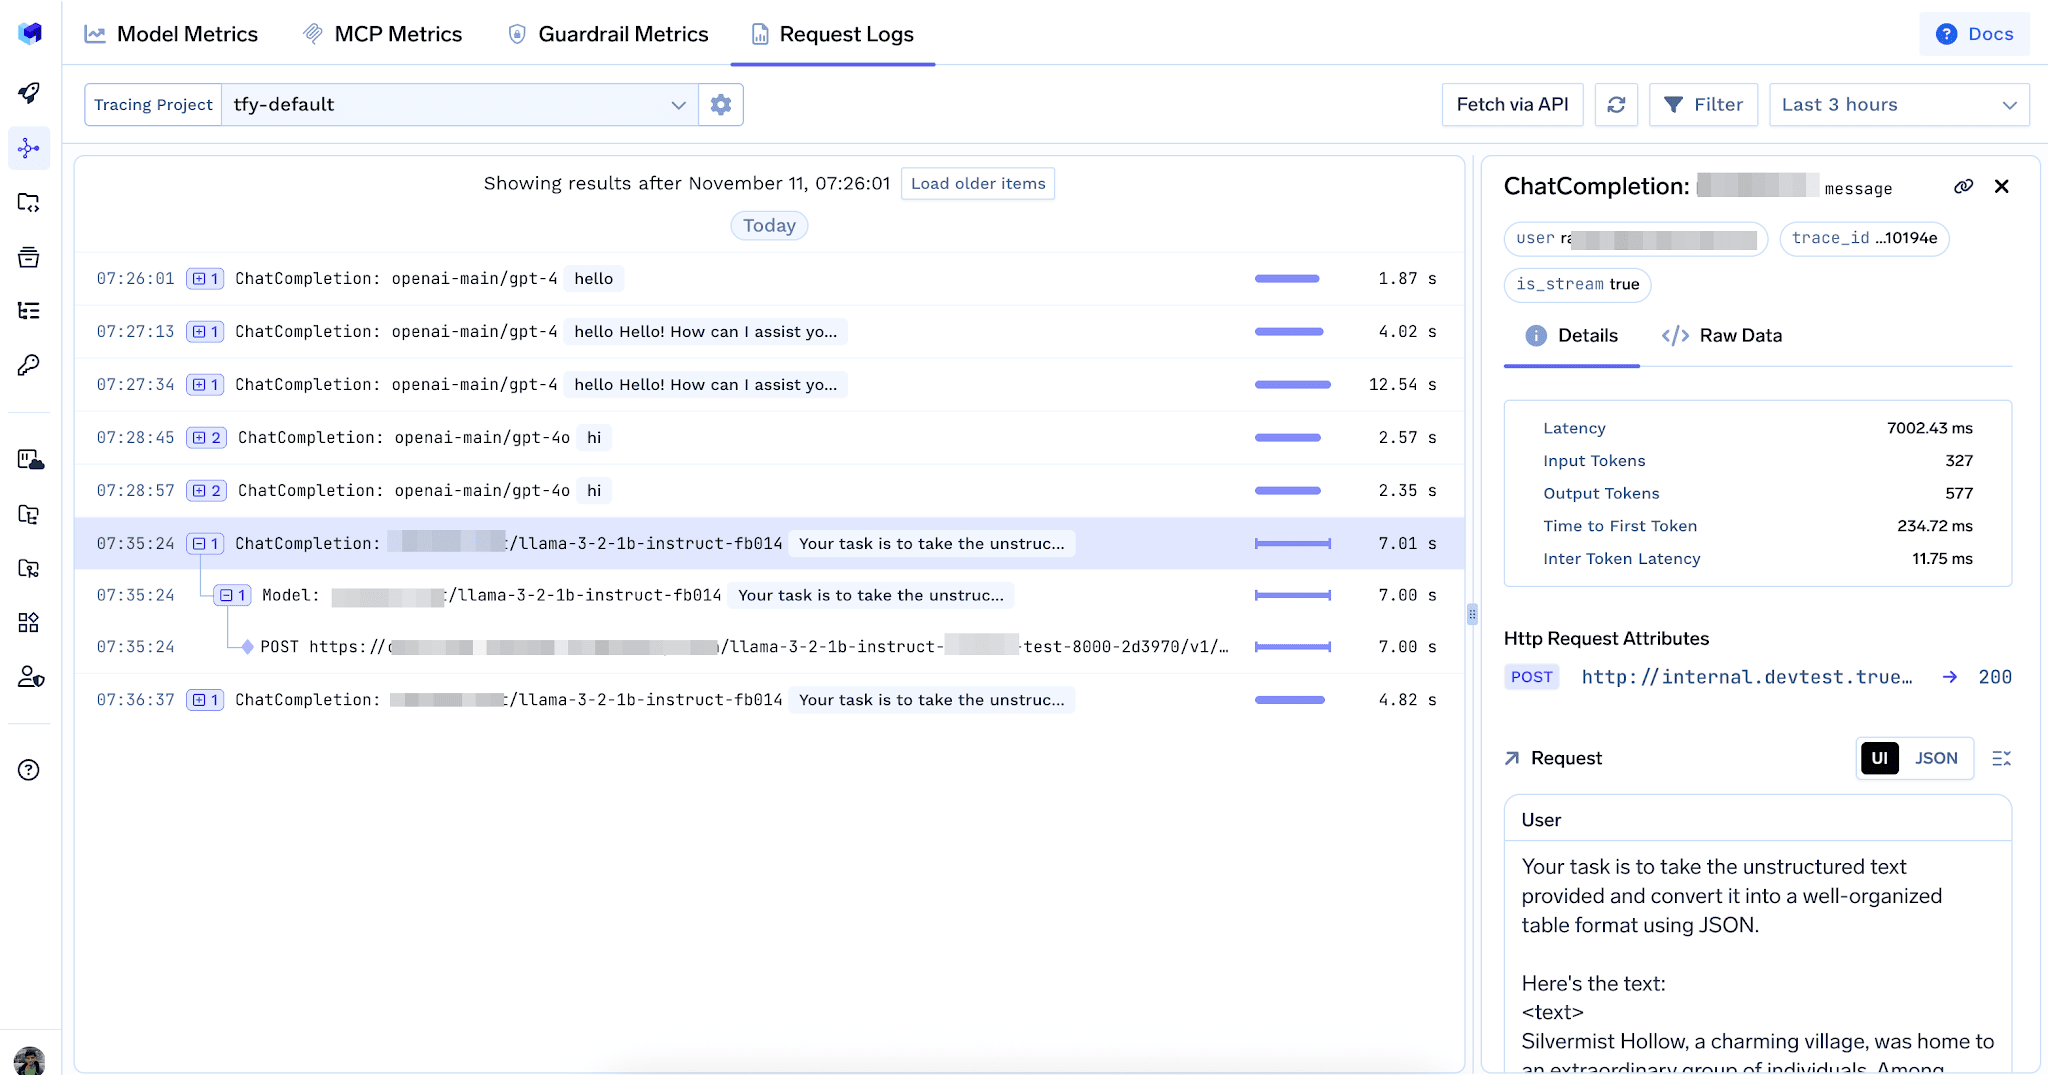
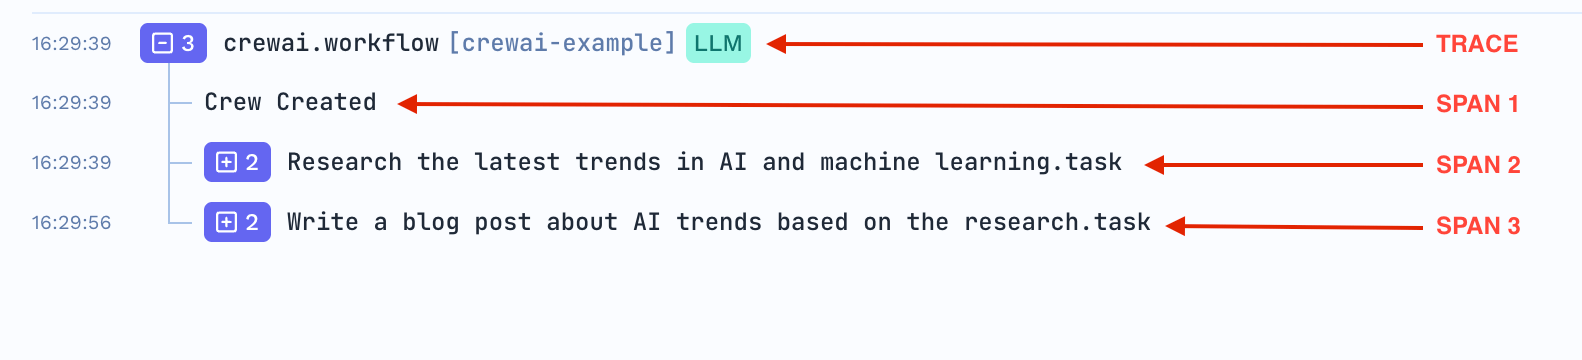
Ladocumentation sur le traçage décrit une trace comme le cycle de vie complet d'une requête à mesure qu'elle transite par les services interagissant avec le LLM. En général, une trace correspond à un appel API unique d'une application.
Un span est une unité de travail individuelle au sein de cette trace, comme un appel de fonction, une requête HTTP ou une inférence de modèle. Une trace est une arborescence de spans avec des relations parent-enfant, où un span enfant est généralement provoqué par son parent. TrueFoundry fournit un backend de collecte OpenTelemetry qui stocke ces traces ainsi qu'une interface pour les interroger et les analyser ; il peut recevoir des traces provenant de n'importe quel SDK compatible OpenTelemetry.
Ladocumentation sur l'inspection des traces examinons un exemple concret : une complétion de chat avec une barrière de protection pour la rédaction des données personnelles (PII), capturée sous forme de cinq spans formant une hiérarchie.
Dans ce même exemple, l'entrée est visiblement expurgée, passant d'un nom à un espace réservé, ce qui démontre le fonctionnement de bout en bout de la barrière de protection PII au sein de la trace.
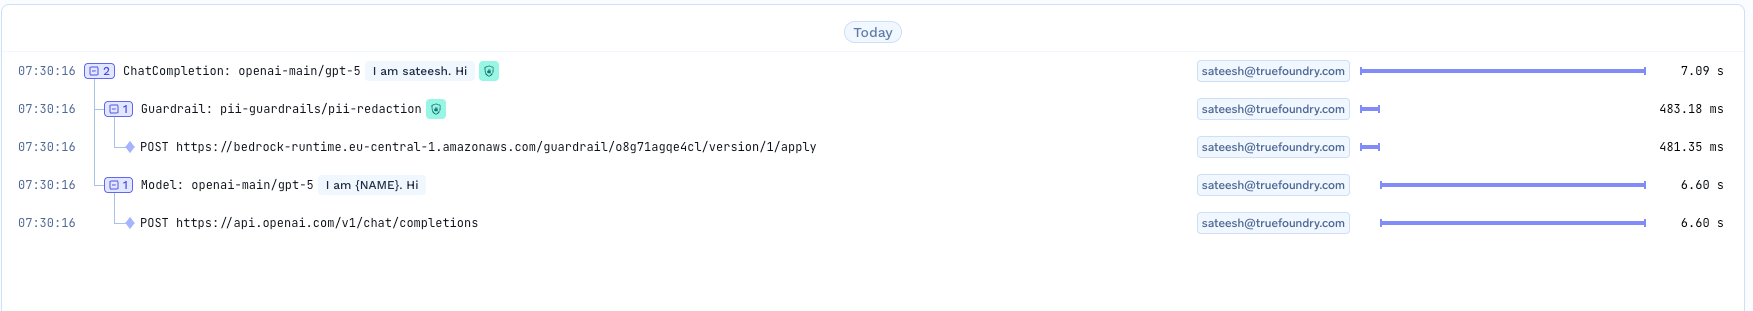
Une trace de complétion de chat montrant les spans de la barrière de protection, du modèle et du réseau sortant.
Les traces individuelles servent au débogage. Pour les tendances, le tableau de bord analytique agrège ces mêmes données. Les onglets couvrent la vue d'ensemble, les métriques de modèle, les métriques MCP, les métriques de barrière de protection, les métriques de routage et les métriques de cache.
Les métriques de modèle peuvent être regroupées par modèles, modèles virtuels, utilisateurs, comptes virtuels, équipes ou métadonnées. Les vues de latence décomposent la latence des requêtes, le temps jusqu'au premier jeton, la latence entre les jetons et le temps par jeton de sortie. Associé aux traces par requête, cela vous offre à la fois le microscope et le tableau de bord.
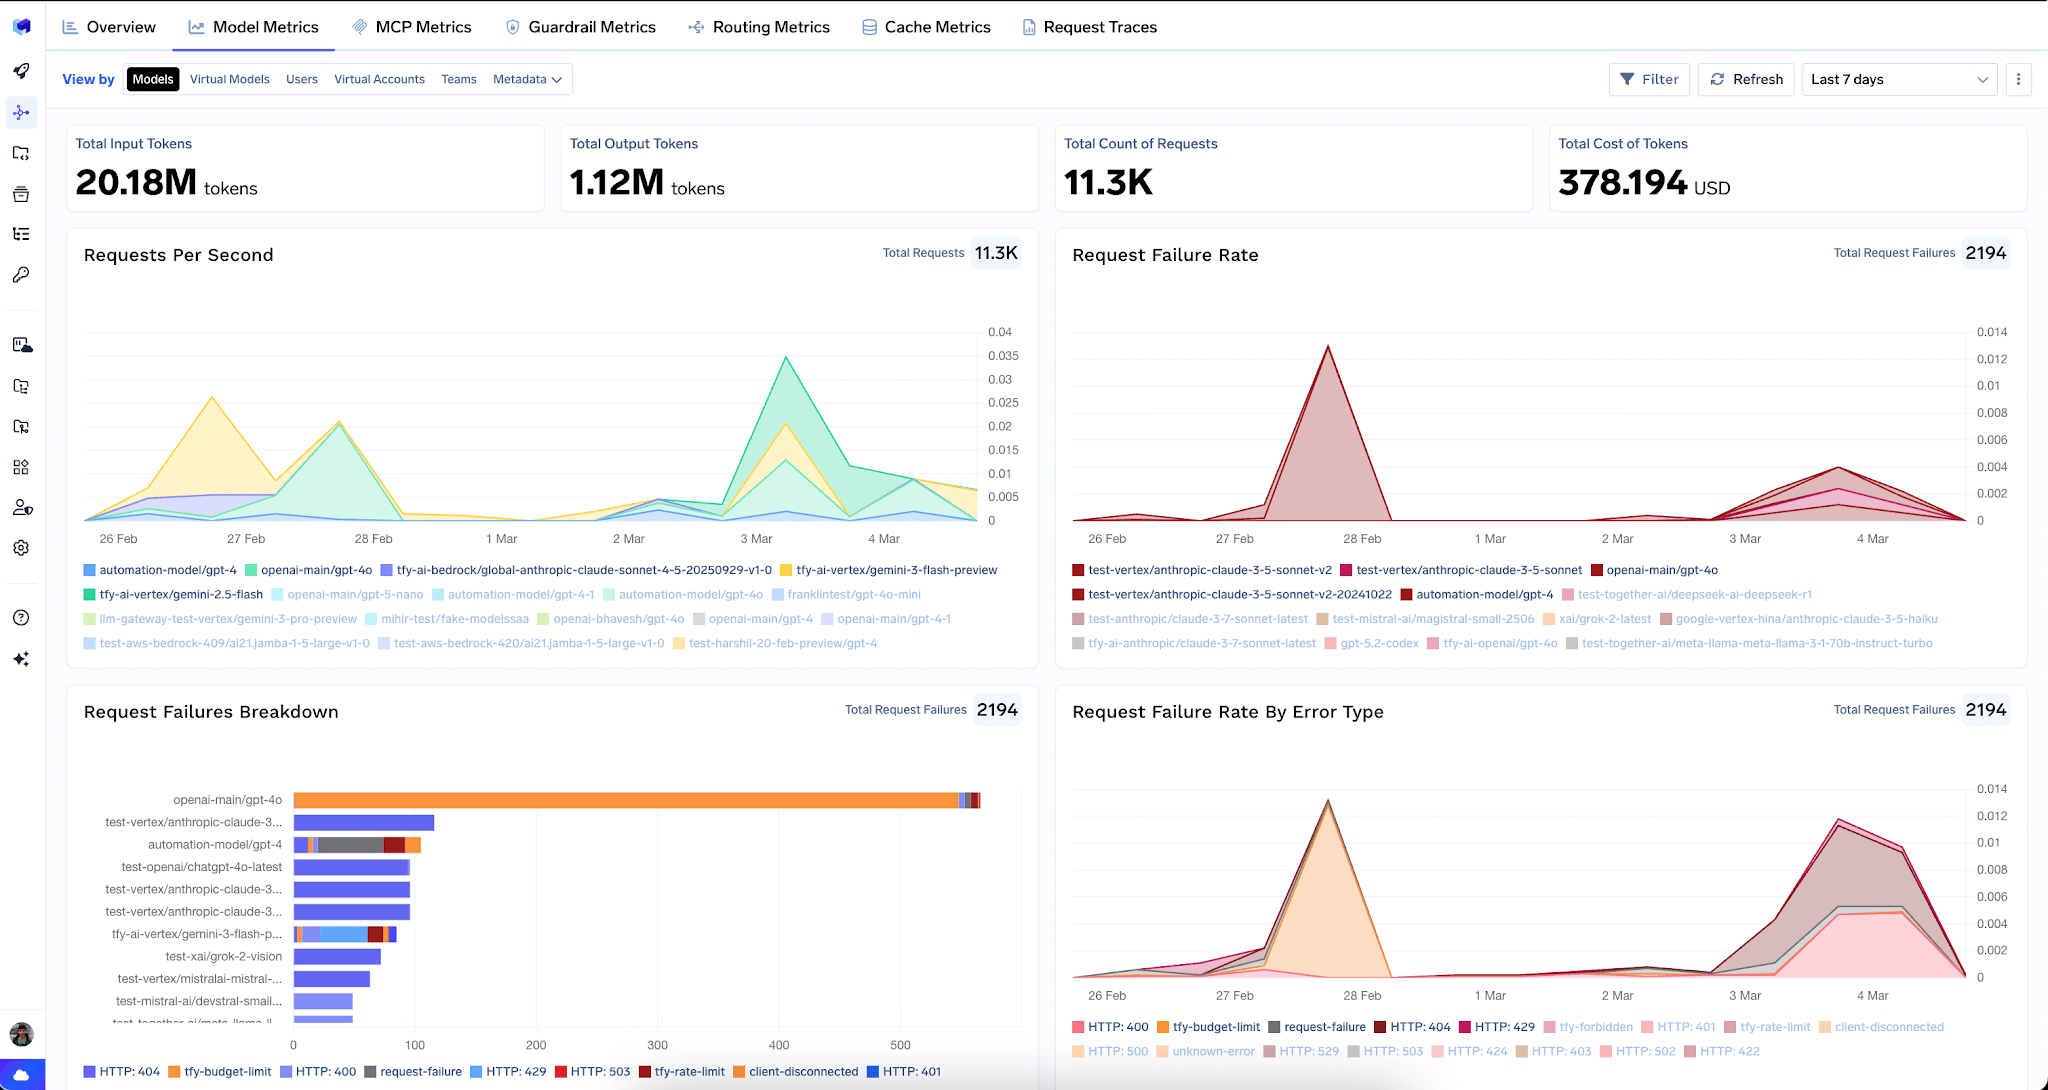
Métriques de modèle dans le tableau de bord analytique, regroupables par équipe, utilisateur, modèle, et plus encore.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.




Send the X-TFY-LOGGING-CONFIG header with a stringified JSON value and set enabled to true or false. Remember that the value is stringified JSON, not a raw object, because most SDKs serialize headers as strings.
Logged requests appear under AI Gateway, then Monitor, then Requests. Opening a request shows its trace, which is the tree of spans covering guardrails, the model, and the outbound provider calls.
A trace is the full lifecycle of a single request. A span is one unit of work inside that trace, such as a guardrail check or a model inference. Spans form a parent and child tree within the trace
Yes. TrueFoundry runs an OpenTelemetry collector backend and can receive traces from any OpenTelemetry compatible SDK. For LLM use cases the docs recommend an LLM focused SDK that captures model specific traces and metrics.



Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception
















