



November 14, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Une semaine après l'arrivée de GPT-6 Sol dans le catalogue, OpenAI a lancé son successeur. GPT-6.1 Sol a été déployé le mardi 29 septembre, et il figurait déjà dans le catalogue de modèles de TrueFoundry AI Gateway avec sa tarification, ses limites de contexte et ses fonctionnalités complétées.
Vous l'appelez depuis le même endpoint compatible OpenAI que vous utilisez pour tout le reste. Pas de nouveau SDK, pas d'intégration séparée, pas d'attente d'une version de la gateway. Changez la chaîne du modèle pour gpt-6.1-sol sur votre compte OpenAI (openai/gpt-6.1-sol sur OpenRouter) et vous êtes sur le nouveau modèle.
Essayez GPT-6.1 Sol sur TrueFoundry AI Gateway →
GPT-6.1 Sol remplace GPT-6 Sol au même prix catalogue, avec un caching moins cher et des limites identiques. Les chiffres qui comptent pour un budget de production :
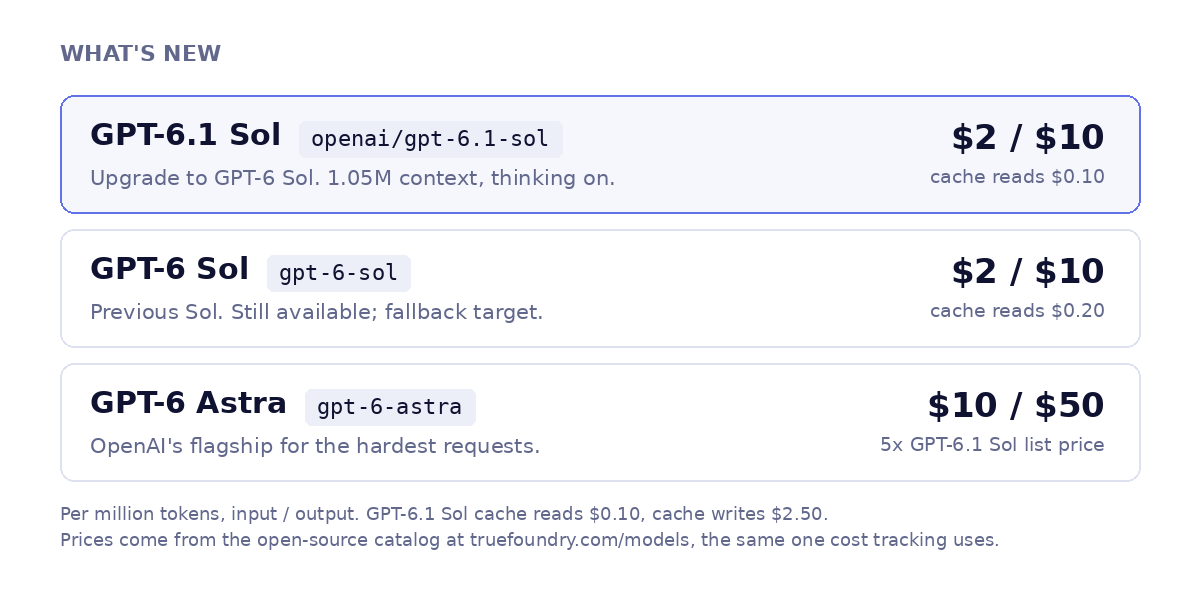
Le catalogue affiche GPT-6 Astra à 10 $ par million de tokens d'entrée et 50 $ par million en sortie. GPT-6.1 Sol s'affiche à 2 $ et 10 $, exactement un cinquième des deux côtés, et ses lectures de cache à 0,10 $ représentent un dixième des 1 $ d'Astra.
Mettez côte à côte les sorties du mois : GPT-6 Luna à 0,10 $ par million de tokens d'entrée, GPT-6 Sol, GPT-6.1 Sol et Claude Sonnet 5.5 à 2 $, Claude Opus 5.5 à 4 $, GPT-6 Astra à 10 $. GPT-6.1 Sol prend la place de GPT-6 Sol sur l'échelle au même prix, avec le tarif de lecture de cache le plus bas de cette ligne à 2 $.
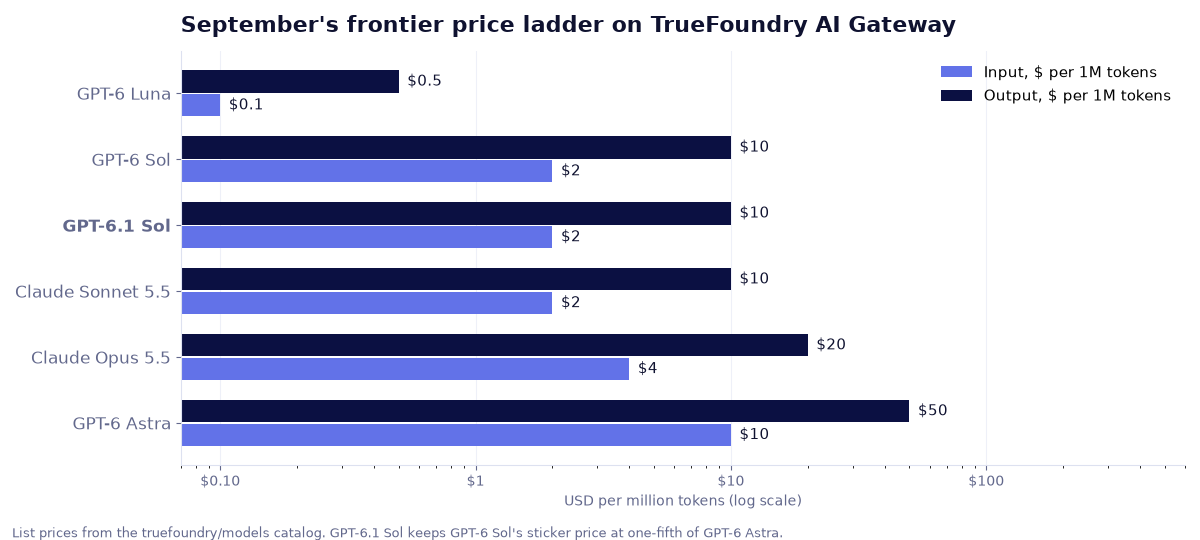
C'est l'argument pour traiter le choix du modèle comme une configuration de la gateway plutôt que du code d'application. La majeure partie du trafic en production se compose d'un grand nombre de requêtes simples et d'un petit nombre de requêtes difficiles. Si la majorité simple va vers Luna, que le milieu va vers GPT-6.1 Sol et que seule la minorité difficile va vers Astra, la facture globale ne ressemble en rien à une facture 100 % Astra. Cela ne fonctionne que si le changement est une modification de configuration, ce à quoi sert l'AI Gateway.
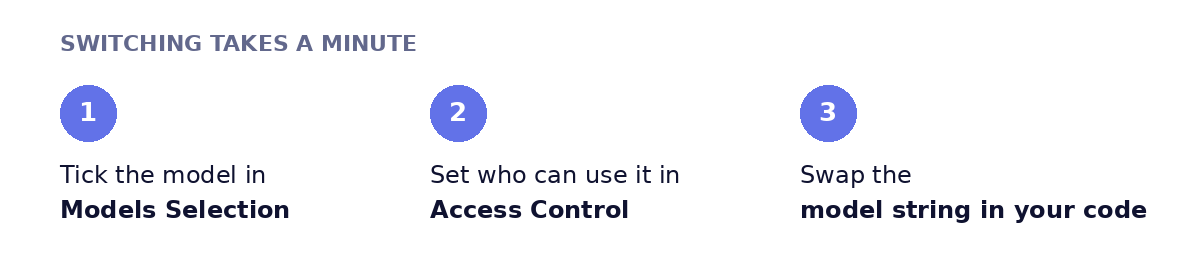
Étape 1 : Activez le modèle dans votre compte fournisseur. Dans la gateway, ouvrez Models → votre compte OpenAI → Models Selection, recherchez gpt-6.1-sol et cochez-le. La tarification s'affiche directement (2 $ en entrée / 10 $ en sortie par million de tokens) car elle provient directement du catalogue. Définissez ensuite l'Access Control pour que le modèle soit délimité aux bonnes équipes et clés virtuelles dès le premier jour.
OpenAI direct et OpenRouter (openai/gpt-6.1-sol) sont tous deux présents dans le catalogue aujourd'hui ; les entrées Microsoft Foundry et AWS Bedrock sont en cours d'intégration.
Vous ne voyez pas le modèle dans votre liste ? + Add Model au bas de la liste permet de l'ajouter manuellement.
Étape 2 : Appelez-le. Ouvrez le Playground, choisissez le modèle et copiez le extrait généré dans le SDK que vous utilisez. La version Python pour OpenAI :
Les identifiants de modèle utilisent un espace de noms sous la forme <compte-fournisseur>/<modele>, de sorte que passer de openai-main/gpt-6-sol à openai-main/gpt-6.1-sol se fait en une ligne. L'en-tête X-TFY-METADATA tague chaque appel afin que les dépenses apparaissent par équipe ou par fonctionnalité dans la vue des métriques.
Étape 3 (optionnel) : Placez-le derrière un modèle virtuel. Créez un virtual model et choisissez l'Auto Routing. La gateway classe chaque requête comme simple, medium ou complexe et l'envoie vers la cible que vous attribuez à ce niveau. Définir GPT-6 Luna pour simple, GPT-6.1 Sol pour medium, GPT-6 Astra pour complexe, avec GPT-6 Sol en secours pendant que les limites de débit de la semaine de lancement se stabilisent, constitue une cartographie de départ judicieuse. Dans nos benchmarks, ce type de routage a réduit les coûts de 50 à 70 % pour environ 98 % de la qualité. Votre application appelle un seul nom de modèle tout au long du processus.
GPT-6.1 Sol est le modèle privilégié lorsqu'une requête a besoin de plus que Luna mais que le prix d'Astra est difficile à justifier, et lorsque des agents renvoient un contexte long que le tarif de cache à 0,10 $ rend économique. L'exécuter via TrueFoundry signifie que la décision de savoir quelles requêtes sont concernées réside dans la configuration de la gateway, où vous pouvez la modifier sans déploiement.
Essayez GPT-6.1 Sol sur TrueFoundry AI Gateway →
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception


















