



November 6, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.


¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
La parte 1 definió el problema: el tokenmaxxing, la nueva métrica basada en líneas de código, donde los ingenieros optimizan para conseguir un mayor volumen de uso de IA simplemente porque es la cifra que se mide. La parte 2 prescribió la solución arquitectónica: identidad, directivas, seguridad y observabilidad vinculadas a cada solicitud en el gateway. Esta entrega final convierte esa arquitectura en algo que una organización realmente pueda operar semana a semana.
La decisión de diseño más trascendental en esta capa es también la que más fácilmente se pasa por alto. El dashboard que construyas condicionará el comportamiento. Una tabla de clasificación genera presión social para consumir tokens sin control. Una sala de control ayuda a los líderes de plataforma, seguridad, finanzas e ingeniería a responder a preguntas más complejas y actuar en consecuencia.
Las preguntas que realmente importan: ¿Qué flujos de trabajo generan valor por cada dólar gastado? ¿Qué agentes se están quedando en bucle? ¿Qué equipos están infrautilizando la IA en áreas donde su aportación sería realmente valiosa? ¿Qué uso de modelos premium está justificado y cuál es meramente decorativo? ¿Qué eventos de guardrails son mero ruido y cuáles señalan un riesgo real?
Diseña los paneles correctamente y estas cuestiones se convertirán en preguntas de operaciones rutinarias que se responderán en la reunión de sincronización de los lunes. Diseñalos mal y tu dashboard más preciso entrenará silenciosamente el mismo comportamiento manipulable que intentabas prevenir.
Antes de diseñar los paneles, hay que establecer las reglas de diseño. Cada principio es la respuesta directa a un modo de fallo introducido por las tablas de clasificación.
El panel de adopción responde a una pregunta engañosamente sencilla: ¿cuántos ingenieros están utilizando realmente herramientas de IA en un día determinado?
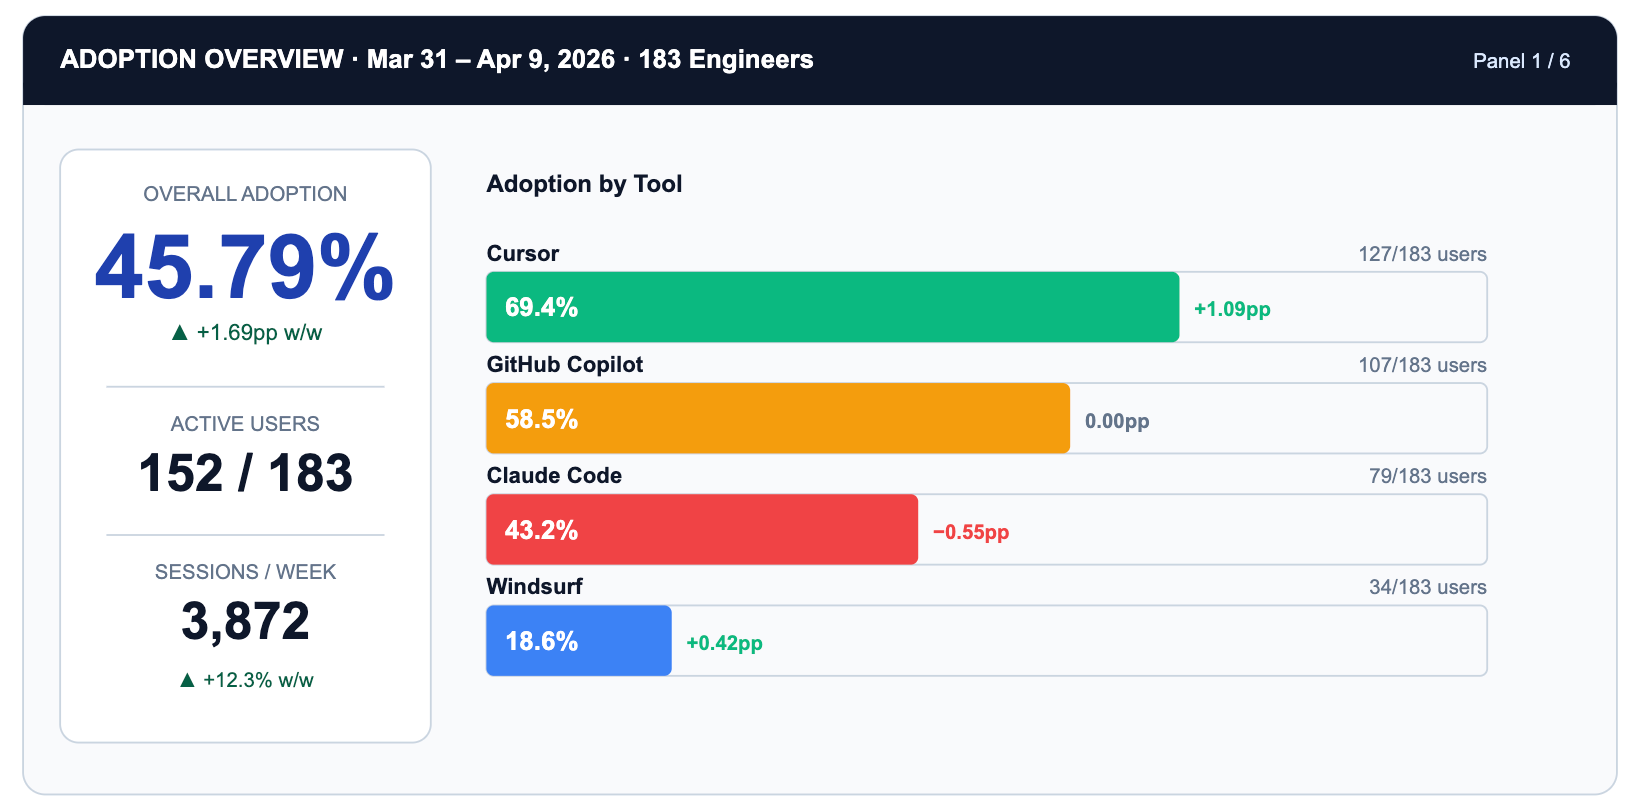
Obsérvese lo que el panel no muestra: clasificaciones individuales. La unidad de medida es proveedor x equipo x día. La acción que genera no es 'felicitar a Alex', sino 'La adopción de Claude Code está 26 puntos porcentuales por debajo de Cursor. ¿Se trata de un problema de fricción con la herramienta o de un problema de ajuste al caso de uso?' Esa es una pregunta que justifica todo un sprint.
TrueFoundry hace esto posible mediante la cabecera X-TFY-METADATA adjunta a cada solicitud del gateway. La cabecera contiene un objeto JSON codificado como cadena cuyos campos incluyen la identidad del usuario, la pertenencia al equipo, el nombre de la herramienta, la etiqueta del proyecto y el ID de sesión.
→ Referencia de cabeceras de solicitud y respuesta de TrueFoundry
→ Visión general del dashboard de analítica
La adopción indica quién está utilizando la IA. La tasa de consumo (burn rate) muestra adónde se destina el dinero. Son cuestiones distintas que deben figurar en paneles independientes.
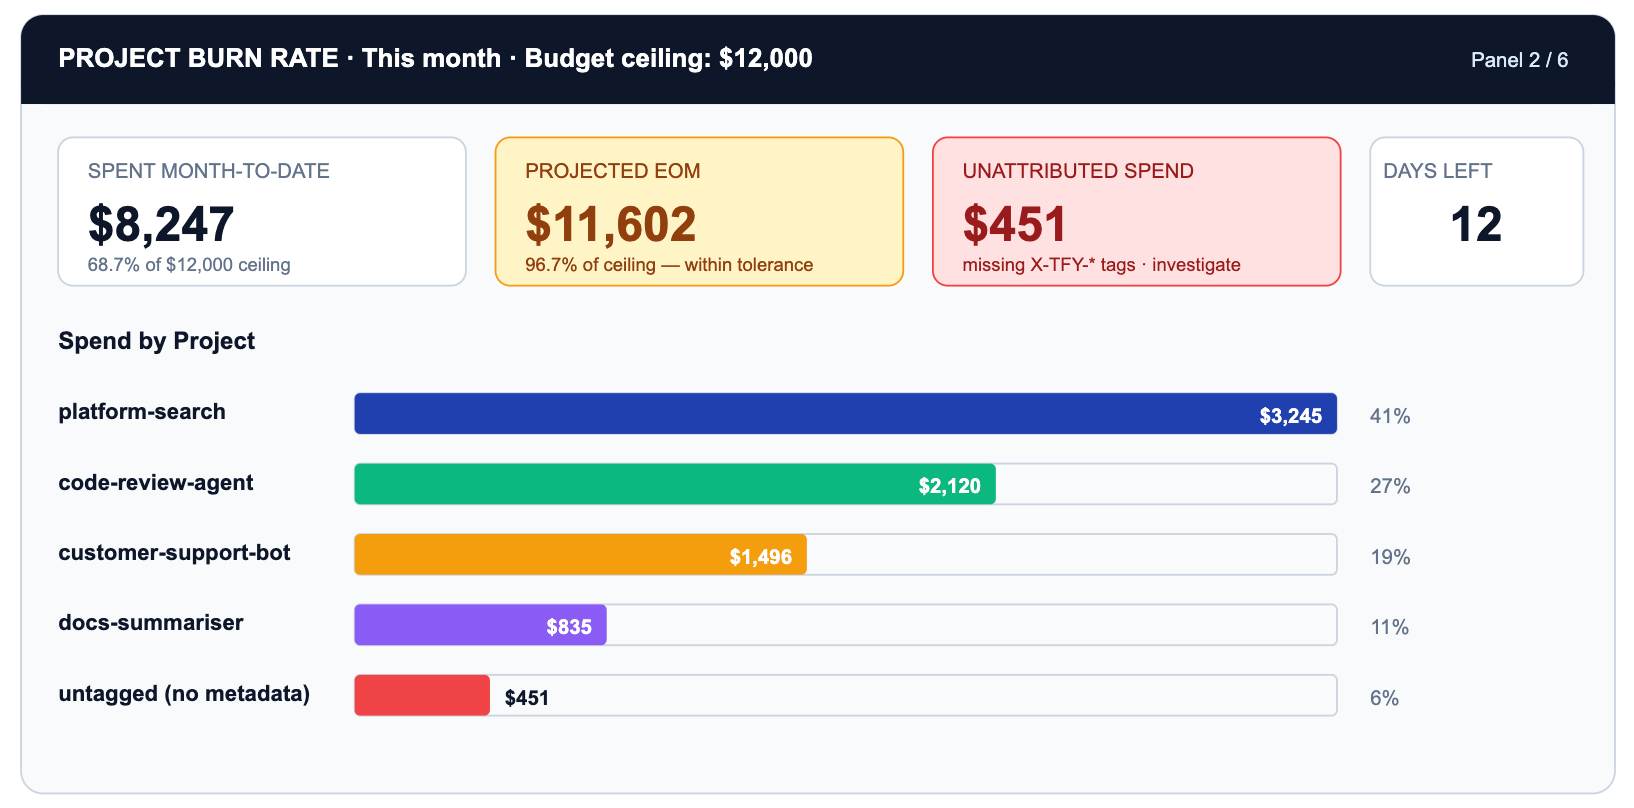
La fila crítica es UNTAGGED (sin etiquetar). Un gasto de $451 no cuenta con metadatos de proyecto. Esto representa una brecha en la configuración del gateway, no un problema de presupuesto. Cualquier solicitud sin etiquetar no se puede atribuir a un resultado de negocio, ni gobernar mediante una política de presupuesto, ni mostrar en un gráfico de tasa de consumo útil.
El límite de presupuesto (Budget Limiting) de TrueFoundry permite establecer límites estrictos por proyecto, por equipo, por familia de modelos o por ventana de tiempo. Cuando platform-search alcanza el 100 % de su límite mensual de $4.000, las solicitudes comienzan a devolver códigos 429 o se redirigen a un modelo más económico según la política configurada.
→ Límite de presupuesto: ventanas, techos y alertas
→ Límite de tasa (Rate Limiting): por usuario, por modelo y por etiqueta de metadatos
El modo de fallo nuevo más costoso en un entorno basado en agentes es el bucle infinito: un agente que reintenta indefinidamente una acción porque su condición de salida nunca se satisface, o porque la herramienta a la que llama sigue devolviendo errores. Un solo agente en bucle puede consumir en una hora la misma cantidad de tokens que un equipo entero de ingenieros en un día.
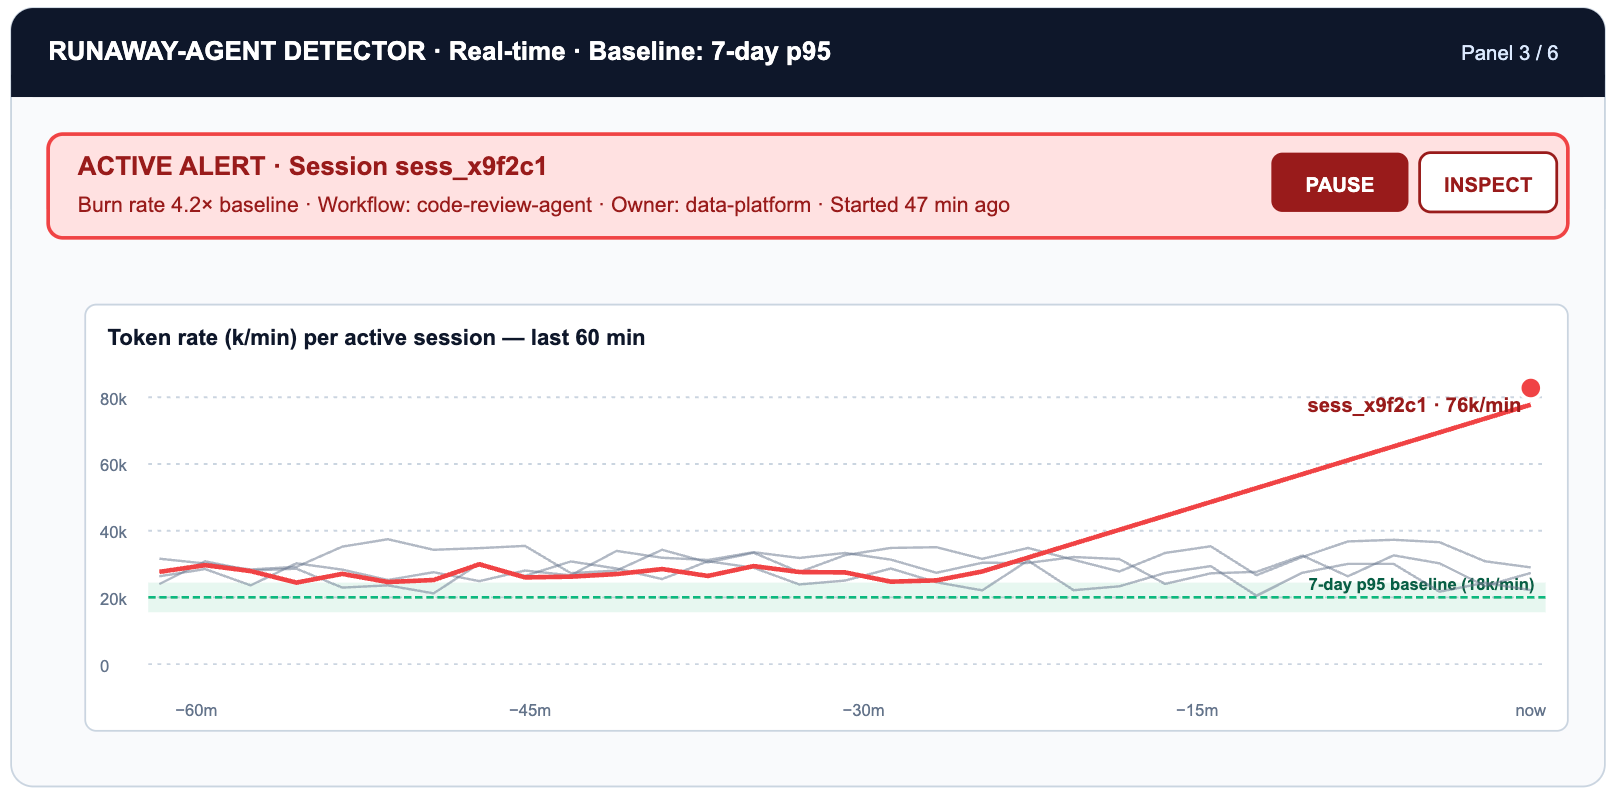
Este panel requiere la señal OTEL que exporta TrueFoundry: tasa de tokens por sesión a lo largo del tiempo, no solo el recuento por solicitud, lo que admite prácticas de AIOps como la detección de anomalías y la identificación proactiva de problemas. La línea base p95 se calcula a partir de los últimos siete días de sesiones para cada etiqueta de flujo de trabajo. Cualquier valor que supere en 3 veces dicha línea base activa un evento de localización (pager) y, de forma opcional, interrumpe la sesión mediante la vía de aplicación de límites de tasa.
→ Exportación de datos OpenTelemetry: trazas, spans y contadores de tokens
→ Límite de tasa (Rate Limiting): aplicación de límites por sesión
No todas las tareas que se envían a un modelo puntero (frontier model) necesitan un modelo de ese nivel. Redirigir una tarea de clasificación de correos electrónicos a Claude Opus 4.7 a un coste de $5/$25 por millón de tokens cuando Haiku 4.5 a $1/$5 lo resolvería con una precisión prácticamente idéntica (dentro de un margen de 2 puntos porcentuales) implica pagar 5 veces más por una capacidad que no se aprovecha. Esta decisión permanece oculta hasta que se agrega a través de miles de solicitudes diarias, que es precisamente lo que hace este panel.
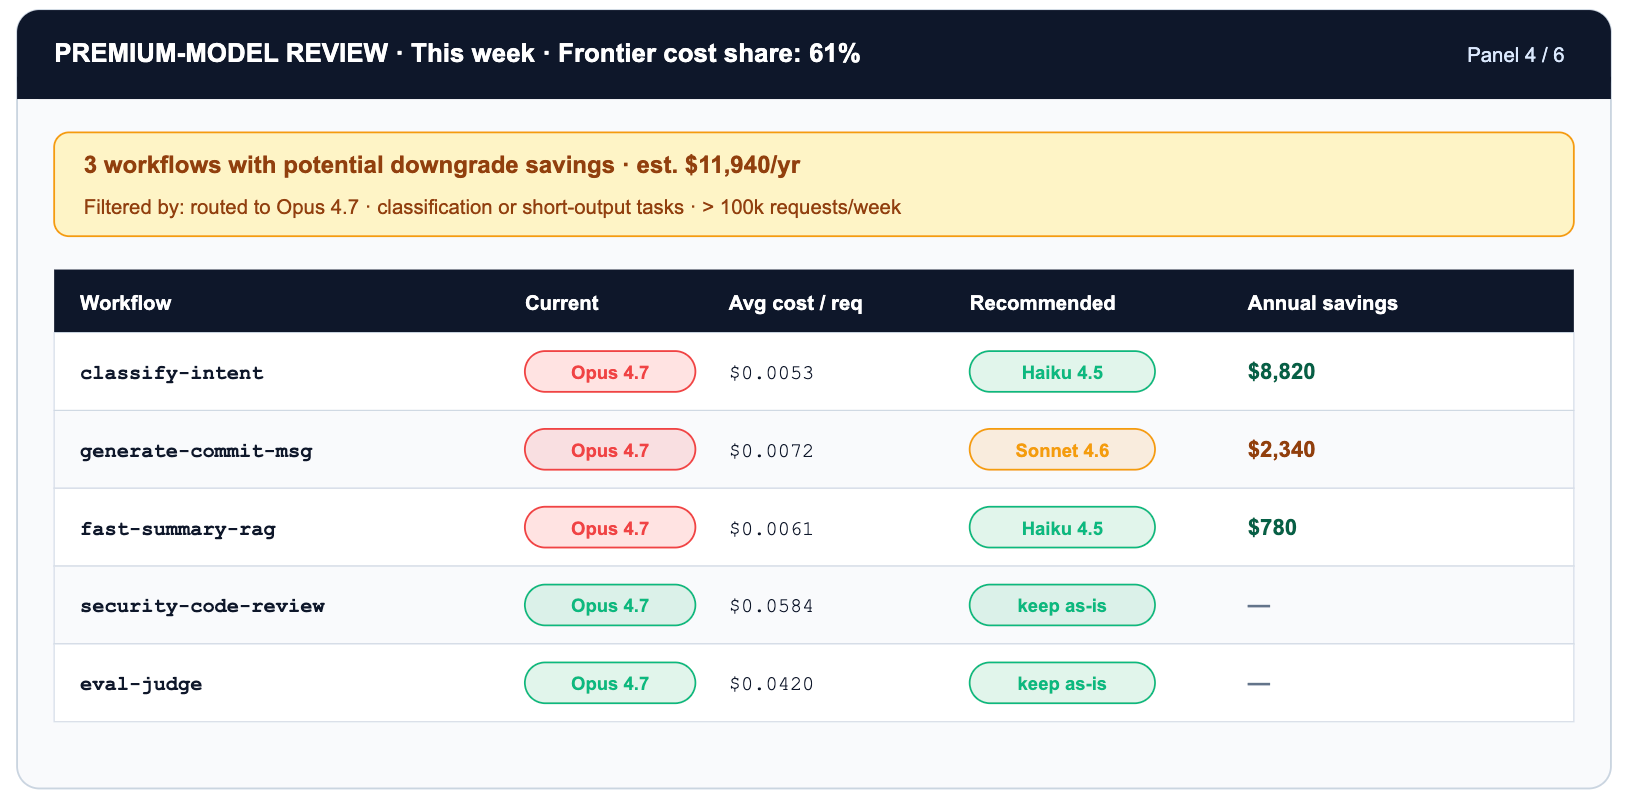
En este panel se acumulan dos niveles de optimización. Redirigir classify-intent de Opus 4.7 a Haiku 4.5 representa una reducción de 5 veces en el coste de los tokens. Además, activar el almacenamiento en caché de prompts en el prompt del sistema reduce los tokens de entrada almacenados en caché en otro 90 %, un descuento acumulado que transforma un flujo de trabajo de $3.200/mes en aproximadamente $50/mes sin alterar la precisión.
Existe también una versión implícita de este panel: la variación del tokenizador (tokenizer drift). Cuando Anthropic lanzó Opus 4.7, el nuevo tokenizador comenzó a generar hasta un 35 % más de tokens para la misma entrada en comparación con Opus 4.6. Las tarifas oficiales no cambiaron, pero el coste efectivo por solicitud sí se incrementó. La única forma de detectar esto es mediante la telemetría de tokens por versión de modelo en el gateway. La única forma de reaccionar es revertir el alias virtual del modelo, lo que en TrueFoundry se realiza mediante una simple diferencia de YAML, sin necesidad de organizar un sprint.
El enrutamiento de modelos virtuales de TrueFoundry permite actuar sobre este panel de forma inmediata. Se configura un nombre de modelo lógico como 'code-review-fast' que redirige a distintos endpoints físicos según la etiqueta del flujo de trabajo, la hora del día o la carga de trabajo, todo ello sin modificar el código de la aplicación. Realizar una prueba A/B con un modelo más económico se reduce a una diferencia de YAML, no a un sprint completo.
→ Visión general del enrutamiento: peso, prioridad, fallback y almacenamiento en caché de prompts
La función del panel de seguridad es el triaje. La mayoría de los eventos de guardrails son mero ruido: tráfico de pruebas, experimentación de desarrolladores o casos límite previstos en producción. Un reducido número de ellos representa un riesgo real: filtración de PII a través de un prompt, una credencial expuesta en el código generado por un agente o un intento de inyección de prompts en la entrada proporcionada por el usuario.
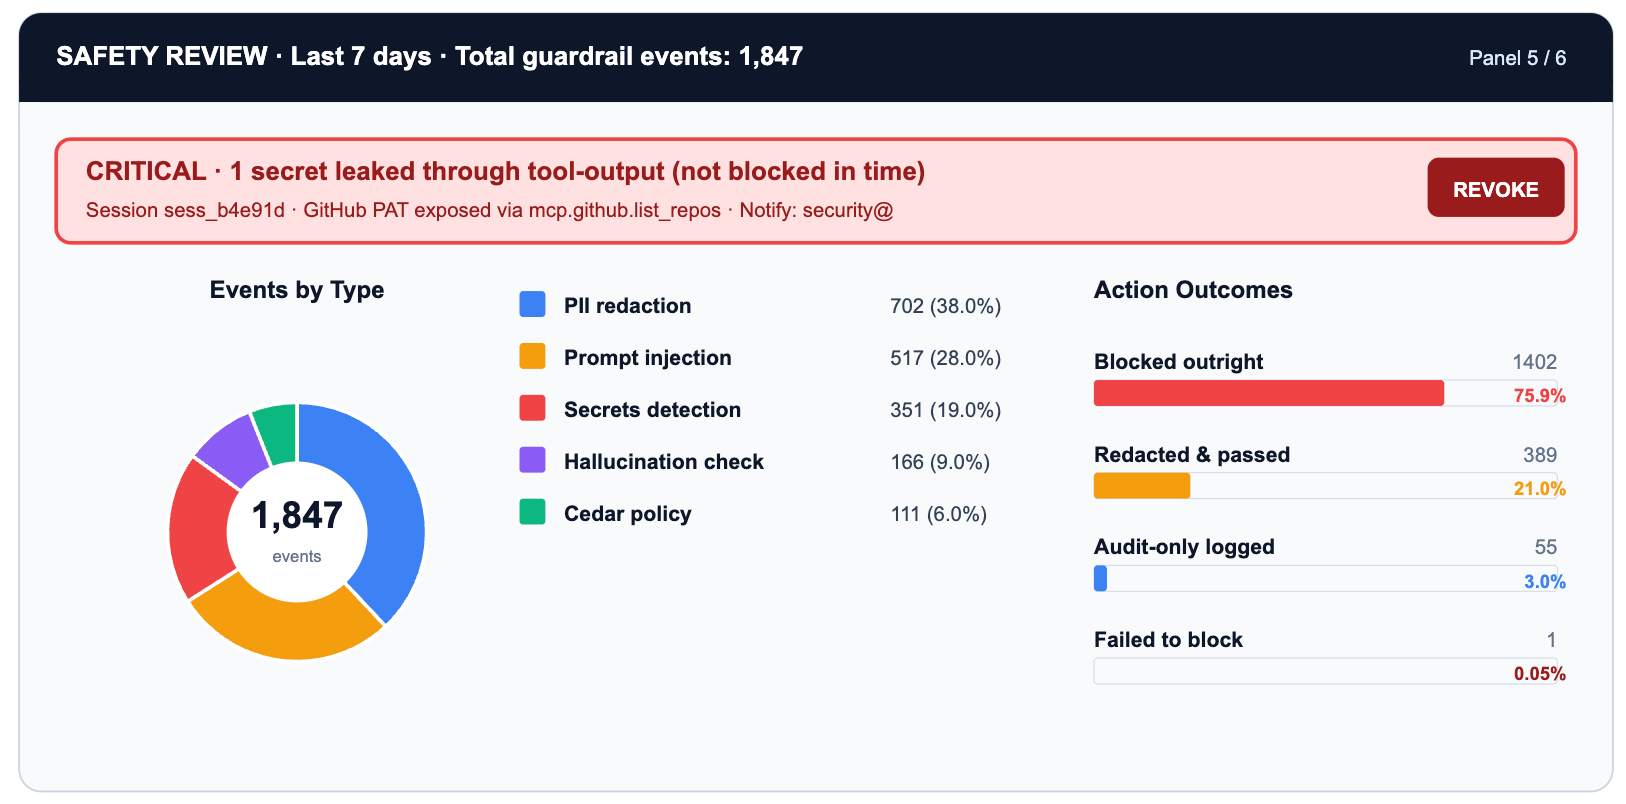
El único secreto filtrado en la fila de escaneo de credenciales (secrets-scan) es la celda que requiere una acción inmediata. Todo lo demás es informativo: útil para ajustar la sensibilidad de los guardrails, distinguir la señal del ruido y demostrar el estado de cumplimiento ante los auditores.
El modelo de guardrails de TrueFoundry basado en cuatro ganchos (request-input, request-output, tool-input, tool-output) permite que cada fila de eventos se vincule a un punto de intercepción específico dentro del ciclo de vida de la solicitud. La detección de PII en request-input intercepta los datos de los usuarios antes de que lleguen al modelo. El escaneo de credenciales en tool-output detecta las claves de acceso antes de que alcancen los sistemas secundarios.
→ Visión general de guardrails: cuatro ganchos y descomposición de la superficie de amenazas
→ Detección de PII/PHI: modos de redacción y ubicación de ganchos
→ Detección de credenciales: modo de validación frente a modo de mutación
Este es el panel más complejo de construir y el más importante de mantener. Los cinco paneles anteriores describen el uso de la IA. Este último determina si ese uso ha producido algún resultado tangible.
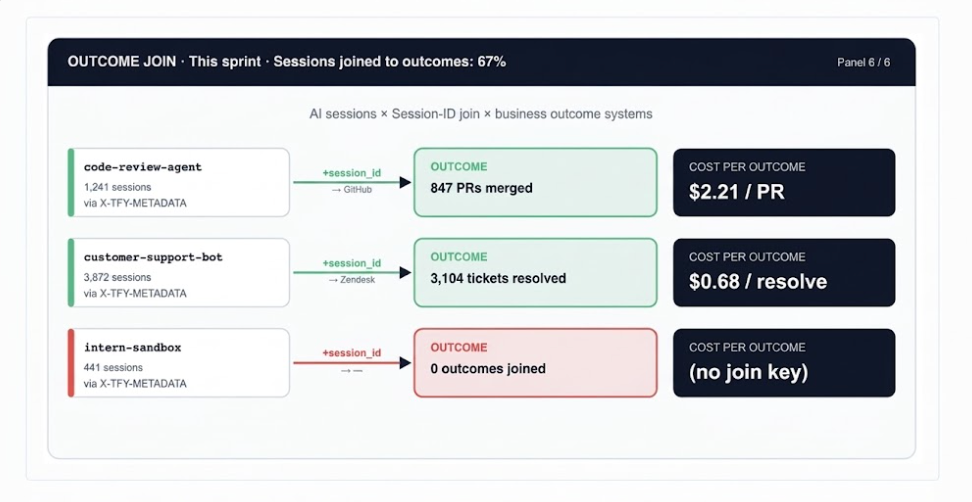
La clave de vinculación es el campo session_id dentro de X-TFY-METADATA, que TrueFoundry propaga a lo largo de cada solicitud en una sesión de agente de múltiples turnos. Cuando el mismo ID de sesión aparece en la carga útil del webhook de GitHub o en los metadatos de Zendesk, se puede cerrar el ciclo: esta sesión tuvo un coste de $2,21 y generó una PR de revisión de código que ha sido fusionada.
→ Analítica: vistas de costes y uso a nivel de sesión
Los seis paneles se nutren de tres capas de métricas bien diferenciadas. El error más común al diseñar un dashboard es mezclar estas capas: una vista ejecutiva no debe mostrar recuentos de reintentos, del mismo modo que una vista de guardia no debe incluir tasas de superación de evaluaciones.
Una vez implementadas las tres capas, existe la tentación de combinarlas en una puntuación por ingeniero y publicar una clasificación. Hay que evitarlo. La siguiente función tiene una finalidad estrictamente diagnóstica: es una herramienta para identificar patrones en los flujos de trabajo que requieran inversión, rediseño o nuevos guardrails. Se debe agregar por workflow_tag, no por user_id.
Los dashboards no dirigen las organizaciones; las rutinas sí. Esta es la cadencia operativa mínima viable para el uso gobernado de la IA:
Cada alerta debe vincularse a un paso concreto de un manual de procedimientos (runbook), y no limitarse a generar un aviso en el PagerDuty. El código YAML a continuación define el conjunto de reglas de alerta mínimo viable para la sala de control, que se ejecuta sobre la exportación OTEL de TrueFoundry:
Verificar el campo workflow_tag en el encabezado X-TFY-METADATA de la solicitud para identificar al equipo propietario
Verificar el campo workflow_tag en el encabezado X-TFY-METADATA de la solicitud para identificar al equipo propietario
→ tfy apply: despliegue de alertas y políticas al estilo GitOps
→ Exportación de datos OpenTelemetry: endpoints de métricas OTEL
Antes de dar por operativa la sala de control de IA, es necesario verificar estas ocho condiciones. Cada una de ellas se corresponde con una capacidad específica de TrueFoundry:
La trilogía sobre el tokenmaxxing ha desarrollado un argumento estructurado en tres capas. Cada una es indispensable; ninguna resulta suficiente por sí sola.
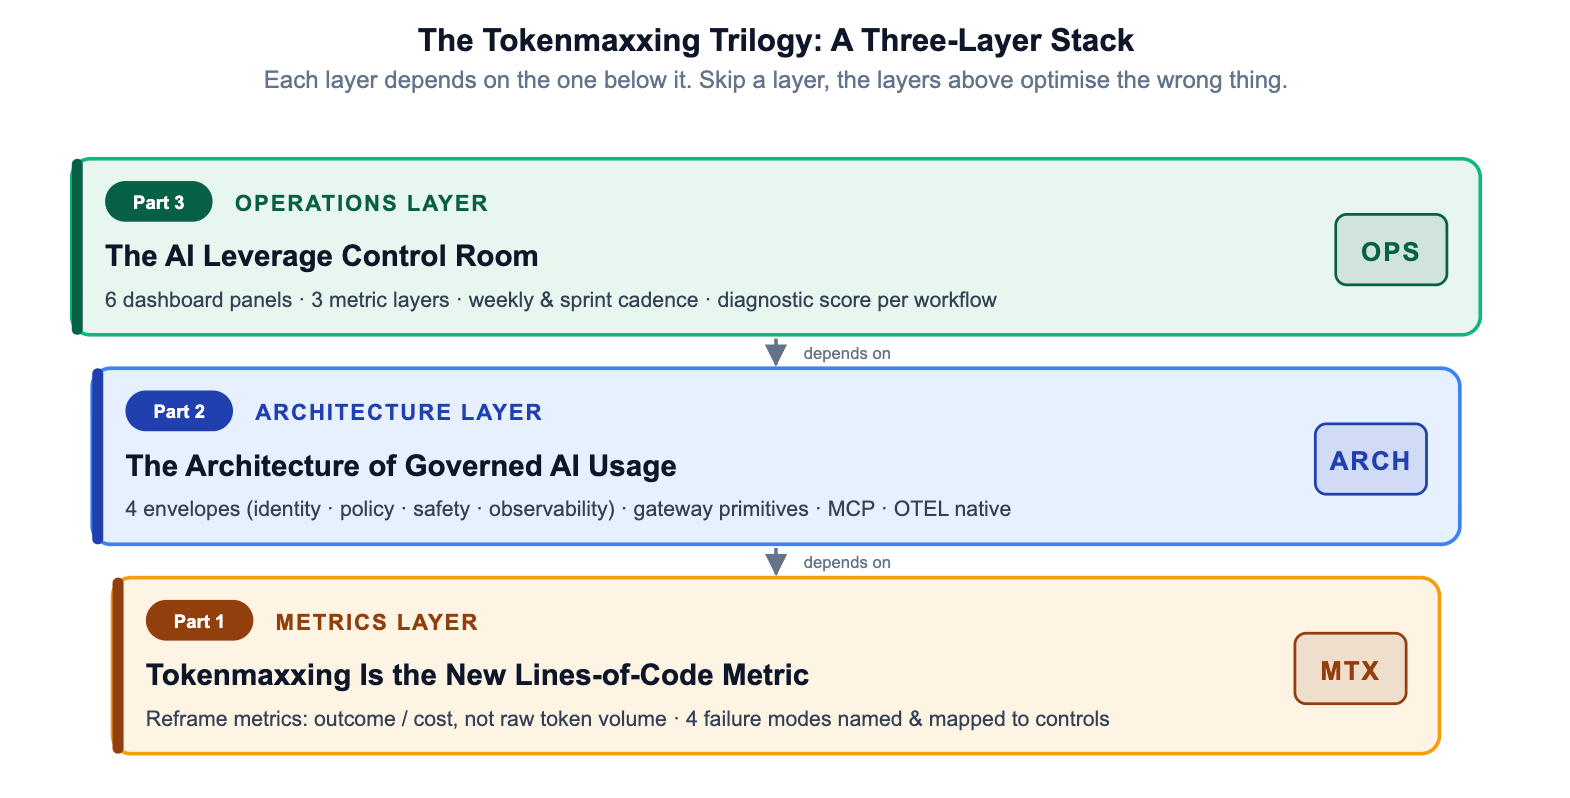
Las organizaciones que se limitan a la Capa 1 disponen de un discurso teórico, pero carecen de mecanismos de control. Aquellas que se quedan en la Capa 2 cuentan con capacidad de control, pero carecen de retroalimentación. La sala de control cierra este ciclo, convirtiendo el uso gobernado de la IA en una disciplina operativa sostenible que genera valor acumulativo a lo largo del tiempo.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada



















