



November 6, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.


Actualizado: November 3, 2026
Published: May 11, 2026
¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
Nos complace anunciar la integración de Resemble AI con TrueFoundry AI Gateway, lo que aporta la clonación de voz, la conversión de texto a voz (TTS) sincrónica y el TTS en streaming dentro de la misma ruta de pasarela que los equipos ya utilizan para LLMs, embeddings y tráfico de agentes.
Los equipos que enrutan su tráfico de AI a través de TrueFoundry's AI Gateway ahora pueden conectar Resemble AI como un proveedor de texto a voz de primer nivel mediante el pass-through nativo del SDK de la pasarela. Las solicitudes enviadas a los endpoints /synthesize y /stream de Resemble fluyen por la ruta de la pasarela con autenticación centralizada, control de acceso por equipo, seguimiento de costes unificado y trazabilidad completa de las solicitudes. No se requieren cambios en el código del cliente más allá de apuntar la URL base de Resemble a la pasarela y autenticarse con un token de TrueFoundry.
Esta publicación aborda la arquitectura de la integración. Explica cómo TrueFoundry AI Gateway expone los proveedores de TTS, cómo se preserva la superficie nativa de la API de Resemble a través de la capa de pass-through y cómo funciona la conmutación por error (failover) entre múltiples proveedores de TTS mediante Virtual Models.
TrueFoundry proporciona la capa de control para los sistemas de AI en producción. A través de AI Gateway, los equipos centralizan el enrutamiento de modelos, la gestión de claves, el control de acceso, la observabilidad y el seguimiento de costes en todos los LLMs, embeddings y proveedores de imagen y audio. Cada solicitud fluye a través de una única capa de proxy donde se verifica la identidad, se aplican límites de tasa (rate limits) y se capturan trazas.
El tráfico de TTS en producción tiende a parecerse al tráfico de LLM en tres aspectos. En primer lugar, se suelen utilizar múltiples proveedores porque ningún fabricante de TTS gana en todas las dimensiones. En segundo lugar, la latencia es crítica porque los agentes de voz envían audio en streaming a los usuarios en tiempo real. En tercer lugar, los costes se acumulan rápidamente por carácter o por segundo, beneficiándose de los mismos controles de presupuesto y repercusión de costes (chargeback) que los equipos ya aplican a las personalizaciones de chat (chat completions). Los argumentos para colocar una pasarela delante de los proveedores de LLM se aplican de forma directa.
Resemble AI es una plataforma completa de seguridad para AI generativa que permite crear, verificar y detectar medios sintéticos en audio, vídeo e imagen. Resemble también desarrolla sus propios modelos fundacionales tanto para la generación como para la detección, lo que le otorga una ventaja clave en la identificación de contenido generado por AI. Para la generación de voz, su modelo central de síntesis es Chatterbox y Chatterbox Multilingual, contando además con la variante Chatterbox Turbo para menor latencia y soporte de etiquetas paralingüísticas. Todos los modelos de TTS desarrollados por Resemble incluyen marcas de agua (watermarking) de forma predeterminada. La plataforma también admite clonación de voz, diseño de voz, edición de audio, SSML, síntesis HD y salida en streaming. Juntas, ambas plataformas ofrecen a los equipos un lugar único para gobernar y rastrear la generación de voz junto con el resto de su pila de AI. TrueFoundry gestiona el despliegue, el enrutamiento y el control operativo. Resemble se encarga de la síntesis propiamente dicha. La integración utiliza el pass-through nativo del SDK de TrueFoundry, que preserva toda la superficie de la API de Resemble sin forzarla a adoptar un formato compatible con OpenAI.
El endpoint de texto a voz sincrónico de Resemble recibe un conjunto reducido de campos y devuelve el audio junto con metadatos de sincronización temporal. El endpoint synthesize acepta un voice_uuid que selecciona la voz entrenada o predefinida a utilizar y un campo data que contiene texto o SSML de hasta 3000 caracteres. Los campos opcionales permiten controlar la selección del modelo mediante model (por ejemplo, chatterbox-turbo), la precisión del audio mediante precision (una entre MULAW, PCM_16, PCM_24 o PCM_32), el formato de salida mediante output_format (wav o mp3), la frecuencia de muestreo (sample rate), el modo HD a través de use_hd y la gestión de pronunciaciones personalizadas mediante apply_custom_pronunciations.
La respuesta (payload) devuelve success y un campo audio_content codificado en base64 que contiene los bytes del audio sintetizado. Los metadatos de temporización se entregan en audio_timestamps con caracteres y tiempos de grafemas, así como caracteres y tiempos de fonemas para casos de uso de alineación posterior, como la sincronización labial (lip sync) o el subtitulado. La respuesta también informa de duration (la duración del audio en segundos), synth_duration (el tiempo bruto de síntesis), output_format, sample_rate y cualquier incidencia advertida por el sintetizador durante la generación.
Un segundo endpoint en /stream admite la síntesis en streaming sobre HTTP para casos de uso de agentes de voz donde el tiempo hasta el primer fragmento de audio (time to first audio chunk) es crítico. la estructura de la solicitud es idéntica, pero la respuesta es un flujo de tramas de audio en lugar de una única carga base64. La autenticación para ambos endpoints se realiza mediante un bearer token emitido desde la consola de la cuenta de Resemble.
TrueFoundry AI Gateway se ejecuta sobre el framework Hono; un solo pod de la pasarela gestiona más de 250 solicitudes por segundo con 1 vCPU y 1 GB de RAM, añadiendo aproximadamente unos 3 ms de latencia. Los pods de la pasarela son sin estado (stateless), están limitados por CPU y escalan horizontalmente a decenas de miles de RPS mediante pods adicionales. El plano de control y el plano de la pasarela están separados. La configuración del proveedor —incluidas las credenciales, las reglas de enrutamiento y los límites de tasa— reside en el plano de control y se sincroniza con los pods de la pasarela a través de NATS. La ruta real de la solicitud permanece en memoria sin llamadas externas más allá de la propia llamada al proveedor.
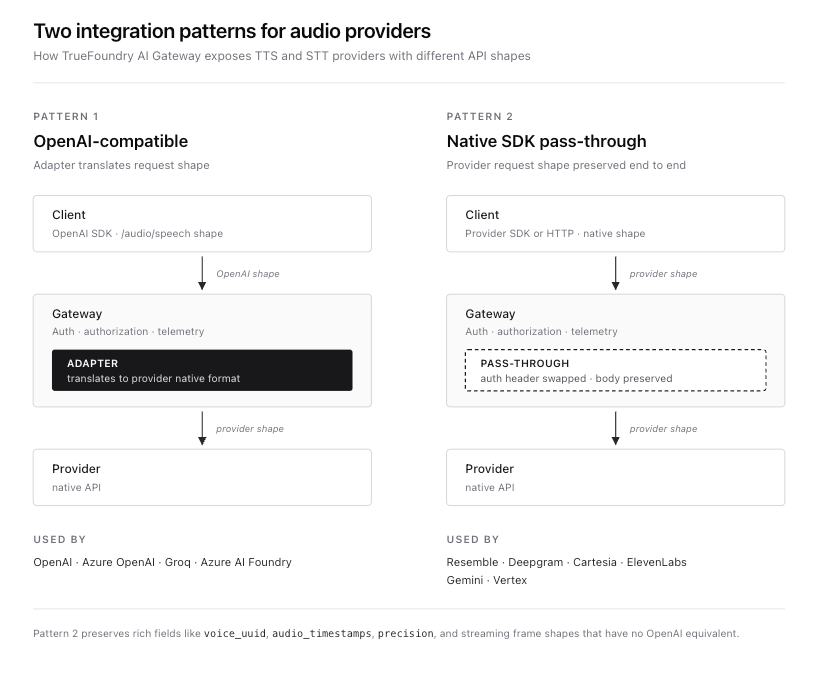
Para TTS, la pasarela expone dos patrones de integración.
El primero es el patrón de API compatible con OpenAI en la URL base de la pasarela. Los proveedores que utilizan el formato /audio/speech de OpenAI (OpenAI, Azure OpenAI, Azure AI Foundry y Groq) se conectan aquí. Los clientes utilizan el SDK estándar de OpenAI y la pasarela traduce la solicitud al formato nativo del proveedor a través de una capa de adaptación.
El segundo es el patrón de pass-through nativo del SDK en {GATEWAY_BASE_URL}/tts/{providerAccountName}. Los proveedores con APIs nativas avanzadas que no se ajustan de manera limpia al formato de OpenAI se integran aquí. Se preserva la estructura completa de solicitud y respuesta del proveedor. La pasarela gestiona la autenticación, el control de acceso, el rastreo y el enrutamiento, pero no modifica el contenido de la carga útil (payload). Este es el patrón que utiliza Resemble, ya que el cuerpo de la solicitud de Resemble con voice_uuid, audio_timestamps, niveles de precision y el selector de modelo chatterbox-turbo no tiene un equivalente equivalente en el contrato de TTS de OpenAI.
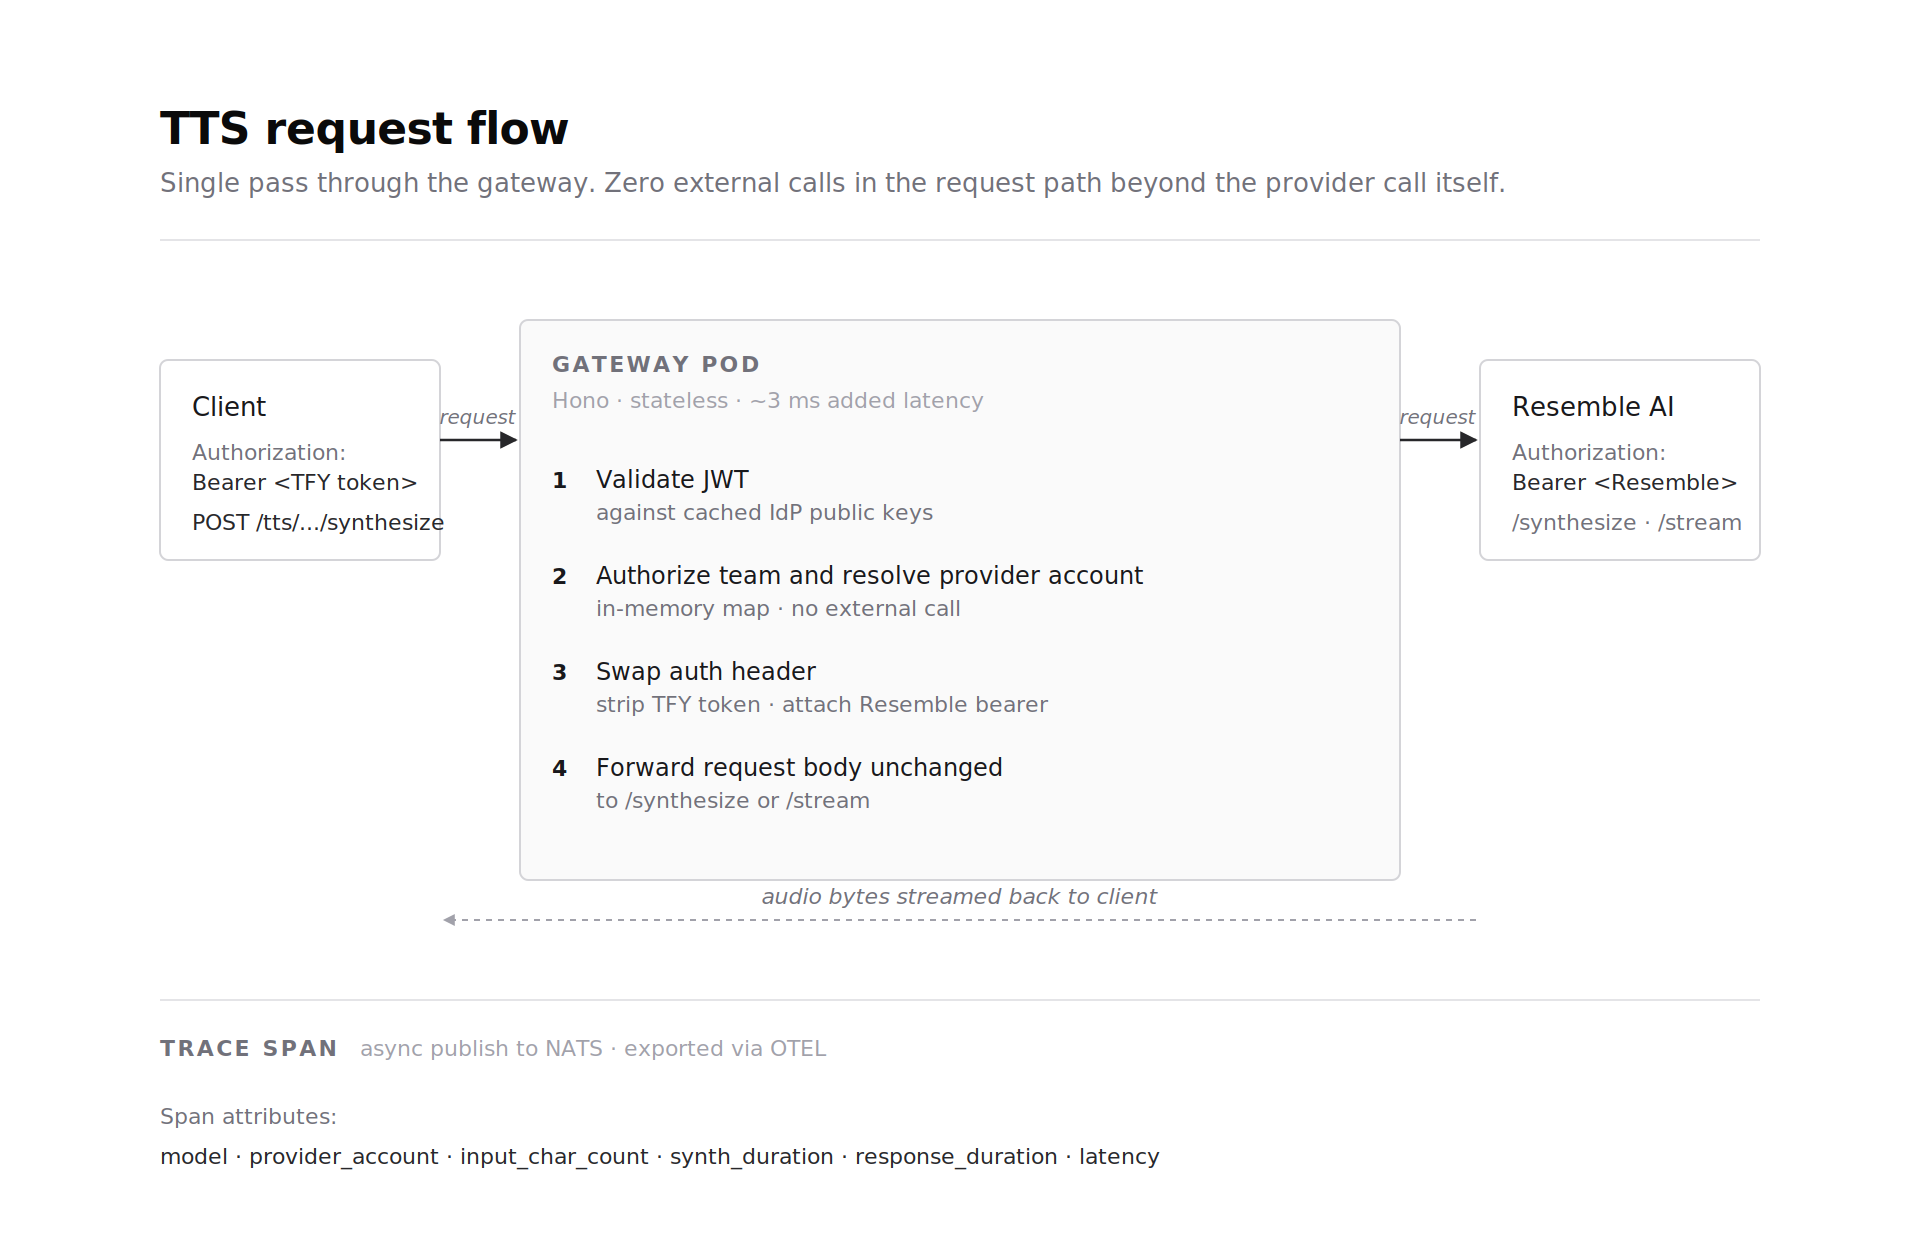
Cuando una solicitud llega a un pod de la pasarela, la secuencia es la siguiente: el token de TrueFoundry en la cabecera Authorization se valida contra las claves públicas del IdP almacenadas en caché. La identidad del equipo se resuelve mediante un mapa en memoria y se comprueba la autorización hacia la cuenta del proveedor Resemble. El cuerpo de la solicitud se reenvía al endpoint synthesize o stream de Resemble con el bearer token de Resemble adjuntado en el lado del servidor. La respuesta se envía en streaming de vuelta al cliente. La interacción completa se captura en un span de traza con el nombre del modelo, la cuenta del proveedor, el recuento de caracteres de entrada, la duración de la respuesta, la duración de la síntesis y la latencia. No hay saltos de red adicionales más allá de la llamada real al proveedor.
Resemble se registra en el plano de control de TrueFoundry como una cuenta de proveedor, almacenando el bearer token de Resemble como un secreto. Una vez añadida la cuenta, la pasarela expone dos rutas TTS para ella. La ruta nativa del SDK en {GATEWAY_BASE_URL}/tts/{providerAccountName}/synthesize actúa como proxy del endpoint sincrónico. La ruta de streaming en {GATEWAY_BASE_URL}/tts/{providerAccountName}/stream actúa como proxy del endpoint de streaming. Ambas rutas preservan exactamente el formato de solicitud y respuesta de Resemble.
Una llamada de cliente mínima tiene el aspecto del siguiente fragmento de código. Tenga en cuenta que el único cambio respecto a una llamada directa a Resemble es la URL base y la cabecera de autenticación.
El código de aplicación existente que apunta directamente a Resemble se migra simplemente cambiando la URL base y el bearer token. Los Voice UUIDs, las cargas útiles de SSML, los ajustes de precisión y el modo HD se mantienen sin modificaciones. Las bibliotecas de cliente oficiales de Resemble se pueden configurar de la misma manera sobrescribiendo su URL base.
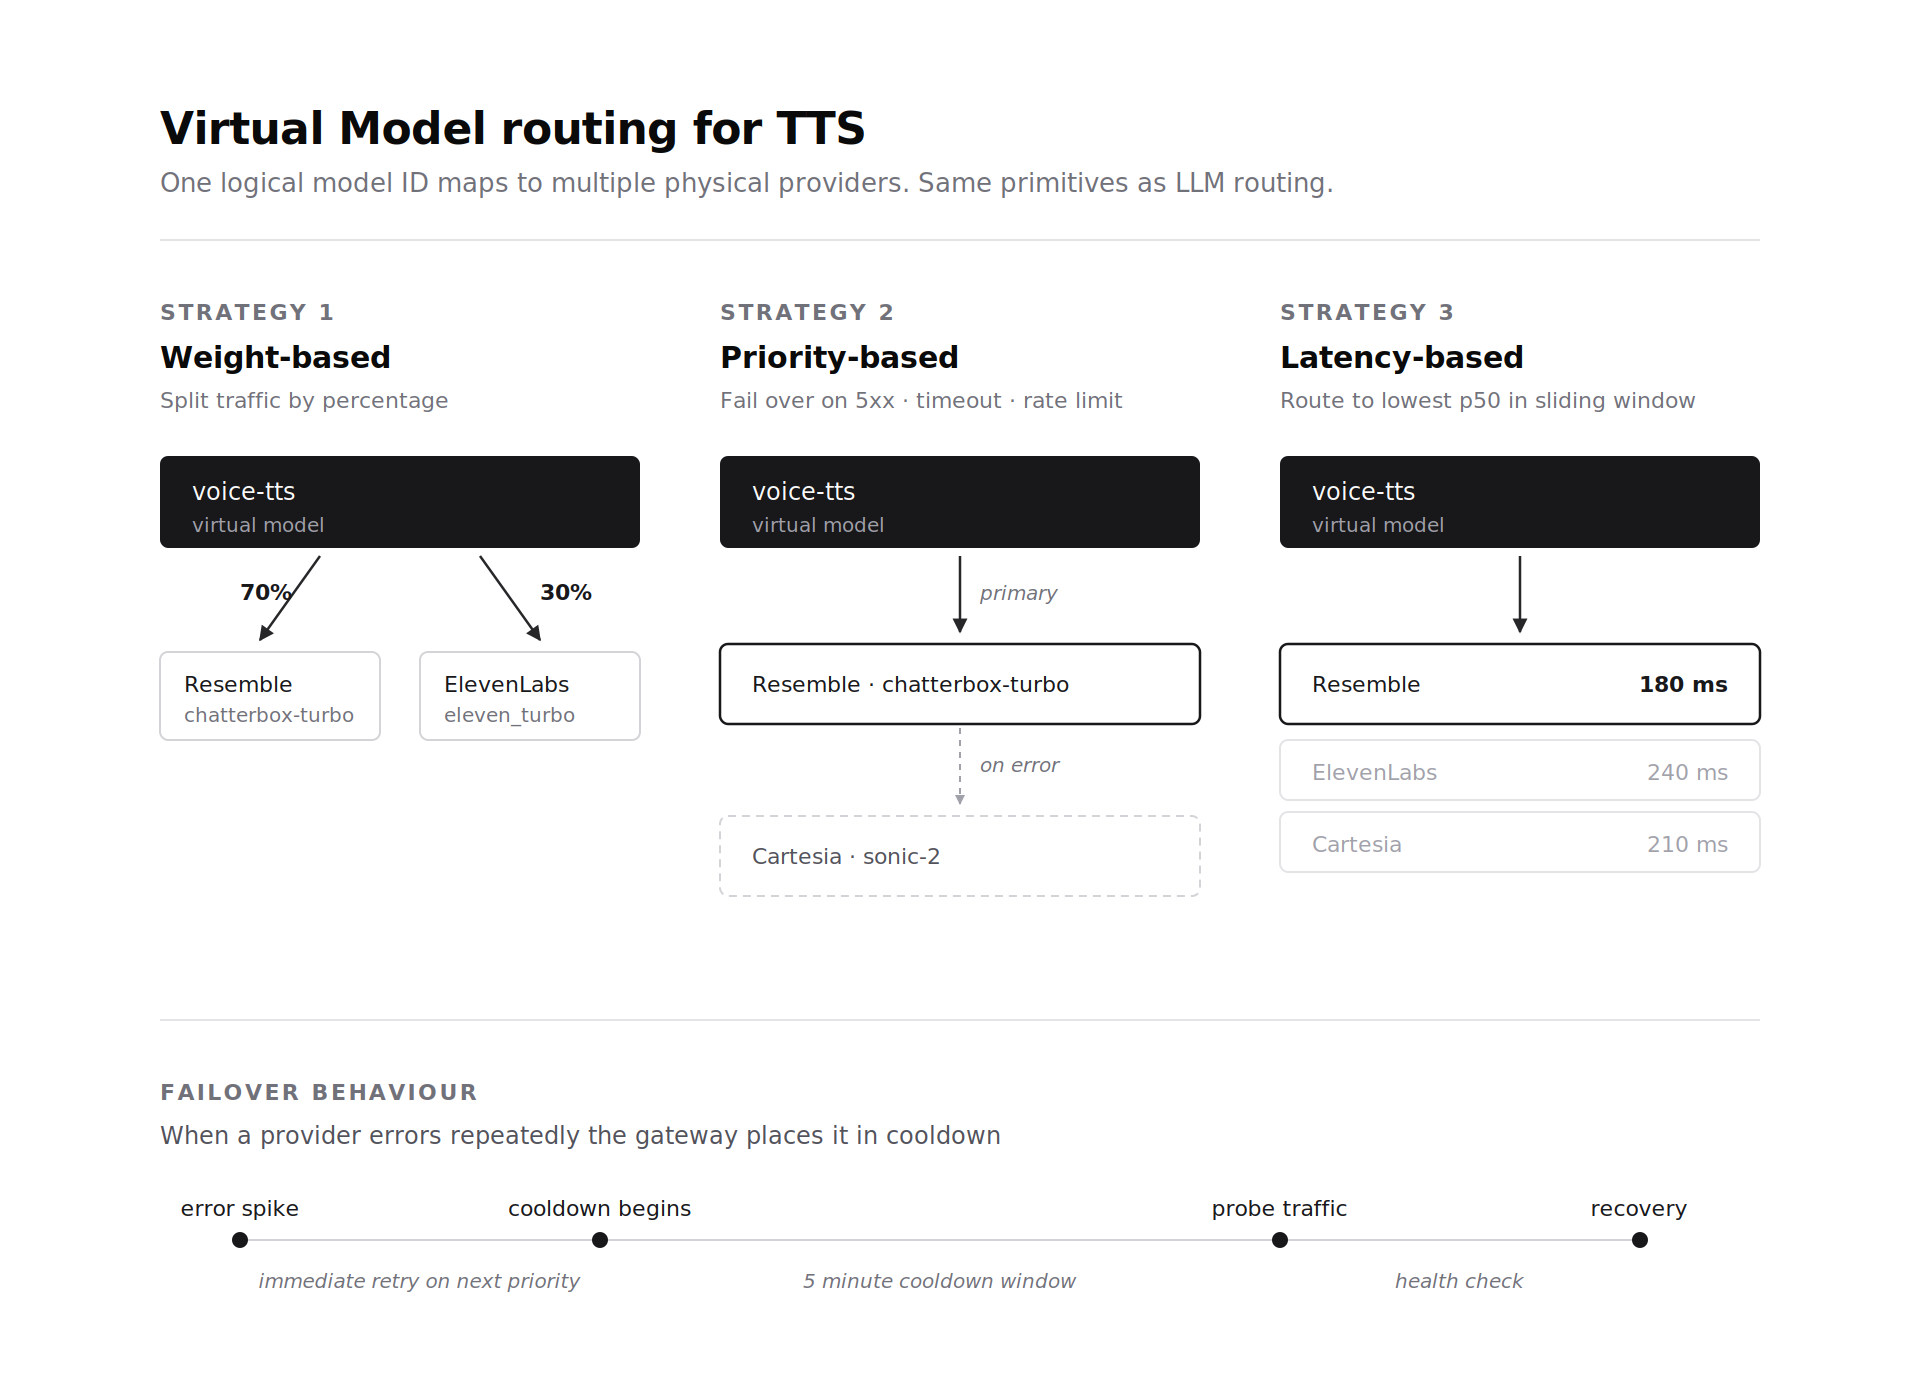
Las arquitecturas de agentes de voz a menudo ejecutan más de un proveedor de TTS en producción por razones de coste y latencia. La abstracción de Virtual Model de la pasarela se extiende a los proveedores de TTS de la misma forma que a los proveedores de LLM. Un identificador de modelo virtual se asigna a uno o más despliegues físicos de TTS con reglas de enrutamiento. El enrutamiento basado en pesos (Weight based) distribuye el tráfico por porcentajes entre los proveedores. El enrutamiento basado en prioridades (Priority based) prueba el primer proveedor y conmuta por error en caso de un error 5xx, un tiempo de espera agotado (timeout) o un límite de tasa superado. El enrutamiento basado en latencia (Latency based) envía el tráfico al proveedor que presente la latencia p50 más baja en la ventana deslizante.
La conmutación por error para TTS funciona con las mismas primitivas que la del LLM. Los errores no reintentables desencadenan un reintento inmediato en el siguiente proveedor por orden de prioridad. Los picos de error colocan a un proveedor en un periodo de enfriamiento (cooldown) de 5 minutos mientras el tráfico de prueba verifica su recuperación. Un equipo que ejecute Resemble Chatterbox Turbo como ruta primaria de baja latencia puede conmutar por error a Cartesia o ElevenLabs sin modificar el código del cliente. El Virtual Model gestiona la selección.
El seguimiento de costes captura el uso de TTS con la misma granularidad que el de los LLM. La pasarela registra el número de caracteres de entrada, la duración de la síntesis, el modelo, el equipo y el usuario para cada solicitud. El servicio agregador calcula el gasto por equipo y por usuario, alimentando los mismos paneles y primitivas de control presupuestario que ya cubren las personalizaciones de chat y los embeddings. Los límites de tasa se aplican mediante el algoritmo Sliding Window Token Bucket con ventanas por minuto delimitadas por usuario, equipo o modelo. Para TTS, la unidad son caracteres o solicitudes en lugar de tokens, pero el algoritmo se mantiene inalterado.
Cada solicitud de TTS emite un span de traza. Los atributos del span incluyen la cuenta del proveedor, el identificador del modelo (por ejemplo, resemble-prod/chatterbox-turbo), el recuento de caracteres de entrada, la duración de la respuesta en segundos, el tiempo bruto de síntesis, el formato de salida, la frecuencia de muestreo y la latencia en el lado de la pasarela. Las trazas se emiten de forma asíncrona a través de NATS y se exportan mediante OTEL a cualquier plataforma de observabilidad que el equipo haya configurado (Arize, Langfuse, LangSmith o cualquiera de los destinos compatibles). El ajuste Exclude Request Data se aplica de la misma forma que en las personalizaciones de chat para mantener el texto de entrada fuera de las trazas exportadas cuando la privacidad de los datos lo requiere.
Esto significa que las llamadas de TTS aparecen en la misma línea de tiempo de traza que la llamada upstream de LLM que generó el texto y la acción downstream del agente que consumió el audio. Para la depuración de agentes de voz, esta consolidación es fundamental. Un turno con fallos se puede rastrear desde la respuesta del LLM que seleccionó la contestación, pasando por la síntesis de TTS que la procesó, hasta la acción que el agente realizó a continuación.
De extremo a extremo, el flujo de la solicitud es el siguiente: un cliente envía una solicitud de TTS a la pasarela en {GATEWAY_BASE_URL}/tts/{providerAccountName}/synthesize o su equivalente en streaming con un bearer token de TrueFoundry. La pasarela autentica al emisor contra las claves del IdP en caché, resuelve la cuenta del proveedor y verifica la autorización del equipo y del usuario en memoria. Si se está utilizando un Virtual Model, la lógica de enrutamiento selecciona un proveedor físico basándose en el peso, la prioridad o la latencia. El cuerpo de la solicitud se reenvía a Resemble con el bearer token de Resemble del lado del servidor adjunto. La respuesta se devuelve en streaming al cliente manteniendo la estructura completa del payload de Resemble, incluidos el contenido de audio, los stamps de tiempo y los metadatos de duración. Cada paso se captura en un span de traza emitido de forma asíncrona a NATS y exportado a través de OTEL.
Nada más tiene que cambiar en la aplicación. No es necesario reescribir el SDK, no hay gestión de autenticación por proveedor en el cliente y no se requiere una canalización de observabilidad independiente para el tráfico de voz. La pasarela ya se encuentra en la ruta de la solicitud para el resto de la pila de AI y Resemble se conecta a esa ruta mediante pass-through nativo. El código de cliente existente de Resemble sigue funcionando simplemente modificando la URL base.
El principio arquitectónico que aporta esta limpieza es el patrón de integración dual. Los proveedores que cumplen el contrato de OpenAI se conectan a través del adaptador compatible con OpenAI y reutilizan los mismos SDKs de cliente. Los proveedores con APIs nativas avanzadas se integran mediante la ruta de pass-through, lo que preserva toda la superficie del proveedor sin forzar una traducción. Para TTS esto es crucial porque las diferencias entre proveedores no son cosméticas. Los Voice UUIDs, los formatos de timestamp de audio, los niveles de precisión y las estructuras de tramas en streaming varían de un modo que un adaptador al estilo OpenAI tendría que simplificar en exceso. El patrón de pass-through mantiene intactos la selección de modelos Chatterbox de Resemble, los timestamps de audio y los controles de precisión, mientras la pasarela asume las responsabilidades transversales de autenticación, enrutamiento, observabilidad y seguimiento de costes.
Obtenga más información sobre TrueFoundry AI Gateway y la plataforma de Resemble AI. Añada Resemble como una cuenta de proveedor en el plano de control de la pasarela y llame al endpoint synthesize o stream en la ruta /tts/{providerAccountName} desde el código de su aplicación existente.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada



















