



November 6, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.


¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
En la Parte 1 se hizo el diagnóstico: tokenmaxxing no es un problema de uso de la IA; es un problema del plano de control. Si los tokens brutos se convierten en un objetivo, la gente se optimizará para los tokens brutos. Si el apalancamiento gobernado de la IA se convierte en el modelo operativo, la plataforma puede fomentar la adopción al tiempo que delimita los costes, el riesgo y el ruido operativo. Esta parte concreta esa arquitectura.
La tesis es sencilla. Cada solicitud de IA que sale de una aplicación empresarial es, la trate como tal o no, un evento de tiempo de ejecución con consecuencias en los costes, la seguridad y la auditoría. El lugar de mayor apalancamiento para vincular controles a esos eventos es la pasarela: la capa que se sitúa entre cada aplicación y cada backend de modelos y herramientas. Un panel de control creado aguas abajo puede describir lo que ha sucedido. Solo la pasarela puede decidir qué sucede a continuación.
Un panel de control informa de un problema. Una pasarela evita el siguiente. La arquitectura que se muestra a continuación es lo que hace operativa esa distinción.
Una solicitud de IA gobernada necesita cuatro envolventes que la recubran antes de salir de la aplicación. Piense en esto como el modelo OSI para la IA empresarial: cada capa tiene una responsabilidad específica y un modo de fallo específico cuando está ausente.
Estas envolventes tienen que estar en la ruta de la solicitud, no en un informe que alguien lea los viernes. Un panel de control creado a posteriori puede describir un problema; solo una envolvente en la solicitud en directo puede dar forma a la siguiente llamada. Este es el principio arquitectónico que separa una plataforma de IA gobernada de un complemento de analítica.
El primer estándar de implementación es un contrato de metadatos estricto. Utilice claves con valores de cadena de texto, envíelas en cada solicitud y exíjalas en sus envolventes de SDK, bibliotecas de clientes internas, marcos de bots y plantillas de agentes. El coste de un campo que falta aparece más tarde como una línea de factura faltante, un pico inatribuible o un evento de barrera de protección que nadie puede redirigir a un propietario.
Etiquetar es el trabajo de ingeniería más barato de toda esta arquitectura y lo primero que se rompe cuando los equipos se lo saltan.
En la pasarela de TrueFoundry, esto viaja como el encabezado X-TFY-METADATA. El mismo espacio de nombres de claves alimenta todo lo que está aguas abajo: los presupuestos se aplican por proyecto, los límites de tasa se aplican por flujo de trabajo, los paneles de control se agrupan por equipo, las trazas se unen a los tickets y finanzas asigna el gasto por centro de costes. No hay una segunda fuente de verdad.

El objetivo arquitectónico no es añadir mandos de control. Es mantener una asignación estrecha entre cada modo de fallo realista y el control específico que lo previene. Aquí está la taxonomía completa:
Si el código de la aplicación nombra un modelo de proveedor específico, ha perdido la capacidad de migrar, probar, hacer pruebas A/B o realizar una conmutación por error sin cambios de código. El patrón correcto es exponer capacidades lógicas —nombres como prod/engineering-assistant o prod/frontier-reasoning— y dejar que la pasarela las resuelva a destinos físicos según los metadatos, la prioridad, el peso o la latencia medida.
En TrueFoundry, para esto sirven los modelos virtuales y la configuración de enrutamiento. Las mismas reglas cubren los despliegues canarios, la preferencia regional, las implementaciones locales con alternativa en la nube y las anulaciones de prompts específicas del proveedor. Esta es la capacidad más infravalorada en la pila de gobernanza: hace que el cumplimiento, la optimización de costes y la migración de modelos sean invisibles para los desarrolladores de aplicaciones.
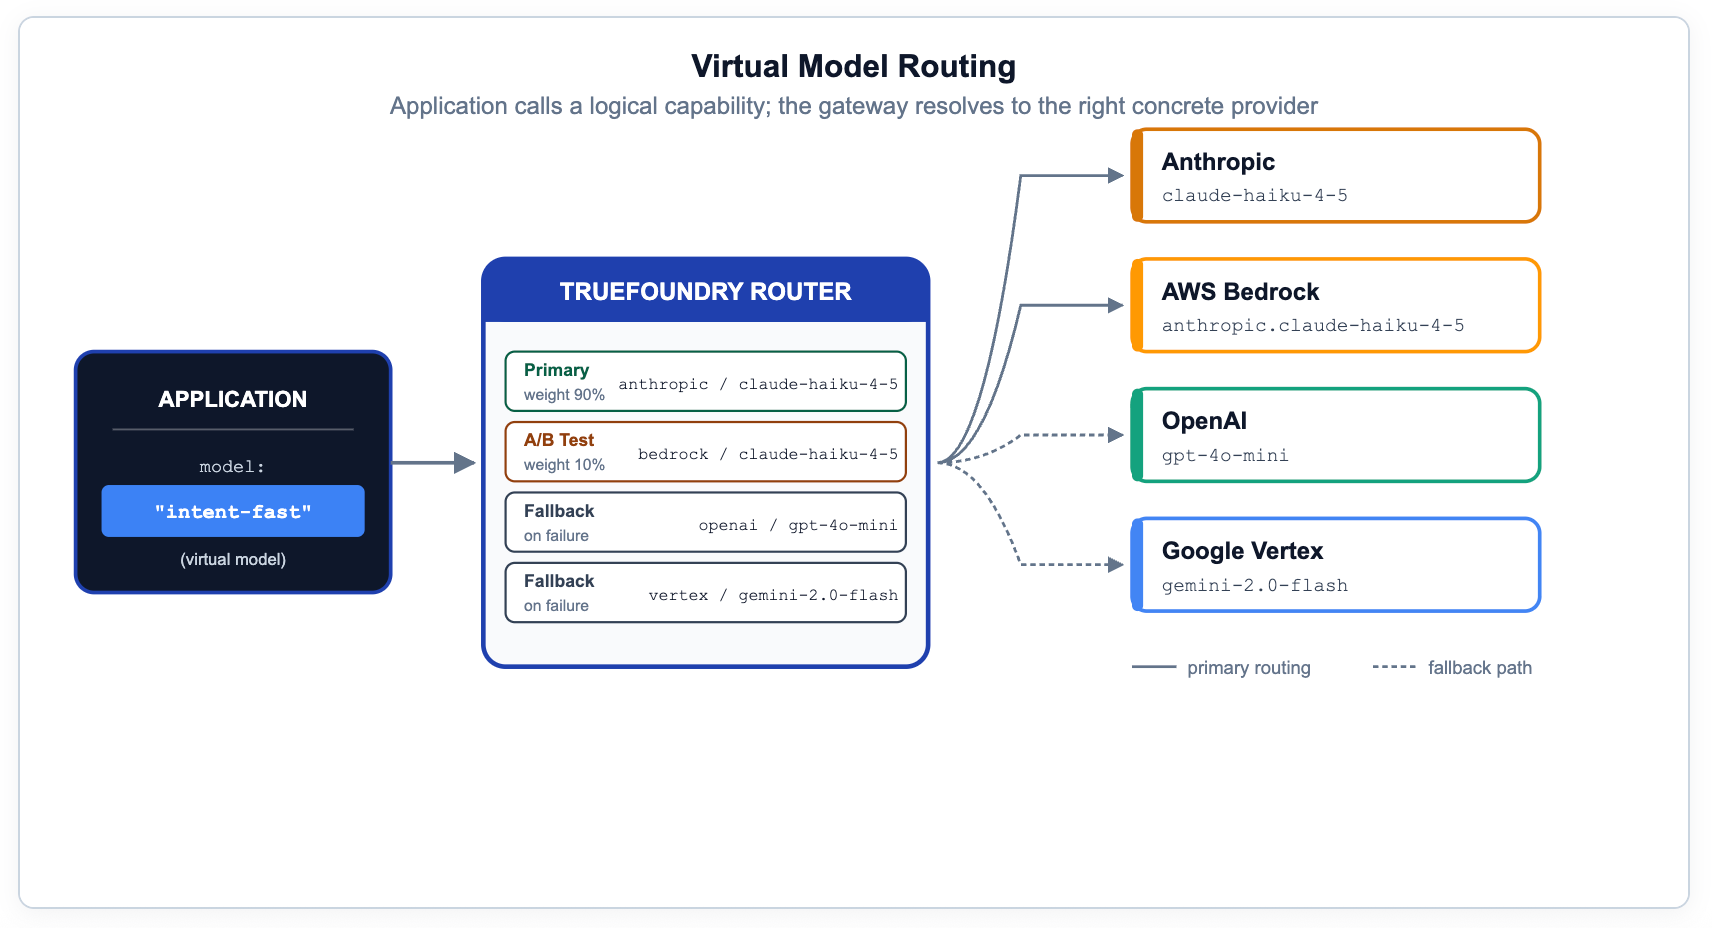
Documentación de enrutamiento: truefoundry.com/docs/ai-gateway/load-balancing-overview
Una vez que las aplicaciones de IA llegan a producción, manejan datos reales de usuarios y, en entornos agénticos, realizan acciones reales a través de herramientas. El perímetro de seguridad no es una sola cosa. Son cuatro ganchos, situados en los cuatro momentos en que la pasarela puede intervenir antes de que una solicitud se convierta en un daño.
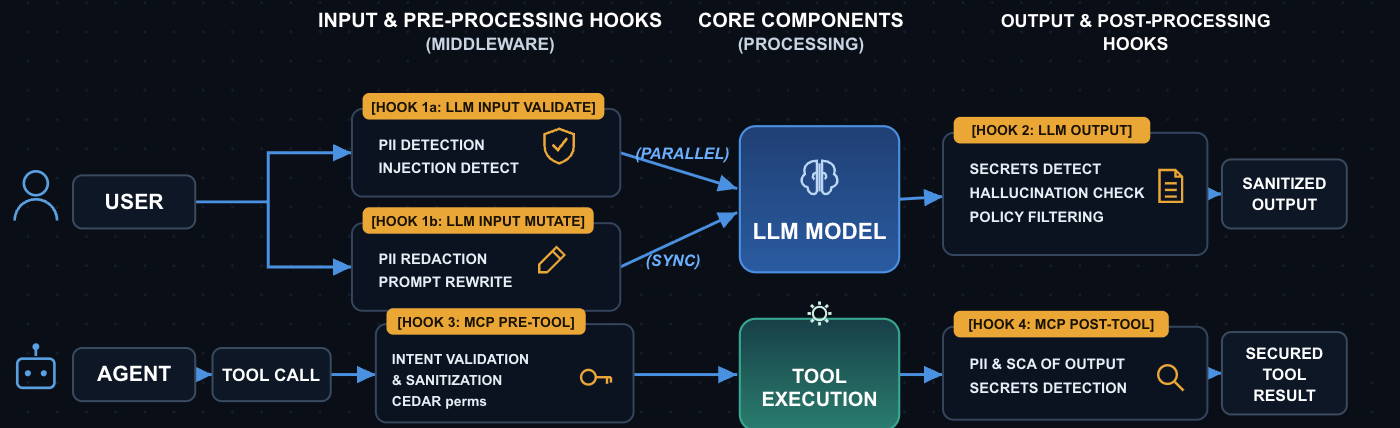
Despliegue las barreras de protección en tres pasos: Auditar → Aplicar pero ignorar en caso de error → Estricto. La configuración intermedia es la que le salvará el día en que un proveedor de seguridad de terceros sufra una interrupción.
Visión general de barreras de protección: truefoundry.com/docs/ai-gateway/guardrails-overview
Detección de PII/PHI: truefoundry.com/docs/ai-gateway/tfy-pii
Detección de secretos: truefoundry.com/docs/ai-gateway/secrets-detection
Dos preguntas dominan las operaciones una vez que el uso gobernado de la IA está en producción: «¿por qué esta solicitud se ha comportado de esta manera?» y «¿el coste que pagamos coincide con el trabajo que obtenemos?». Ninguna de las dos se puede responder desde un gráfico de recuento de tokens.
La superficie mínima necesaria para responderlas —y la superficie que la pasarela de TrueFoundry proporciona nada más instalarla—:
Documentación de analítica: truefoundry.com/docs/ai-gateway/analytics
Exportación de OpenTelemetry: truefoundry.com/docs/ai-gateway/export-opentelemetry-data
Las cuatro envolventes anteriores se diseñaron asumiendo solicitudes tipo chat: una aplicación envía un prompt y el modelo devuelve texto. Las cargas de trabajo de IA modernas han ido más allá de esa suposición. Los agentes llaman a herramientas. Las herramientas llaman a otras herramientas. Una sola solicitud de usuario puede generar una trayectoria de agente de 50 pasos que toca media docena de servidores MCP. La superficie de coste, la superficie de seguridad y la superficie de auditoría se han trasladado del prompt a la llamada a la herramienta.
Esta es la razón por la que la pasarela de TrueFoundry admite nativamente tanto la API de LLM como el protocolo Model Context Protocol (MCP). La misma envolvente de identidad, los mismos interruptores automáticos y los mismos ganchos de observabilidad se aplican a una llamada a una herramienta que a una finalización de chat. La identidad OAuth 2.0 se inyecta en las llamadas a herramientas MCP para que un agente actúe como un usuario específico, no como una cuenta de servicio, cuando consulta una base de datos o crea un ticket de Jira. Los servidores MCP virtuales le permiten componer un «finance-agent-server» lógico a partir de herramientas repartidas en tres servidores MCP reales, con control de acceso y límites de tasa aplicados a la composición.
El protocolo Model Context Protocol es importante para el coste, no solo para la arquitectura. TrueFoundry informa de un ahorro de hasta el 99 % en tokens de inferencia cuando los agentes utilizan la recuperación activa de herramientas en lugar de atiborrar los prompts con contexto, además de una sobrecarga en las llamadas a herramientas medida en aproximadamente 10 ms.
→ Descripción general de la pasarela MCP
Resulta tentador trasladar estos controles al código de la aplicación: una envolvente aquí, un decorador de Python allá, una clase auxiliar en el marco del agente. Eso funciona hasta que tiene tres equipos de aplicaciones, dos proveedores de modelos, una adquisición, una auditoría PCI y un incidente de límite de tasa un martes.
En ese momento descubre que ha construido cuatro planos de control ligeramente diferentes que no coinciden, y que ninguno de ellos puede detener una solicitud de un equipo que no importó la envolvente. La pasarela existe por la misma razón por la que existían las pasarelas de API hace una década: es el único lugar donde cada solicitud, de cada aplicación, en cada entorno, se puede observar y moldear de manera uniforme.
La objeción a una pasarela siempre es «un salto más en la ruta de la solicitud». TrueFoundry AI Gateway añade aproximadamente 5 ms de sobrecarga p50 y gestiona más de 350 solicitudes por segundo en una sola vCPU. La objeción no resiste al contrastarla con las cifras.
La pasarela es también el único lugar que puede comunicarse con toda la superficie de la infraestructura de IA moderna: más de 1000 LLM en más de 19 proveedores, además de los servidores MCP a los que llaman sus agentes, además de los modelos autoalojados detrás de su VPC. TrueFoundry fue nombrada en el informe de Gartner «10 Best Practices for Optimizing Generative & Agentic AI Costs 2026», porque la única forma en que las empresas realmente optimizan en esta superficie es ejecutando cada solicitud a través de una capa gobernada.
→ Arquitectura de la plataforma
→ Arquitectura del plano de la pasarela
El tokenmaxxing es un síntoma de una adopción de IA no gestionada. La arquitectura anterior es el remedio. La identidad define quién pregunta. La política define lo que está permitido. La seguridad define lo que es aceptable. La observabilidad define lo que realmente sucedió. Juntas convierten la actividad de tokens brutos en un ciclo de vida de solicitud gobernado: responsable, útil, seguro y ajustable.
El objetivo no es reducir el uso de la IA. El objetivo es hacer que cada línea de esta sea explicable.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada



















