


noviembre 20, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.


¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
OpenTelemetry está proporcionando a los sistemas GenAI un vocabulario de telemetría compartido, pero no es un esquema universal definitivo. En junio de 2026, el proyecto trasladó sus convenciones semánticas de GenAI, específicas de proveedores y de MCP a un repositorio dedicado para poder iterar y publicar versiones de forma independiente. Actualmente, ese repositorio marca las convenciones GenAI como en Desarrollo (Development) y, a fecha de 21 de agosto de 2026, no cuenta con una versión oficial lanzada. La oportunidad sigue siendo sustancial: unos nombres comunes para las operaciones del modelo, el uso de tokens, los pasos del agente, las llamadas a MCP, los eventos de contenido y los resultados de evaluación pueden reducir el trabajo de traducción entre la instrumentación y los backends de observabilidad. La postura de ingeniería debe ser la adopción con conocimiento de la versión, no dar por sentado que el esquema de gen_ai.* ya se ha congelado.
Dos equipos pueden emitir telemetría válida en OpenTelemetry y aun así no estar de acuerdo sobre qué significa una llamada a un LLM. La interoperabilidad del transporte y la interoperabilidad semántica son problemas distintos. OTLP puede mover telemetría entre sistemas; las convenciones semánticas hacen que los campos dentro de esa telemetría sean interpretables de forma más consistente. En el caso de GenAI, este segundo problema aún se está estandarizando activamente.
El APM genérico sigue siendo útil para el rendimiento de procesamiento, la latencia, los errores, las dependencias y la salud del servicio. La GenAI añade semánticas que esas señales no describen por sí solas.
Comportamiento probabilístico. La misma solicitud lógica puede generar salidas diferentes, por lo que la depuración a menudo requiere el modelo solicitado y el servido, los ajustes de generación, los identificadores de respuesta y, cuando la política lo permita, el contexto de entrada o salida relevante. El contenido completo es una prueba útil, pero no siempre es adecuado o necesario retenerlo.
Economía de los tokens. El recuento de solicitudes sigue siendo importante para la carga y la limitación de tasa, pero resulta insuficiente para analizar el gasto y la eficiencia del modelo. Un número reducido de llamadas con un contexto largo puede costar más que un número elevado de llamadas cortas. Las métricas actuales de GenAI incluyen el uso de tokens y la duración de la operación, junto con mediciones del tiempo transcurrido hasta el primer fragmento (time-to-first-chunk) y el tiempo por fragmento de salida (time-per-output-chunk).
Estructura del agente. Una llamada al modelo es solo una operación dentro de muchas en los agentes. La planificación, la ejecución de herramientas, la recuperación de información, los flujos de trabajo y las llamadas a MCP pueden determinar el resultado. Por lo tanto, la observabilidad necesita un vocabulario para la ejecución que rodea a la inferencia, no solo para el límite de la API del proveedor.
Sensibilidad del contenido. Los prompts y las salidas suelen contener datos del usuario o de la empresa. OpenTelemetry puede describir cómo registrar ese contenido, pero decidir si se debe capturar, retener, exportar, redactar o restringir sigue siendo una decisión de gobernanza de datos.
La forma más útil de interpretar el trabajo actual es por señal y por operación, en lugar de asumir una única escala de madurez. El repositorio dedicado a GenAI marca el conjunto de las convenciones como en Desarrollo (Development).
Spans de modelo y de inferencia. Las convenciones actuales definen las operaciones de cliente de GenAI, incluyendo la inferencia, los embeddings, las recuperaciones de información, la obtención de respuestas, las operaciones de memoria y la ejecución de herramientas. Los atributos comunes incluyen gen_ai.provider.name, gen_ai.operation.name, identificadores del modelo solicitado y de respuesta, y el uso de tokens de entrada/salida. La temporización del span proporciona la duración de la operación; las métricas dedicadas estandarizan el uso de tokens y las mediciones relacionadas con la latencia.
Spans de agente y del framework. Las convenciones del agente definen operaciones como create_agent, invoke_agent, invoke_workflow, plan y execute_tool. Estos spans pueden hacer que una ruta de ejecución instrumentada sea reconstruible. No exponen el razonamiento privado de un modelo ni aparecen automáticamente a menos que el framework o la instrumentación correspondientes los emitan.
Convenciones de MCP. MCP cuenta con sus propias convenciones en Desarrollo (Development) para spans de cliente y servidor, propagación del W3C Trace Context, correlación de transporte, atributos para la detección de herramientas y métricas como mcp.client.operation.duration y mcp.server.operation.duration. El valor reside en la continuidad a través del límite de MCP, no en la promesa de que cada implementación de MCP ya emita estas convenciones.
Métricas y convenciones específicas de proveedores. El repositorio define métricas para cliente, servidor, flujo de trabajo, agente y herramientas, e introduce convenciones específicas de proveedores para sistemas como OpenAI, Anthropic, Azure AI Inference y AWS Bedrock.
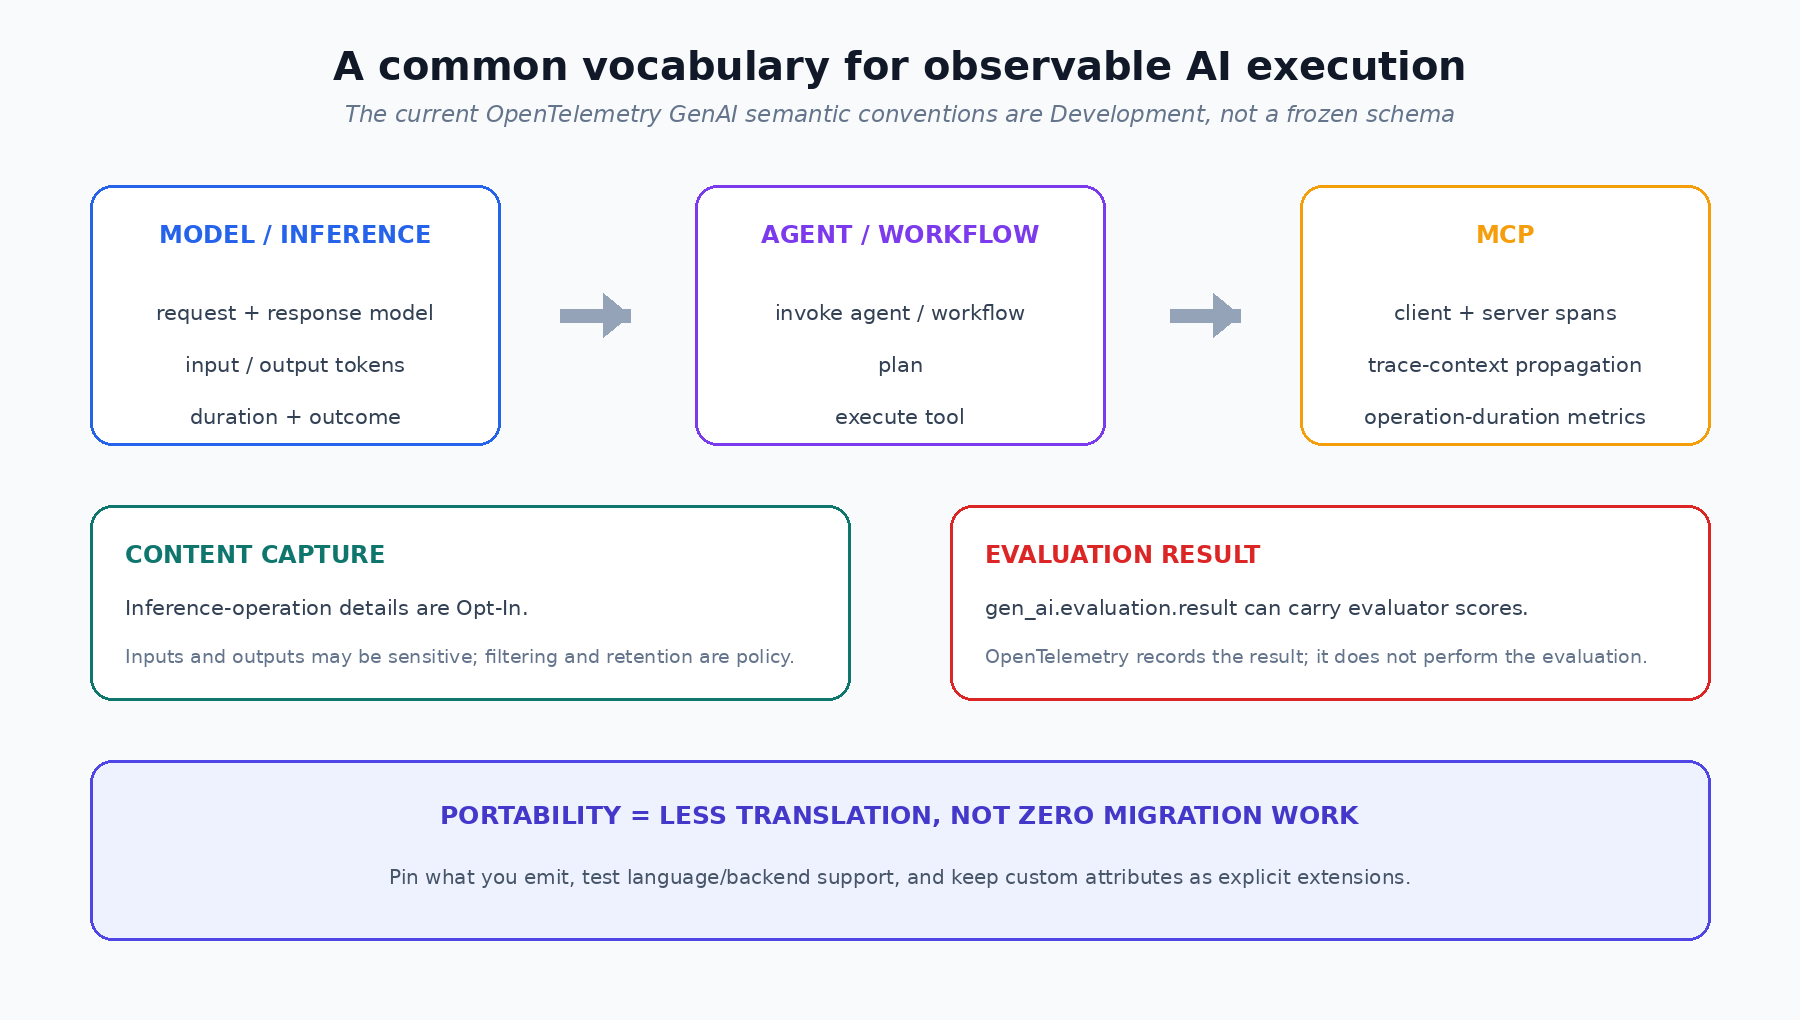
El evento actual gen_ai.client.inference.operation.details puede transportar el historial de chat, los parámetros, las entradas y las salidas de forma independiente de la traza principal. Su nivel de requerimiento es explícitamente Opt-In, y la documentación de OpenTelemetry advierte de que el soporte de eventos aún no está disponible en todos los lenguajes.
Este es un valor predeterminado mejor que tratar los prompts y las ejecuciones completadas como texto de diagnóstico ordinario. OpenTelemetry define la estructura de la telemetría; no decide el periodo de retención, el almacenamiento regional, la política de acceso, la base legal ni los requisitos de redacción. Esas siguen siendo responsabilidades del operador y del backend.
Para un despliegue en producción, redacta la política antes de activar el contenido: qué entornos pueden capturar el contenido completo, qué se filtra o se trunca, adónde se permite enviar la telemetría exportada, cuánto tiempo se retiene y quién puede recuperarla.
Una pasarela es un punto de emisión idóneo para el tráfico de modelos que realmente pasa a través de ella. Observa los modelos solicitados y servidos, la latencia, los resultados de los proveedores, el uso de tokens, el comportamiento del enrutamiento y las variables de coste sin pedir a cada equipo de aplicación que vuelva a construir esa recolección de forma independiente. Por sí sola, no es una traza de agente completa: la planificación local de la app, la recuperación de información, el trabajo con herramientas o las llamadas que omiten la pasarela requieren instrumentación en esas capas específicas.
TrueFoundry ya exporta a través de OpenTelemetry. AI Gateway admite la exportación OTLP de trazas y métricas a plataformas de observabilidad compatibles. El material de ingeniería actual de TrueFoundry también documenta los spans del proveedor utilizando atributos contemporáneos como gen_ai.provider.name, gen_ai.operation.name, gen_ai.request.model, gen_ai.response.model, gen_ai.usage.input_tokens y gen_ai.usage.output_tokens, junto con extensiones específicas de TrueFoundry para el contexto y el coste del gateway. (documentación de exportación de OpenTelemetry; guía de instrumentación del gateway de TrueFoundry).
La visibilidad de MCP puede convivir en el mismo plano operativo. El Metrics Dashboard de TrueFoundry realiza el seguimiento del tráfico, los servidores, las herramientas, los fallos y la latencia de MCP para las llamadas enrutadas a través del AI/MCP Gateway. Esto complementa, en lugar de reemplazar, la instrumentación de la aplicación o del harness para los pasos locales del agente. (Metrics Dashboard; visión general de MCP Gateway).
El runtime del agente es el límite de observabilidad complementario. TrueForge, el harness de agentes de código abierto de TrueFoundry, ejecuta el bucle modelo/herramienta con herramientas MCP, skills, sandboxing, aprobaciones, gestión de contexto y sesiones persistentes. Su modelo de SDK expone una jerarquía explícita de Agent → Session → Turn → Event, con eventos transmitidos en streaming para la inicialización de MCP, mensajes del modelo, respuestas de herramientas, aprobaciones y finalización del turno. Esos eventos de runtime contienen un contexto a nivel de agente que un gateway no puede inferir solo a partir del tráfico del modelo y de MCP.
La afirmación segura para publicación es deliberadamente más acotada que una afirmación de integración: este artículo no afirma que TrueForge emita actualmente las últimas convenciones semánticas de GenAI de OpenTelemetry. En su lugar, TrueForge proporciona una superficie de runtime abierta e inspeccionable que se puede instrumentar o correlacionar con las trazas OTLP que TrueFoundry AI Gateway ya exporta. Esa separación constituye una arquitectura útil: el harness sabe qué está haciendo el agente; el gateway sabe qué cruzó su límite de políticas; OpenTelemetry proporciona a esas capas instrumentadas un transporte común y un vocabulario cada vez más compartido.
La exportación externa de trazas cuenta con un control de contenido explícito. Las guías de integración de OTel de TrueFoundry documentan una opción Exclude Request Data que elimina tfy.input, tfy.output y tfy.input_short_hand de los spans exportados, manteniendo al mismo tiempo la telemetría estructural como los tokens, la latencia y los metadatos del modelo. Este es un control de salida útil para esos campos de contenido de TrueFoundry; los equipos aún deben revisar cualquier atributo estándar o personalizado adicional que emitan. (ejemplo de documentación de integración).
La evaluación se mantiene como un cálculo independiente. TrueFoundry admite flujos de trabajo de evaluación externa sobre trazas, mientras que la convención de OpenTelemetry proporciona un lugar estándar para representar el resultado de un evaluador. No combine ambos conceptos en una sola afirmación: la telemetría aporta evidencias; los evaluadores las interpretan. (evaluación online).

Separe la portabilidad de OTLP de la madurez de las convenciones semánticas. Es útil exportar trazas y métricas a través de OpenTelemetry hoy en día, incluso mientras los nombres de campos de GenAI continúan evolucionando.
Fije y pruebe la semántica que realmente emite. El repositorio de GenAI está en fase Development, las definiciones centrales anteriores se han movido y el soporte por lenguaje es desigual. Trate su conjunto de atributos emitidos como una interfaz con versiones y pruébela frente al backend y las bibliotecas de instrumentación con las que opera.
Instrumente cada límite de ejecución o aplicación según lo que realmente puede ver. Un gateway es excelente para el tráfico de modelos y de MCP enrutado por el gateway. La instrumentación del agente/harness sigue siendo necesaria para la planificación, las herramientas locales, la recuperación, las transiciones de estado y otros trabajos que nunca cruzan ese gateway.
Instrumente el límite del harness cuando necesite la semántica del agente. Si utiliza TrueForge, su modelo de sesión, turno y eventos le proporciona identificadores de runtime explícitos y eventos de herramientas/aprobaciones para correlacionarlos con las trazas del gateway. Transmita solo los metadatos de correlación que su política de observabilidad permita; no copie por defecto cargas de eventos sensibles en los atributos de span.
Haga que la captura de contenido sea opcional (opt-in) por política. Minimice y filtre el contenido antes de la exportación y, a continuación, configure controles de retención y acceso en el backend de observabilidad. No confunda el nombre de un campo de OpenTelemetry con una política de gobernanza de datos.
Mantenga la evaluación separada, pero corrrelaciónela. Calcule la calidad o la seguridad con el evaluador adecuado para la carga de trabajo y, a continuación, utilice un evento estándar de resultado de evaluación donde se admita para adjuntar el resultado a la operación que generó la respuesta.
Utilice atributos personalizados como extensiones, no como reemplazos. Los campos específicos del producto, como los metadatos de coste y del gateway de TrueFoundry, son útiles. Mantenga los atributos estándar junto a ellos para que las herramientas genéricas sigan teniendo una superficie común.
Las convenciones semánticas resuelven un problema de vocabulario, no todos los problemas de observabilidad. El repositorio dedicado de GenAI de OpenTelemetry todavía está en fase Development; la cobertura de la implementación varía según el lenguaje y la biblioteca; y los backends pueden diferir en cómo indexan, consultan, renderizan, retienen o fijan el precio de la misma telemetría. Incluso una cobertura perfecta de las convenciones semánticas solo describe lo que la instrumentación puede observar: no expone el razonamiento oculto del modelo ni hace visible la ejecución no instrumentada.
Para TrueFoundry, la afirmación útil es concreta: AI Gateway puede exportar trazas y métricas a través de OTLP y documenta los atributos de estilo actual gen_ai.* junto con las extensiones específicas de TrueFoundry. Esto proporciona a los equipos una ruta de exportación basada en estándares sin pretender que las convenciones de GenAI, que evolucionan de forma independiente, estén congeladas. Si una versión concreta de convención semántica es un requisito de adquisición o gobernanza, valide el conjunto exacto de atributos emitidos y el soporte de lenguaje/backend del que depende.
gen_ai.evaluation.result.El estado de OpenTelemetry GenAI y los nombres de los campos se describen a partir del repositorio dedicado a las convenciones semánticas de GenAI actual a fecha de 21 de agosto de 2026. El repositorio se encuentra en etapa de Development y no cuenta con un lanzamiento oficial a esa fecha. Las declaraciones sobre los productos TrueFoundry se limitan a la documentación pública actual y al material de ingeniería: exportación OTLP, observabilidad del gateway, métricas MCP, atributos gen_ai.* documentados y filtrado en tiempo de exportación de campos de contenido tfy.* especificados. Este artículo no afirma la conformidad con una confirmación de cambios (commit) específica y no publicada del repositorio OpenTelemetry GenAI.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada


