


noviembre 20, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



Published: noviembre 20, 2026

¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
LiteLLM se ha ganado su popularidad. Tiene licencia MIT, admite más de 100 proveedores tras una única API compatible con OpenAI, se instala en minutos y permite a un equipo pequeño pasar de "llamar a tres proveedores con tres SDK" a "llamar a un solo endpoint" casi sin esfuerzo. Para muchos proyectos es la elección inicial correcta y nada de esta publicación sostiene lo contrario.
Las razones por las que los equipos migran fuera de él son estructurales y aparecen a una escala predecible. Cuando una docena de ingenieros se convierten en cien, cuando una aplicación se convierte en treinta, cuando "probablemente deberíamos controlar el gasto" se convierte en "finanzas necesita el coste por equipo" y "seguridad necesita un registro de auditoría", un proxy Python de proceso único empieza a resentirse ante tareas para las que nunca fue diseñado. Si a esto le sumamos los incidentes de la cadena de suministro de 2026 en la cadena de distribución de LiteLLM, la conversación pasa de "funciona" a "¿quién controla el acceso a nuestros modelos y cómo lo demostramos?".
Esta es una guía de migración, no un análisis destructivo. Identifica las señales específicas de que LiteLLM se te ha quedado pequeño, mapea cada concepto de LiteLLM con su equivalente en una pasarela gobernada y define una transición paso a paso que es de bajo riesgo precisamente porque ambas partes utilizan la API compatible con OpenAI. En la mayoría de los casos, el código de tu aplicación cambia solo en una línea: la URL base.
¿Se te ha quedado pequeño LiteLLM? Descubre cómo un cambio en la URL base te permite pasar a una pasarela gobernada. Reserva una demostración.
Sé preciso con los detonantes. Las historias vagas de "no escaló" no ayudan a planificar; los modos de fallo específicos, sí.
El límite de rendimiento del GIL. El proxy de LiteLLM es Python. El Global Interpreter Lock de Python significa que un proceso ejecuta bytecode de Python en un hilo a la vez. Para un proxy limitado por I/O que principalmente espera respuestas de proveedores, esto es tolerable con baja concurrencia; pero a medida que el volumen de solicitudes concurrentes aumenta, el manejo de solicitudes, la serialización, el registro y las comprobaciones de directivas compiten por ese único bloqueo, viendo cómo la latencia sube y el rendimiento se aplana sin importar cuántico hardware añadas. Puedes fragmentar en muchos procesos e instancias, pero entonces pasas a gestionar la orquestación y el problema de estado compartido que eso crea.
Concentración de secretos y superficie de impacto. El proxy almacena las claves API de cada proveedor que gestiona. Ese es el objetivo de un proxy, pero significa que un proxy comprometido o una configuración filtrada expone OpenAI, Anthropic, los endpoints de tus modelos en la nube, todo a la vez. Sin una gestión centralizada de secretos, rotación y acceso delimitado, la superficie de impacto de cualquier incidente es "absolutamente todo".
Dispersión de despliegues y aplicación de parches. Al ser tan fácil de ejecutar, LiteLLM acaba ejecutándose en todas partes: una copia en el portátil de cada desarrollador, una en CI, varias en producción. Cuando surge una vulnerabilidad, hay que buscar y parchear cada instancia. No hay un plano de control único que diga "cada emisor pasa por este endpoint gobernado", por lo que "parchear el proxy" se convierte en una búsqueda del tesoro.
Carga de HA autohospedada. Ejecutar un proxy es fácil. Ejecutarlo con conmutación por error, actualizaciones sin tiempo de inactividad, comprobación de estado y escalado horizontal bajo SLA es un trabajo de plataforma que ahora asumes por completo. Muchos equipos llegan a un punto en el que ese esfuerzo no diferenciado no merece la pena.
Dos eventos en 2026 convirtieron estas preocupaciones estructurales en urgentes y vale la pena exponerlos con claridad sin alarmismos.
En marzo de 2026, un compromiso en CI provocó la publicación de versiones maliciosas de LiteLLM (versiones 1.82.7 y 1.82.8) en PyPI. Los paquetes maliciosos robaban credenciales de los sistemas que los instalaban. La imagen oficial de Docker no se vio afectada. En octubre de 2026, un segundo incidente implicó la publicación de una versión maliciosa (1.107.0) tanto en PyPI como en Docker utilizando tokens de GitHub robados. De forma independiente, LiteLLM ha tenido múltiples CVE, incluida una en el catálogo de Vulnerabilidades Conocidas Explotadas de CISA (una ruta de ejecución remota de código explotable por titulares de una clave API) y un problema por el cual se podía establecer una sesión MCP con cualquier token portador.
El patrón de corrección en cada caso fue el mismo: fijar versiones, reconstruir desde una versión conocida como buena y rotar todos los secretos. La lección no es "LiteLLM no es seguro"; los proyectos de código abierto son objetivo precisamente porque se usan ampliamente. La lección es que la concentración de secretos junto con la dispersión de versiones convierte cualquier evento individual en la cadena de suministro en un incidente en toda la flota, y ese es un argumento a favor de un plano de control gobernado donde la versión, los secretos y el acceso se gestionen y auditen de forma centralizada. Una dependencia comprometida es mucho más fácil de contener cuando todos los emisores ya se dirigen a través de un endpoint gobernado con credenciales rotadas y delimitadas, y un registro de auditoría completo.
Una pasarela de IA gobernada conserva todo lo que te daba LiteLLM (un endpoint compatible con OpenAI para muchos proveedores) y añade la capa en la que un proxy ligero no se centra:
TrueFoundry ofrece esto como un único plano de control y, de forma crucial, se despliega como SaaS, en tu VPC, on-premise o en entornos aislados (air-gapped), manteniendo el plano de datos dentro de tu red, por lo que "gobernado" no significa "entregar tu tráfico a un tercero". Para conocer los criterios de selección en general, consulta cómo elegir una pasarela de IA y, para el marco arquitectónico, qué es y qué hace un proxy de LLM.
Descubre cómo TrueFoundry mapea tus claves, presupuestos y modelos de LiteLLM a una directiva gobernada. Reserva una demostración.
La migración es deliberadamente incremental. Nunca se cambia toda la organización de golpe.
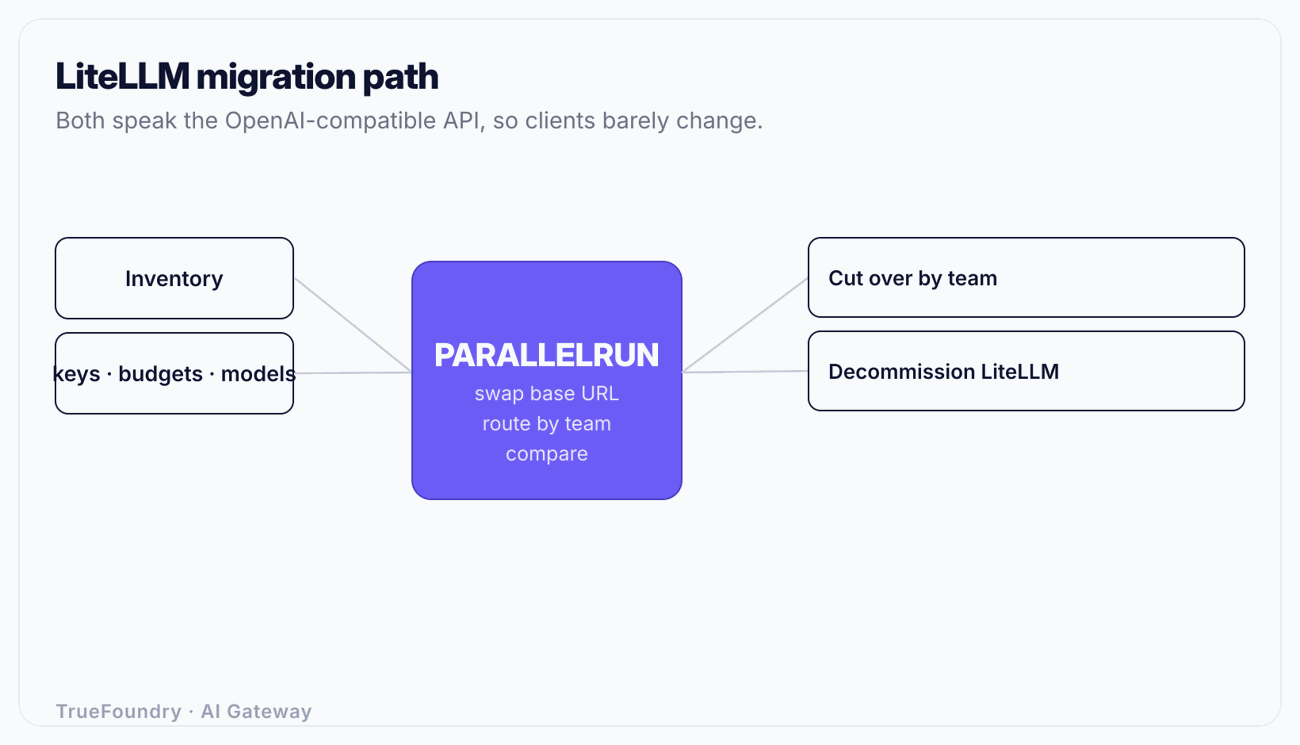
Antes de tocar nada, cataloga lo que LiteLLM está haciendo por ti hoy:
El inventario de emisores es el paso que los equipos se saltan y del que luego se arrepienten. No puedes transferir un tráfico que no sabías que existía. Utiliza grep en tus bases de código e infraestructura para buscar el nombre de host del proxy.
No estás reconstruyendo; estás traduciendo. Cada concepto de LiteLLM tiene un equivalente en la pasarela gobernada.
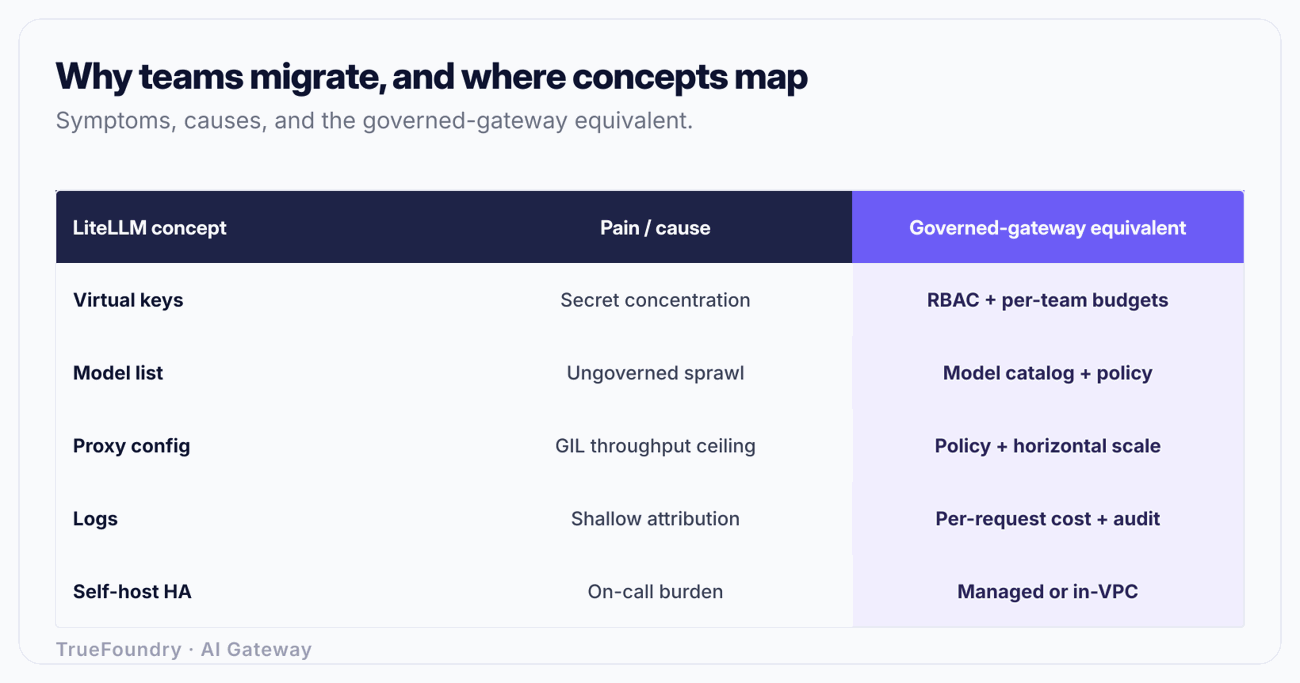
La traducción es principalmente un replanteamiento mental: LiteLLM piensa en claves y en un archivo de configuración; una pasarela gobernada piensa en identidades, equipos, catálogos y directivas. Las capacidades se superponen en gran medida, por lo que la migración es de bajo riesgo.
Este es el paso que hace que todo sea seguro. Tanto LiteLLM como la pasarela gobernada exponen una API compatible con OpenAI. Eso significa que el único cambio que necesita un cliente es la URL base: pasar de la URL del proxy de LiteLLM al endpoint de la pasarela. Sin cambiar de SDK, sin reescribir la estructura de las solicitudes, sin cambios en la interpretación de las respuestas.
Despliega la pasarela gobernada junto a LiteLLM. Apunta un solo servicio de bajo riesgo a la nueva URL base. Verifica que las respuestas sean idénticas, que la observabilidad muestre el tráfico con la atribución de costes correcta y que los presupuestos y las barreras de protección se comporten según lo configurado. Como ambos endpoints están activos, puedes compararlos directamente y volver a cambiar un servicio a la URL base antigua en segundos si algo no parece correcto.
Un ejemplo concreto: supongamos que tu servicio de inferencia lee OPENAI_API_BASE desde una variable de entorno. La migración para ese servicio consiste en cambiar una variable de entorno y reiniciar, y revertirla es volver a cambiarla. Esa es toda la superficie de impacto en el lado del cliente de esta migración cuando ambas partes utilizan la misma API.
Ahora migra el tráfico en oleadas, organizadas por equipo o aplicación, no todo a la vez:
Hacer la transición por equipos te da un límite de reversión limpio y permite definir correctamente los presupuestos y los accesos por equipo a medida que avanzas, en lugar de migrar un entramado de claves compartidas en un solo salto arriesgado. También distribuye el trabajo de revisión: cada equipo confirma que su propio tráfico se ve bien antes de continuar.
Una vez que cada emisor apunte a la pasarela y haya estado a prueba el tiempo suficiente para confiar en él, desmantela LiteLLM: detén las instancias del proxy, elimina los secretos de proveedores de su configuración y, lo que es muy importante, rota esas credenciales de proveedores para que las copias del antiguo proxy queden inhabilitadas. Elimina el proxy de la CI y de las configuraciones de los desarrolladores para que la dispersión de despliegues no vuelva a crecer silenciosamente. La migración termina cuando existe exactamente una ruta gobernada hacia cada modelo y ningún proxy huérfano custodie claves activas.
Migrar claves compartidas en lugar de redefinir el acceso por equipo. Los despliegues de LiteLLM acumulan claves virtuales compartidas que usan varios equipos. Transferirlas tal cual vuelve a crear la misma dispersión sin gobernar de la que estás intentando escapar. Aprovecha la transición para definir el acceso por equipo contra tu proveedor de identidad; esa es la mitad del propósito de la migración.
Omitir el inventario de emisores. Los equipos migran las aplicaciones que recuerdan y dejan un notebook, un trabajo de cron o un paso de CI apuntando al antiguo proxy. Luego desmantelan LiteLLM y algo se rompe en silencio. Busca todo con grep para encontrar el nombre de host antiguo antes de apagar el proxy.
Olvidar rotar los secretos al desmantelar. Si apagas LiteLLM pero dejas sin rotar las claves de proveedores que custodiaba, esas credenciales siguen activas y ahora están en un sistema desmantelado y sin supervisión, exactamente la condición de secretos obsoletos que explotaron los incidentes de 2026. Rota cada credencial que custodiara el antiguo proxy.
Tratar el cambio de URL base como si fuera toda la migración. El cambio de URL base es lo que hace que el lado del cliente sea trivial, pero la gobernanza (RBAC, presupuestos, delimitación de catálogos, auditoría) es la razón por la que estás migrando. Cambiar las URL sin configurar realmente la gobernanza te deja con un nuevo proxy y los mismos problemas antiguos.
Transición masiva ("big bang"). Cambiar a toda la organización en un solo paso elimina tu margen de reversión. La ejecución en paralelo y la transición equipo por equipo existen para que cualquier problema se limite a un solo equipo y sea reversible con un simple cambio de URL base. Omítelos solo si disfrutas de las llamadas de emergencia por incidentes.
Que LiteLLM se te quede pequeño es una señal de éxito, no un error al elegirlo. Los detonantes son específicos y estructurales: el límite de rendimiento de un proxy Python bajo concurrencia, la concentración de todos los secretos de proveedores en un solo lugar, la dispersión de copias en múltiples entornos, el peso completo de la HA autohospedada y un año 2026 en la cadena de suministro que hizo que la concentración de secretos y la dispersión de versiones parecieran mucho menos abstractas.
La migración en sí es de bajo riesgo porque ambas partes utilizan la API compatible con OpenAI, por lo que el cambio en el cliente suele ser solo la URL base. Inventaria lo que tienes, mapea las claves a RBAC y presupuestos, la lista de modelos a un catálogo, la configuración a directivas, ejecuta ambos sistemas en paralelo, realiza la transición equipo por equipo y desmantela con una rotación completa de secretos. Hecho de esta manera, cambias un proxy conveniente por un plano de control gobernado sin necesidad de reescribir código, y obtienes como resultado un control total sobre el acceso, los costes y la auditoría.
Migra desde LiteLLM con cambios mínimos en tus aplicaciones. Reserva una demostración.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada




