


noviembre 20, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



Published: noviembre 20, 2026

¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
El Model Context Protocol proporciona a un LLM una forma estándar de llamar a herramientas, leer contexto y reutilizar prompts en cualquier cliente compatible. Crear un servidor que lo hable no es difícil; crear uno que sea correcto, seguro de exponer y agradable de usar para un modelo requiere tomar algunas decisiones más de las que cubren los tutoriales de inicio rápido. Esta guía recorre el camino completo: qué expone un servidor, qué transporte elegir y por qué, cómo definir una herramienta que el modelo realmente use bien, cómo autenticar un servidor remoto, cómo probarlo y qué cambia cuando se pasa de un portátil a producción.
Los ejemplos prácticos son pseudocódigo estructural en un estilo similar a Python. Muestran la forma correcta (nombres, esquemas, firmas de controladores) sin vincularte a una versión específica de SDK, porque la forma es lo que se traslada. Si prefieres primero la base conceptual, qué es un servidor MCP cubre el modelo; esta publicación aborda la construcción.
¿Has creado un servidor MCP? Ponlo tras un gateway para autenticación, registro y auditoría. Reserva una demo.
Un servidor MCP ofrece tres tipos de capacidades a un cliente. Acertar con la distinción en la fase de diseño evita el error más común: meter todo a la fuerza en las herramientas.
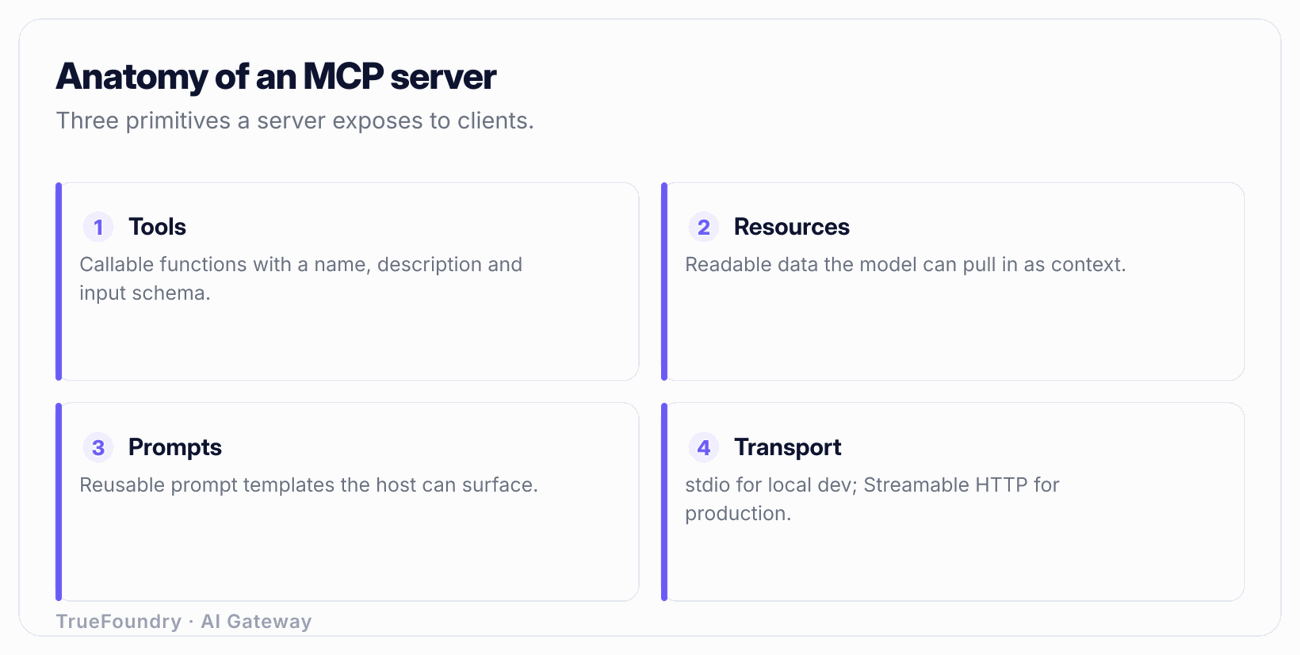
Las herramientas (tools) son funciones invocadas por el modelo. El modelo decide, durante una conversación, llamar a una herramienta para realizar una tarea: consultar una base de datos, crear un ticket o enviar una solicitud a una API interna. Las herramientas pueden tener efectos secundarios. Son la primitiva a la que se recurre cuando el modelo necesita actuar. Una herramienta tiene un nombre, una descripción y un JSON Schema para sus entradas, y devuelve contenido estructurado.
Los recursos (resources) son contexto de solo lectura controlado por la aplicación y mediante una URI. Un recurso son datos que el cliente puede leer y entregar al modelo como contexto: un archivo, un documento de configuración o el contenido actual de un registro. La diferencia clave respecto a una herramienta radica en el control y la intención. Un recurso es de solo lectura y normalmente lo selecciona la aplicación o el usuario ("adjunta este documento"), no lo invoca el modelo en mitad de un razonamiento para causar un efecto. Si lo que estás exponiendo nunca cambia de estado y es realmente "aquí tienes un contexto para leer", se trata de un recurso, no de una herramienta.
Los prompts son plantillas invocadas por el usuario. Un prompt es un mensaje (o secuencia de mensajes) reutilizable y parametrizado que un usuario activa explícitamente, a menudo presentado en un cliente como un comando de barra inclinada (slash command) o un elemento de menú. "Resume esta PR en nuestro estilo corporativo" con un parámetro pr_url es un prompt. Los prompts los controla el usuario, no los elige el modelo de forma autónoma.
Una regla práctica: si el modelo debe decidir cuándo usarlo, crea una herramienta. Si el usuario o la aplicación deciden qué contexto cargar, crea un recurso. Si el usuario quiere una instrucción predefinida y repetible, crea un prompt. La mayoría de los servidores solo envían herramientas de forma legítima, pero un servidor que exponga, por ejemplo, tus manuales operativos (runbooks) internos se modela mejor con recursos que con una herramienta get_runbook que el modelo tenga que adivinar cómo llamar.
El protocolo define cómo intercambian mensajes JSON-RPC un cliente y un servidor. Hay dos transportes importantes, y la elección condiciona casi todo sobre cómo se despliega.
El stdio local ejecuta el servidor como un subproceso del cliente e intercambia mensajes a través de la entrada y salida estándar. Es la opción adecuada para el desarrollo y para clientes de escritorio como un IDE o un asistente local, donde el servidor se ejecuta en la misma máquina que el usuario. No hay red, no hay autenticación que configurar y el cliente gestiona el ciclo de vida del proceso. Para ejecutar servidores locales dentro de un cliente de código específicamente, consulta servidores MCP en Claude Code. La limitación es evidente: stdio atiende exactamente a un usuario local y no se puede compartir, equilibrar la carga ni alcanzar a través de una red.
El Streamable HTTP remoto ejecuta el servidor como un servicio de red al que los clientes acceden a través de HTTP, con transmisión de servidor a cliente (streaming) para notificaciones y progreso. Este es el transporte para cualquier entorno multiusuario, alojado o de producción. La revisión del protocolo del 2026-07-28 es importante en este punto: Streamable HTTP admite un modo sin estado (stateless), donde el servidor no tiene que vincular a un cliente a una sesión de larga duración en una sola instancia. La operación sin estado es lo que permite ejecutar muchas réplicas idénticas detrás de un equilibrador de carga y escalar horizontalmente sin sesiones pegajosas (sticky sessions), que es la propiedad más importante para el alojamiento en producción. La misma revisión estandarizó las cabeceras Mcp-Method y Mcp-Name en las solicitudes, exponiendo el método JSON-RPC y el nombre de la herramienta o recurso en la capa HTTP. Esto parece menor, pero no lo es. Significa que un gateway, proxy o equilibrador de carga puede enrutar, limitar la velocidad, autorizar y registrar por herramienta sin procesar el cuerpo del JSON-RPC, que es exactamente lo que se necesita para gobernar un servidor a escala.
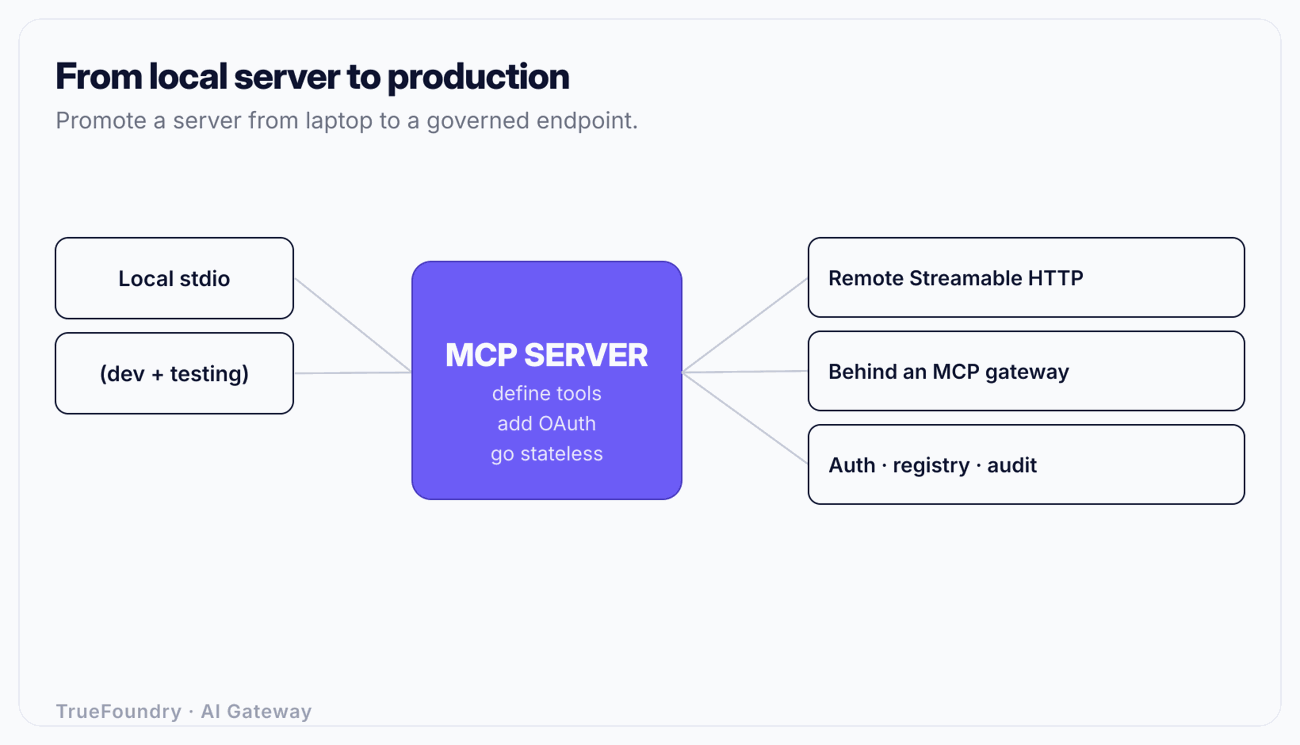
Crea y depura en stdio; despliega en Streamable HTTP. Escribir tu servidor de modo que el transporte sea una capa exterior delgada (controladores a los que no les importa cómo se ha accedido a ellos) te permite moverte entre ellos sin reescribir la lógica.
La definición de una herramienta consta de tres partes, y el comportamiento del modelo está gobernado por las tres. Aquí es donde realmente se originan la mayoría de los problemas de "mi servidor no funciona".
# Structural pseudocode — shape, not a specific SDK version.

@server.tool()
def search_orders(
    customer_id: str,        # required
    status: str = "any",     # enum: open | shipped | cancelled | any
    limit: int = 20,         # 1..100
) -> list[Order]:
    """Search a customer's orders by status.

    Use this when the user asks about the state, history, or
    contents of orders for a known customer_id. Returns up to
    `limit` orders, newest first. Does NOT create or modify
    orders. If the customer_id is unknown, ask the user for it
    rather than guessing.
    """
    ...
Las tres partes:
Nombre. Corto, encabezado por un verbo y no ambiguo. search_orders, no orders ni do_order_stuff. El modelo lee primero el nombre al decidir entre docenas de herramientas disponibles.
Descripción. Este es el texto más importante que escribirás, y es prompt engineering, no documentación. El modelo decide si llama a la herramienta y cómo rellenar sus argumentos casi en su totalidad a partir de la descripción. Indica qué hace la herramienta, cuándo usarla, cuándo no usarla, qué devuelve y cómo gestionar los datos de entrada que falten. El ejemplo anterior le indica al modelo que es de solo lectura ("NO crea ni modifica") y le da un comportamiento alternativo ("pregunta al usuario en lugar de adivinar"). Las descripciones vagas producen un modelo que llama a la herramienta equivocada, llama a la herramienta correcta con argumentos erróneos o la llama cuando no debería. Trata cada descripción como un mini prompt del sistema.
Esquema de entrada. Un JSON Schema preciso. Marca los campos obligatorios como requeridos. Utiliza enumeraciones (enums) para conjuntos cerrados (status es uno de cuatro valores) para que el modelo no pueda inventar "in_progress". Establece límites (limit entre 1 y 100). Añade una descripción a cada campo. Un esquema estricto limita al modelo y permite que el servidor, o un gateway situado delante de él, valide las entradas antes de que se ejecute cualquier controlador.
Dos trampas en las que cae todo el mundo:
create_refund) debe tolerar que se le llame dos veces con las mismas entradas sin duplicar el efecto. Acepta una clave de idempotencia o haz que la operación sea naturalmente idempotente. Diseña para una entrega de al menos una vez (at-least-once), porque eso es lo que vas a recibir.Un servidor stdio local hereda la confianza de la máquina del usuario y no necesita autenticación. En el momento en que expones un servidor sobre HTTP, necesita autenticación real, y el protocolo es muy específico sobre lo que significa "real".
El modelo de autorización de MCP se basa en OAuth 2.1. Hay dos piezas especialmente importantes. En primer lugar, el servidor es un recurso protegido por OAuth: los clientes obtienen un token de acceso de un servidor de autorización y lo presentan como un token de portador (bearer token). En segundo lugar, y fácil de pasar por alto, la especificación exige indicadores de recurso (resource indicators, RFC 8707) para que un token esté vinculado al servidor MCP específico para el que fue emitido (el recurso), en lugar de ser un token de propósito general. Sin indicadores de recurso, un token emitido para el servidor A puede reutilizarse contra el servidor B que confíe en el mismo servidor de autorización, creando un problema de diputado confuso (confused deputy). Con ellos, el servidor de autorización emite un token delimitado al recurso previsto y cada servidor rechaza los tokens que no vayan dirigidos a él.
En la práctica, esto no se implementa desde cero. Se coloca el servidor detrás de algo que finalice OAuth correctamente y valide la audiencia de cada token. Ese es uno de los cometidos de un gateway de MCP. El funcionamiento interno más detallado, la validación de tokens, los ámbitos (scopes) y el modo de fallo por diputado confuso se explican en autenticación en MCP. La regla para esta guía: un servidor MCP remoto protegido por una clave API estática compartida no está autenticado, está ofuscado. Utiliza OAuth 2.1 con tokens vinculados a la audiencia.

Descubre cómo TrueFoundry aloja y gobierna tus servidores MCP remotos. Reserva una demo.
Antes de exponer nada, ejercita el servidor a través de un cliente MCP y observa el intercambio real de mensajes.
La prueba guiada por el modelo del paso 3 es la que los equipos suelen saltarse y la que más importa. Un servidor técnicamente correcto pero que describe mal sus herramientas fallará de la forma más difícil de depurar a través de los registros: simplemente, el modelo lo usará mal.
Un servidor que se ejecuta en tu portátil sobre stdio y un servidor que es seguro exponer a tráfico real son artefactos distintos. Esto es lo que contiene la brecha entre ambos.
Alojamiento y ciclo de vida. El servidor se convierte en un servicio que se despliega, monitoriza, implementa y revierte. Necesita comprobaciones de estado (health checks), límites de recursos y un destino de despliegue. Alojamiento de servidores MCP cubre las opciones y alternativas.
Escalado sin estado. Para ejecutar múltiples réplicas detrás de un equilibrador de carga, mantén el servidor sin estado por solicitud, que es para lo que está diseñado el modo sin estado de Streamable HTTP de la revisión 2026-07-28. Cualquier estado de sesión debe residir en un almacén compartido, no en la memoria de la instancia; de lo contrario, la siguiente solicitud de un cliente enrutada a una réplica diferente fallará.
Autenticación y autorización. OAuth 2.1 con indicadores de recurso para la autenticación y, a continuación, autorización: qué usuarios y qué agentes pueden llamar a qué herramientas. Trata al agente como una identidad de primer nivel, no solo al humano que está detrás; la identidad del agente de IA y la autorización detallada por herramienta son lo que evita que un servidor capaz se convierta en una amenaza de seguridad.
Descubrimiento mediante un registro. Los clientes y los equipos de plataforma necesitan encontrar el servidor, saber qué versión tiene y conocer qué expone. Un registro es el catálogo que hace que los servidores sean descubribles y gobernables en toda una organización; consulta qué es un registro MCP. Sin él, cada equipo vuelve a descubrir y reconfigurar manualmente los mismos servidores.
Observabilidad. Necesitas visibilidad por llamada: quién llamó a qué herramienta, con qué argumentos, cuánto tardó, si dio error y cuánto costó. Los servidores básicos no emiten nada de esto de forma estandarizada.
Barreras de protección (guardrails). Las entradas y salidas de las herramientas pueden transportar PII, secretos o payloads de prompt injection introducidos a través del contenido devuelto. Inspeccionarlos es una responsabilidad transversal que no conviene reimplementar en cada servidor.
El patrón que hace que esto sea manejable consiste en no reestructurar esa capa por servidor. Construye tu servidor para que haga bien su único cometido sobre Streamable HTTP y ponlo detrás de un gateway de MCP que proporcione autenticación, autorización, registro, observabilidad y guardrails de forma uniforme. Esa es la diferencia entre exponer un servidor aislado y operar una flota de ellos. Qué es un gateway MCP explica el modelo y gobernanza empresarial de MCP cubre los requisitos de control, auditoría y acceso que conlleva. TrueFoundry ofrece esto como un gateway y registro de MCP con control de acceso (RBAC, SSO, SCIM) y guardrails, desplegable en SaaS, en VPC propia, en local (on-prem) o en entornos aislados (air-gapped) para que el plano de datos permanezca dentro de tu red.
Lo convierten todo en una herramienta. El contexto de solo lectura se mete a la fuerza en herramientas get_* que el modelo tiene que adivinar cómo llamar, cuando debería ser un recurso que la aplicación adjunta. Las instrucciones predefinidas y repetidas se codifican de forma rígida, cuando deberían ser prompts que el usuario invoca. Modela las tres primitivas deliberadamente.
Escriben descripciones de herramientas demasiado breves. Una descripción de una sola línea deja que el modelo adivine cuándo y cómo llamar a la herramienta, y terminará adivinando mal. La descripción gobierna el comportamiento; escríbela como un prompt del sistema, incluyendo cuándo no usar la herramienta.
Despliegan un servidor remoto tras una clave compartida. Una clave API estática no es autenticación. Los servidores remotos necesitan OAuth 2.1 con tokens vinculados a la audiencia (indicadores de recurso) para que un token destinado a un servidor no se pueda reutilizar en otro. Omitir esto crea una vulnerabilidad de diputado confuso.
Ignoran la idempotencia. Los clientes, las redes y los sistemas de conmutación por error de los gateways realizan reintentos. Una herramienta con efectos secundarios que no sea idempotente duplicará cobros, creaciones o envíos bajo condiciones de reintento perfectamente normales. Diseña para una entrega de al menos una vez.
Tratan el "funciona" como un "está listo para producción". Que un servidor funcione es solo el principio. El alojamiento, el escalado sin estado, la autenticación, el registro, la observabilidad y los guardrails constituyen el trabajo real para que exponerlo sea seguro, y reconstruir eso por servidor es la razón por la que las organizaciones terminan con docenas de puntos de enlace sin gobernar.
Crear un servidor MCP es un trayecto corto de inicio y largo de consolidación. El inicio es la guía rápida: elegir un transporte, registrar una herramienta con nombre, descripción y esquema, y probarla con un cliente. Se puede tener un servidor funcional en una tarde. La consolidación comprende todo lo que lo hace correcto y seguro: modelar intencionadamente herramientas frente a recursos frente a prompts, escribir descripciones sobre las que el modelo pueda actuar, hacer idempotentes las herramientas con efectos secundarios, autenticar el acceso remoto con OAuth 2.1 e indicadores de recurso, y escalar sin estado.
El paso que la mayoría de los equipos subestiman es el salto de "funciona en mi portátil" a "expuesto a tráfico real". Ese salto abarca el alojamiento, la autenticación, la autorización, el descubrimiento, la observabilidad y los guardrails, y la clave reside en no reconstruir esa capa para cada servidor. Crea el servidor para que cumpla su función sobre Streamable HTTP, colócalo tras un gateway y registro de MCP para la gobernanza, y dispondrás de algo que realmente se puede operar en lugar de un endpoint aislado que nadie puede asegurar ni encontrar.
Lleva tu servidor MCP de un entorno local a una producción gobernada. Reserva una demo.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada




