


noviembre 20, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



Published: noviembre 20, 2026

¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
Las comparaciones directas de modelos suelen hacerse la pregunta equivocada. "¿Terra o Flash?" implica que debes casarte con uno. Pero GPT-6.1 Terra y Gemini 3.6 Flash ocupan el mismo escalón de la pirámide: modelos de gama media, gran contexto y código sólido (aunque no flagship) con precios muy cercanos. Cuando dos modelos están tan próximos y son tan sustituibles, el error caro es elegir uno y dejarlo fijado en el código. El movimiento barato y resiliente es enrutar entre ellos, usar cada uno donde sea mejor o más barato, y hacer fallback de uno a otro cuando un proveedor tenga un mal momento.
Esta publicación compara ambos en las dimensiones que importan (precio, contexto, código, velocidad), todo según informes y con cautela, y luego plantea el verdadero argumento: tratarlos como objetivos intercambiables en una directiva de enrutamiento, con un flagship por encima de ellos para la parte difícil.
Nota de precisión: aparte de las cifras de Claude utilizadas como referencia, cada especificación a continuación procede de informes de terceros a fecha de noviembre de 2026, y algunas fuentes entran en conflicto. Verifica con las páginas oficiales de OpenAI y Google antes de construir sobre estos números.
¿Quieres enrutar entre modelos de gama media por tarea y precio, con fallback automático? Reserva una demo.
Se informa de que GPT-6.1 Terra se lanzó alrededor del 26 de octubre de 2026 como el miembro de gama media de la línea GPT-6.1 de OpenAI. Perfil reportado: 1 $ por 1M de tokens de entrada, 5 $ por 1M de tokens de salida, ventana de contexto de aproximadamente 1,05M y un Coding Index en torno a 48. Su característica destacada es el precio: a unos 1 $ / 5 $ reportados, se sitúa cerca de la mitad del coste por token de GPT-6.1 Sol (reportado en 2 $ / 10 $) mientras que, según se informa, conserva una gran parte de la capacidad de código de Sol.
Se informa de que Gemini 3.6 Flash se lanzó alrededor de julio de 2026 como el modelo de gama media de Google optimizado para velocidad. Perfil reportado: 1,50 $ por 1M de tokens de entrada, 7,50 $ por 1M de tokens de salida, una ventana de contexto de 1M, rendimiento cercano a 280 tokens por segundo, un Intelligence Index cerca de 50 y SWE-Bench Pro alrededor del 58,7 %. Su característica destacada es la combinación de código y velocidad a un precio de gama media.

Precios/benchmarks según informes a fecha de noviembre de 2026; verifica en la página de precios oficial de cada proveedor antes de basarte en ellos: las especificaciones de los modelos cambian con frecuencia. Las cifras de Claude, donde se haga referencia en otros lugares, son los únicos números confirmados de primera mano.
Unas pocas advertencias honestas sobre cómo leer esta tabla:
La conclusión hacia la que empuja la tabla no es "Gana Terra" ni "Gana Flash". Es que estos dos están lo suficientemente cerca como para ser sustitutos, y los sustitutos son exactamente aquello entre lo que quieres enrutar.
Cuando dos modelos son sustituibles, comprometerse con uno no te aporta nada y te cuesta dos cosas: pierdes la capacidad de usar el modelo más adecuado por tarea y asumes el riesgo de caída de un único proveedor. Enrutar entre ellos soluciona ambos problemas.
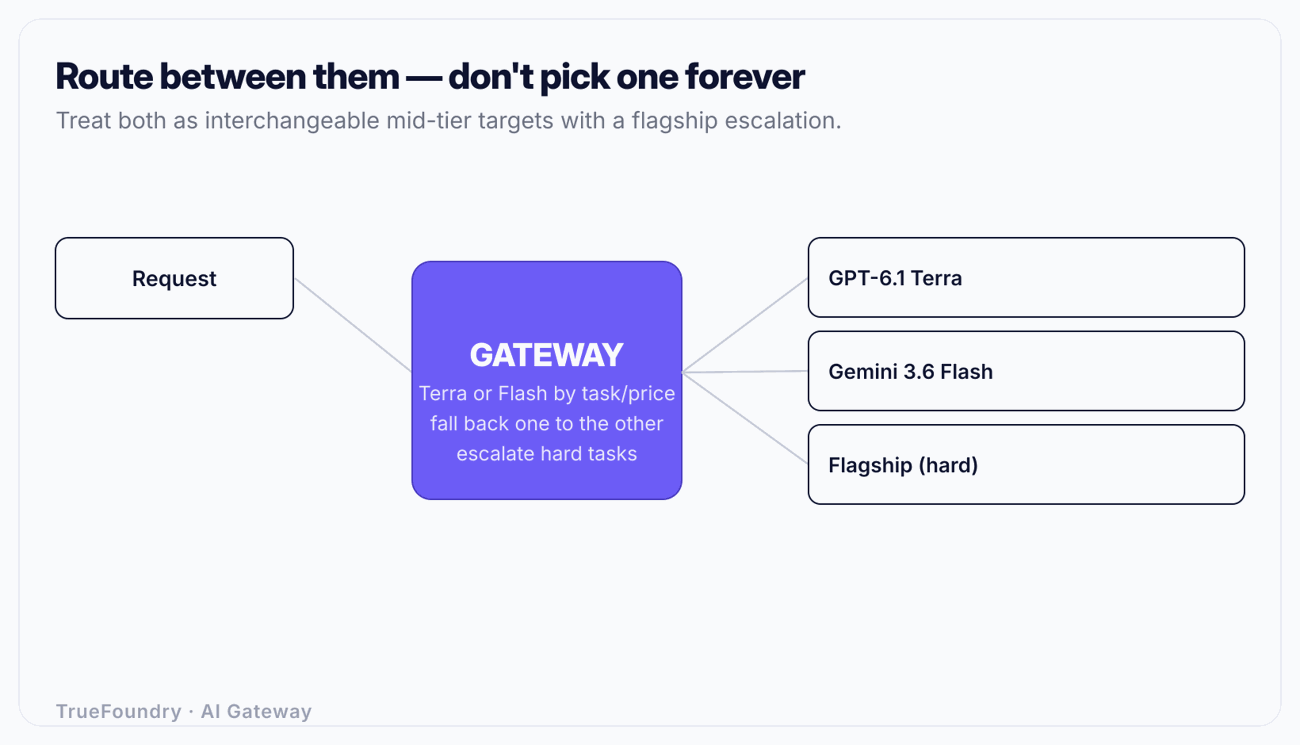
El precio reportado más bajo de Terra lo convierte en la opción por defecto para tráfico orientados a la salida y sensible al coste: generación masiva, chat largo, código diario de alto volumen. La ventaja reportada de Flash en código y velocidad lo convierte en el objetivo preferido para peticiones con carga intensiva de código o rutas sensibles a la latencia donde los ~280 tokens/seg importan. No tienes que elegir a nivel global; eliges por clase de tarea. Esto es selección de modelos basada en coste y calidad, y el mecanismo detrás de ello es un router de LLM.
Dado que son sustituibles, cada uno es un fallback natural para el otro. Configura Terra como principal con Flash como fallback (o a la inversa) y cualquier error de proveedor, tiempo de espera o límite de tarifa en uno será absorbido por el otro. El usuario ve una respuesta ligeramente más lenta, no un fallo. Este es el valor central del fallback de LLM: dos modelos intercambiables de gama media te dan redundancia de proveedores casi gratis, porque de todos modos ibas a ejecutar uno de ellos.
Ninguno es un flagship. Para código agéntico de largo alcance o razonamiento profundo, ambos deberían escalar a un nivel flagship (Claude Opus 5.5 es una opción sólida por defecto confirmada; GPT-6.1 Sol y Gemini 3.1 Pro son pares reportados). El par de gama media gestiona el volumen; el flagship capta la parte difícil. La puerta de acceso es una regla de enrutamiento.
Descubre cómo TrueFoundry trata modelos intercambiables como una sola directiva de enrutamiento. Reserva una demo.
Precios/benchmarks según informes a fecha de noviembre de 2026; verifica en la página de precios oficial de cada proveedor antes de basarte en ellos: las especificaciones de los modelos cambian con frecuencia.
Observa que la mayoría de las filas emparejan los dos modelos como principal y fallback en lugar de elegir uno de forma exclusiva. Ese es el objetivo del diseño: no estás eligiendo un ganador, estás asignando roles que se pueden intercambiar.
La directiva anterior solo es útil si es barata de expresar y barata de cambiar. Un AI gateway con una API unificada y compatible con OpenAI te da eso. Tu aplicación llama a un alias estable; el gateway decide si la petición llega a Terra, a Flash o a un flagship, y qué hacer en caso de error.
Como ambos modelos tienen un alias, la llegada de GPT-6.2 o Gemini 3.7, o una rebaja de precio en cualquiera de ellos, es solo una edición de configuración. Tu directiva de enrutamiento se adapta; tu aplicación no cambia.
Toma un producto de herramientas para desarrolladores que envía 4M de peticiones de código de gama media al mes, con mucha salida (aproximadamente 600 tokens de entrada y 1.500 de salida por petición, ya que la generación de código produce muchos tokens).
La salida domina aquí, por lo que el precio de salida es la palanca. Con los 5 $ / 1M de salida reportados de Terra, 1.500 tokens de salida por petición cuestan unos 0,0075 $ por petición en salida. Con los 7,50 $ / 1M reportados de Flash, la misma petición cuesta unos 0,01125 $ en salida, aproximadamente un 50 % más. En 4M de peticiones, esa diferencia es sustancial.
Pero, según se informa, Flash programa un poco mejor y se ejecuta más rápido. Así que la directiva no es "todo Terra". Es: enrutar la mayor parte de la generación rutinaria a Terra para aprovechar la ventaja del precio de salida, enrutar las peticiones de código más difíciles o sensibles a la latencia a Flash, y hacer fallback de cada uno al otro en caso de error. Luego observas el coste por modelo y la calidad por modelo en la observabilidad y ajustas el reparto. Si la calidad de Terra se mantiene en tu tráfico, te apoyas más en él; si la ventaja de Flash en código se traduce en menos reintentos, eso cambia los cálculos. La única forma de saberlo es midiendo, por lo que el enrutamiento y la observabilidad son un solo sistema, no dos.
Los reintentos cambian estos cálculos de una manera que las tablas de precios brutos ocultan. Si la salida de Terra es un 33 % más barata pero produce una respuesta incorrecta que fuerza una segunda llamada un 5 % más a menudo que Flash, esa tasa de reintentos se come parte de la ventaja de precio, porque una petición reintentada paga dos veces. Es por eso que una comparación de precios plana es engañosa y por lo que hay que medir el coste efectivo por respuesta correcta, no el coste por llamada. Un modelo que es nominalmente más barato pero necesita más reintentos puede acabar siendo más caro con tráfico real, y la única forma de verlo es con observabilidad por modelo rastreando tanto el coste como la tasa de fallos en tus propias peticiones.
Para evitar que una ruta de escalación dispare el gasto en silencio, limita el nivel flagship con límites de tarifa de tokens y presupuestos de modo que una escalación descontrolada devuelva un HTTP 429 en lugar de una factura sorpresa.
GPT-6.1 Terra y Gemini 3.6 Flash no son un duelo con un único ganador. Son dos caballos de batalla de gama media intercambiables, con precios a un tercio de diferencia entre sí, ambos con un contexto de ~1M y cada uno con una pequeña ventaja reportada de la que carece el otro: Terra en precio, Flash en código y velocidad. Cuando los modelos están tan cerca, la cuestión no es a cuál coronar, sino cómo usar ambos.
Enruta entre ellos por tarea y coste, haz fallback de uno a otro para obtener redundancia de proveedores casi gratuita, y escala a un flagship solo para la parte difícil. Expresa todo esto como una directiva en un gateway detrás de una sola API compatible con OpenAI, y el próximo lanzamiento o bajada de precios de cualquiera de los proveedores se convertirá en un cambio de configuración en lugar de una migración. Así es como se obtiene lo mejor de ambos sin apostar tu arquitectura a ninguno.
Enruta entre Terra y Flash en lugar de elegir uno. Reserva una demo.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada




