


noviembre 20, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



Published: noviembre 20, 2026

¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
La mayoría de los equipos no tienen un problema con los modelos insignia. Tienen un problema con el modelo predeterminado. El modelo que responde a la petición media, el que gestiona el flujo constante de chat, resúmenes, programación diaria y respuestas con generación aumentada por recuperación (RAG), es donde realmente se acumula la factura, porque ahí es donde está el volumen. Gemini 3.6 Flash es interesante precisamente porque está diseñado para ese puesto predeterminado: lo suficientemente capaz como para que los usuarios no perciban una pérdida de calidad respecto a un modelo insignia, y lo suficientemente económico como para dirigirle todo el flujo de trabajo.
Este artículo analiza qué es Gemini 3.6 Flash (según lo reportado en noviembre de 2026), cómo se sitúa entre los modelos pequeños de bajo coste y los modelos insignia, cuándo elegirlo y cuándo no, y el patrón de pasarela que le permite convertirlo en su opción predeterminada sin dejar de escalar las peticiones que realmente requieren más potencia.
Una aclaración inicial sobre la precisión: a excepción de las cifras de Claude, las especificaciones mostradas a continuación proceden de informes de terceros y fuentes que a veces se contradicen. Tómelas como punto de partida y verifíquelas con las páginas oficiales de modelos y precios de Google antes de desarrollar sobre ellas. Las especificaciones de los modelos cambian con frecuencia.
¿Quiere enrutar la mayor parte del tráfico a un modelo de clase Flash y escalar solo las peticiones difíciles? Reserve una demostración.
Según se ha reportado, Gemini 3.6 Flash se lanzó alrededor de julio de 2026 como el modelo de nivel intermedio y optimizado para velocidad dentro de la línea Gemini 3.x de Google. El perfil reportado incluye:
El resumen en una línea: un modelo que le ofrece la mayor parte de la utilidad cotidiana de un modelo insignia, a un precio de nivel intermedio, con contexto de clase insignia y un rendimiento elevado. Esa combinación es exactamente lo que debe ser un modelo predeterminado.
Precios y benchmarks según lo reportado a fecha de noviembre de 2026; verifique con la página oficial de precios de cada proveedor antes de basarse en ellos — las especificaciones de los modelos cambian con frecuencia.
Si en su cuenta o región aún no aparece 3.6 Flash, la alternativa segura y disponible de forma general es Gemini 3.5 Flash. Considere la versión 3.6 como el objetivo y la 3.5 GA como el respaldo hasta que haya confirmado la 3.6 directamente.
La forma más útil de analizar Flash es como el peldaño intermedio de una escalera de tres niveles. Por debajo se encuentra el nivel de coste mínimo. Por encima se encuentran los modelos insignia. Cada peldaño tiene una función.
Nivel de coste mínimo (aproximadamente 0,10 $–0,25 $ de entrada). Claude Haiku 5.5 está confirmado desde 0,10 $ / 0,50 $. El reportado GPT-6 Luna se sitúa en 0,10 $ / 0,50 $ y Gemini 3.1 Flash-Lite cerca de 0,25 $ / 1,50 $. Están destinados a clasificación, extracción, enrutamiento y otras tareas cortas y sin ambigüedades. En precio de entrada, son aproximadamente 15 veces más baratos que Flash. No son tan capaces, ni están diseñados para serlo.
Modelo de trabajo de clase Flash (aproximadamente 1 $–2 $ de entrada). Gemini 3.6 Flash con un precio reportado de 1,50 $ / 7,50 $, junto a alternativas equivalentes como Claude Sonnet 5.5 (confirmado a 2 $ / 10 $) y el reportado GPT-6.1 Terra (1 $ / 5 $). Este es el nivel predeterminado: chat, resúmenes, respuestas RAG, programación habitual y cualquier tarea que requiera competencia real sin necesitar el razonamiento más profundo.
Nivel insignia (aproximadamente 2 $–10 $ de entrada, salida elevada). Gemini 3.1 Pro (reportado a 2 $ / 12 $), Claude Opus 5.5 (confirmado a 4 $ / 20 $), el reportado GPT-6 Astra (10 $ / 50 $). Estos justifican su precio únicamente en tareas complejas: programación basada en agentes a largo plazo, razonamiento profundo y análisis complejos.

La clave de esta escala es que cada peldaño difiere aproximadamente en un orden de magnitud tanto en precio como en capacidad, por lo que mover una petición al peldaño equivocado resulta costoso en una dirección o deficiente en calidad en la otra. Flash es el peldaño al que pertenece la mayor parte de su tráfico.
Flash es la opción predeterminada adecuada, pero no la solución para todo. A continuación se detalla el criterio de decisión.
Precios y benchmarks según lo reportado a fecha de noviembre de 2026; verifique con la página oficial de precios de cada proveedor antes de basarse en ellos — las especificaciones de los modelos cambian con frecuencia. Las cifras de Claude están confirmadas oficialmente.
Descubra cómo TrueFoundry utiliza modelos económicos por defecto y activa alternativas automáticamente. Reserve una demostración.
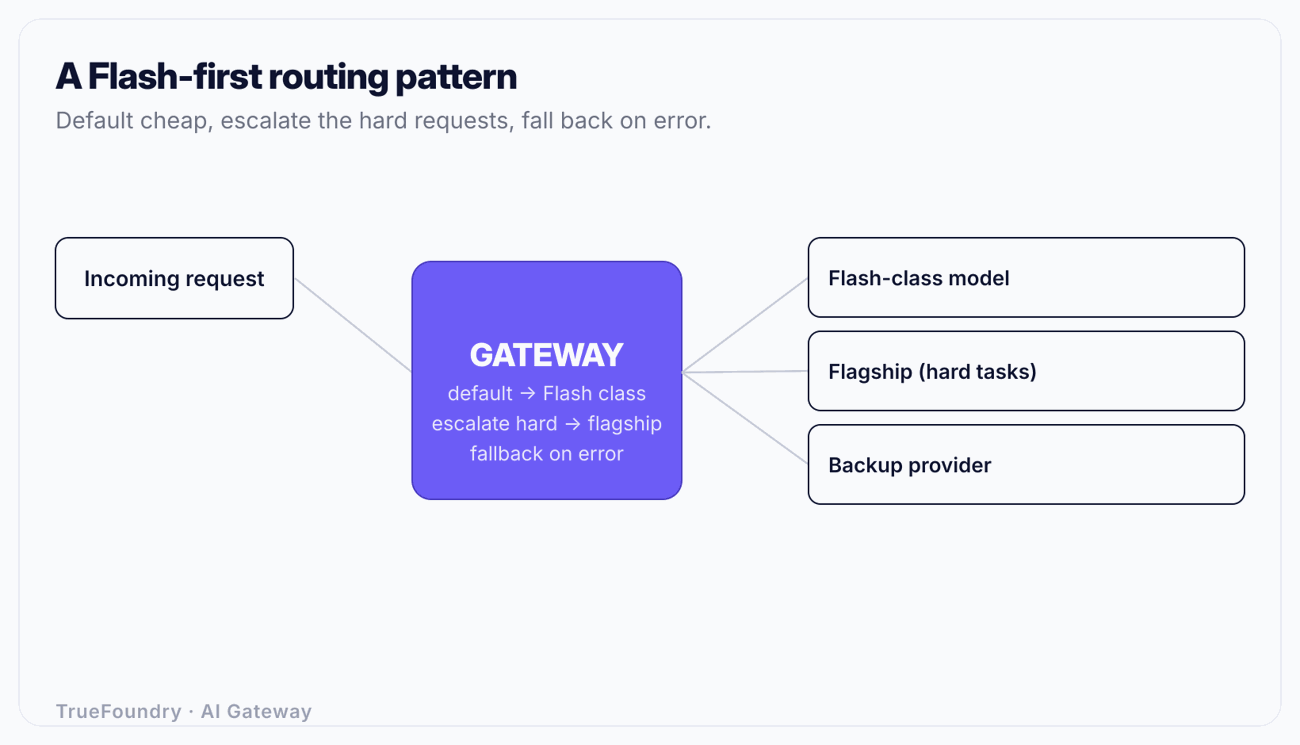
Saber que Flash debe ser su opción predeterminada no es suficiente. Necesita un mecanismo que dirija la mayor parte del tráfico a Flash, identifique las peticiones que requieren más capacidad, escale únicamente esas y no falle si Google sufre una interrupción temporal. Ese mecanismo es una pasarela de AI con una API unificada y compatible con OpenAI.
A continuación se describe el patrón en cuatro pasos.
1. Establezca Flash como la ruta predeterminada. Configure un alias de modelo (por ejemplo, default-chat) apuntando a Gemini 3.6 Flash en la configuración de la pasarela. Su aplicación llama a default-chat y nunca incluye "gemini-3.6-flash" codificado de forma rígida. Cuando quiera probar Sonnet 5.5 o Terra como opción predeterminada, solo tendrá que cambiar una línea de configuración y desviar un porcentaje del tráfico, sin necesidad de realizar un despliegue de la aplicación. Esto es la práctica de cost- and quality-aware model selection, y la idea subyacente es what an LLM router does.
2. Escale las peticiones complejas. Etiquete las peticiones que requieran mayor capacidad (una señal de complejidad desde su aplicación, un punto de enlace específico o un reintento tras una respuesta con baja confianza) para que la pasarela las enrute a un alias de modelo insignia. La mayor parte del tráfico se mantiene en Flash y solo la pequeña fracción compleja paga las tarifas de un modelo insignia. La regla de control es una directiva de enrutamiento, no ramas de código dispersas en sus servicios.
3. Use alternativas en caso de error. Configure Flash para que redirija las peticiones a un segundo proveedor cuando Google devuelva un error o supere el tiempo de espera. Una petición destinada a la clase Flash puede redirigirse a Claude Sonnet 5.5 o GPT-6.1 Terra. Los reintentos en la misma petición y las alternativas entre proveedores transforman una incidencia del servicio en un pequeño incremento de latencia en lugar de una caída del sistema. Consulte what is LLM fallback.
4. Aplique almacenamiento en caché y mida los resultados. El almacenamiento en caché exacto y semántico evita pagar a Flash por responder la misma pregunta dos veces; consulte semantic caching. Además, cada llamada queda registrada con sus tokens, latencia y coste etiquetados por usuario, equipo y modelo, lo que le permite demostrar que Flash asume el volumen principal mientras el modelo insignia solo procesa la fracción compleja. Consulte LLM observability tools.
Considere un producto que procesa 5M de peticiones al mes, principalmente de chat y RAG, con una pequeña proporción de razonamiento complejo. Suponga que la distribución es de un 75 % cotidiano (adecuado para Flash), un 20 % trivial (adecuado para el nivel de coste mínimo) y un 5 % complejo (adecuado para un modelo insignia), con un promedio de 800 tokens de entrada y 400 de salida.
Si todo se ejecuta en un modelo insignia a 2 $ / 12 $, pagará la tarifa de salida del modelo insignia en las 5M de peticiones, incluidas las 3,75M que Flash habría resuelto de la misma forma y la 1M que un modelo de 0,10 $ habría respondido de manera idéntica.
En su lugar, al enrutar por niveles:
La fracción trivial del 20 % reduce aproximadamente 15 veces su coste de entrada al pasar de Flash al nivel de coste mínimo. La fracción cotidiana del 75 % reduce su coste de salida desde la tarifa del modelo insignia (12 $) a la de Flash (7,50 $), lo que representa un descuento cercano al 40 % en el componente principal del gasto. La fracción compleja del 5 % mantiene el uso del modelo insignia. El efecto neto en la mayoría de combinaciones reales de tokens es una reducción de la factura superior a un tercio, sin pérdida de calidad en ningún nivel, ya que cada petición sigue siendo procesada por un modelo adecuado a sus necesidades. La única forma de confirmar esta cifra es midiendo el coste por nivel, motivo por el cual las herramientas de observabilidad y cost attribution son tan importantes como el propio enrutamiento.
Para evitar que el nivel insignia incremente el presupuesto de forma imprevista, defina un límite mediante token rate limiting and budgets: la pasarela devolverá un código HTTP 429 cuando un equipo o modelo supere su límite, evitando que las rutas de escalado disparen el gasto.
Gemini 3.6 Flash está diseñado para el segmento donde se concentra la mayor parte de su gasto: la petición media. Con tarifas reportadas de 1,50 $ / 7,50 $, una ventana de contexto de 1M de tokens y un elevado rendimiento, ofrece la mayor parte de la utilidad cotidiana de un modelo insignia sin su coste, situándose claramente por encima del nivel de coste mínimo que debe seguir gestionando las tareas triviales. El modelo mental adecuado es una escala, y Flash representa el peldaño al que pertenece la mayor parte del tráfico.
Establézcalo como su opción predeterminada en una pasarela, escale solo las peticiones complejas a un modelo insignia, recurra a un segundo proveedor cuando Google tenga incidencias y mida el coste por modelo para verificar que la distribución sea eficiente. De este modo, utilizar Gemini 3.6 Flash deja de ser una decisión aislada para convertirse en una directiva de enrutamiento que podrá ajustar en cuanto aparezca el siguiente modelo o la próxima bajada de precios.
Enrute el tráfico hacia el modelo más económico que ofrezca la calidad necesaria. Reserve una demostración.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada




