


noviembre 20, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



Published: noviembre 20, 2026

¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
«¿Cuál es el mejor LLM para programar?» es la pregunta equivocada, porque no tiene una respuesta estable. El modelo que escribe la función de 40 líneas más limpia no es el que quieres consumiendo tokens en una refactorización de 30 archivos, y el modelo que resuelve un error de concurrencia complejo resulta excesivo para autocompletar un método getter. Los benchmarks cambian cada pocas semanas. Un equipo que codifica un único modelo en sus herramientas en enero vuelve a debatir la decisión en abril.
La pregunta adecuada es: para esta categoría de tarea de programación, con este presupuesto, ¿a qué modelo enruto? ¿Y cómo mantengo el gasto y la seguridad bajo control cuando cien desarrolladores responden a esa pregunta de forma diferente? Esa es la pregunta que responde esta publicación. Repasamos los competidores según sus puntos fuertes reales, te ofrecemos un marco de decisión de tarea a modelo que perdura más allá de cualquier benchmark individual y, a continuación, cubrimos la parte que la mayoría de los equipos omiten: la capa de enrutamiento y gobernanza que convierte la elección del modelo en un valor de configuración en lugar de una reescritura de código.
Una nota de precisión de antemano. Los precios de Claude de Anthropic a continuación están verificados a fecha de noviembre de 2026. Las cifras de benchmarks de la competencia son datos reportados o agregados; indicamos su atribución y fecha, y se recomienda volver a verificarlas con cada proveedor antes de comprometer presupuesto.
¿Quieres seguimiento de costes por desarrollador y guardrails en todos los modelos de programación? Reserva una demo.
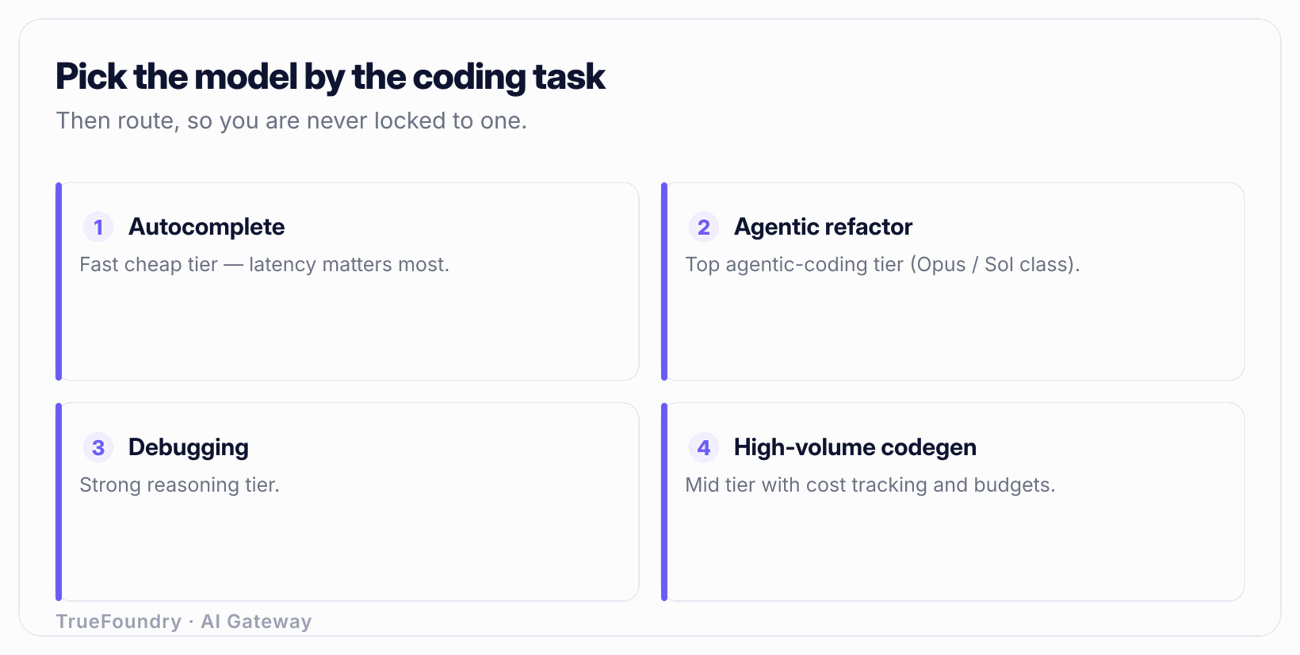
Antes de elegir un modelo, hay que definir el trabajo. La mayoría de las comparativas del «mejor LLM para programar» fallan porque promedian tareas con requisitos opuestos. Divide la programación en cuatro modalidades y la elección resultará mucho más clara.
Autocompletado / completado en línea. El modelo predice las siguientes líneas mientras escribes. La latencia lo es todo: cualquier valor superior a unos 300-500 ms interrumpe el flujo. El contexto es pequeño (el archivo actual y algunos vecinos). Realizas miles de estas llamadas por desarrollador al día, por lo que el coste unitario predomina. Buscas un modelo rápido y económico, no el más inteligente.
Refactorización multiarchivo basada en agentes. El modelo planifica, lee muchos archivos, edita varios, ejecuta pruebas e itera: un bucle que puede ejecutarse durante minutos y consumir cientos de miles de tokens en una sola tarea. Aquí es donde la profundidad de razonamiento, la coherencia en contextos largos y la capacidad de mantenerse en el plan a lo largo de muchos pasos marcan la diferencia. También es donde un modelo débil resulta más caro, porque consume tokens dando palos de ciego para luego entregarte un diff roto.
Depuración profunda. Un problema complejo: una condición de carrera, una fuga de memoria, un fallo intermitente que solo aparece bajo carga. El volumen es bajo, pero el valor de resolverlo correctamente es alto. Buscas la máxima calidad de razonamiento y estás dispuesto a pagarla por incidente.
Generación de código de alto volumen. Andamiaje, código repetitivo, plantillas de pruebas, scripts de migración, docstrings: grandes cantidades de código sencillo. Los requisitos de calidad son moderados; el rendimiento y el coste por generación predominan. Un modelo de gama media suele ganar en coste total de propiedad.
Estas cuatro modalidades raras veces se ajustan a un solo modelo. El mismo desarrollador, en la misma hora, necesita un modelo rápido y económico para completados, un modelo de razonamiento profundo para el error en el que se ha atascado y un modelo agéntico sólido para la refactorización que ha iniciado en segundo plano. Esa es la razón estructural por la que la estandarización en un solo modelo fracasa.
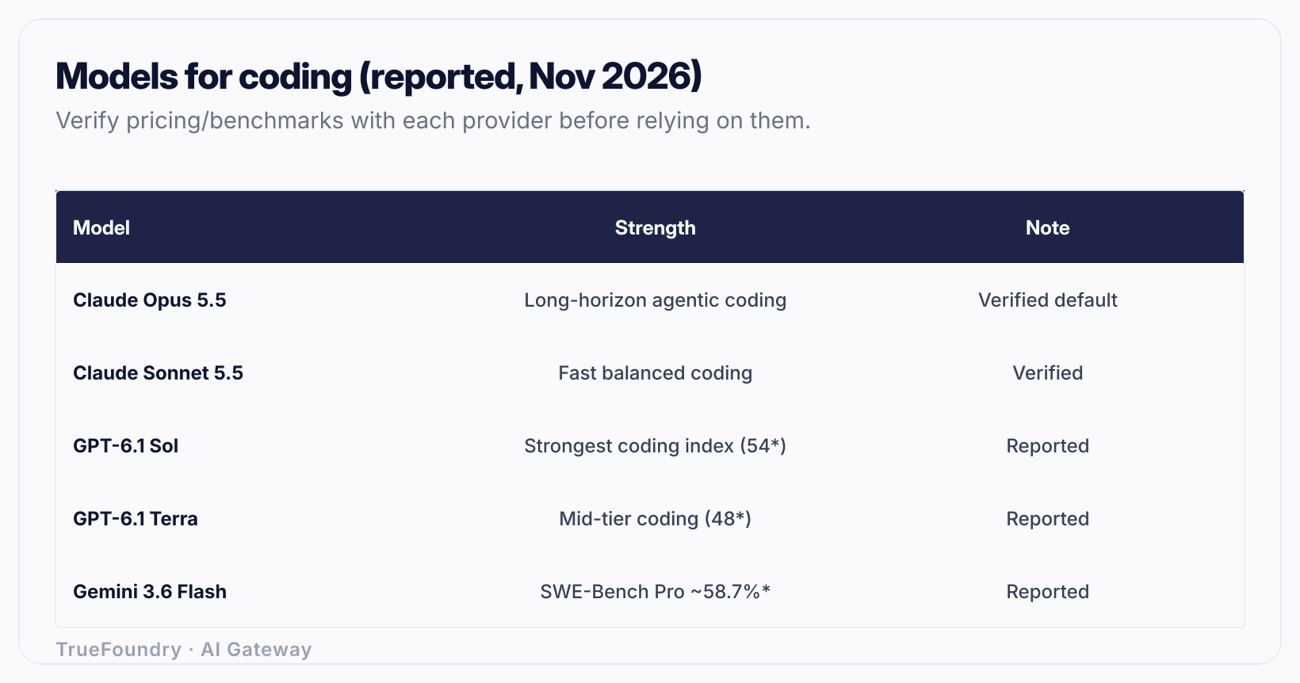
Este es el estado real de la situación a noviembre de 2026. Los precios de Claude están verificados; el resto de datos son reportados y deben comprobarse de nuevo.
La generación 5.5 de Claude se divide claramente entre las modalidades de tareas anteriores:
El patrón práctico es una estrategia de niveles dentro del propio ecosistema de Claude: Haiku para completados y volumen masivo, Sonnet para la mayoría del trabajo con agentes, Opus para refactorizaciones complejas y sesiones de depuración bloqueadas.
A fecha de noviembre de 2026, los informes sitúan a GPT-6.1 Sol en la cumbre de la capacidad de programación general, con un «Coding Index» agregador en torno a 54, y a GPT-6.1 Terra un paso por detrás, en aproximadamente 48. Sol se posiciona como modelo de frontera para programación; Terra como un nivel más rápido y económico. Trata los números del índice como orientativos: proceden de agregación de terceros, no de una suite de pruebas estandarizada única, y los precios y nombres de niveles propios de OpenAI deben confirmarse en su sitio web antes de asignar presupuesto.
Se informa que Gemini 3.6 Flash alcanza alrededor del 58,7 % en SWE-Bench Pro, un benchmark que mide correcciones reales de estilo pull-request en repositorios auténticos. Si esa cifra se mantiene, Flash resulta competitivo en tareas prácticas de ingeniería de software dentro de un nivel orientado a la velocidad y el coste. De nuevo: datos reportados a noviembre de 2026, verificar con Google.
SWE-Bench y los índices de programación miden la capacidad de un modelo para generar un parche correcto en problemas seleccionados. No miden cómo se comporta un modelo dentro de tu agente, en tu base de código, con tus herramientas y límites de contexto. Un modelo que obtiene dos puntos más en un benchmark público puede perder claramente en la práctica si es más lento, tiene una ventana de contexto efectiva menor o procesa peor tu lenguaje y framework. Utiliza los benchmarks para elaborar una lista corta y, a continuación, ejecuta tu propia evaluación en tareas representativas de tu trabajo real.
A continuación se muestra el panorama reportado en una tabla. Lee la nota de advertencia posterior antes de citar cualquiera de estas cifras.
Nota: Los precios de Claude están verificados a fecha de noviembre de 2026. Todas las cifras de la competencia son datos reportados o agregados por terceros a fecha de noviembre de 2026 y no son directamente comparables entre diferentes suites de prueba; vuelve a verificar las especificaciones, la disponibilidad y los precios con cada proveedor antes de basarte en ellos.
En lugar de elegir «el mejor modelo», define una opción por defecto por modalidad de tarea y una vía de escalado. Esta es la parte que permanece válida cuando la clasificación cambie el mes que viene.
La lógica: inicia cada tarea en el nivel más económico que garantice el éxito y escala únicamente ante una señal concreta (pruebas fallidas, diff demasiado grande, agente en bucle). Una refactorización que un modelo de gama media estropearía en diez iteraciones costosas resulta más económica en un modelo de gama superior que la resuelve en dos. Un completado que un modelo de gama superior ejecutaría a la perfección sigue siendo el lugar equivocado para gastar, porque realizas esa llamada diez mil veces al día.
Observa lo que este marco requiere a nivel operativo: la capacidad de enviar diferentes peticiones a distintos modelos según el tipo de tarea y las señales, sin reescribir la aplicación. Eso es el enrutamiento, y ahí es donde interviene un gateway. Consulta la selección de modelos basada en coste y calidad para ver cómo se codifica esta lógica, y qué es un LLM router para conocer su funcionamiento mecánico.
Descubre cómo TrueFoundry enruta el tráfico de programación y limita el gasto por desarrollador. Reserva una demo.
Imagina una organización de 200 desarrolladores. Algunos trabajan en Cursor, otros en Claude Code, unos pocos prefieren Copilot en VS Code y el equipo de datos llama a los modelos directamente desde notebooks. Cada herramienta utiliza diferentes modelos por defecto y cada desarrollador tiene sus preferencias. Incluso si impusieras un único modelo hoy, uno mejor saldrá al mercado en seis semanas y tus mejores ingenieros esquivarán la restricción.
Esto no representa una falta de disciplina. Es el estado final correcto. Tareas diferentes requieren modelos diferentes, herramientas distintas exponen modelos diversos y la frontera tecnológica avanza mensualmente. Luchar contra esa fragmentación es una batalla perdida. La estrategia ganadora consiste en dejar de intentar estandarizar el modelo y estandarizar, en su lugar, el punto de control situado delante de los modelos.
En la práctica, esto significa que cada agente de programación de la organización (Claude Code, Cursor, Copilot, scripts propios) apunta a un único endpoint compatible con OpenAI en lugar de a la API de cada proveedor directamente. Tras ese endpoint, tú decides el enrutamiento, observas cada petición y aplicas las políticas. El modelo se convierte en un valor de configuración. Cambiar Sonnet por un modelo más reciente, o añadir GPT-6.1 Sol como vía de escalado para depuración, es un cambio de configuración, no una migración de código en toda la infraestructura.
Un AI gateway se sitúa entre tus agentes de programación y los proveedores de modelos, exponiendo una API unificada compatible con OpenAI. Para la programación en concreto, destacan cuatro capacidades.
Atribución de costes por desarrollador, equipo y modelo. Los agentes de programación consumen tokens a un ritmo que sorprende a los departamentos financieros. Una refactorización mediante agentes puede consumir más de 300 000 tokens en una sola tarea. Sin atribución, recibes una única factura global del proveedor sin saber si el gasto corresponde a las refactorizaciones del equipo de plataforma o al bucle descontrolado de un desarrollador. El gateway etiqueta cada petición con usuario, equipo y modelo, lo que permite responder «quién ha gastado qué en qué modelo» hasta el nivel de petición individual. Esta es la base de la atribución de costes y presupuestos de equipos y del FinOps para AI en general.
Presupuestos y límites de tasa por desarrollador o equipo. Define un presupuesto mensual en dólares por equipo y un límite de tasa de peticiones por desarrollador. Al superar un límite, el gateway devuelve un código HTTP 429 en lugar de incrementar la factura silenciosamente. Esto evita que un agente desconfigurado en bucle genere un coste imprevisto de cinco cifras de la noche a la mañana. Los detalles mecánicos se explican en limitación de tasa de tokens y presupuestos.
Guardrails contra la filtración de secretos. Los agentes de programación leen tu código fuente. Este contiene credenciales integradas, nombres de host internos, datos de clientes en archivos de prueba y PII en datos de ensayo. Cualquiera de esos elementos puede enviarse a un proveedor de modelos dentro de un prompt. Un gateway puede escanear las peticiones salientes en busca de secretos y PII, bloqueándolos o redactándolos antes de que salgan de tu red. Para una organización regulada, esto marca a menudo la diferencia entre un uso «aprobado» y uno «prohibido». Consulta AI guardrails para ver los tipos de detección.
Auditoría y observabilidad. Un registro único de cada petición: quién, qué modelo, cuántos tokens, latencia, coste y resultado de guardrails. Cuando el equipo de seguridad pregunte si se ha filtrado código a un modelo externo el trimestre pasado, dispondrás de una respuesta precisa. Combina el registro del gateway con tus herramientas de observabilidad de LLM para el seguimiento de la latencia y la calidad a lo largo del tiempo.
El AI gateway de TrueFoundry ofrece exactamente este plano de control: una API unificada compatible con OpenAI con enrutamiento por latencia/peso/prioridad, conmutación por error automática y reintentos en la petición, almacenamiento en caché exacto y semántico, presupuestos y límites de tasa por usuario/equipo/modelo, observabilidad completa por petición y guardrails para PII/secretos/inyección de prompts. Se despliega como SaaS, en tu VPC, on-premise o en entornos aislados (air-gapped), garantizando que el plano de datos que procesa tu código fuente permanezca dentro de tu red.
Analicemos un caso concreto. Tres desarrolladores, una semana, trabajos diferentes:
Tres desarrolladores, tres modalidades de tareas, tres niveles y un gasto semanal combinado cercano a 40 $, donde la refactorización profunda del Desarrollador C cuesta aproximadamente 14 veces más que los completados del Desarrollador A. Ahora imagina 200 desarrolladores sin atribución: recibes una sola factura y no puedes distinguir el trabajo productivo del gasto descontrolado. Con el gateway, observas que la refactorización del Desarrollador C ha sido costosa pero rentable, los completados del Desarrollador A son eficientes y, si el agente de un cuarto desarrollador entra en bucle a las 2 a. m., el límite de presupuesto lo detiene con un código 429 antes de que suponga un problema.
Las cifras anteriores utilizan precios verificados de Claude y valores redondeados a modo de ilustración; tus volúmenes reales de tokens variarán. Lo esencial es la estructura: la modalidad de la tarea determina el nivel, el nivel determina el coste y la atribución transforma un total indeterminado en una partida presupuestaria gestionada.
Perseguir la tabla de clasificación. Los equipos vuelven a seleccionar su «modelo único de programación» cada vez que se actualiza un benchmark, modificando las herramientas en cada ocasión. La diferencia en los benchmarks suele ser menor que el coste de dicha rotación. Define opciones por defecto por modalidad de tarea, enruta y deja que el gateway absorba los cambios de modelo mediante configuración.
Enrutar todo al modelo superior. Utilizar Opus 5.5 o GPT-6.1 Sol para autocompletado parece seguro, pero resulta muy costoso: estás pagando precios de nivel frontera en las llamadas de mayor volumen y menor valor agregado. Adapta el nivel a la tarea. El modelo más económico que garantice el éxito es el adecuado.
Sin atribución de costes hasta que llega la factura. Muchos equipos descubren el gasto en agentes de programación solo cuando finanzas pide explicaciones. Para entonces no es posible identificar qué equipo o comportamiento lo ha generado. La atribución debe estar implantada antes de escalar licencias, no después.
Ignorar la salida de secretos y PII desde el código. El mayor riesgo de los agentes de programación no es el código incorrecto, sino la filtración de código válido. Los archivos de código fuente contienen credenciales y datos de clientes, y los agentes los envían a proveedores de modelos externos. Sin un guardrail de salida, se están exponiendo secretos de los que solo te percatarás en una revisión de incidentes.
Tratar la elección del modelo como una responsabilidad de la aplicación. Codificar nombres de modelos y API keys en cada herramienta y servicio implica que cada cambio de modelo requiere un despliegue. Sitúa la elección tras un endpoint de gateway y la selección del modelo pasará a ser una decisión de política, definida una vez y aplicada en todas partes.
El «mejor LLM para programar» es un objetivo en constante evolución, y tratar de alcanzarlo continuamente es ineficiente. La estrategia duradera consiste en dejar de elegir un solo modelo y comenzar a gestionar una cartera: un nivel rápido y económico para completados y tareas masivas, un nivel equilibrado para el trabajo diario con agentes y un nivel de frontera para refactorizaciones complejas y depuración profunda, con una señal clara de escalado entre ellos. La división Opus/Sonnet/Haiku de Claude se adapta casi de forma directa a este esquema hoy en día, y las cifras reportadas de GPT-6.1 y Gemini ofrecen opciones de escalado y comparativa que puedes incorporar mediante configuración.
Lo que permite gobernar esa cartera es la capa situada delante de ella. Enruta cada agente de programación a través de un único AI gateway y la elección del modelo se convertirá en un valor de configuración, el coste será atribuible por desarrollador y equipo, los presupuestos detendrán el gasto descontrolado mediante códigos 429 y los guardrails evitarán que los secretos de tu código fuente se filtren a un proveedor. Así es como te mantienes en la vanguardia sin perder el control del gasto ni del alcance de los riesgos.
Gobierna el uso de modelos de tus agentes de programación desde un único gateway. Reserva una demo.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada




