



October 10, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.



Published: October 10, 2026
Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Zwei Zahlen bestimmen den Großteil der Diskussionen über Claude Sonnet 4.5 und GPT-5. Anthropic berechnet für Claude Sonnet 4.5 3 $ pro Million Eingabe-Token und 15 $ pro Million Ausgabe-Token. OpenAI berechnet für GPT-5 1,25 $ bzw. 10 $. Bei den offiziellen Preislisten hat GPT-5 die Nase vorn.
Preislisten sagen in der Praxis wenig aus. Ein Programmier-Agent, der eine fehlgeschlagene Aufgabe zweimal neu ausführt, hat die Token-Einsparungen bereits wieder aufgebraucht. Eine Zusammenfassungs-Pipeline mit einem stabilen Präfix von 40.000 Token verhält sich anders als ein Agent, der den Kontext bei jedem Durchgang neu schreibt.
Beide Anbieter sind zudem über diese Versionen hinausgegangen. OpenAI bezeichnet GPT-5 als sein bisheriges Reasoning-Modell und verweist Entwickler auf GPT-5.6. Anthropic positioniert neuere Claude-Modelle für viele Entwicklungsanforderungen mittlerweile über Claude Sonnet 4.5. Teams, die einen der Modellnamen fest im Code verankern, schaffen sich frühzeitig Migrationsschulden.
Beide Modelle zielen auf anspruchsvolle generative KI-Workloads ab, auch wenn ihre Schwerpunkte unterschiedlich gesetzt sind. Die Analyse der Positionierung der jeweiligen Anbieter ist aufschlussreicher als jede einzelne Bestenliste. Die praktische Entscheidung zwischen Claude Sonnet 4.5 und GPT-5 beginnt mit dem primären Anwendungsfall.
Anthropic hat Claude Sonnet 4.5 für anspruchsvolle Programmierarbeiten, langlebige Agenten und Computer-Nutzung positioniert. Die Ankündigung beschreibt es als wichtiges Release für reale Agenten, wobei die Preise bei den gleichen 3 $ und 15 $ wie bei Claude Sonnet 4 liegen. Die API-Modell-ID lautet `claude-sonnet-4-5-20250929` – ein fixierter Snapshot und kein sich verändernder Zeiger.
GPT-5 ist das Reasoning-Modell von OpenAI für Programmierung und agentische Aufgaben über verschiedene Bereiche hinweg, verfügbar über Chat Completions und die Responses API. Der Snapshot lautet `gpt-5-2025-08-07`. Das Modell akzeptiert Text- und Bildeingaben und gibt Text aus, unterstützt Reasoning-Token und bietet einen `reasoning.effort`-Parameter mit den Optionen `minimal`, `low`, `medium` und `high`.
Ein praktischer Unterschied zeigt sich sofort. Laut der Modelldokumentation von OpenAI unterstützt GPT-5 kein Fine-Tuning und keine vorhergesagten Ausgaben. Claude Sonnet 4.5 bietet agentische Kontrollmöglichkeiten, einschließlich verschachteltem Denken (interleaved thinking) über einen Beta-Header für tool-gestützte Schlussfolgerungen.
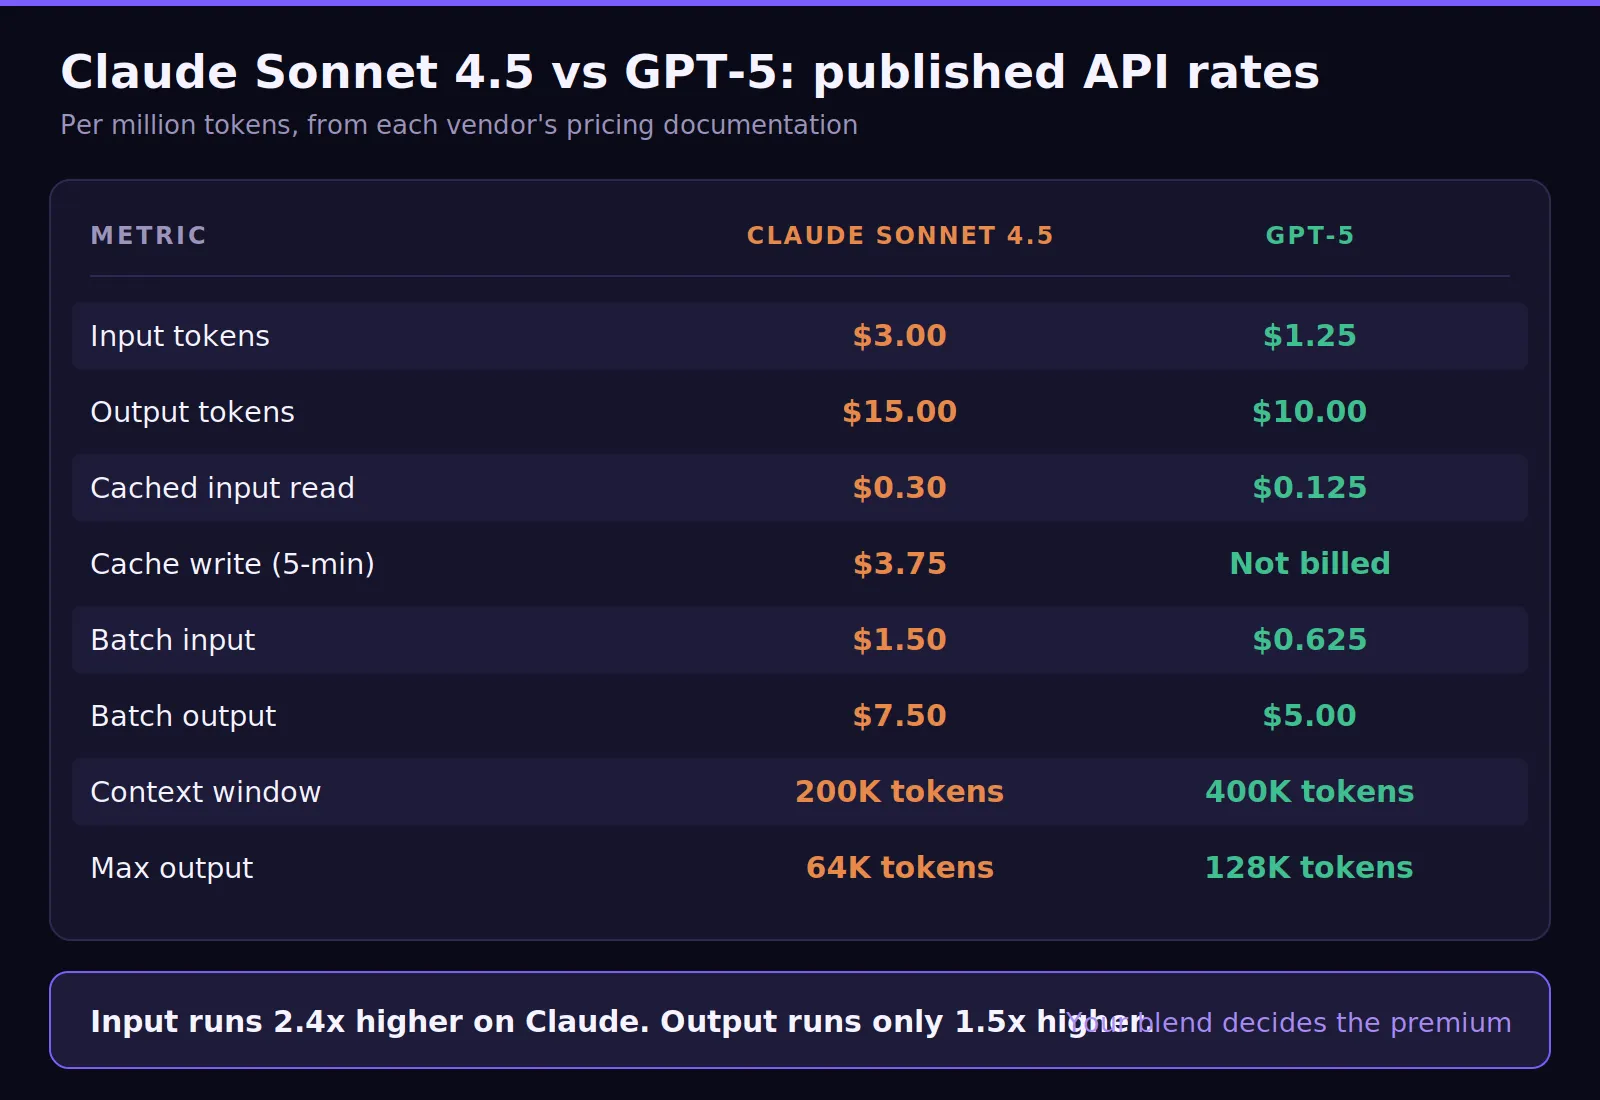
Bei der Preisgestaltung unterscheiden sich die beiden Modelle am deutlichsten. Alle unten aufgeführten Raten stammen aus den offiziellen Preisdokumentationen der Anbieter. Käufer sollten die Kosten dennoch nach Workload modellieren, da Eingabekosten, Ausgabelänge, Cache-Verhalten und Wiederholungsversuche die endgültige Rechnung beeinflussen.
Zwei Verhältnisse sind wichtiger als die absoluten Zahlen. Die Eingabe ist bei Claude Sonnet 4.5 2,4-mal teurer. Die Ausgabe ist 1,5-mal teurer. Da diese Unterschiede variieren, hängt der gemischte Aufschlag von der Anzahl der Token ab, die Ihr Workload verbraucht und generiert.
Nehmen wir 1.000 Anfragen mit jeweils 30.000 Eingabe-Token und 2.000 Ausgabe-Token ohne Caching. Claude Sonnet 4.5 kostet 90,00 $ für die Eingabe und 30,00 $ für die Ausgabe. GPT-5 kostet 37,50 $ für die Eingabe und 20,00 $ für die Ausgabe.
Dies führt zu einem Vergleich von 120,00 $ gegenüber 57,50 $. In diesem Beispiel ist Claude 2,09-mal so teuer. Der Kostenvorteil von GPT-5 ist bei der reinen Token-Ökonomie deutlich, insbesondere bei Workflows mit hohem Volumen für Support, Klassifizierung und Content-Management.
Verarbeiten Sie nun 90 % dieser Eingaben aus dem Cache. Claude Sonnet 4.5 sinkt auf 8,10 $ für zwischengespeicherte Lesevorgänge, 9,00 $ für neue Eingaben und 30,00 $ für die Ausgabe. GPT-5 liegt bei 27,13 $. Der Aufschlag verringert sich, da Caching die Eingabeseite reduziert.
Die Cache-Abrechnung ist eine Falle, die man kennen sollte. Anthropic berechnet Cache-Schreibvorgänge mit einer Dauer von fünf Minuten zum 1,25-fachen der Basiseingabe. Die veröffentlichte Preisliste von OpenAI für GPT-5 führt keine separate Gebühr für Cache-Schreibvorgänge auf. Die Preise für Antwort-Token und Cache-Churn können daher die Entscheidung beeinflussen.
Die Kosten beantworten eine Frage. Ob ein KI-Modell die Aufgabe lange genug im Arbeitsspeicher halten kann, um sie abzuschließen, beantwortet eine schwierigere. Beim Vergleich von Claude Sonnet 4.5 und GPT-5 verdienen das Kontextfenster, die Ausgabelimits und die Reasoning-Kontrollen eine genaue Betrachtung.
Die Kontextlücke wird leicht unterschätzt. GPT-5 akzeptiert die doppelte Eingabemenge und gibt die doppelte maximale Ausgabemenge aus. Das ist wichtig für große Refactorings, umfangreiche Textseiten, komplexe Workflows und lange Agenten-Traces, die als eine einzige große Aufgabe anfallen.
Sonnet 4.5 bietet eine Funktion, die GPT-5 fehlt. Das Kontextbewusstsein von Anthropic integriert das verbleibende Budget des Modells direkt in die Anfrage, und zwar als `<budget:token_budget>200000</budget:token_budget>` im System-Prompt sowie als fortlaufende `<system_warning>` nach jedem Tool-Aufruf. Die Modellplanung basiert somit auf der tatsächlich verfügbaren Kapazität statt auf Schätzungen.
Claude Sonnet 4.5 unterstützt zudem über einen Beta-Header das verschachtelte Denken (interleaved thinking) bei der Tool-Nutzung. Dies ist hilfreich bei komplexen logischen Aufgaben, tiefergehenden Analysen, wissenschaftlichen Fragestellungen, Finanzanalysen, mathematischen Berechnungen sowie bei agentenbasierten Geschäftsprozessen, bei denen die Ergebnisse eines Tools den nächsten Schritt beeinflussen.
GPT-5 unterstützt verschiedene Stufen des logischen Aufwands durch einen Standardmodus und erweiterte Reasoning-Einstellungen. Dies gibt Teams eine weitere Möglichkeit, Latenz, Analysequalität und Kosteneffizienz zu optimieren. Welches Modell das richtige ist, hängt letztlich von der gemessenen Qualität innerhalb der jeweiligen Arbeitslast ab.
Benchmarks können bei einer ersten Vorauswahl helfen, sollten jedoch keine internen Tests ersetzen. Artificial Analysis veröffentlicht einen Intelligence Index und Modellvergleiche, während andere Quellen ART-Performance, Analyseintelligenz und spezialisierte Reasoning-Scores abdecken. Betrachten Sie diese als erste Orientierungshilfe, nicht als Entscheidungsgrundlage für die Beschaffung.
Die Positionierung von Anthropic konzentriert sich auf Softwareentwicklung, Tool-Nutzung und langlebige agentenbasierte Aufgaben. Das macht Claude Sonnet 4.5 relevant für agentengestützte Programmierung, Code-Generierung, Code-Reviews und autonome Abläufe. Das Modell ist besonders dann interessant, wenn die hohe Qualität die Anzahl der Review-Zyklen reduziert.
Betrachten Sie die Modellqualität ohnehin als arbeitslastspezifisch. Coding-Benchmarks messen öffentliche Aufgaben, während Ihre Entwickler in privaten Repositories arbeiten. Repository-Konventionen, Abhängigkeitsgraphen, Review-Kultur und Teststrukturen bestimmen, ob Claude Sonnet eine überlegene Leistung erbringt.
Testen Sie beide Modelle mit denselben 20 internen Tickets und bewerten Sie diese anhand eines festen Rasters. Zählen Sie fehlgeschlagene Versuche, Folgeanfragen, Tool-Fehler und akzeptierte Pull Requests. Ein Modell, das pro Aufruf teurer ist, kann sich dennoch durch weniger notwendige Korrekturschleifen auszahlen.
Der direkteste Vergleich ist selten ein universelles Leaderboard-Ergebnis. Ein Team stellt möglicherweise einen klaren Vorsprung für Claude in einem Repository fest, während GPT-5 in einem anderen besser abschneidet. Deshalb sollte die Antwort auf die Frage „Claude Sonnet 4.5 vs. GPT-5“ aus realen Tests mit Ihren eigenen Arbeitslasten kommen.
Die veröffentlichten Token-Preise von GPT-5 liegen bei Input, Output, Cache-Reads und Batch-Nutzung unter denen von Claude Sonnet 4.5. Das verändert die Kalkulation für produktive Arbeitslasten mit hohem Volumen. Support-Automatisierung, Klassifizierung, Qualitätsprüfungen natürlicher Sprache und interne Tools tendieren daher oft zu GPT-5.
Das größere Kontextfenster von 400.000 Token unterstützt eine weitere Klasse von Arbeitslasten. Pipelines zur Dokumentenverarbeitung lassen sich so oft in einem einzigen Aufruf abwickeln, anstatt Antworten stückeln und zusammenfügen zu müssen. Weniger Fragmente bedeuten weniger Zusammenführungen, weniger Fehler und weniger operativen Aufwand.
Die Kosten allein sollten nicht den Ausschlag geben. Output-Qualität, Wiederholungsverhalten, Cache-Trefferrate und menschlicher Prüfaufwand beeinflussen die Gesamtausgaben. Der Wissensstichtag von GPT-5 liegt zudem hinter dem von Claude Sonnet 4.5, was bei neueren Frameworks, APIs und Unternehmens-Workflows eine Rolle spielen kann.
GPT-5 eignet sich möglicherweise auch besser für ein allgemeines Publikum und breite KI-Plattform-Anwendungsfälle. Es kann ähnliche Inhalte für Support, Zusammenfassungen, Analysen und CMS-Workflows unterstützen. Für die Anbindung an die Google-Suche könnten Gemini 3 Pro, Cosmic AI oder ein anderes spezialisiertes Modell einen separaten Vergleich wert sein.
Die meisten Teams betrachten die Entscheidung als eine einzige, feste Wahl. Das ist meist der falsche Ansatz. Die bessere Strategie ist eine Aufteilung nach Arbeitslast und die Frage, ob ein einziges Modell wirklich alles abdecken muss. Das macht den Vergleich zwischen GPT-5 und Claude Sonnet 4.5 operativ deutlich nützlicher.
Wählen Sie Claude Sonnet 4.5, wenn:
Wählen Sie GPT-5, wenn:
Wählen Sie eine verwaltete Modellebene, wenn:
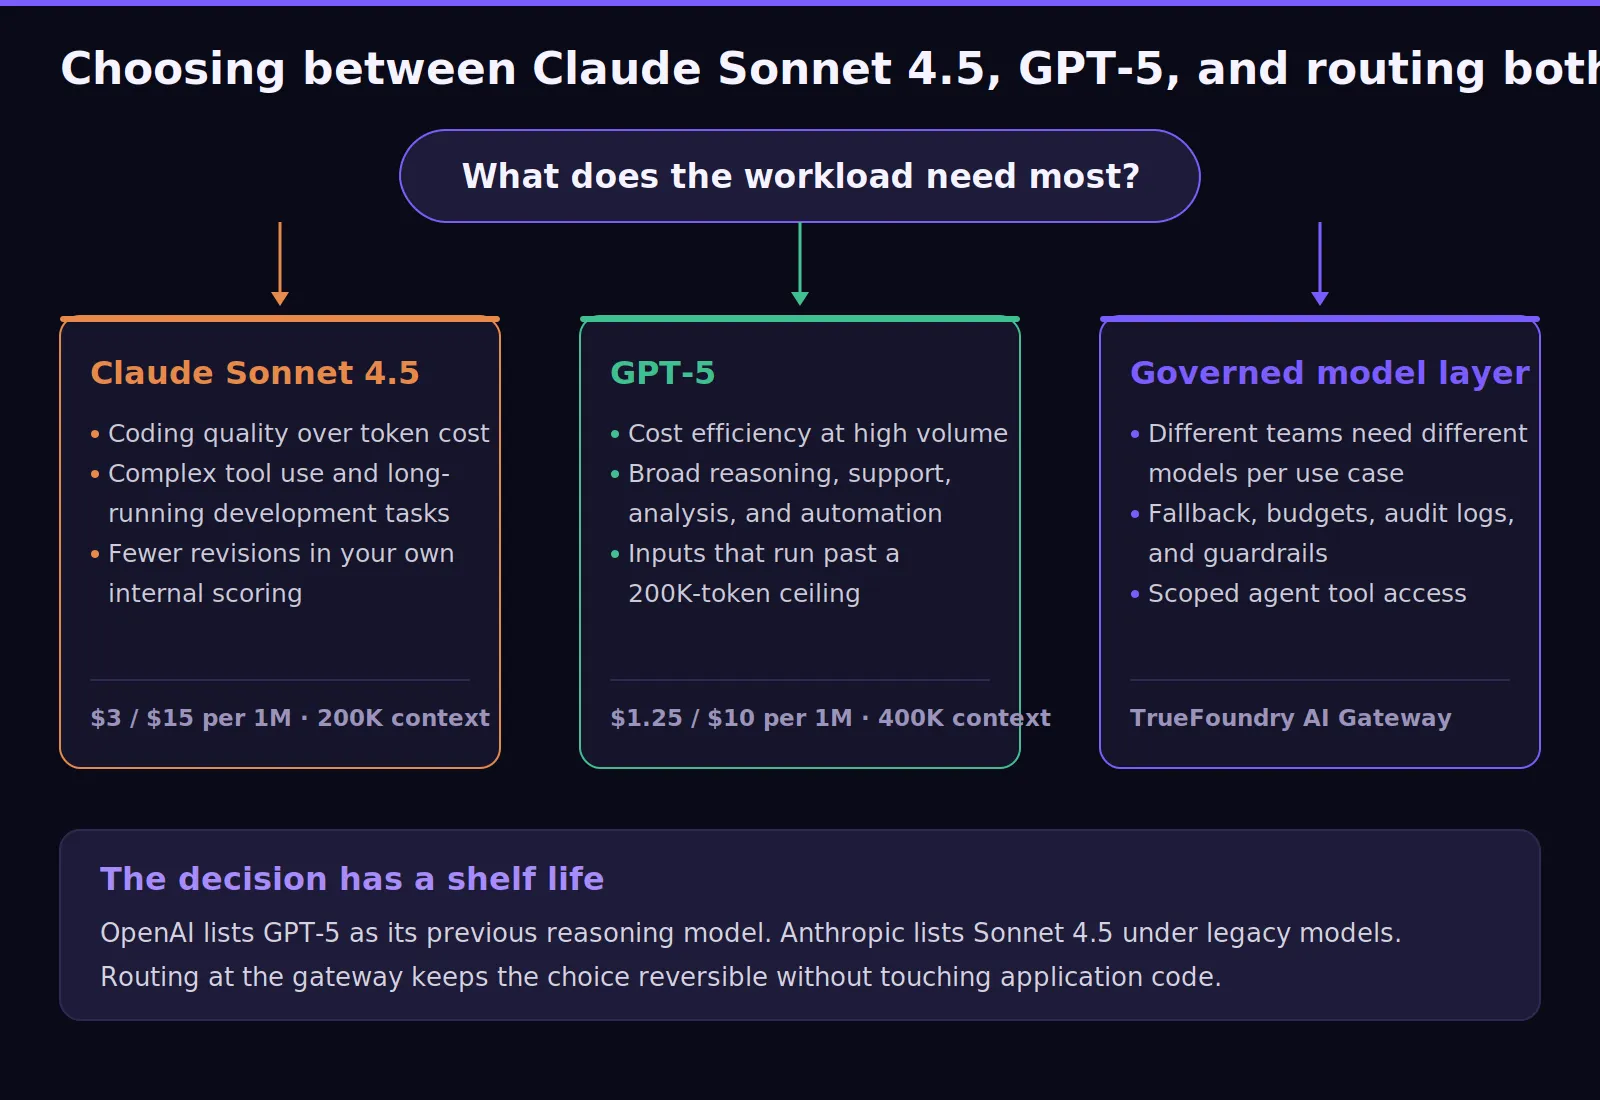
Der obige Vergleich hat nur eine begrenzte Gültigkeitsdauer. GPT-5 trägt bereits die Bezeichnung eines Vorgängermodells. Anthropic hat neuere Modelle als Claude Sonnet 4.5 veröffentlicht. Die KI-Landschaft entwickelt sich schnell, und TrueFoundry hält Modellwechsel aus dem Anwendungscode heraus.
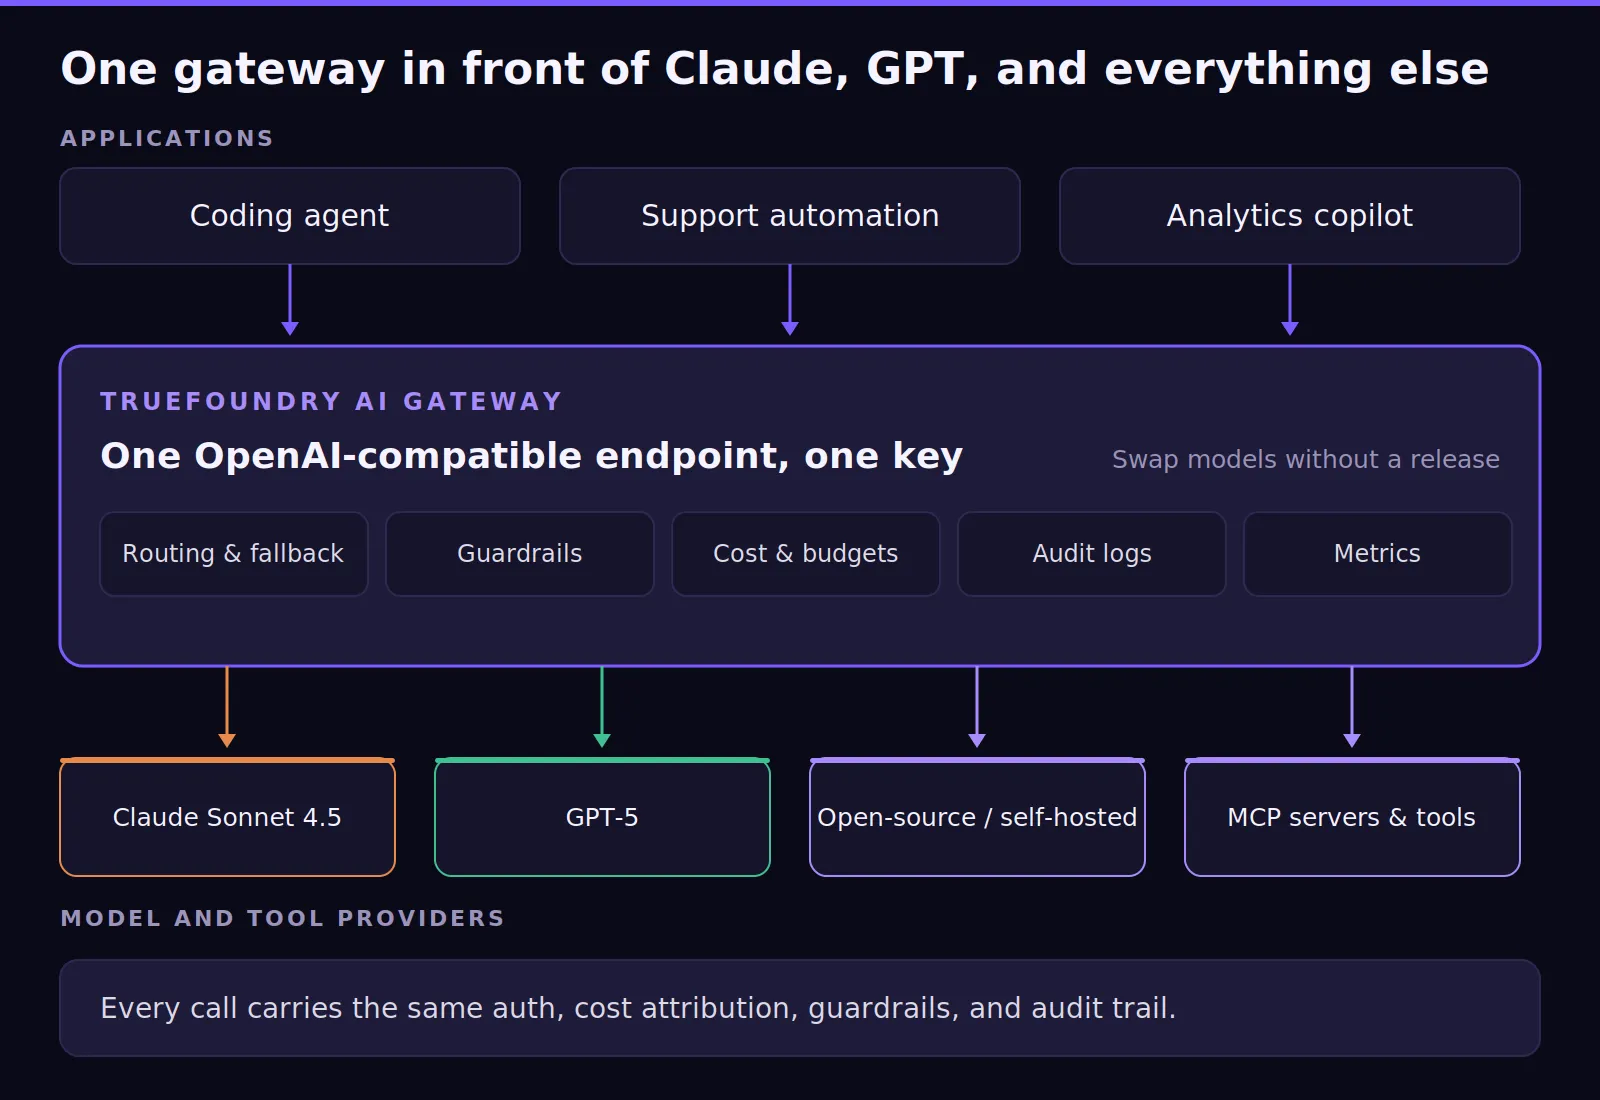
Teams können Claude Sonnet 4.5 und GPT-5 hinsichtlich Qualität, Kosten, Latenz und Argumentationstiefe abwägen. Die Governance-Ebene bleibt dabei unabhängig von beiden Anbietern. Verschiedene Gruppen können so unterschiedliche Modelle für Programmierung, Support-Automatisierung, Analysen und interne Copiloten einsetzen.
Das AI Gateway fungiert als Schnittstelle zwischen Anwendungen und Modellanbietern. Es stellt einen einzigen OpenAI-kompatiblen Endpunkt bereit und übernimmt dabei Authentifizierung, Protokollierung, Sicherheitsvorgaben und Kostenkontrolle. Dieselbe Ebene kann Claude, GPT, Open-Source- und selbst gehostete Modelle steuern.
from openai import OpenAI

client = OpenAI(
    api_key="your-truefoundry-pat",
    base_url="https://{your-gateway-host}/api/llm/api/inference/openai",
)

# Same client, same call shape, different backend model.
for model in ["anthropic-main/claude-sonnet-4-5", "openai-main/gpt-5"]:
    response = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": "Refactor this handler for idempotency."}],
        extra_headers={"X-TFY-METADATA": '{"team":"platform","environment":"staging"}'},
    )
    print(model, response.usage)
LLM-Gateway für Multi-Modell-Routing. Das LLM-Gateway leitet Anfragen über eine einzige Schnittstelle an verschiedene Anbieter weiter. So kann GPT-5 umfangreiche Zusammenfassungen übernehmen, während Sonnet 4.5 für Coding- und Agenten-Aufgaben zuständig ist. Ein virtuelles Modell verleiht beiden einen stabilen Namen und macht den Wechsel der Zielmodelle zu einer reinen Konfigurationsänderung statt eines neuen Releases.
routing_config:
  type: priority-based-routing
  load_balance_targets:
    - target: anthropic-main/claude-sonnet-4-5
      priority: 0
      retry_config:
        attempts: 2
        delay: 100
        on_status_codes: ["429", "500", "503"]
      fallback_status_codes: ["429", "500", "502", "503"]
    - target: openai-main/gpt-5
      priority: 1
      fallback_candidate: true
Regeln werden in der festgelegten Reihenfolge ausgewertet, wobei der erste Treffer zählt. Die `retry_config` pro Zielmodell fängt kurzzeitige Ausfälle ab, während `fallback_status_codes` die Anfrage weiterleitet, wenn Wiederholungsversuche voraussichtlich nicht helfen. TrueFoundry erkennt zudem ein fehlerhaftes Ziel anhand von Anfragen, Token-Verbrauch und Fehlerraten pro Minute und nimmt es vorübergehend aus dem Betrieb.
MCP-Gateway für sicheren Tool-Zugriff. Das MCP-Gateway regelt, wie Anwendungen und Agenten auf Tools, APIs, Datenbanken und Geschäftssysteme zugreifen. Ein eingeschränkter Zugriff ist entscheidend, sobald ein KI-Agent auf Basis von Claude oder GPT Datensätze abrufen, Dienste aufrufen oder Workflows auslösen kann.
Agent-Gateway für Governance auf Workflow-Ebene. Das Agent-Gateway ergänzt die Governance auf Workflow-Ebene für autonome Aufgaben. Es hilft bei der Steuerung von mehrstufigen Abläufen, Ausführungslimits, der Kommunikation zwischen Agenten und sitzungsbezogenem Tracing. Endlosschleifen und unsichere Aktionen werden so zu nachvollziehbaren Telemetriedaten statt zu bösen Überraschungen am Monatsende.
Sicherheitsvorgaben, Kostenkontrolle und Audit-Protokolle. Sie machen den Einsatz von GPT-5 und Claude Sonnet 4.5 zu einer kontrollierten Entscheidung in der Produktion. Das Metrik-Dashboard liefert Daten zu Latenz, Zeit bis zum ersten Token, Inferenzkosten, Eingabe- und Ausgabetoken, Cache-Metriken sowie Blockierungen durch Budgetlimits.
Diese Funktion macht aus einem Vergleich eine fundierte operative Entscheidung statt einer einmaligen Einschätzung. 10 % des Traffics auf ein anderes Modell umzuleiten und die Kosten pro gelöster Aufgabe zu messen, ist aussagekräftiger als das bloße Lesen von Preislisten. Zudem hilft es Teams dabei, informierte Entscheidungen zu treffen.
Bleiben Sie flexibel bei der Modellwahl, während die Governance in der Produktion konsistent bleibt. Demo buchen und erfahren Sie, wie TrueFoundry Claude, GPT, Open-Source- und eigene Modelle über ein zentral gesteuertes AI Gateway bereitstellt.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet




















