



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.


De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
AI in 2026 betekent dat u meerdere modellen van verschillende providers gebruikt, elk met eigen prijzen, latentieprofielen, snelheidslimieten en foutmodi. De teams die het snelst vooruitgaan, verbinden zich niet langer rechtstreeks met modellen; ze laten alles via een LLM-gateway verlopen. Eén laag die providers verenigt, naleving afdwingt, kosten beheerst en u de waarneembaarheid biedt die nodig is om echt te begrijpen wat uw AI-stack doet.
De gateway die u kiest, bepaalt hoe snel u oplevert, hoe betrouwbaar uw systemen zijn en hoeveel u uiteindelijk betaalt. Deze gids helpt u de juiste keuze te maken.
Bouwen met AI draait niet langer om het kiezen van het ene beste model. Verschillende providers blinken uit op verschillende gebieden, prijzen veranderen voortdurend en geen enkele LLM domineert elke toepassing. Wat vandaag werkt voor chat, schiet morgen misschien tekort voor codegeneratie of redeneren.
Een LLM-gateway fungeert als een slimme tussenlaag tussen uw toepassingen en de snel veranderende wereld van modelproviders. In plaats van uw systeem rechtstreeks te koppelen aan elke API, met aangepaste integraties en vendor lock-in tot gevolg, verbindt u met één gateway en profiteert u van:
Naarmate de adoptie van AI versnelt, zullen de echte winnaars niet alleen degenen zijn die LLM's gebruiken, maar degenen die ze verstandig beheren. De gateway is de plek waar dat beheer plaatsvindt.
Niet alle gateways zijn gelijk. De juiste hangt af van de omvang van uw team, uw werkstroom en uw nalevingsvereisten. Dit is het evaluatiekader dat er toe doet:
Prestaties: Een goede gateway moet verzoeken intelligent routeren, met een juiste balans tussen snelheid, betrouwbaarheid en kosten. Zoek naar minder dan 10 ms p95-overhead op time-to-first-token. Hogere latentie stapelt zich op bij multi-step agentic workflows.
Flexibiliteit: Uw gateway moet meerdere providers, open API's en eenvoudig wisselen ondersteunen. Lock-in doet het doel teniet.
Waarneembaarheid: Duidelijke kosten- en gebruiksinzichten, dashboards en anomaliedetectie. Zonder deze functies werkt u in het blind.
Beveiliging: Of het nu gaat om SOC2, AVG (GDPR) of versleuteling op ondernemingsniveau, de gateway moet een consistent beleid afdwingen. Dit is vooral belangrijk voor LLM-implementaties in gereguleerde sectoren.
Belangrijkste metrieken voor het evalueren van een gateway
| Criterium | Wat moet u evalueren? | Prioriteit | TrueFoundry |
|---|---|---|---|
| Latentie | Voegt <10 ms p95-overhead toe voor time-to-first-token? | Noodzakelijk | ✅ Ondersteund |
| Dataresidentie | Bewaart logs binnen uw regio (EU/VS)? | Afhankelijk van toepassing | ✅ Ondersteund |
| Op latentie gebaseerde routing | Routeert automatisch om op basis van realtime latentie/storingen? | Noodzakelijk | ✅ Ondersteund |
| Sleutelrotatie & -intrekking | Sleutels roteren of intrekken zonder downtime? | Noodzakelijk | ✅ Ondersteund |
| Sleutelrotatie & -intrekking | Sleutels roteren of intrekken zonder downtime? | Noodzakelijk | ✅ Ondersteund |
| Sleutelrotatie & -intrekking | Sleutels roteren of intrekken zonder downtime? | Noodzakelijk | ✅ Ondersteund |
| Sleutelrotatie & -intrekking | Sleutels roteren of intrekken zonder downtime? | Noodzakelijk | ✅ Ondersteund |
| Sleutelrotatie & -intrekking | Sleutels roteren of intrekken zonder downtime? | Noodzakelijk | ✅ Ondersteund |

De markt voor LLM-gateways groeit snel. Nieuwe spelers treden toe, gevestigde namen ontwikkelen zich door en iedereen belooft de slimste laag te zijn tussen u en de wereld van modellen. Maar ze leveren niet allemaal dezelfde waarde. Sommige richten zich op snelheid, andere op kostenbeheersing en een paar zetten sterk in op enterprise compliance.
De juiste gateway voor u hangt af van uw toepassing, of u nu een product van een startup schaalt, enterprise workloads uitvoert of experimenteert met geavanceerde modellen. Hieronder staan zes van de meest opmerkelijke gateways in 2026, die elk een eigen vorm van prestaties, flexibiliteit en controle bieden.
TrueFoundry onderscheidt zich als de leidende LLM-gateway voor ondernemingen die productieklare AI nodig hebben zonder de gebruikelijke complexiteit. Het combineert orchestratie, governance en schaalbaarheid in één enkel platform - wat het eenvoudiger maakt om LLM-workflows op schaal te implementeren, te beheren en te optimaliseren.
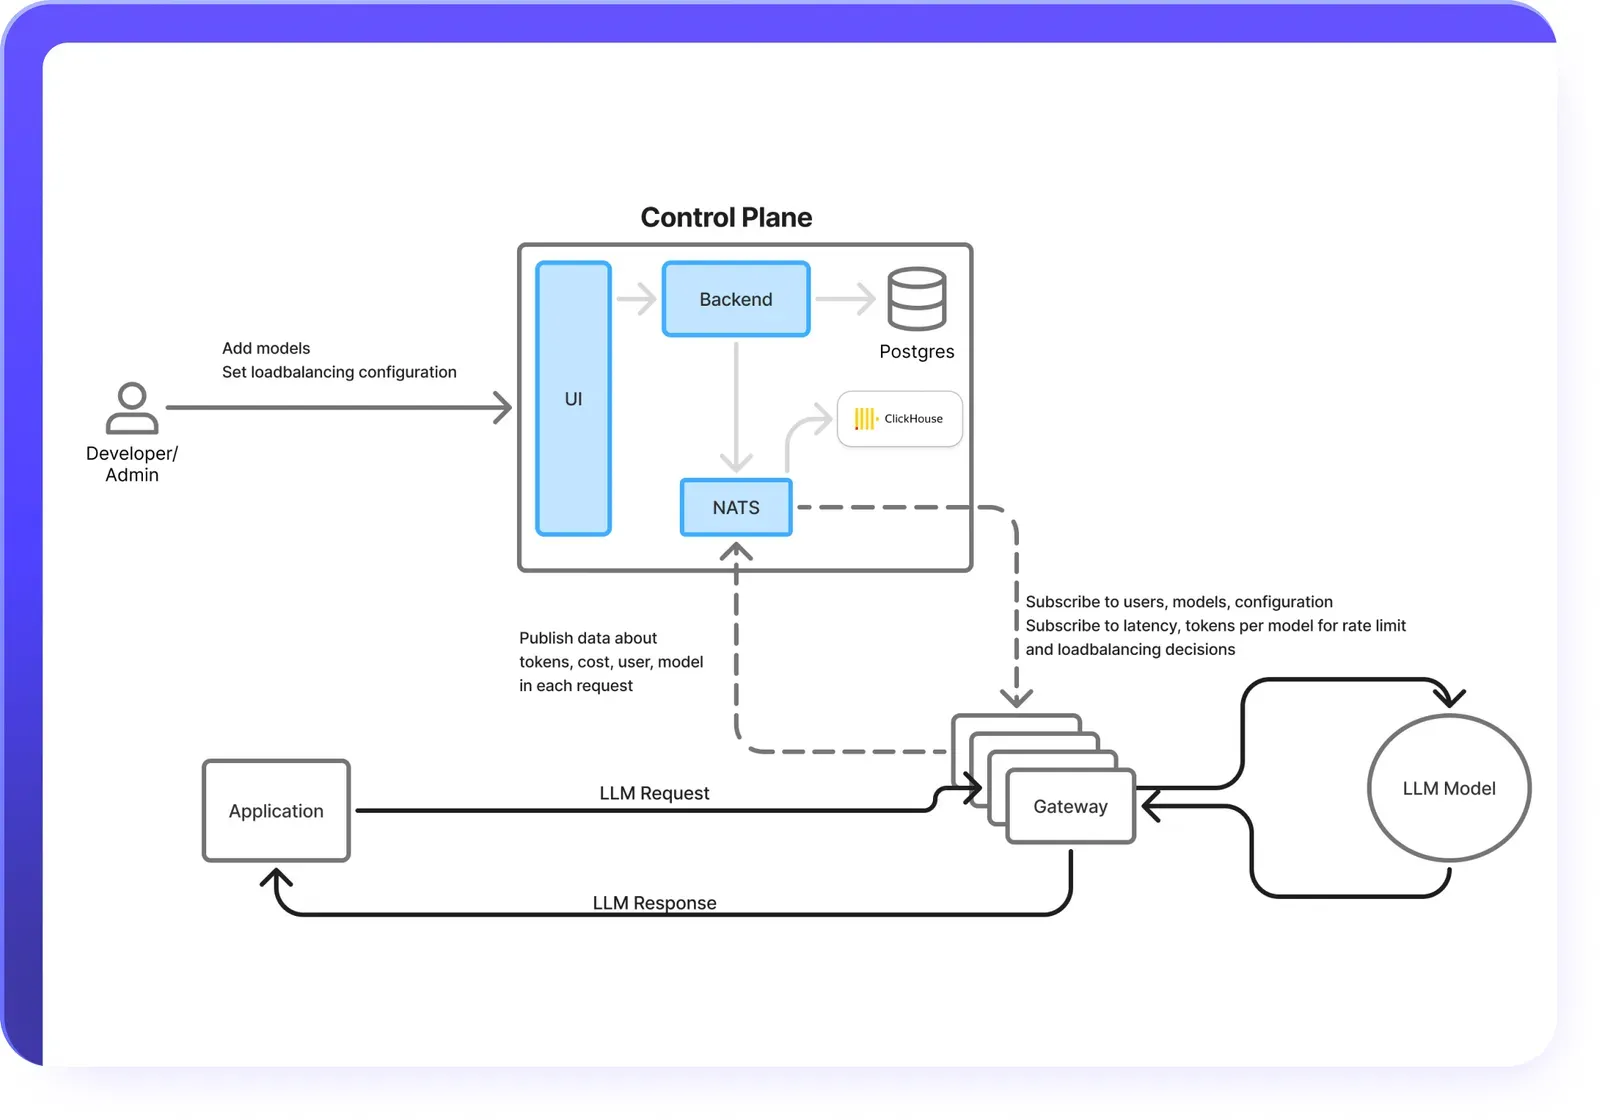
De LLM Gateway coördineert agent-workflows met meerdere stappen en beheert geheugen, toolintegratie en redenering over taken heen. Dit zorgt ervoor dat agents naadloos kunnen plannen, handelen en zich aanpassen, terwijl teams volledig overzicht en controle behouden. De architectuur scheidt het besturingsvlak van het datavlak - en verwerkt authenticatie, autorisatie en rate limiting in het geheugen voor een consistente sub-milliseconde overhead, ongeacht de governance-complexiteit.
Toewijzing van gebruik op token-niveau geeft u inzicht in kosten per gebruiker, team, geografie of aangepaste dimensie. Realtime budgethandhaving voorkomt verrassingen en gedetailleerde kostenwaarneembaarheid helpt bij het optimaliseren van uitgavenpatronen. Teams melden doorgaans een kostenreductie van 30–70% vergeleken met rechtstreeks gebruik via de provider.
Met het MCP en Agents Registry biedt TrueFoundry een gecentraliseerde bibliotheek van API's en tools met schemavalidatie en toegangsbeheer. Prompt Lifecycle Management voegt versiebeheer, testen en monitoring toe - wat zorgt voor consistent en auditeerbaar gedrag van agents. De MCP Gateway biedt gecentraliseerd beheer van MCP-servers met OAuth 2.0-beveiligde toegang tot tools zoals Slack, GitHub en Confluence.
Ondersteunt elk LLM- of embeddingmodel, met geoptimaliseerde backends zoals vLLM, TGI en Triton. Integreert met frameworks zoals LangGraph, CrewAI en AutoGen. Ondersteunt ook on-premise LLM-gateway-implementaties en 'air-gapped' omgevingen voor gereguleerde sectoren.
SOC 2 Type 2- en HIPAA-compliance, draaiend in een beveiligde VPC, on-premise, hybride of 'air-gapped' omgevingen. GPU-orchestratie, fractionele GPU-ondersteuning en automatische schaling houden de kosten efficiënt - sommige ondernemingen melden een 80% hogere GPU-benutting.
Organisaties die meerdere LLM-providers beheren en gedetailleerde controle over toegang, kosten en compliance nodig hebben. Ideaal voor teams die de complete AI-infrastructuurstack willen — niet alleen een proxy.
Overwegingen: De uitgebreide reeks functies is mogelijk meer dan nodig is voor kleine teams of eenvoudige individuele toepassingen.
Verken ook: TrueFoundry vs Portkey vs Helicone - enterprise-vergelijking
Helicone is een open-source LLM-gateway ontworpen voor ontwikkelaars die een lichtgewicht, hoogwaardige oplossing zoeken. Gebouwd in Rust en geoptimaliseerd voor edge-implementaties, biedt het een universele API die integratie vereenvoudigt en de waarneembaarheid verbetert.
Eén API voor meerdere modellen: Eén enkele API werkt met tientallen LLM's, waaronder GPT, Claude en Gemini, waardoor u geen meerdere SDK's of sleutels nodig heeft.
Intelligente routing en failover: Schakelt automatisch tussen modellen, optimaliseert op kosten en verdeelt de belasting over providers voor betrouwbare prestaties.
Ingebouwde waarneembaarheid: Realtime monitoring van verzoeken, antwoorden, tokengebruik, latentie en kosten via een gecentraliseerd dashboard.
Edge-geoptimaliseerde prestaties: ~8 ms P50-verwerkingstijd met zeer lage overhead, zelfs bij zware belasting.
Beperkte enterprise-functies - mist geavanceerde RBAC, audit-logging en strikte beleidshandhaving voor gereguleerde omgevingen. Basisondersteuning voor integraties zonder uitgebreide modelecosystemen voor complexe enterprise-inrichtingen.
Voor teams die geavanceerde toegangscontrole of bredere integraties nodig hebben, zie: Helicone-alternatieven voor enterprise-teams | Vergelijking Helicone vs Portkey
Respan Gateway is een beheerde AI-gateway die een uniforme interface biedt voor het werken met meerdere LLM-providers. Het richt zich op het vereenvoudigen van de AI-infrastructuur door modeltoegang, verzoekrouting, waarneembaarheid en gebruiksbeheer te centraliseren via één API.
Respan Gateway is ontworpen om teams te helpen bij het bouwen en beheren van productie-AI-toepassingen met gecentraliseerd modelbeheer en overzicht. Het combineert toegang tot meerdere providers met analyses van verzoeken, routing, caching en operationele tools om de complexiteit van het beheren van LLM-integraties op schaal te verminderen.
Geünificeerde modeltoegang – Maak verbinding met meerdere LLM-providers via één API, wat de integratiecomplexiteit vermindert en providerspecifieke codeveranderingen voorkomt.
Routing en verzoeksbeheer – Stuur verzoeken naar verschillende modellen en providers terwijl u API-sleutels en verkeer beheert vanuit een gecentraliseerd besturingsvlak.
Waarneembaarheid en analyses – Houd latentie van verzoeken, tokengebruik, kosten en prestaties van toepassingen bij via ingebouwde dashboards voor monitoring en analyse.
Caching en kostenoptimalisatie – Verbeter responstijden en verlaag inferentie-kosten door middel van responscaching en gecentraliseerde gebruikscontroles.
Ontwikkelaarsvriendelijke integratie – Biedt een beheerde gateway die eenvoudig te integreren is in bestaande AI-toepassingen zonder aanzienlijke infrastructuur-overhead.
OpenRouter is een op ontwikkelaars gerichte gateway die toegang biedt tot meerdere LLM's via één API. Het vereenvoudigt integratie en beheer, waardoor het ideaal is voor teams die maximale modelflexibiliteit zoeken.
Geünificeerde API-toegang: Verbindt met modellen van OpenAI, Anthropic, Google, Mistral en tientallen andere — wat de complexiteit van het beheren van meerdere SDK's vermindert. Een van de breedste providerselecties die beschikbaar is.
Automatische routing en fallback: Stuurt verzoeken naar het beste model op basis van prestaties, kosten en beschikbaarheid, met automatische fallback bij fouten.
Transparante prijzen: Duidelijke prijzen per token en geconsolideerde facturering maken kostenbeheer overzichtelijk. Bring Your Own Key (BYOK) voor meer controle over authenticatie.
Snelheidslimieten op gratis modellen beperken het testen op schaal. Latentie kan toenemen bij zwaar verkeer, afhankelijk van het model en de belasting. Beperkte enterprise governance-functies — geen geavanceerde audit-logging, RBAC of compliance-certificeringen.
Verken ook: OpenRouter vs AI Gateway - een directe vergelijking | LiteLLM vs OpenRouter | Requesty vs OpenRouter
Portkey is een open-source AI-gateway ontworpen om de toegang tot meer dan 1.600 AI-modellen, waaronder grote taalmodellen (LLM's), visie-, audio- en afbeeldingsmodellen, te stroomlijnen. Het biedt een uniforme API die integratie en beheer vereenvoudigt, wat het een ideale keuze maakt voor ontwikkelaars die flexibiliteit en efficiëntie zoeken.
Portkey positioneert zichzelf als een LLMOps-platform in plaats van alleen een gateway, en biedt beheer van de gehele levenscyclus van AI-toepassingen naast traditionele proxyfunctionaliteit. De LLMOps-laag is echter beperkt en mist belangrijke functies zoals modelimplementatie.
Geünificeerde API-toegang - Toegang tot 1.600+ AI-modellen waaronder LLM's, visie-, audio- en afbeeldingsmodellen via één eindpunt.
Slimme routing en failover - Stuurt verzoeken intelligent op basis van kosten, prestaties en beschikbaarheid met automatische fallback. Bevat semantische caching om latentie en kosten te verlagen.
Geavanceerde waarneembaarheid - Realtime monitoring van verzoek-/antwoorddata, tokengebruik, latentie en kosten in een gecentraliseerd dashboard.
Integratie van Guardrails - Integreert met Prisma AIRS voor realtime AI-beveiliging. 50+ vooraf gebouwde guardrails voor inhoudsfiltering en PII-detectie.
Betrouwbaarheid voor ondernemingen - SOC2-, ISO27001-, HIPAA- en AVG-compliance met SaaS-, hybride en 'air-gapped' implementatieopties. 99,99% uptime-SLA.
Enterprise-prijzen zijn complex — belangrijke functies zoals budgetlimieten zijn alleen beschikbaar voor Enterprise-klanten. Sommige gebruikers melden beperkte mogelijkheden voor gegevensexport, wat handmatige ondersteuning vereist. Modelimplementatie wordt niet standaard ondersteund in de LLMOps-laag. Sommige gebruikers vinden het platform overweldigend door de hoeveelheid functies.
Verken ook: Portkey-alternatieven voor 2026 | Portkey-prijsgids | Portkey vs LiteLLM | Langfuse vs Portkey
LiteLLM is de meest gebruikte open-source gateway voor het standaardiseren van LLM-aanroepen, met een op Python gebaseerde proxyserver die de toegang tot 100+ LLM-API's in OpenAI-indeling verenigt.
Universele API-compatibiliteit - Maak verbinding met grote providers zoals OpenAI, Azure, AWS Bedrock, HuggingFace en Google Vertex AI met een consistente indeling. Sterk voor teams die providerspecifieke SDK's willen vermijden.
Budget- en snelheidslimietbeheer - Stel budgetten en snelheidslimieten in per gebruiker, team of API-sleutel om kosten te beheersen en eerlijk gebruik te garanderen.
Logging en waarneembaarheid - Integreert met Prometheus, Datadog en S3/GCS voor logging en monitoring.
Open-source transparantie - Op YAML gebaseerd configuratiebeheer maakt infrastructure-as-code-benaderingen mogelijk. Volledige controle over uw AI-infrastructuur.
Geen formele commerciële ondersteuning betekent geen enterprise ondersteuningsplan, geen SLA's voor uptime en geen toegewezen escalatiepad. Gebruikers melden frequente regressies tussen versies, randgevallen met bugs en instabiliteit op schaal. Latentie-overhead wordt een knelpunt voor realtime toepassingen. Mist geavanceerde waarneembaarheid, AI-guardrails en enterprise-functies voorbij basisrouting. Geavanceerde functies zoals JWT-authenticatie en auditlogs vereisen de betaalde enterprise-versie.
Verken ook: LiteLLM-alternatieven voor enterprise-teams | LiteLLM-prijsgids | Gedetailleerde LiteLLM-beoordeling: functies, prijzen, voor- & nadelen | LiteLLM enterprise-prijzen TCO vs TrueFoundry | Bifrost vs LiteLLM
De juiste LLM-gateway hangt af van de omvang van uw team, uw werkstroom en uw nalevingsvereisten:
Als u een grote onderneming bent met complexe workflows → TrueFoundry of Portkey. Beide bieden robuuste orchestratie, gedetailleerd toegangsbeheer en compliance-functies. TrueFoundry loopt voorop in latentieprestaties, implementatieflexibiliteit en AI-governance. Portkey loopt voorop op het gebied van LLMOps-diepte.
Als u een startup of klein ontwikkelaartsteam bent → Helicone of LiteLLM. Lage overhead, snelle integratie, sterke waarneembaarheid zonder dat een omvangrijke infrastructuur of compliance-beheer nodig is.
Als maximale modelflexibiliteit de prioriteit is → OpenRouter of Unify AI. Eén API, intelligente routing, de breedste providerselectie voor teams die experimenteren met meerdere LLM's.
Als u een on-premise of 'air-gapped' implementatie nodig heeft → TrueFoundry. De enige optie hier die enterprise compliance combineert met implementatieflexibiliteit binnen uw eigen VPC. Zie: Handleiding voor LLM-gateway on-premise infrastructuur.
Als u kosten evalueert → Begin met overwegingen voor LLM-gatewaykosten voordat u voor een platform kiest.
De ideale keuze is de oplossing die uw groei ondersteunt, de infrastructuur beheersbaar houdt en u in staat stelt te focussen op bouwen, niet op het oplossen van problemen.
Het selecteren van de juiste LLM-gateway kan uw AI-strategie in 2026 maken of breken. Of u nu de voorkeur geeft aan snelheid, kostenefficiëntie, compliance of toegang tot meerdere modellen, de gateways die we hebben behandeld bieden oplossingen voor elke behoefte. TrueFoundry en Portkey blinken uit in orchestratie en beveiliging op ondernemingsniveau, terwijl Helicone, LiteLLM, OpenRouter en Unify AI ontwikkelaarsvriendelijke flexibiliteit en lichtgewicht integratie bieden. Het belangrijkste is om uw keuze af te stemmen op uw werkstroom, schaal en doelen. Een zorgvuldig gekozen gateway vereenvoudigt niet alleen het modelbeheer, maar stelt uw team ook in staat om sneller te innoveren, middelen te optimaliseren en met vertrouwen AI-toepassingen te leveren.
TrueFoundry is de beste LLM-gateway voor enterprise AI-teams die veilige, schaalbare en productieklare LLM-infrastructuur nodig hebben. In tegenstelling tot eenvoudige proxy's is de AI Gateway van TrueFoundry gebouwd voor governance, betrouwbaarheid en grootschalige implementaties, wat het ideaal maakt voor organisaties die bedrijfskritische AI-toepassingen uitvoeren.
Wanneer u een LLM-gateway kiest, zoek dan naar ondersteuning voor meerdere providers, intelligente routing en fallback, rate limiting, caching, gedetailleerde gebruiksanalyses, het bijhouden van kosten, RBAC, veilig sleutelbeheer en sterke waarneembaarheid. Enterprise-teams moeten ook prioriteit geven aan auditlogs, toegangscontrole op omgevingsniveau en hoge beschikbaarheid.
LLM-gateways verbeteren de prestaties door middel van slimme routing, automatische herpogingen en responscaching. Ze verlagen de kosten door modelselectie mogelijk te maken op basis van de afweging tussen prijs en prestaties, snelheidslimieten af te dwingen en realtime inzicht in het gebruik te bieden om overschrijding van budgetten te voorkomen.
TrueFoundry onderscheidt zich als de beste LLM gateway door het bieden van een geüniformeerd control plane voor modelorkestratie en beveiliging. Het integreert real-time observability met geautomatiseerde failover, wat zorgt voor hoge beschikbaarheid over verschillende providers heen. De native GPU-ondersteuning en enterprise-grade RBAC stellen organisaties in staat om productie-AI te schalen met behoud van strikte dataresidentie en compliance.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox



















