August 27, 2025
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.




De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Stel dat team A is aangewezen om een RAG-applicatie te ontwikkelen voor use-case-1, dat team B een RAG-applicatie ontwikkelt voor use-case-2, en dat team C net bezig is met de planning van hun komende RAG-applicatie. Heeft u ooit gewenst dat het bouwen van RAG-pipelines voor meerdere teams eenvoudiger was? Dat niet elk team vanaf nul hoeft te beginnen, maar dat er een modulaire manier is waarop elk team dezelfde basisfunctionaliteit kan gebruiken en hier effectief eigen apps bovenop kan bouwen zonder elkaar te hinderen?
Geen zorgen! Dit is precies waarom we Cognita hebben gemaakt. Hoewel RAG onmiskenbaar indrukwekkend is, kan het proces om er een functionele applicatie mee te maken uitdagend zijn. Er komt heel wat kijken bij de implementatie en best practices voor ontwikkeling, variërend van het selecteren van de juiste AI-modellen voor de specifieke use-case tot het effectief organiseren van data om de gewenste inzichten te verkrijgen. Hoewel tools zoals LangChain en LlamaIndex bestaan om het ontwerpen van prototypes te vereenvoudigen, was er nog geen toegankelijk, gebruiksklaar open-source RAG-template dat best practices bevat en modulaire ondersteuning biedt, zodat iedereen het snel en eenvoudig kan gebruiken.
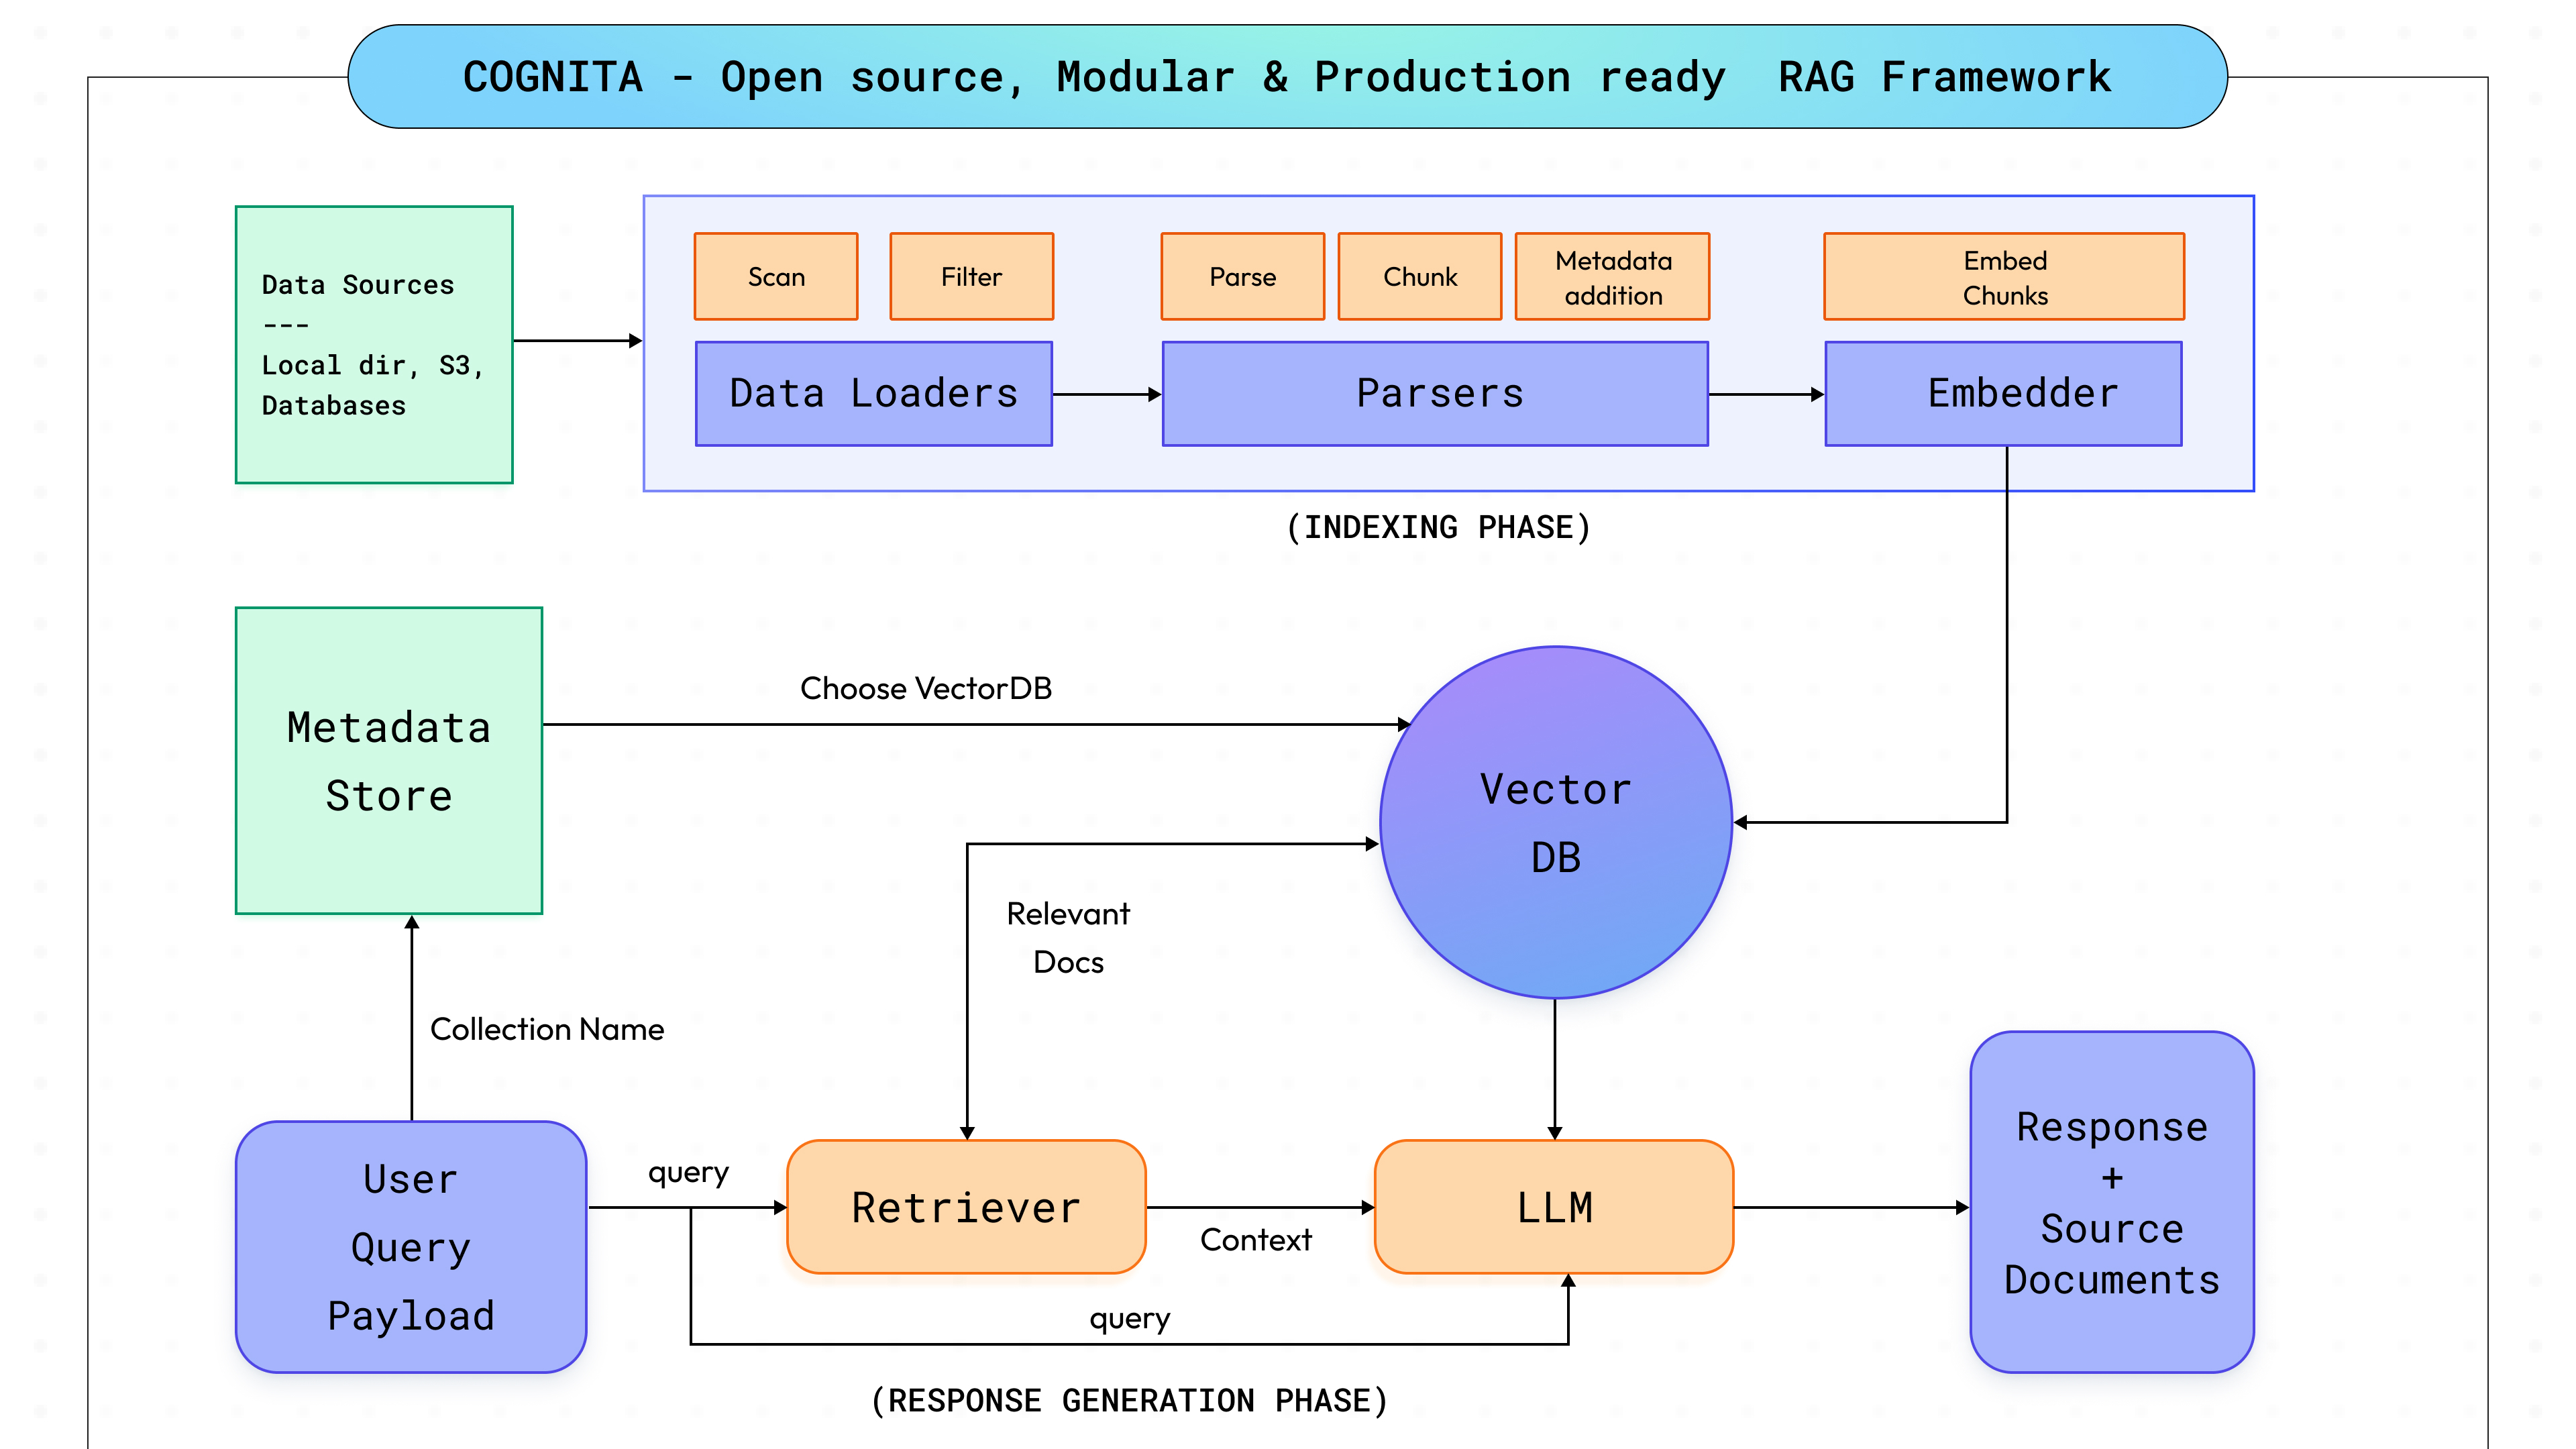
Bij het ontwikkelen van de interne werking van Cognita was ons doel om een balans te vinden tussen volledige aanpasbaarheid en flexibiliteit, terwijl we direct uit de doos gebruiksvriendelijkheid garanderen. Gezien het snelle tempo van ontwikkelingen in RAG en AI, was het voor ons essentieel om Cognita te ontwerpen met schaalbaarheid in het achterhoofd. Dit maakt een naadloze integratie van nieuwe doorbraken en uiteenlopende use-cases mogelijk. Hierdoor hebben we het RAG-proces opgedeeld in afzonderlijke modulaire stappen (zoals getoond in het bovenstaande diagram, te bespreken in de volgende secties). Dit vergemakkelijkt het onderhoud van het systeem, de toevoeging van nieuwe functionaliteiten zoals interoperabiliteit met andere AI-bibliotheken, en stelt gebruikers in staat het platform af te stemmen op hun specifieke vereisten. Onze focus blijft gericht op het bieden van een robuuste tool die niet alleen aan de huidige behoeften van gebruikers voldoet, maar ook mee-evolueert met de technologie, inclusief bredere architecturale verschuivingen zoals MCP vs RAG, wat langetermijnwaarde garandeert.
Cognita is ontworpen rond zeven verschillende modules, die elk aanpasbaar en bestuurbaar zijn om aan verschillende behoeften te voldoen:
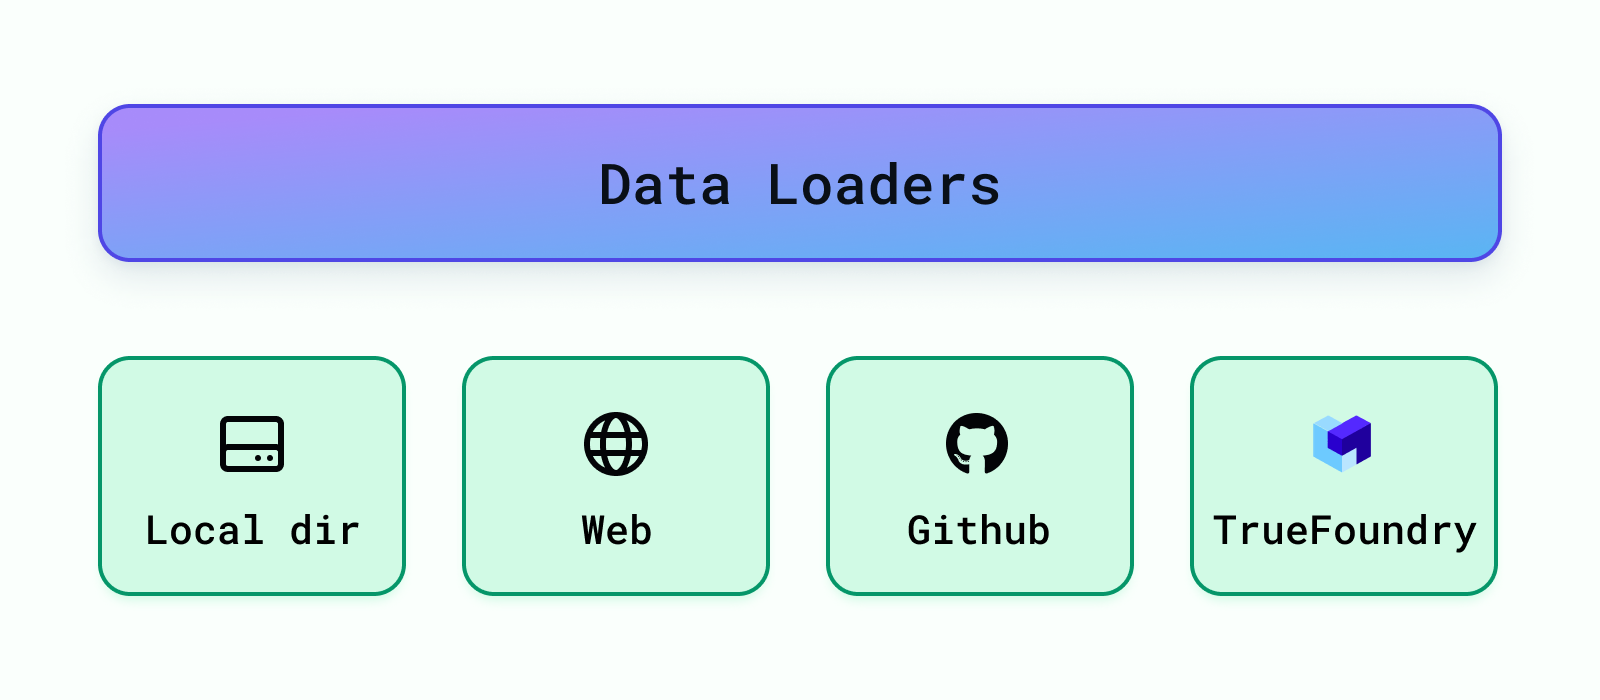
Deze laden de data uit verschillende bronnen zoals lokale mappen, S3-buckets, databases, Truefoundry-artifacts, enz. Cognita ondersteunt momenteel het laden van data uit een lokale map, web-URL, GitHub-repository en Truefoundry-artifacts. Meer data loaders kunnen eenvoudig worden toegevoegd onder backend/modules/dataloaders/ . Zodra een dataloader is toegevoegd, moet u deze registreren zodat deze door de RAG-applicatie kan worden gebruikt onder backend/modules/dataloaders/__init__.py Voeg het volgende toe om een dataloader te registreren:
In deze stap verwerken we verschillende soorten data, zoals reguliere tekstbestanden, PDF's en zelfs Markdown-bestanden. Het doel is om al deze verschillende typen om te zetten naar één gemeenschappelijk formaat, zodat we er later gemakkelijker mee kunnen werken. Dit onderdeel, parsing genoemd, duurt meestal het langst en is lastig te implementeren wanneer we een dergelijk systeem opzetten. Het gebruik van Cognita helpt hierbij, omdat het het zware werk van het beheren van datapipelines al voor ons afhandelt.
Hierna splitsen we de geparsede data op in uniforme chunks. Maar waarom is dit nodig? De tekst die we uit de bestanden halen, kan verschillende lengtes hebben. Als we deze lange teksten direct gebruiken, voegen we uiteindelijk een hoop onnodige informatie toe. Omdat alle LLM's bovendien slechts een beperkte hoeveelheid tekst tegelijk kunnen verwerken, kunnen we niet alle belangrijke context opnemen die nodig is voor de vraag. Daarom splitsen we de tekst op in kleinere delen voor elke sectie. Intuitief zullen kleinere chunks relevantere concepten bevatten en minder ruis veroorzaken in vergelijking met grotere chunks.
Momenteel ondersteunen we parsing voor Markdown-, PDF - en Text -bestanden. Meer data parsers kunnen eenvoudig worden toegevoegd onder backend/modules/parsers/ . Zodra een parser is toegevoegd, moet u deze registreren zodat deze door de RAG-applicatie kan worden gebruikt onder backend/modules/parsers/__init__.py Voeg het volgende toe om een parser te registreren:
Zodra we de data in kleinere stukken hebben opgedeeld, willen we de belangrijkste chunks voor een specifieke vraag vinden. Een snelle en effectieve manier om dit te doen is door een voorgeconditioneerd model (embedding-model) te gebruiken om onze data en de vraag om te zetten in speciale codes genaamd embeddings. Vervolgens vergelijken we de embeddings van elke chunk data met die van de vraag. Door de cosine similarity tussen deze embeddings te meten, kunnen we bepalen welke chunks het meest verwant zijn aan de vraag, wat ons helpt de beste te selecteren voor gebruik.
Er zijn veel voorgeconditioneerde modellen beschikbaar om de data te embedden, zoals modellen van OpenAI, Cohere, enz. De populairste kunnen worden ontdekt via HuggingFace's Massive Text Embedding Benchmark (MTEB) leaderboard. We bieden ondersteuning voor OpenAI Embeddings, TrueFoundry Embeddings en ook de huidige SOTA embeddings (per april 2024) van mixedbread-ai.
Meer embedders kunnen eenvoudig worden toegevoegd onder backend/modules/embedder/ . Zodra een embedder is toegevoegd, moet u deze registreren zodat deze door de RAG-applicatie kan worden gebruikt onder backend/modules/embedders/__init__.py Voeg het volgende toe om een parser te registreren:
Opmerking: Onthoud dat embeddings niet de enige methode zijn om belangrijke chunks te vinden. We zouden hier ook een LLM voor kunnen gebruiken! LLM's zijn echter veel groter dan embedding-modellen en hebben een limiet op de hoeveelheid tekst die ze tegelijk kunnen verwerken. Daarom is het slimmer om eerst embeddings te gebruiken om de top k chunks te selecteren. Vervolgens kunnen we LLM's toepassen op deze minder talrijke chunks om te bepalen welke het beste als context gebruikt kunnen worden om onze vraag te beantwoorden.
Zodra de embedding-stap potentiële matches vindt (wat er veel kunnen zijn), wordt er een reranking-stap toegepast. Reranking zorgt ervoor dat de beste resultaten bovenaan staan. Hierdoor kunnen we de top x documenten kiezen, wat onze context beknopter maakt en de prompt-query korter. We bieden ondersteuning voor de SOTA reranker (per april 2024) van mixedbread-ai die is geïmplementeerd onder backend/modules/reranker/
Zodra we vectoren voor teksten hebben gemaakt, slaan we ze op in een zogenaamde vector database. Deze database houdt deze vectoren bij, zodat we ze later snel kunnen terugvinden via verschillende methoden. Reguliere databases organiseren data in tabellen met rijen en kolommen, maar vector databases zijn speciaal omdat ze data opslaan en zoeken op basis van deze vectoren. Dit is uitermate handig voor zaken zoals afbeeldingsherkenning, taalbegrip of aanbevelingssystemen. In een aanbevelingssysteem wordt elk item dat u wilt aanbevelen (zoals een film of een product) bijvoorbeeld omgezet in een vector, waarbij verschillende onderdelen van de vector verschillende kenmerken van het item vertegenwoordigen, zoals het genre of de prijs. Evenzo wordt bij taaltoepassingen elk woord of document omgezet in een vector, waarbij delen van de vector kenmerken van het woord of document vertegenwoordigen, zoals hoe vaak het woord wordt gebruikt of wat het betekent. Deze vector databases zijn ontworpen om dit efficiënt af te handelen. Door verschillende manieren te gebruiken om te meten hoe dicht vectoren bij elkaar liggen, zoals hun gelijkenis of afstand, vinden we de vectoren die het dichtst bij de gegeven gebruikersquery liggen. De meest gebruikelijke meetmethoden zijn Euclidean Distance, Cosine Similarity en Dot Product.
Er zijn diverse vector databases beschikbaar op de markt, zoals Qdrant, SingleStore, Weaviate, enz. We ondersteunen momenteel Qdrant en SingleStore. De Qdrant vector db-klasse is gedefinieerd onder /backend/modules/vector_db/qdrant.py, terwijl de SingleStore vector db-klasse is gedefinieerd onder /backend/modules/vector_db/singlestore.py
Andere vector db's kunnen ook worden toegevoegd in de map vector_db en kunnen worden geregistreerd onder /backend/modules/vector_db/__init__.py
Om ondersteuning voor een vector DB toe te voegen in Cognita, moet de gebruiker het volgende doen:
BaseVectorDB (from backend.modules.vector_db.base import BaseVectorDB) en initialiseer deze met VectorDBConfig (from backend.types import VectorDBConfig)create_collection: Om de collectie/het project/de tabel te initialiseren in de vector db.upsert_documents: Om de documenten in te voegen in de db.get_collections: Haal alle collecties op die aanwezig zijn in de db.delete_collection: Om de collectie te verwijderen uit de db.get_vector_store: Om de vector store op te halen voor de gegeven collectie.get_vector_client: Om de vector client op te halen voor de gegeven collectie, indien aanwezig.list_data_point_vectors: Om reeds aanwezige vectoren in de db op te sommen die vergelijkbaar zijn met de documenten die worden ingevoegd.delete_data_point_vectors: Om de vectoren uit de db te verwijderen, gebruikt om oude vectoren van het bijgewerkte document te verwijderen.We laten nu zien hoe we een nieuwe vector db kunnen toevoegen aan het RAG-systeem. We nemen het voorbeeld van zowel Qdrant - als SingleStore -vector db's.
Qdrant is een Open-Source Vector Database en Vector Search Engine geschreven in Rust. Het biedt een snelle en schaalbare vector similarity search dienst met een handige API. Volg onderstaande stappen om de Qdrant vector db toe te voegen aan het RAG-systeem:
In het .env-bestand kunt u het volgende toevoegen
VECTOR_DB_CONFIG = '{"url": "<url_here>", "provider": "qdrant"}' # Qdrant URL for deployed instanceVECTOR_DB_CONFIG='{"provider":"qdrant","local":"true"}'# For local file based Qdrant instance without docker
QdrantVectorDB aan in backend/modules/vector_db/qdrant.py die overerft van BaseVectorDB en initialiseer deze met VectorDBConfigcreate_collection om een collectie aan te maken in Qdrantupsert_documents om de documenten in de db in te voegenget_collections om alle collecties op te halen die aanwezig zijn in de dbdelete_collection om de collectie te verwijderen uit de dbget_vector_store om de vector store op te halen voor de gegeven collectieget_vector_client om de vector client op te halen voor de gegeven collectie, indien aanweziglist_data_point_vectors om al aanwezige vectoren in de db op te sommen die vergelijkbaar zijn met de documenten die worden ingevoegddelete_data_point_vectors om de vectoren uit de db te verwijderen, gebruikt om oude vectoren van het bijgewerkte document te verwijderenSingleStore biedt krachtige vector database-functionaliteit die uitermate geschikt is voor op AI gebaseerde applicaties, chatbots, afbeeldingsherkenning en meer, waardoor het niet meer nodig is om een gespecialiseerde vector database te draaien puur voor uw vector-workloads. In tegenstelling tot traditionele vector databases slaat SingleStore vectordata op in relationele tabellen naast andere typen data. Door vectordata samen te brengen met gerelateerde data kunt u eenvoudig uitgebreide metadata en andere attributen van uw vectordata bevragen met de volle kracht van SQL.
SingleStore biedt een gratis tier voor ontwikkelaars om aan de slag te gaan met hun vector database. U kunt zich hier aanmelden voor een gratis account. Ga na het aanmelden naar Cloud -> workspace -> Create User. Gebruik de inloggegevens om verbinding te maken met de SingleStore-instantie.
In het .env-bestand kunt u het volgende toevoegen
VECTOR_DB_CONFIG = '{"url": "<url_hier>", "provider": "singlestore"}' # url: mysql://{user}:{password}@{host}:{port}/{db}
Volg de onderstaande stappen om de SingleStore vector db toe te voegen aan het RAG-systeem:
SingleStoreVectorDB aan in backend/modules/vector_db/singlestore.py die overerft van BaseVectorDB en initialiseer deze met VectorDBConfigcreate_collection om een collectie aan te maken in SingleStoreupsert_documents om de documenten in te voegen in de dbget_collections om alle collecties op te halen die aanwezig zijn in de dbdelete_collection om de collectie te verwijderen uit de dbget_vector_store om de vector store op te halen voor de gegeven collectieget_vector_client om de vector client op te halen voor de gegeven collectie, indien aanweziglist_data_point_vectors om al aanwezige vectoren in de db op te sommen die vergelijkbaar zijn met de documenten die worden ingevoegddelete_data_point_vectors om de vectoren uit de db te verwijderen, gebruikt om oude vectoren van het bijgewerkte document te verwijderenDit bevat de noodzakelijke configuraties die een project of RAG-app uniek definiëren. Een RAG-app kan een verzameling documenten bevatten uit een of meer gecombineerde databronnen, wat we aanduiden als collection. De documenten uit deze databronnen worden geïndexeerd in de vector db met behulp van methoden voor data loading + parsing + embedding. Voor elke RAG-use-case bevat de metadata store:
We definiëren momenteel twee manieren om deze data op te slaan: één locally en de andere met behulp van Truefoudry. Deze stores zijn gedefinieerd onder - backend/modules/metada_store/
Zodra de data is geïndexeerd en opgeslagen in de vector db, is het tijd om alle onderdelen samen te voegen om onze app te gebruiken. Query Controllers doen precies dat! Ze helpen ons het antwoord op te halen voor de bijbehorende gebruikersquery. De stappen van een typische query controller zijn als volgt:
collection name wordt de relevante vector db opgehaald met de bijbehorende configuratie zoals het gebruikte embedding-model, vector db-type, enz.query worden relevante documenten opgehaald uit de vector db met behulp van de retriever .context en worden samen met de query (oftewel question) aan de LLM gegeven om het antwoord te genereren. Deze stap kan ook prompt tuning omvatten.Opmerking: In het geval van agents kunnen de tussenstappen ook gestreamd worden. Het is aan de specifieke app om dit te bepalen.
Query controller-methoden kunnen direct worden blootgesteld als API door HTTP-decorators toe te voegen aan de respectievelijke functies.
Voer de volgende stappen uit om uw eigen query controller toe te voegen:
app-2 is. We schrijven onze controller dan onder /backend/modules/query_controller/app-2/controller.pyquery_controller decorator toe aan uw klasse en geef de naam van uw aangepaste controller door als argumentpost, get, delete om van uw methoden een API te makenbackend/modules/query_controllers/__init__.pyEen voorbeeld van een query controller is geschreven onder: /backend/modules/query_controller/example/controller.py Raadpleeg dit voor een beter begrip
Een typisch Cognita-proces bestaat uit twee fasen:
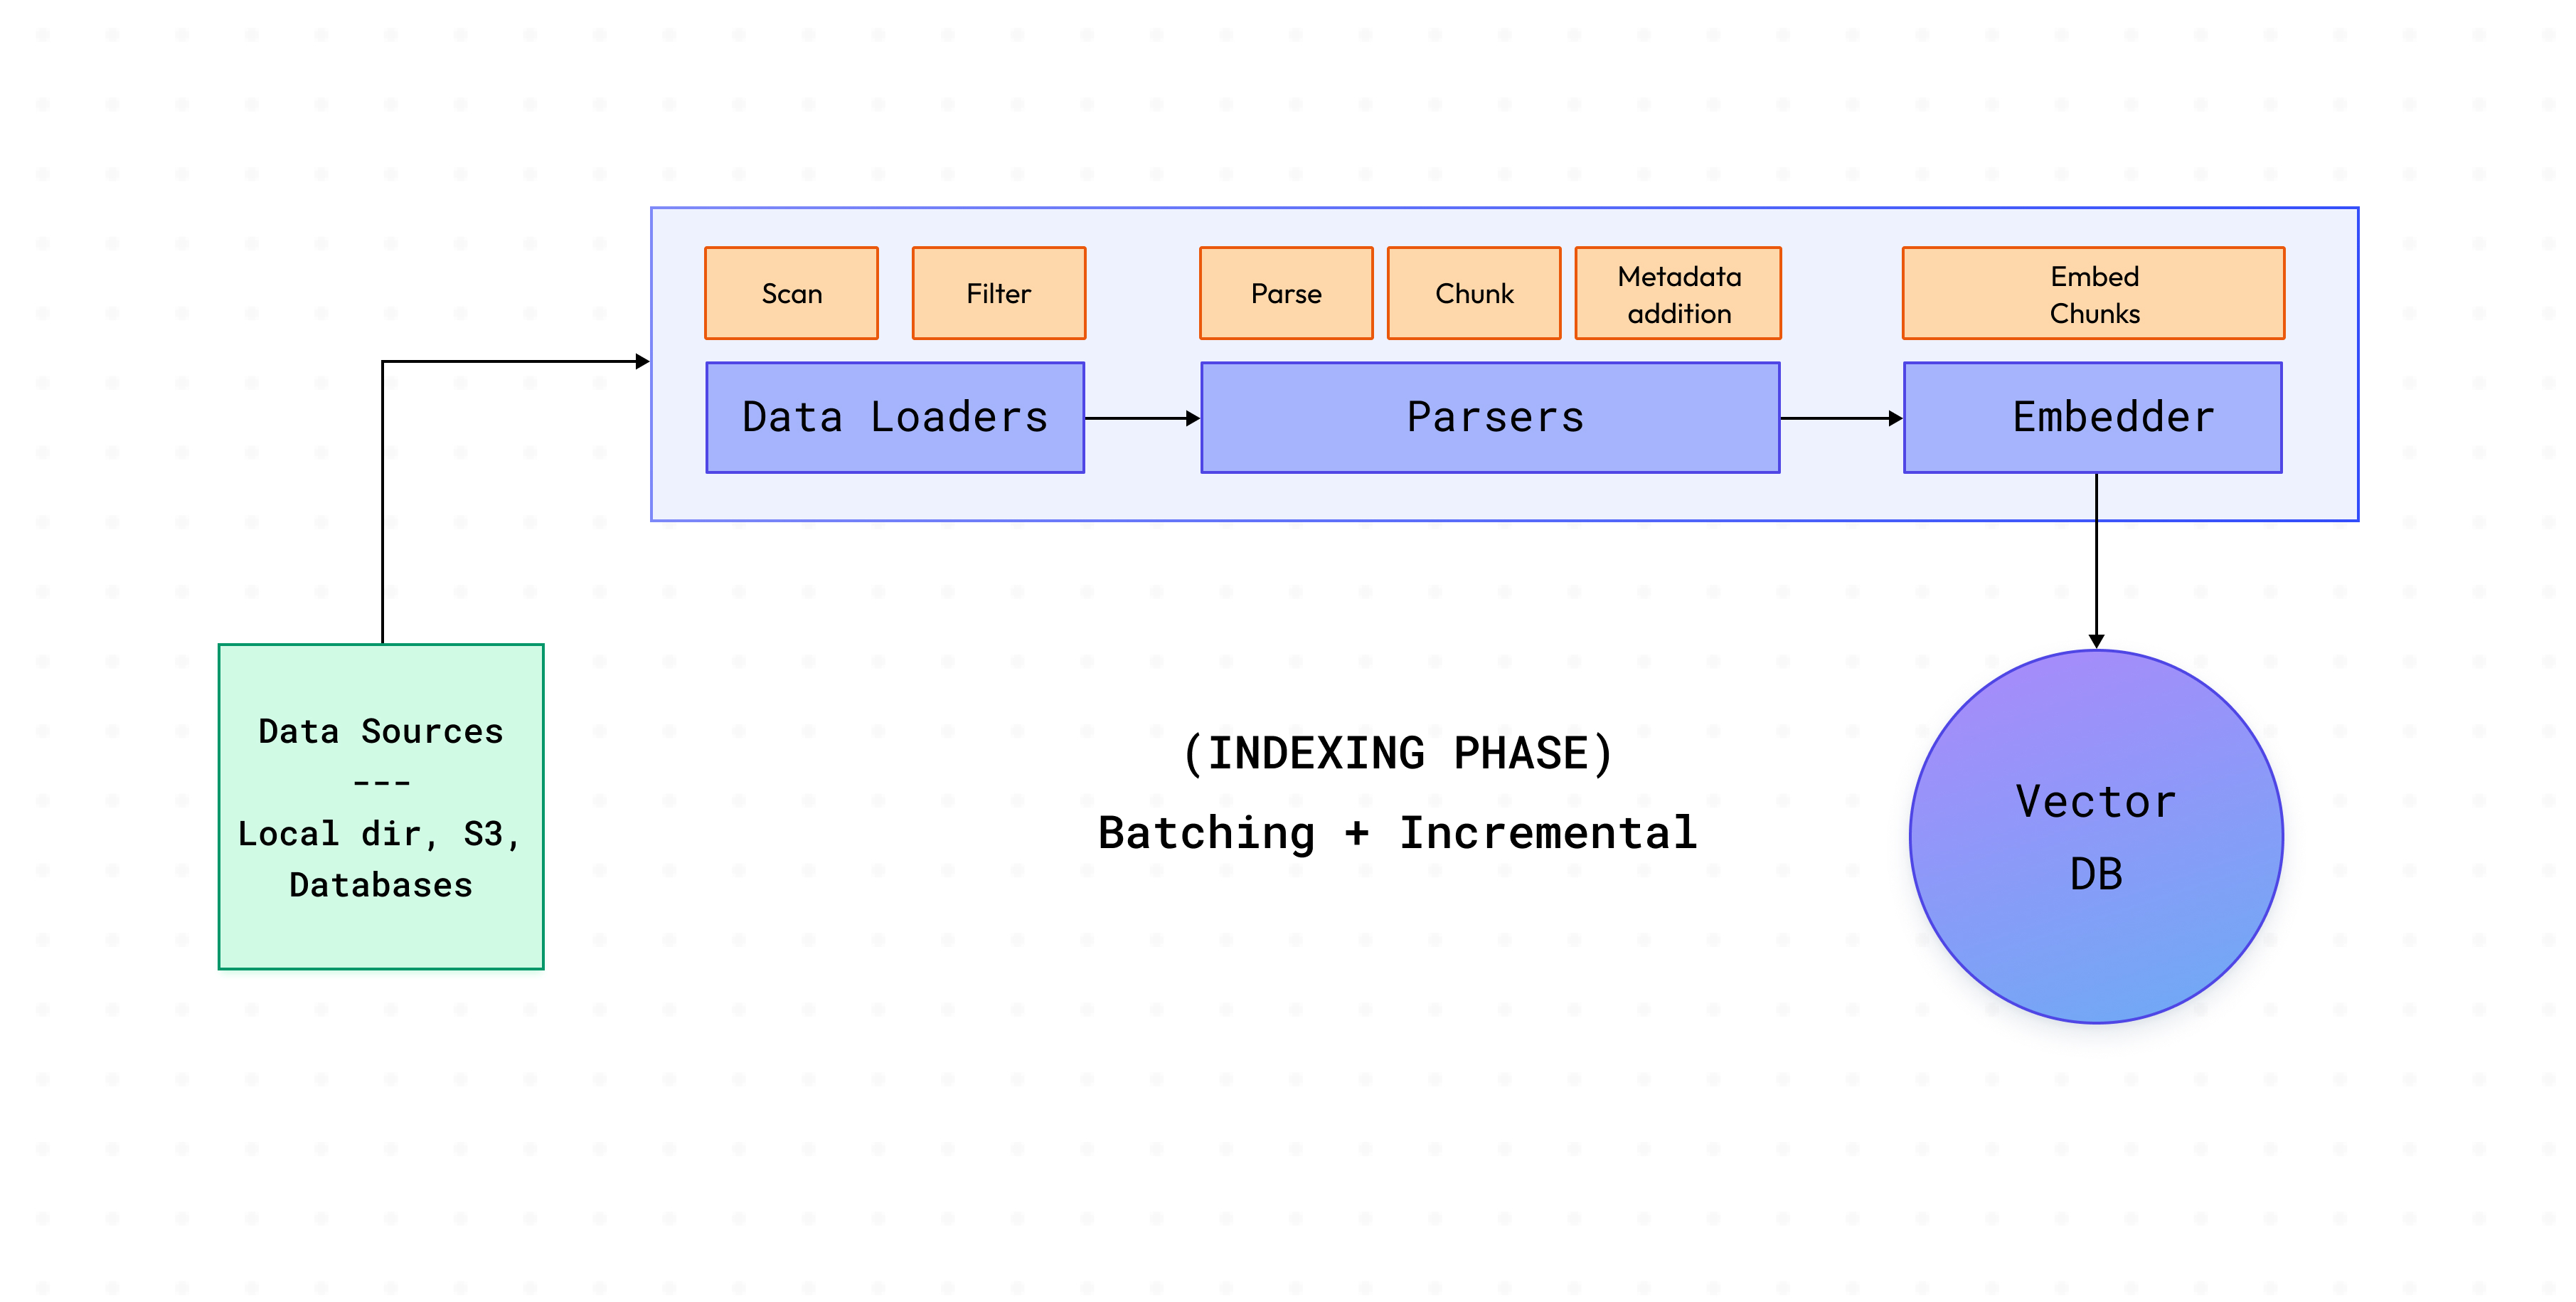
Deze fase omvat het laden van data uit bronnen, het parsen van de documenten in deze bronnen en het indexeren ervan in de vector db. Om grote hoeveelheden documenten in productieomgevingen te verwerken, gaat Cognita nog een stap verder.
INCREMENTAL indexering genoemd. Er is ook een andere modus die in Cognita wordt ondersteund, namelijk FULL indexering. FULL indexering voert de data opnieuw in de vector db in, ongeacht de aanwezige vectordata voor de gegven collectie.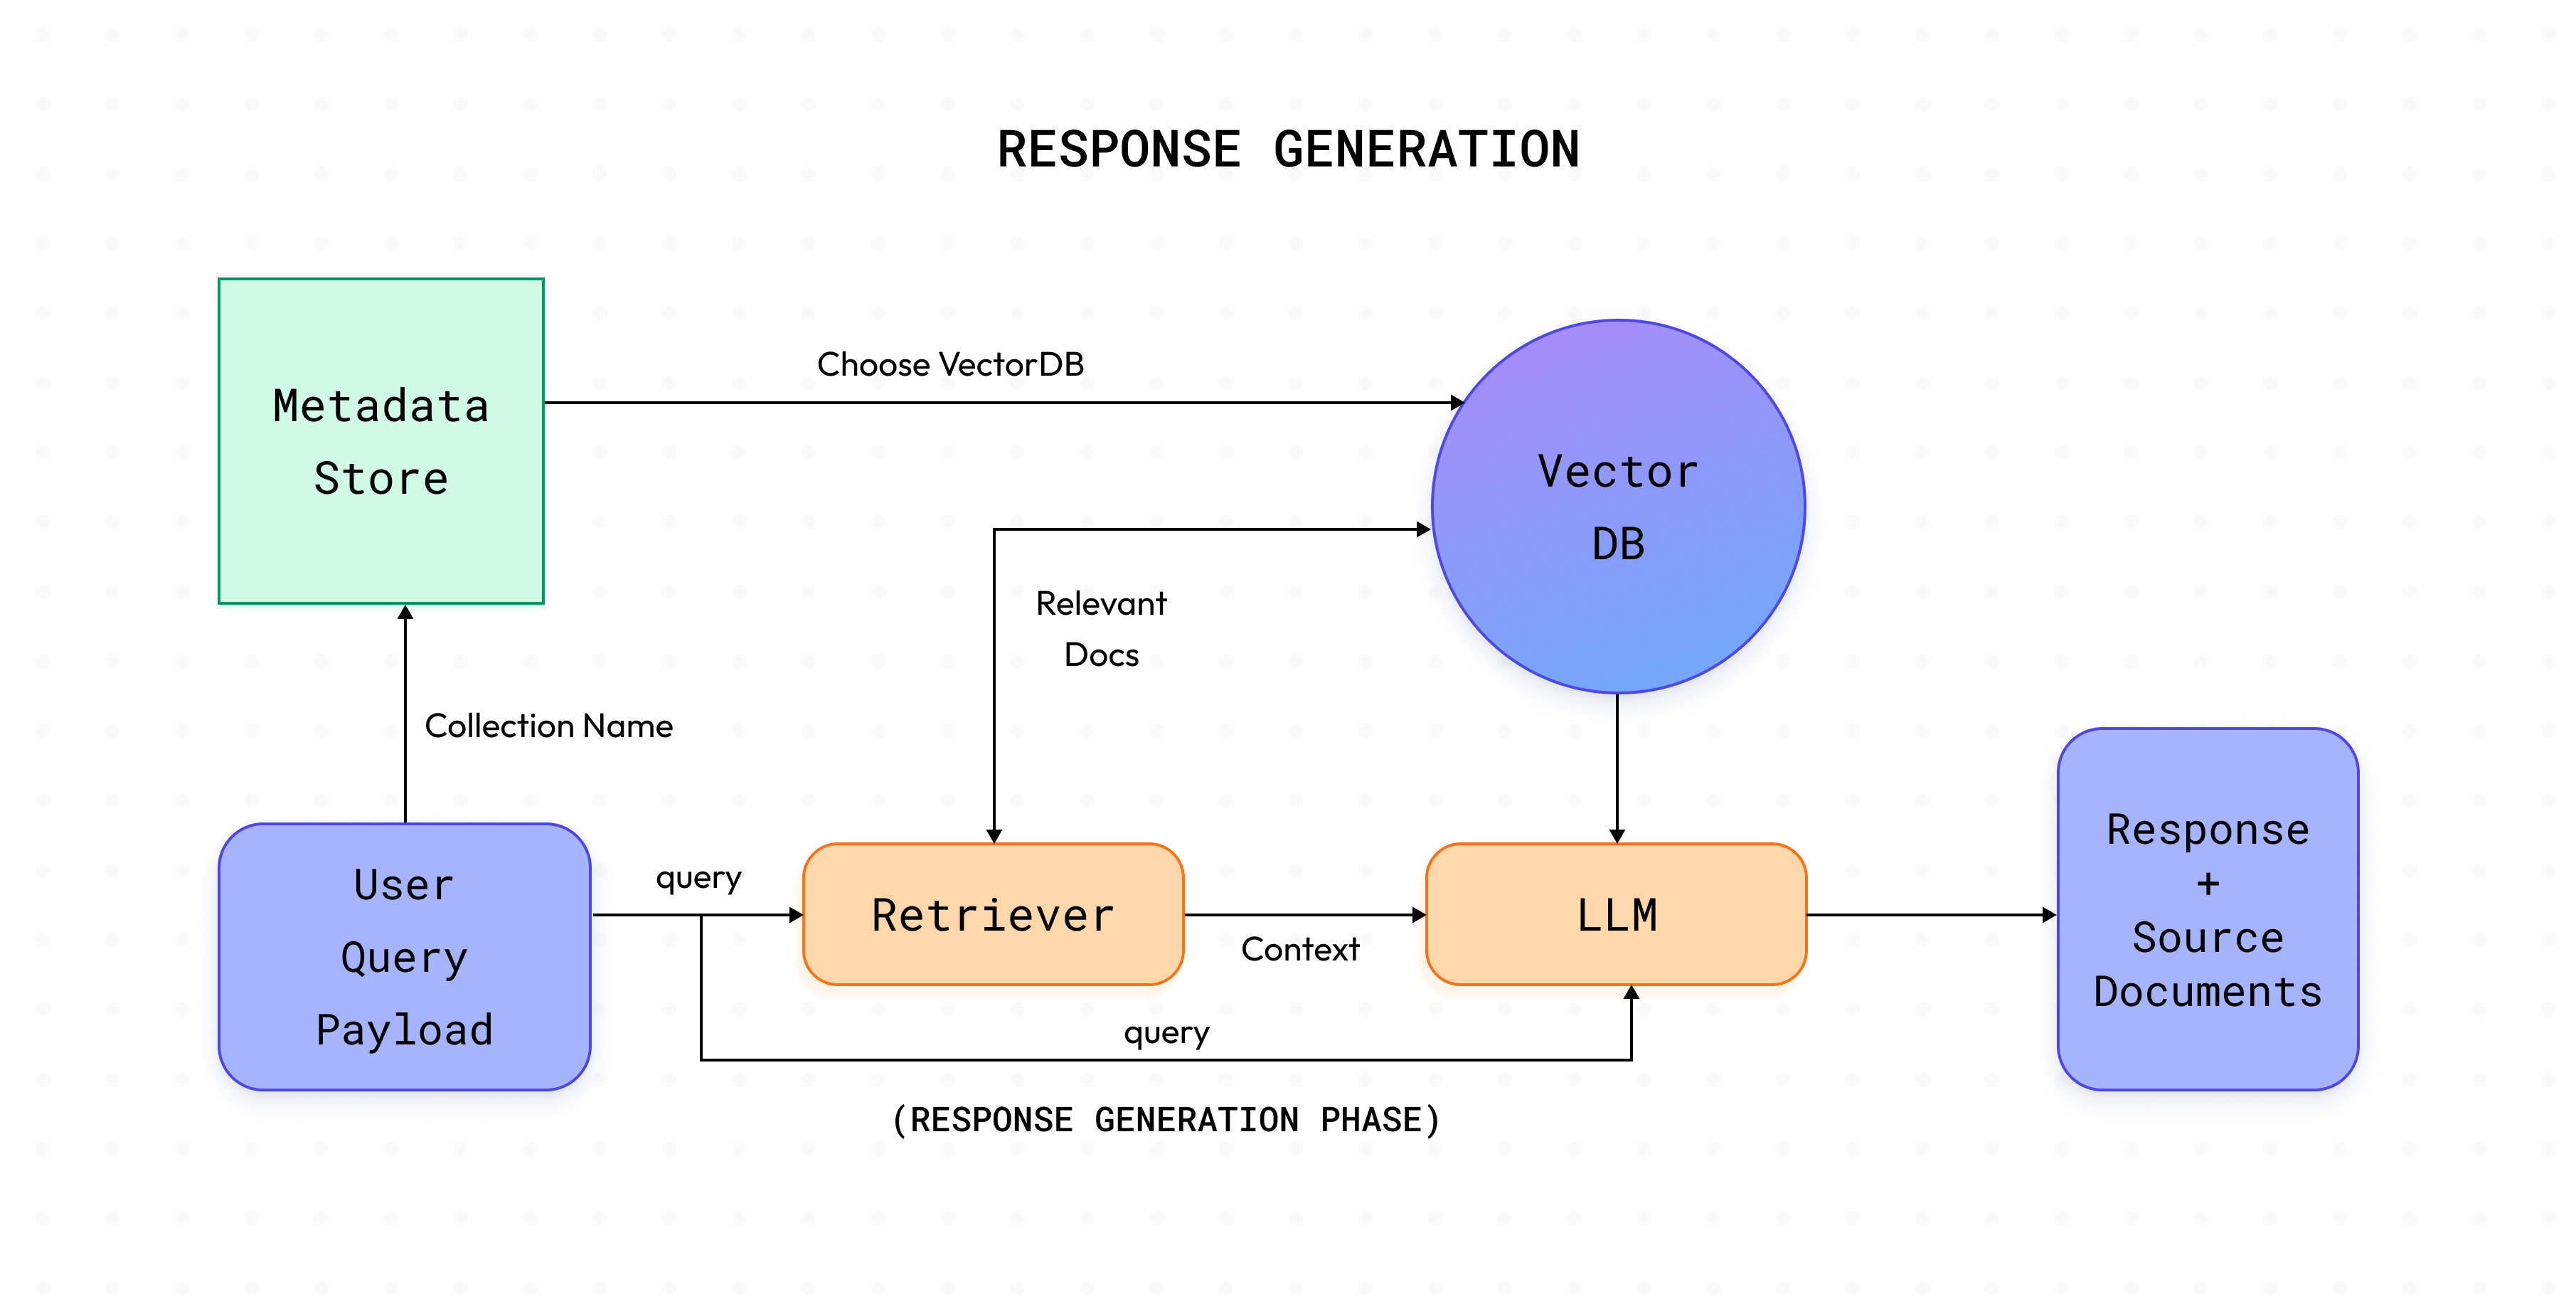
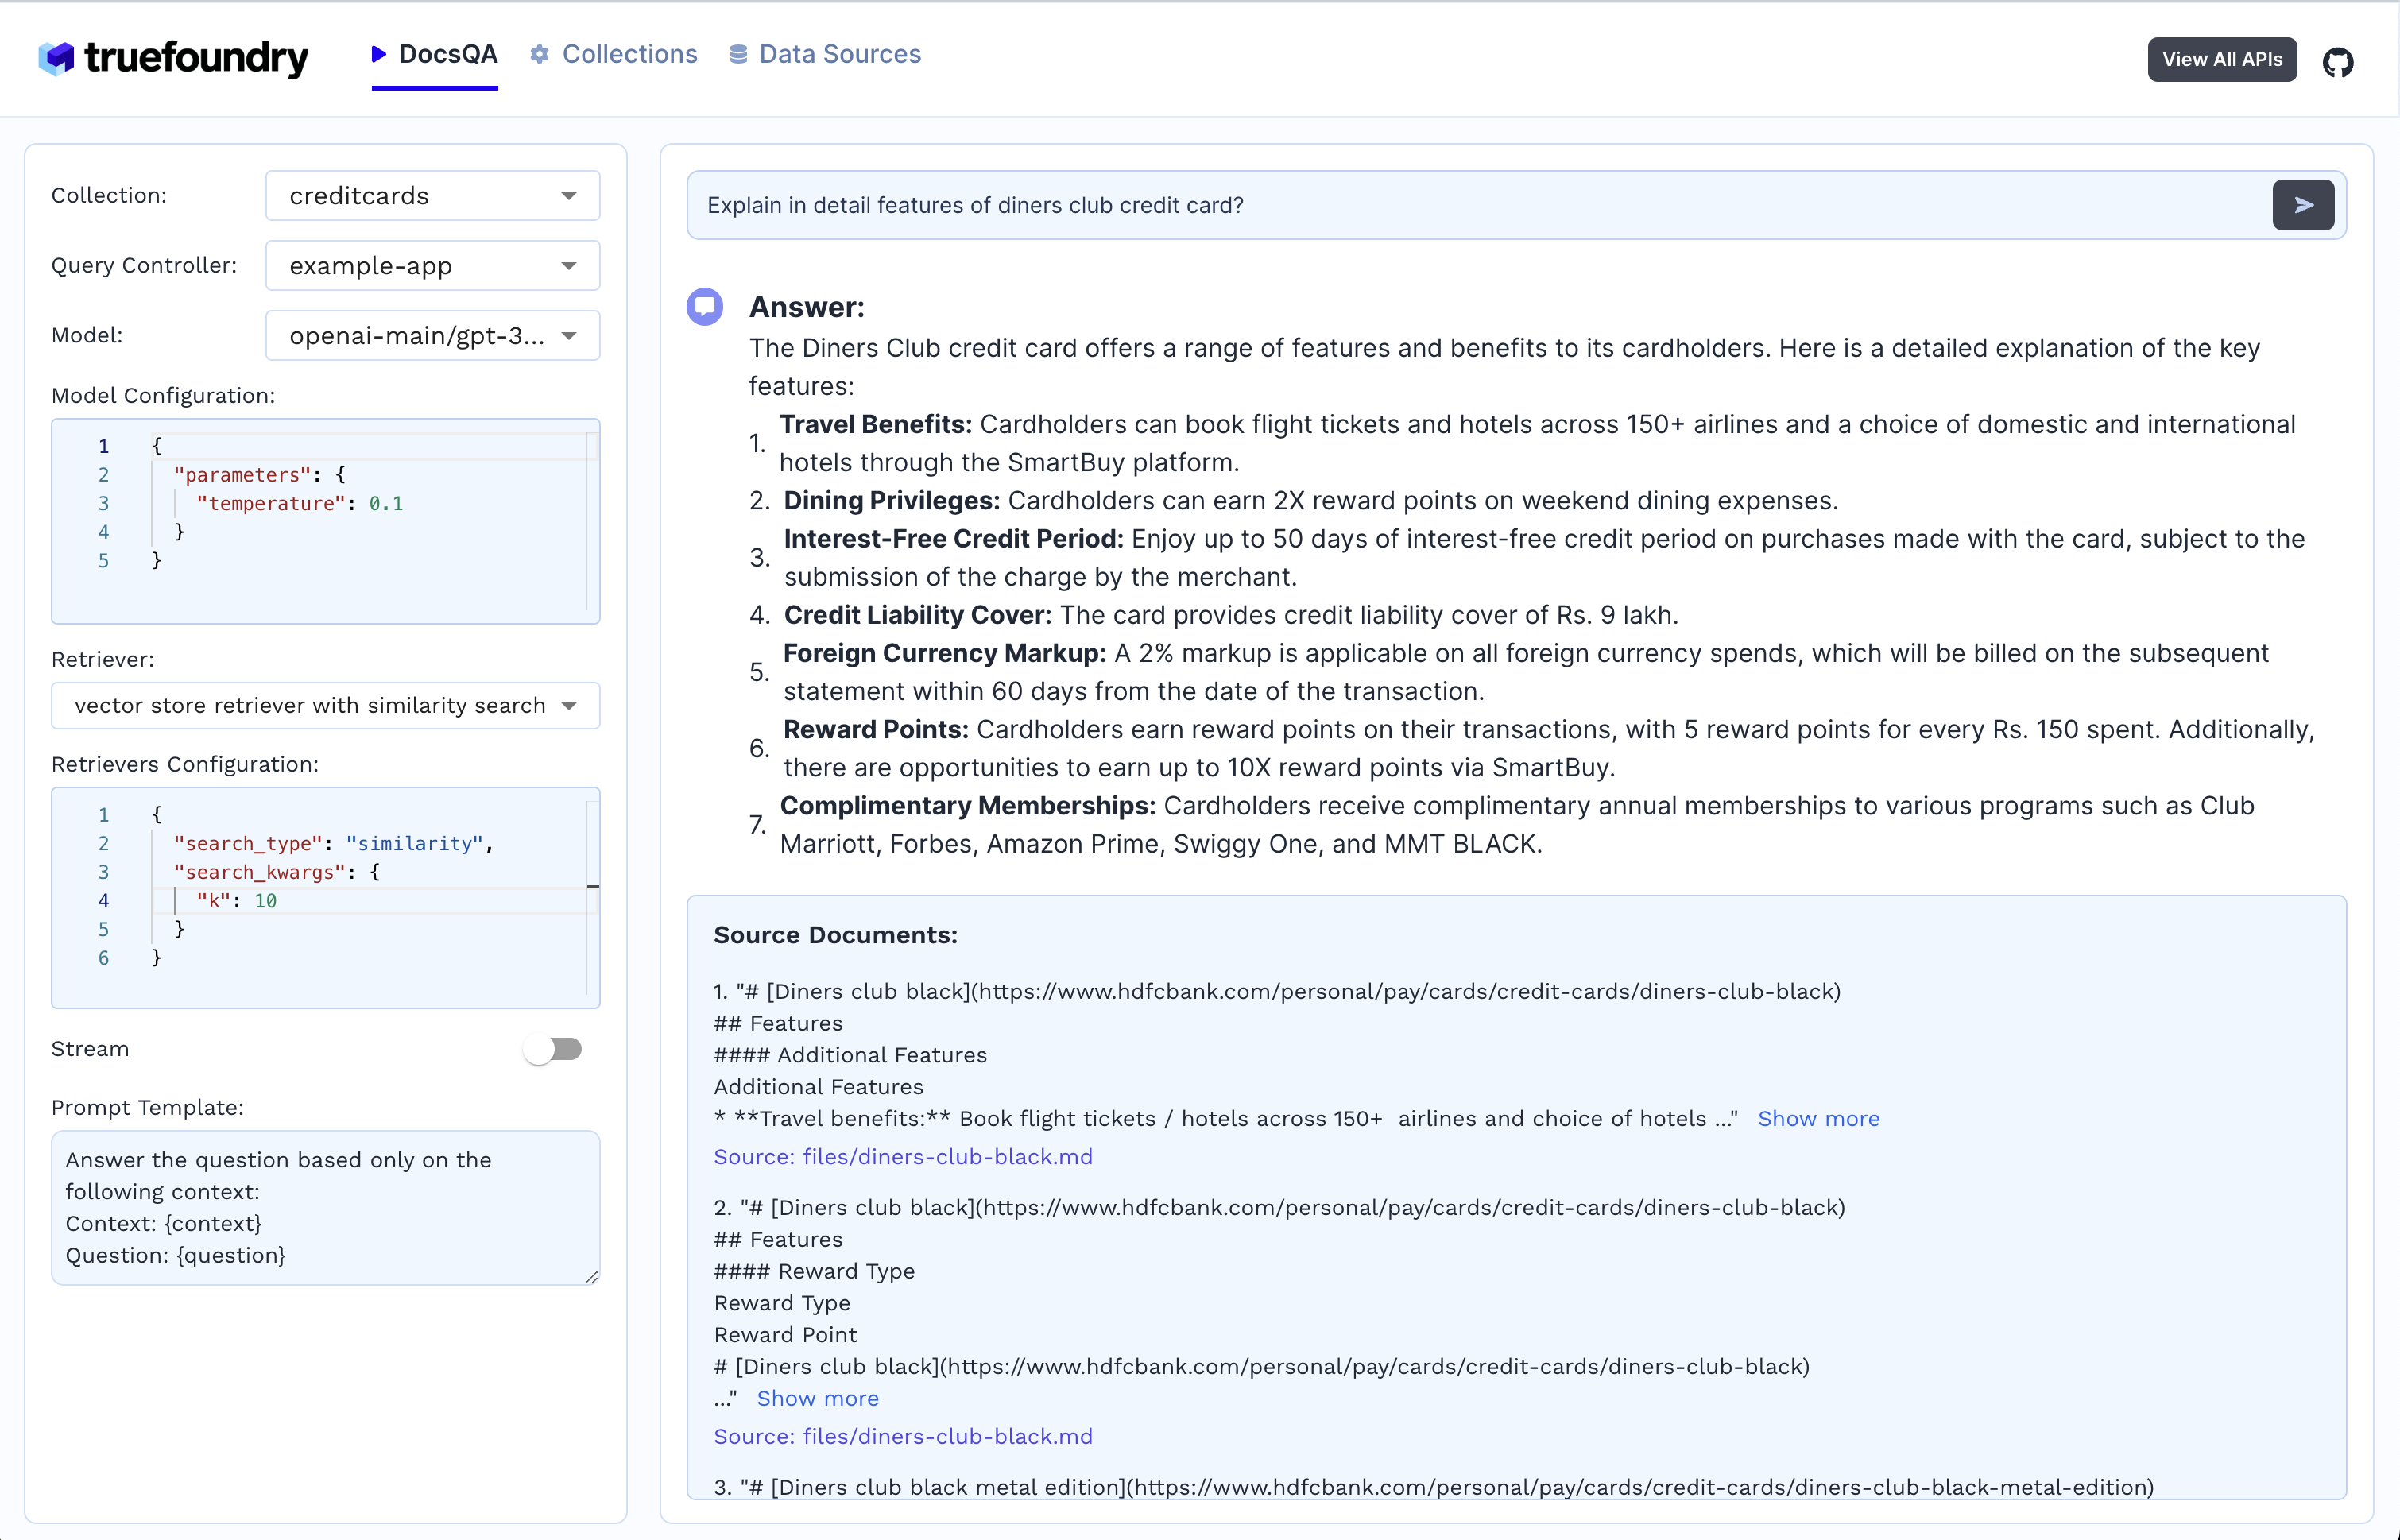
De fase van antwoordgeneratie voert een call uit naar het /answer endpoint van uw gedefinieerde QueryController en genereert het antwoord voor de aangevraagde query.
De volgende stappen laten zien hoe u de Cognita UI kunt gebruiken om documenten te bevragen:
1. Databron aanmaken
Data Sources 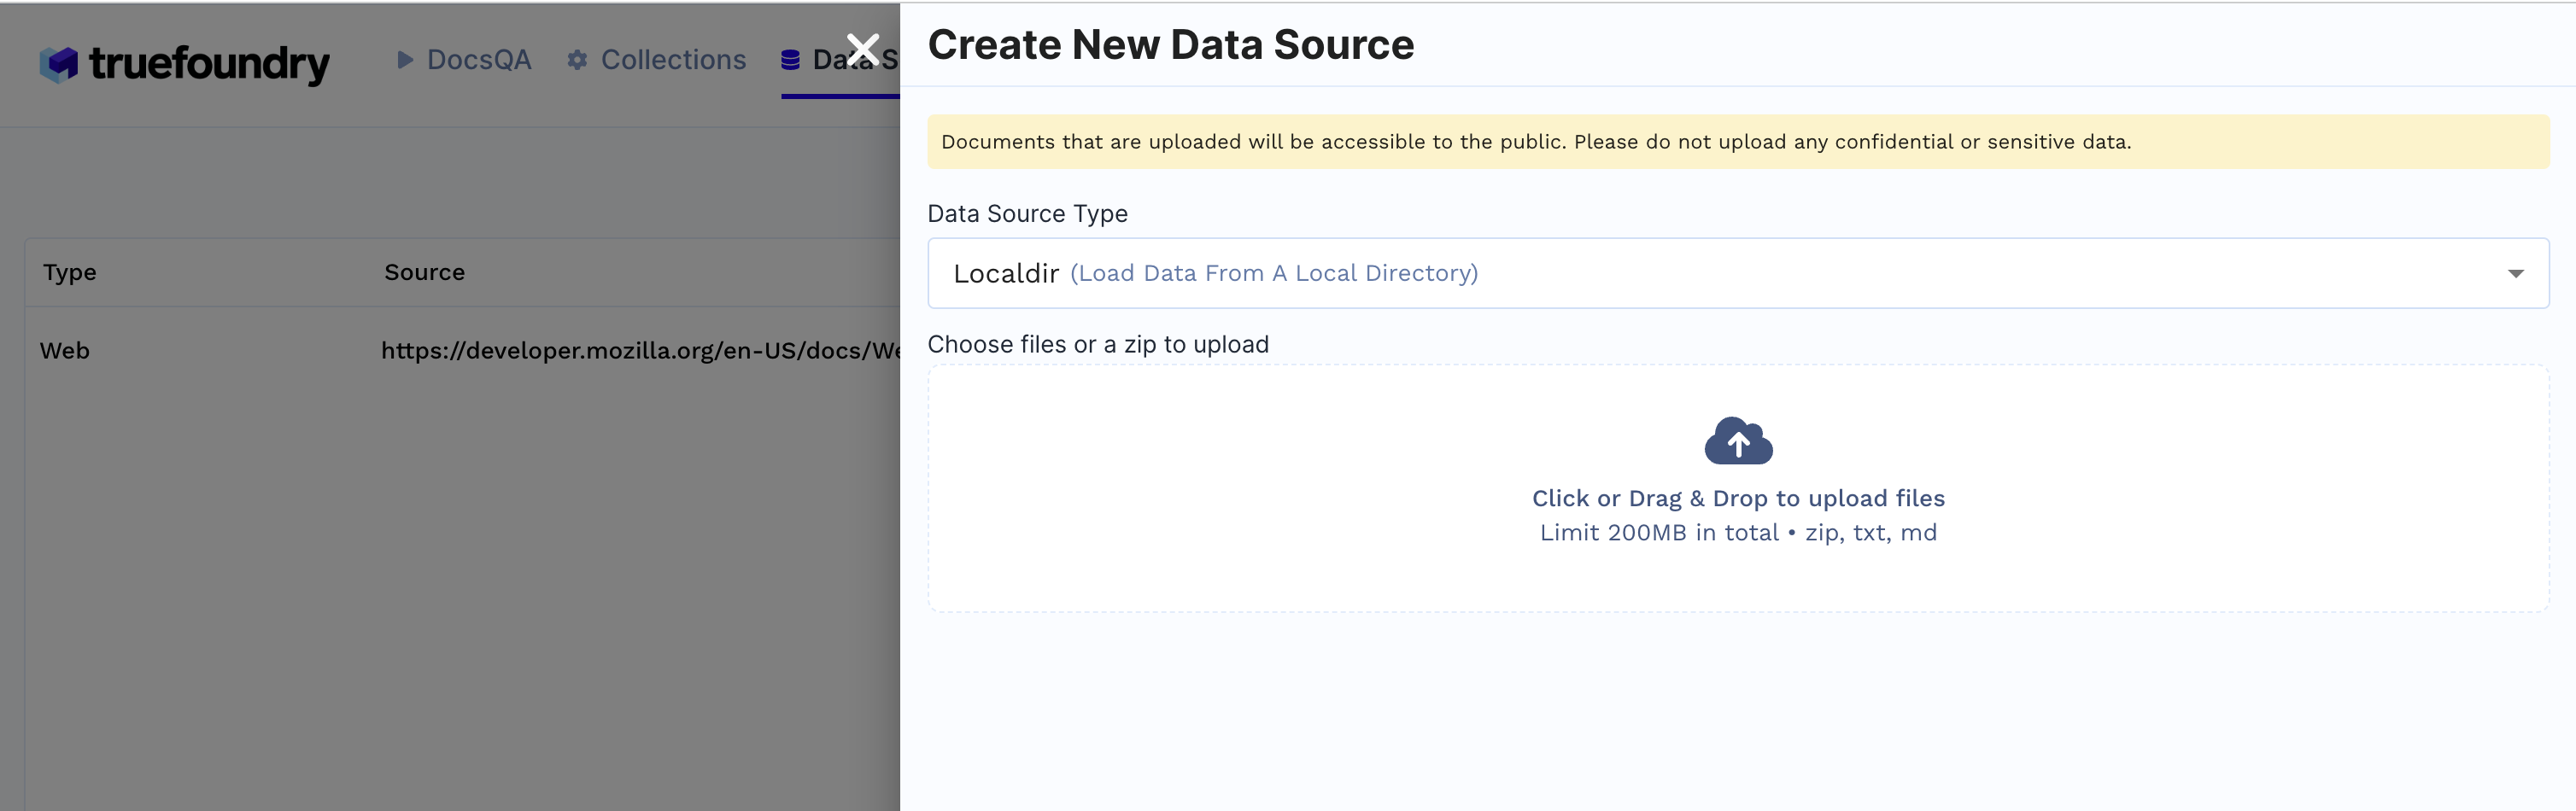
+ New DatasourceLocaldir is geselecteerd, uploadt u bestanden van uw apparaat en klikt u op Submit.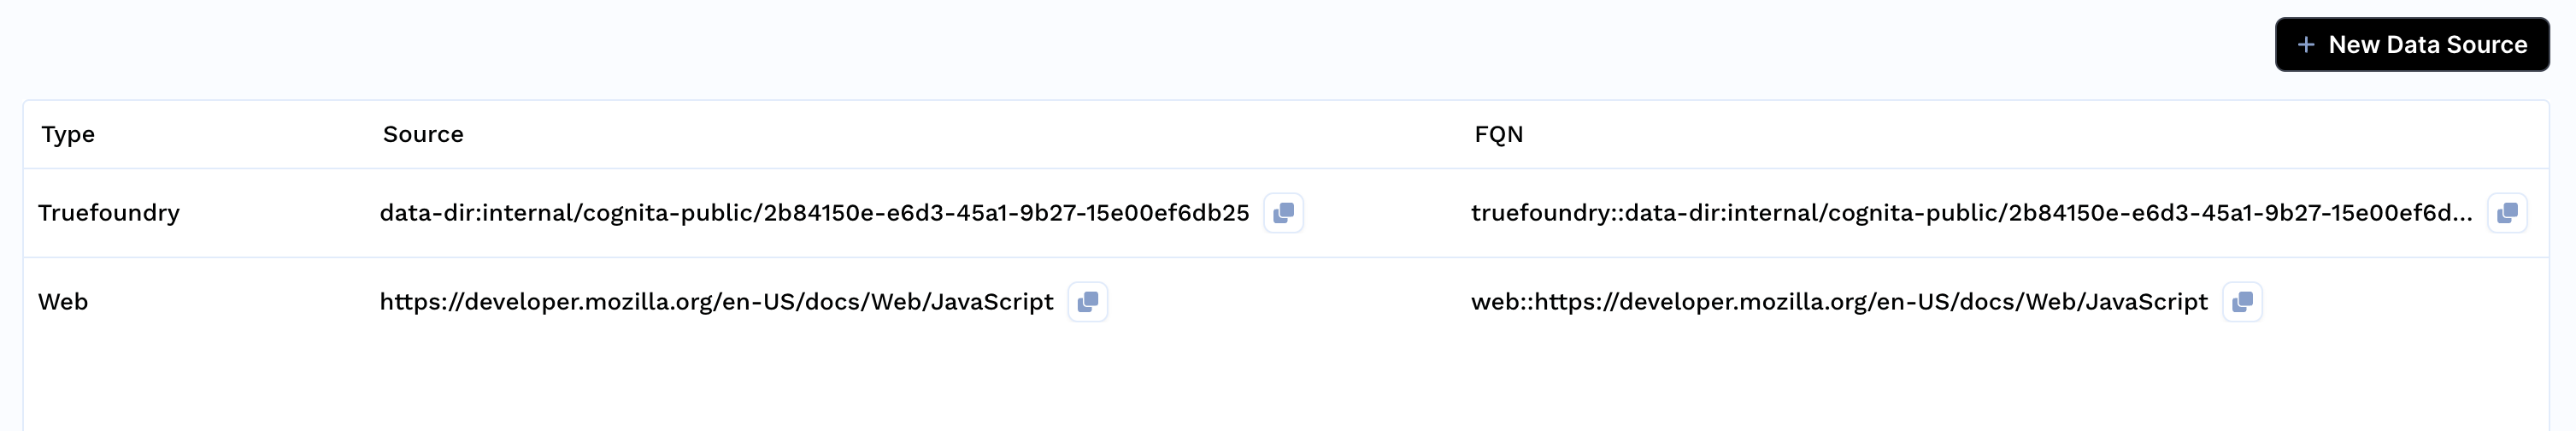
2. Collectie aanmaken
Collections+ New Collection 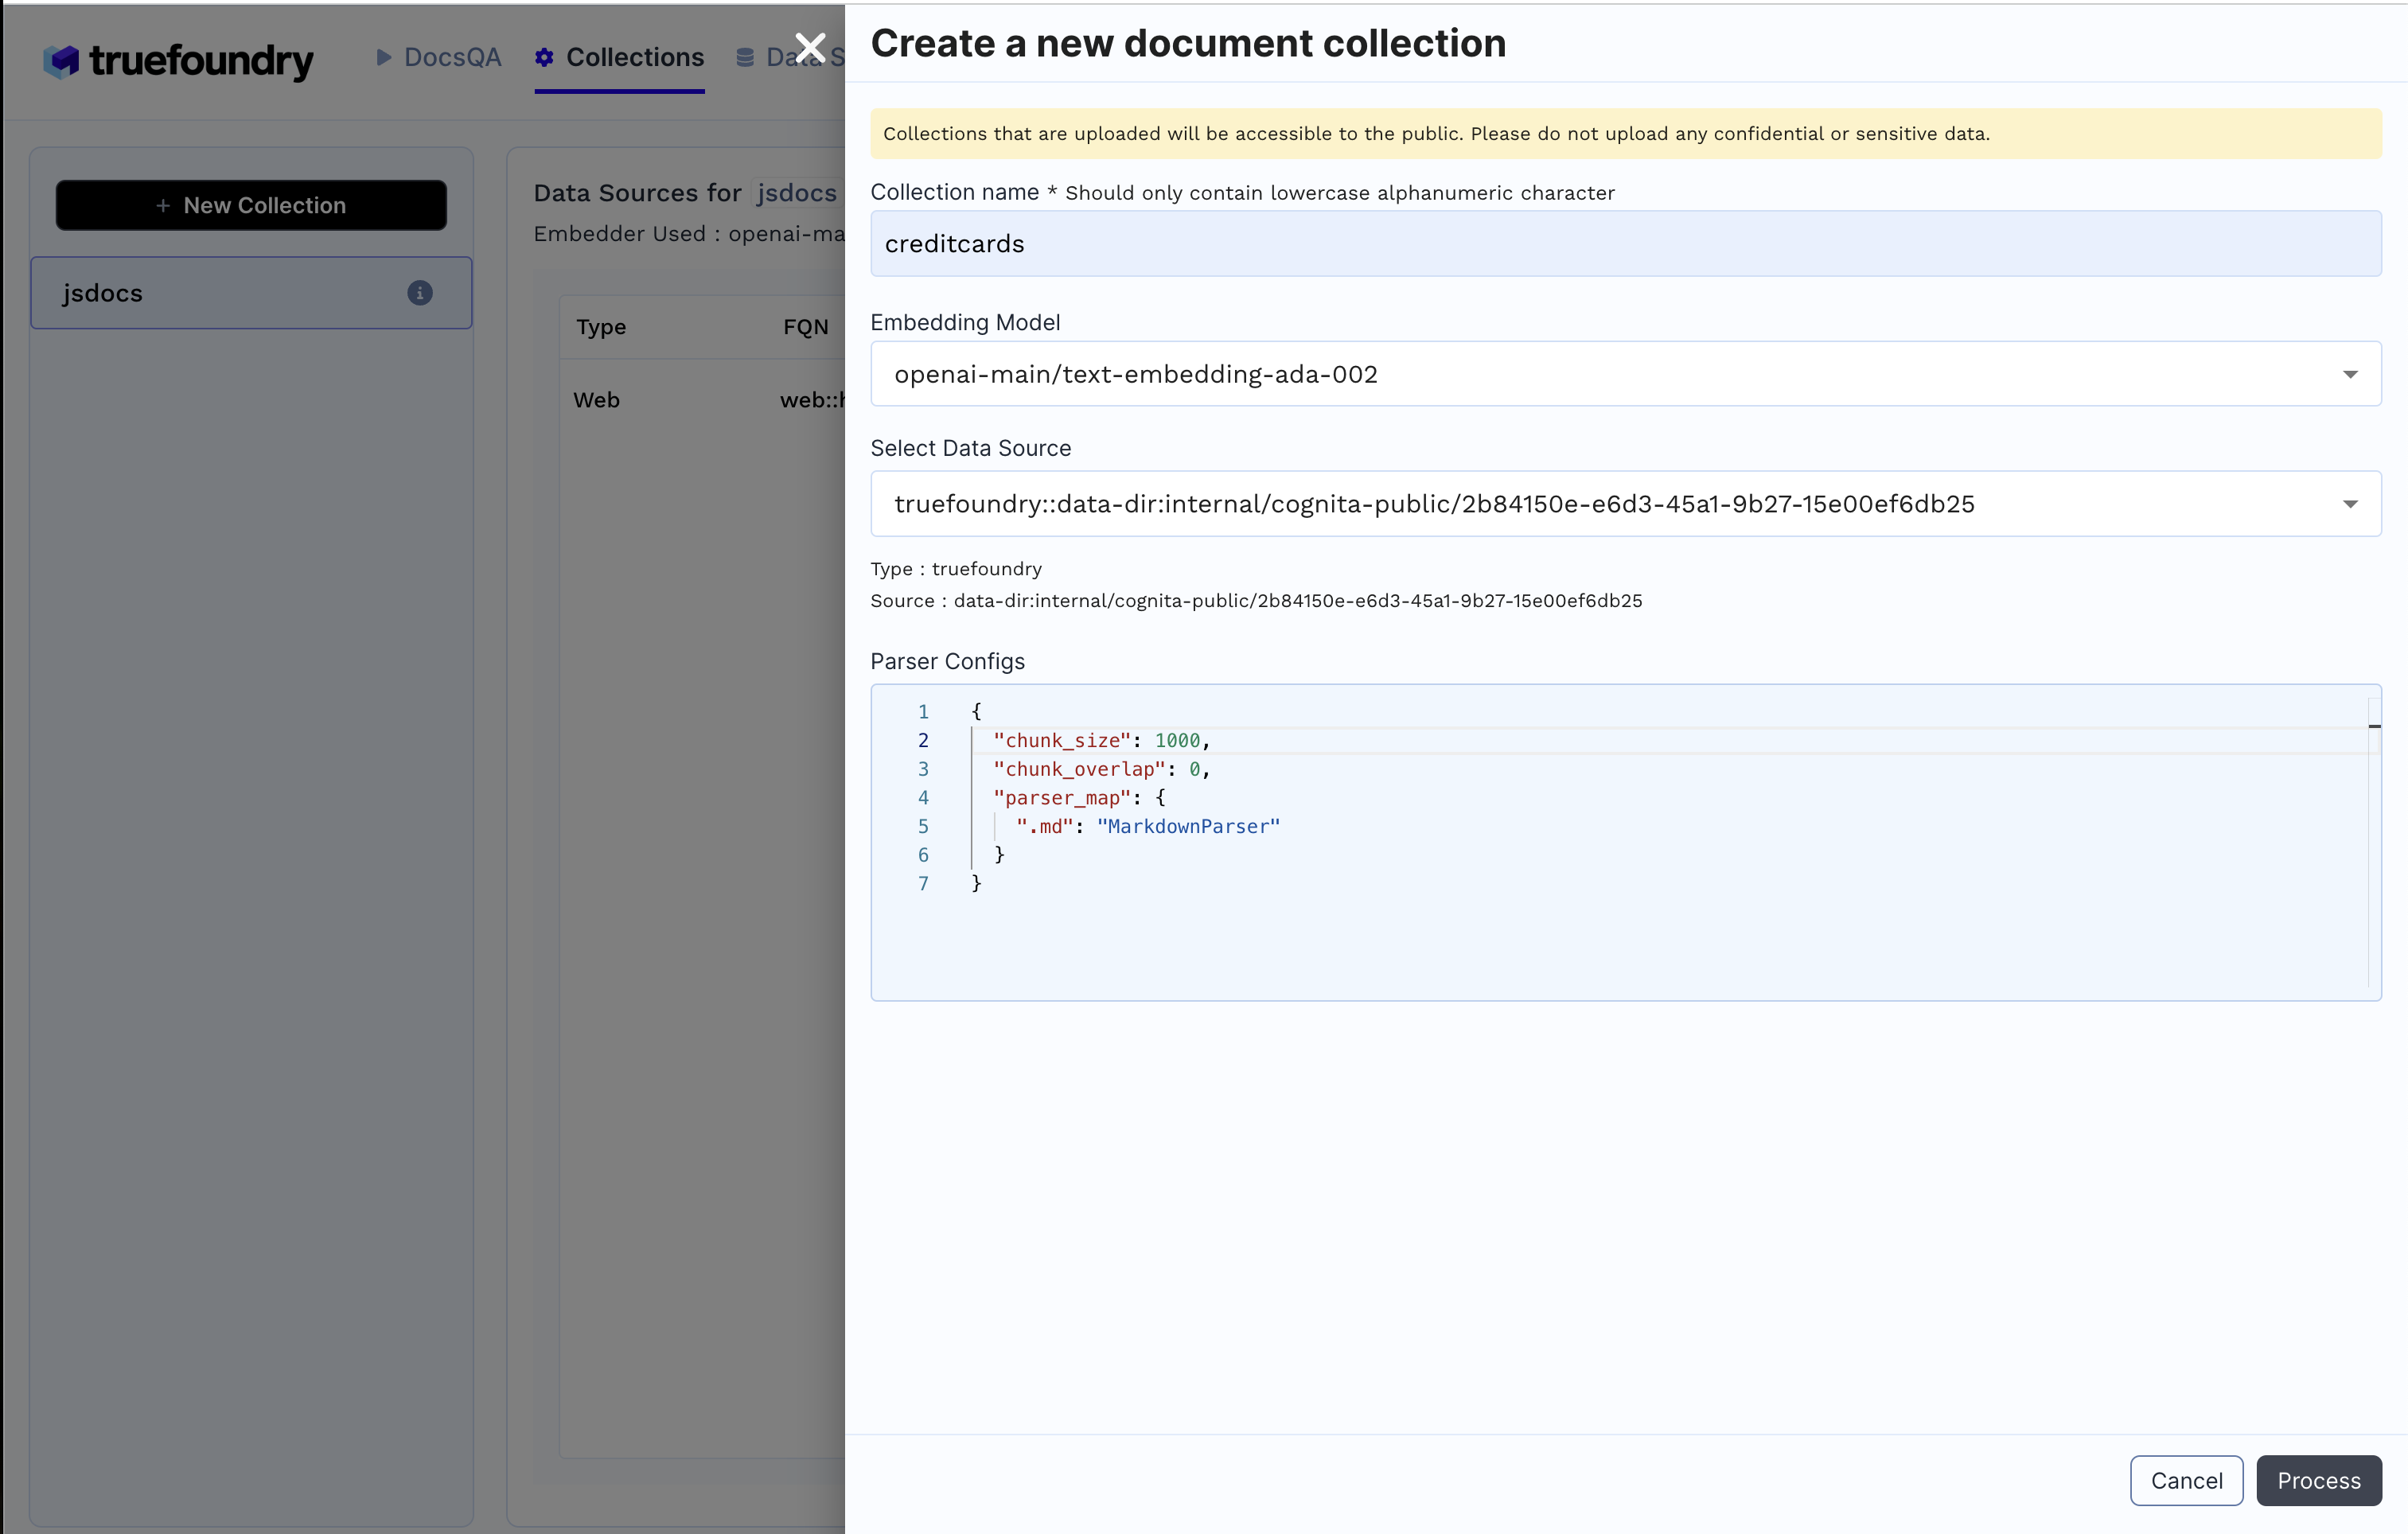
Process om de collectie aan te maken en de data te indexeren. 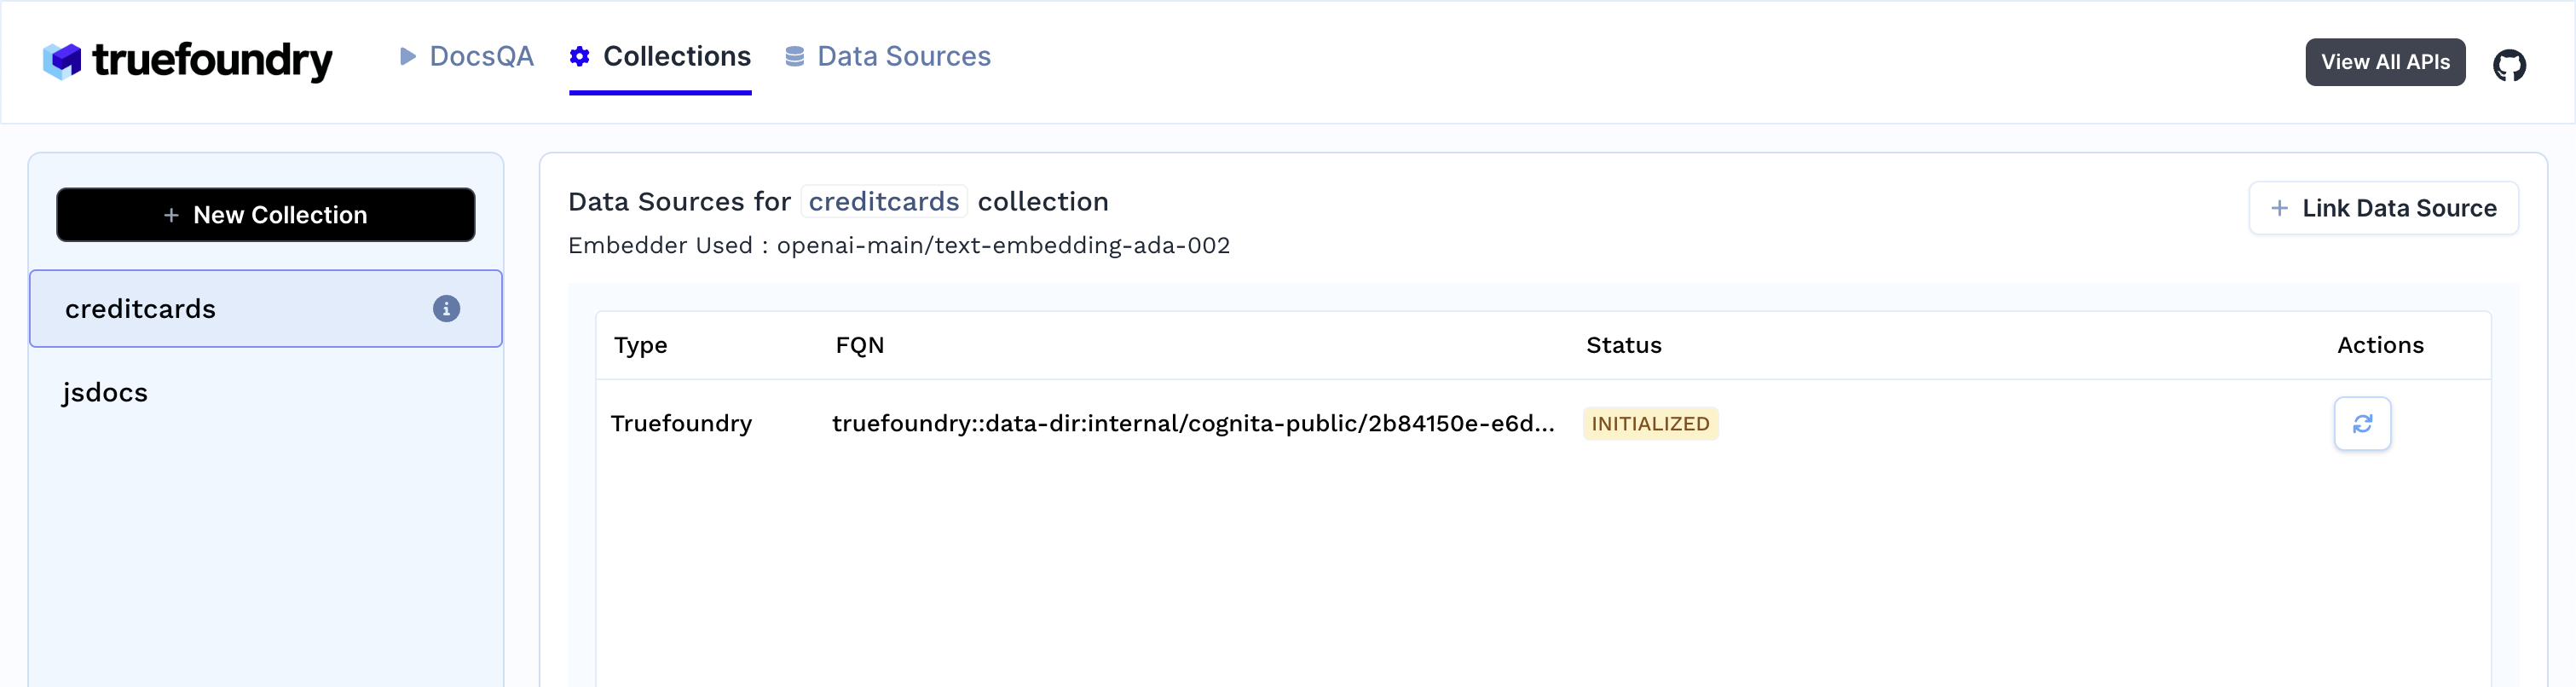
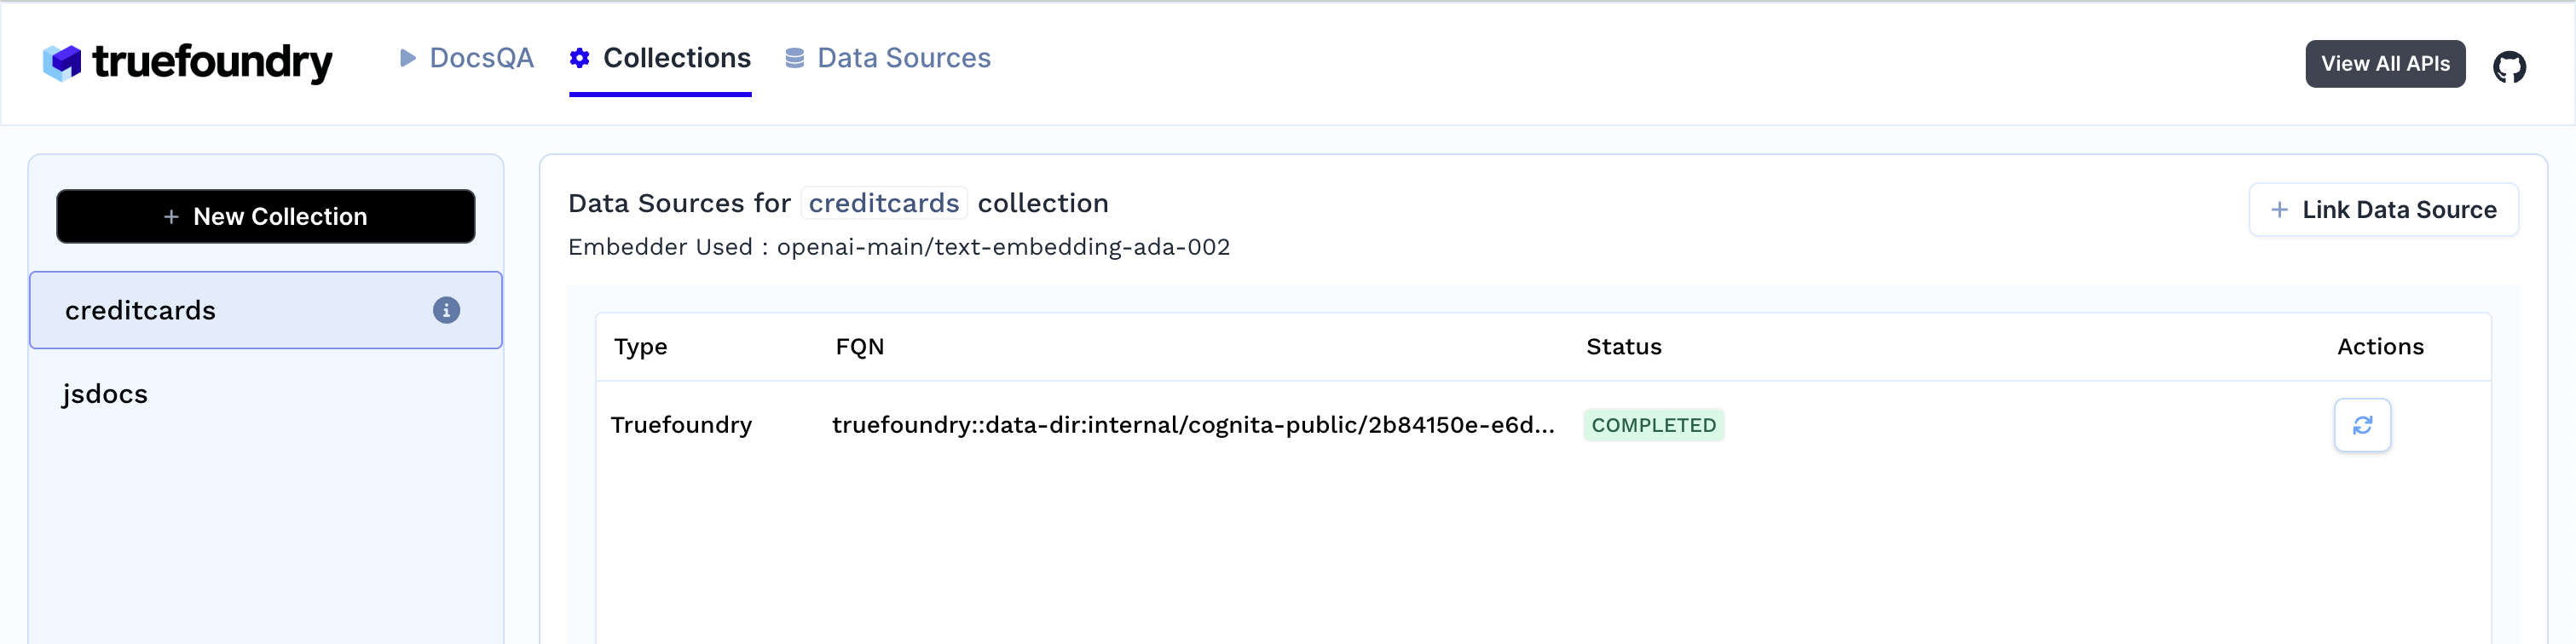
3. Zodra u de collectie aanmaakt, begint de data-ingestie. U kunt de status bekijken door uw collectie te selecteren in het tabblad Collections. U kunt later ook aanvullende databronnen toevoegen en deze in de collectie indexeren.
4. Antwoordgeneratie
Boek een gepersonaliseerde demo of meld u vandaag nog aan om te starten met het bouwen van uw RAG-use-cases.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox