November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.




De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
50 Vragen om in 2026 aan Elke Leverancier te Stellen
Evaluaties van enterprise AI-platformen mislukken op voorspelbare manieren. De demo van de leverancier draait op een zorgvuldig gekozen test-prompt. Hun prijsslide gaat uit van veronderstellingen van 5.000 tokens per call die niet overeenkomen met uw werkelijke werkbelasting. Het diagram van de beveiligingsarchitectuur dat ze tonen, geldt voor een implementatiemodus waarnaar u niet heeft gevraagd. De MCP-functionaliteit waarvan ze beweren dat deze beschikbaar is, komt “in onze volgende release”. Zes weken later tekent u een contract voor een product dat voor 70 procent past, en uw platformteam besteedt de rest van de contractperiode aan het opvullen van de overige 30 procent met maatwerk.
Een gescoorde RFP verandert deze dynamiek. Elke leverancier beantwoordt dezelfde vragen, schriftelijk, voordat er ook maar één demo draait. Hun ontwijkende antwoorden (een ontweken vraag, een functionaliteit die “onze integratiepartner vereist”, een claim inzake naleving die een vraag over de reikwijdte niet overleeft) komen naar boven in het schriftelijke dossier, waar ze in een vervolggesprek niet meer verdraaid kunnen worden. Datzelfde dossier houdt de leverancier verantwoordelijk wanneer de werkelijkheid na ondertekening begint af te wijken van de verkooppitch vóór ondertekening — de meest voorkomende klacht bij de inkoop rond de verlenging na het eerste jaar.
Drie zaken tillen dit sjabloon uit boven wat algemene inkoopkaders voor ondernemingen al dekken. MCP-governance, de protocol-stack die uw AI-agents gebruiken om met tools te communiceren, waar de meeste AI gateway-producten nog steeds toegangscontrole achteraf toevoegen waarvoor ze niet ontworpen zijn. Agentic AI-controles, de trace-correlatie, kostentoewijzing en isolatiegrenzen die een uit meerdere stappen bestaande agent-taak veranderen in een debugbare, factureerbare en beheerbare eenheid in plaats van een mist van losgekoppelde LLM-calls. AI-specifieke compliance, waaronder pariteit van velden in audit-logs tussen LLM- en tool-aanroepen, gestructureerde antwoorden over dataresidentie die rekening houden met de routing van modelproviders over regio's heen, en de architecturale BAA-controles die HIPAA-handhaving werkelijkheid maken in plaats van papierwerk.
Gebruik dit als uitgangspunt. Pas de weging aan uw omgeving aan. Stuur hetzelfde document naar elke leverancier op uw shortlist. Het solutions team van TrueFoundry is ingericht om alle 50 vragen schriftelijk te beantwoorden met bewijslast als onderdeel van de formele enterprise-evaluatie.
Nu naar de vragen zelf.

Figuur 1. Split-plane referentiearchitectuur: control plane en compute plane gescheiden door een boundary met uitsluitend metadata, waarbij één IdP identiteit aan beide levert.
De volgorde van de stappen is belangrijker dan de vragen zelf. De meeste mislukte evaluaties slaan stap één over: het verkrijgen van schriftelijke antwoorden op het volledige sjabloon voordat een leverancier een demo mag geven. Demo's zijn bedoeld ter verificatie van schriftelijke beweringen, niet voor verkenning. Als de eerste communicatie van een leverancier over een functie afkomstig is van een slide, heeft u de controle over het evaluatieverhaal uit handen gegeven.
Stuur het sjabloon tegelijkertijd naar elke leverancier op uw shortlist, met een deadline voor schriftelijke reactie over twee weken. Gebruik de antwoorden om te scoren op basis van een gewogen rubric. Pas na het scoren plant u demo's in, en in die demo's is het de taak van uw platformteam om te verifiëren of wat schriftelijk is vastgelegd overeenkomt met wat er draait. Beschouw elke claim die tijdens de demo naar boven komt maar niet in het schriftelijke antwoord stond als een bevinding om te onderzoeken, niet als een functie om positief te scoren.
Een paar specifieke punten om dit goed uit te voeren:
Als u ooit bij een beveiligingsbeoordeling heeft gezeten waarbij de compliance-reikwijdte van de leverancier alleen betrekking had op de SaaS-optie die u niet van plan was te gebruiken, kent u de kosten van het overslaan van de rubric-stap. Een gescoorde RFP dwingt dat detail voorafgaand aan het contract af.
Beveiliging en compliance is het punt waar de meeste evaluaties van AI-platformen in de tweede vergadering vastlopen. Niet omdat het leveranciers aan certificeringen ontbreekt. De meeste hebben ergens wel een SOC 2 Type II. Het probleem is de afstemming: de certificeringsreikwijdte, de architecturale controles die deze implementeren en de implementatiemodus die u daadwerkelijk koopt, komen niet overeen. Een SOC 2 die de marketingportal van de leverancier dekt, doet niets voor een AI gateway die PHI on-premise verwerkt. Een BAA die als sjabloon bestaat maar niet beschrijft hoe PHI in het data plane is geïsoleerd, is papierwerk, geen controle. De onderstaande vragen dwingen de afstemming af tussen certificeringsreikwijdte en architecturale werkelijkheid, wat voorkomt dat antwoorden zoals “wij zijn gecertificeerd” een gewicht krijgen dat ze niet verdienen.
De andere valkuil die vroeg genoemd moet worden: leveranciers die beveiligingsvragen in het abstracte beantwoorden omdat hun concrete architectuur is verdeeld over twee producten met verschillende beveiligingsniveaus. Hun on-premise-versie heeft weinig functionaliteiten en is niet afzonderlijk gecertificeerd. Hun SaaS-versie heeft de certificeringen, maar past niet in uw omgeving. Herken dit door dezelfde vraag twee keer te stellen, waarbij u telkens de implementatiemodus specificeert. Als de antwoorden verschillen, kijkt u naar twee producten die als één worden op de markt gebracht.
Score deze sectie meedogenloos.
Een split-plane implementatie waarbij het data plane (de proxy die prompts, modelreacties, embeddings en MCP tool-aanroepen afhandelt) volledig in de VPC van de klant draait en nooit een uitgaande verbinding naar de infrastructuur van de leverancier opent voor verzoekladingen (payloads). Het control plane (configuratie, RBAC-instellingen, dashboards) kan afhankelijk van de implementatiemodus in de infrastructuur van de leverancier of de klant draaien, maar wisselt uitsluitend metadata uit. Audit-logs, prompt-responsgegevens en embeddings komen terecht in door de klant beheerde blob-storage (S3, GCS, Azure Blob), niet in door de leverancier beheerde databases. Als de “VPC-implementatie” van de leverancier nog steeds prompts naar een door de leverancier beheerde log-aggregator stuurt, is dat een SaaS-implementatie in een ander jasje.
Controleer de sectie Systeembeschrijving op het expliciet noemen van de gedekte implementatiemodi. Zoek naar formuleringen zoals “de multi-tenant SaaS-omgeving gehost in [cloud]” versus “de door de klant geïmplementeerde gateway- en control plane-componenten”. Als de beschrijving er slechts één noemt, dekt de certificering er slechts één. Controleer de gedekte Trust Services Criteria. Beveiliging is de basis, maar Beschikbaarheid, Vertrouwelijkheid en Verwerkingsintegriteit zijn van belang voor AI-werkbelastingen die gereguleerde gegevens verwerken. Een SOC 2 die alleen Beveiliging dekt, is het halve verhaal.
Het platform haalt sleutels van modelproviders uit de Vault of Secrets Manager van de klant bij het opstarten van de gateway of op verzoek met behulp van een door de klant beheerde IAM-rol, waarbij sleutelreferenties (niet de sleutelwaarden zelf) in de platformconfiguratie worden opgeslagen. Rotatie is een Vault-handeling: overschrijf de sleutel in Vault, de gateway haalt de nieuwe waarde op bij de volgende lezing of op een configureerbaar vernieuwingsinterval. Het platform slaat sleutels van providers nooit in rust op. Als het antwoord van de leverancier is “u uploadt sleutels in onze admin-UI en wij slaan ze versleuteld op”, is dat een ander (en zwakker) beveiligingsmodel. De sleutels bevinden zich nu in de infrastructuur van de leverancier, zelfs bij een “VPC”-implementatie.
De log-regel voor de MCP tool-aanroep moet pariteit van velden hebben voor de gedeelde dimensies (timestamp, request_id, trace_id, user, application, latency_ms, status, policy decision) plus de tool-specifieke velden:
Let op dezelfde trace_id op beide plekken: de LLM-call en de MCP-aanroep zijn gecorreleerd aan één gebruikersverzoek, wat het concrete antwoord is op vraag 8 van Sectie 4. Hash de parameters in plaats van ze onbewerkt te loggen. Het volledig loggen van parameters vormt een risico op datalekken in gereguleerde omgevingen. Als in het MCP-voorbeeldlog van de leverancier policy.decision, trace_id of user attribution ontbreken, is MCP-governance rapportage achteraf en geen handhaving.

Figuur 2. Gegevensstroom van audit-logs: pariteit van velden tussen LLM-inference-gebeurtenissen en MCP tool-aanroepgebeurtenissen, beide gecorreleerd door één trace_id.
“Versleuteld in rust” is universeel. Wiens sleutel de versleuteling uitvoert, is de werkelijke controle. In een self-hosted implementatie zijn door de klant beheerde sleutels haalbaar omdat de datastores zich in het account van de klant bevinden; in een SaaS-implementatie zijn door de klant beheerde sleutels een functionaliteit aan de leverancierszijde die ontworpen moet zijn. Stel de vraag met de gespecificeerde implementatiemodus.
Voor self-hosted implementaties betekent “beschikbaarheid patch” een getagde release die het platformteam van de klant kan implementeren. “Tijdsbestek voor toepassing door klant” is de SLA waaraan de klant zich intern verbindt. Als de leverancier een tijdsbestek van 30 dagen voor de klant voorstelt voor kritieke CVE's, is dat een lange periode om kwetsbaar te zijn; bied hier weerstand tegen.
De meeste inkooptrajecten bij grote ondernemingen lopen vast op de implementatie. Het platform ziet er geweldig uit in de SaaS-demo, waarna de beveiligingsbeoordeling drie dingen aan het licht brengt die het blokkeren: uitgaande connectiviteit naar de infrastructuur van de leverancier voor telemetrie, een configuratiedatabase die in de cloud van de leverancier wordt gehost, en een control plane dat nauw gekoppeld is aan een specifieke cloudregio. Tegen de tijd dat die beperkingen zichtbaar worden, heeft u al onderhandeld over de prijs van het verkeerde product, en de weg voorwaarts is ofwel heronderhandelen vanuit een positie van gemaakte kosten, ofwel akkoord gaan met een implementatie die een schuld op het gebied van compliance creëert.
Deze sectie brengt implementatiebeperkingen vooraf in kaart. De leveranciers die deze vragen strak kunnen beantwoorden, zijn degenen die al zijn geïmplementeerd in omgevingen zoals de uwe. De leveranciers die een verkenningsgesprek nodig hebben om Sectie 2 te beantwoorden hebben dat niet, en u zult de integratie-engineering uitvoeren tijdens het verkenningsgesprek waarvoor u hen betaalt.
Let goed op de antwoorden.
Indicatieve schatting van de omvang voor ~500 RPS continu: 3 tot 4 gateway-replica's met elk 2 vCPU / 4 GB RAM, Postgres op 4 vCPU / 16 GB RAM met 100 GB SSD, blob-storage geschaald op basis van de bewaartermijn (een bewaartermijn van 90 dagen bij 10 KB/log-regel en 500 RPS is ongeveer 1,2 TB). De leverancier moet dit soort getallen schriftelijk verstrekken vóór ondertekening, en niet “afhankelijk van werkbelasting”.

Figuur 3. Eén control plane dat gelijktijdig compute planes beheert over AWS, Azure, GCP en on-premise Kubernetes, elk met zijn eigen grens voor dataresidentie.
Alles wat slechter is dan dit voor een multi-region productie-inrichting moet vergezeld gaan van een schriftelijke uitleg. “Wij ondersteunen geen multi-region” is acceptabel van een kleine leverancier; “wij ondersteunen het, maar leggen geen RTO vast” is dat niet.
Elke productpagina van een AI gateway leest hetzelfde: universele API, intelligente routing, kostenbeheersing, observability. De details achter die woorden scheiden een gateway die u in productie kunt laten draaien van een dunne proxy met een marketingwebsite. “Intelligente routing” kan van alles betekenen, van een statische round-robin tussen twee modellen tot een werkelijk cascade-beleid met kostenplafonds, afstemming van functionaliteiten en fallback-ketens. “Kostenbeheersing” kan een dashboard betekenen dat u de rekening van gisteren toont, of het kan harde tokenbudgetten betekenen die daadwerkelijk een 429 aan de applicatie retourneren wanneer een team zijn limiet bereikt.
De vragen in deze sectie dwingen de details naar boven. Wijs antwoorden af die de marketingtekst alleen maar herhalen. De leverancier die zegt “wij ondersteunen intelligente routing” zonder de regeltaal, het cascadegedrag, de afhandeling van fouten en de integratie met budgetten te beschrijven, heeft geen routing. Ze hebben een configuratievlag.
Laat hen bewijzen dat de architectuur bestaat.
De applicatie stuurt een standaard OpenAI-compatibel verzoek. De gateway kiest de provider op basis van de regel, valt bij storing terug op de cascade, voegt de budgetreferentie toe voor kostentoewijzing en past inline guardrails toe. Er veranderen geen applicatiecodes wanneer de route opnieuw wordt geconfigureerd. Als de "intelligente routing" van de leverancier voor elke variant wijzigingen op applicatieniveau vereist, is dat geen routing op gateway-niveau. Het is een wrapper.
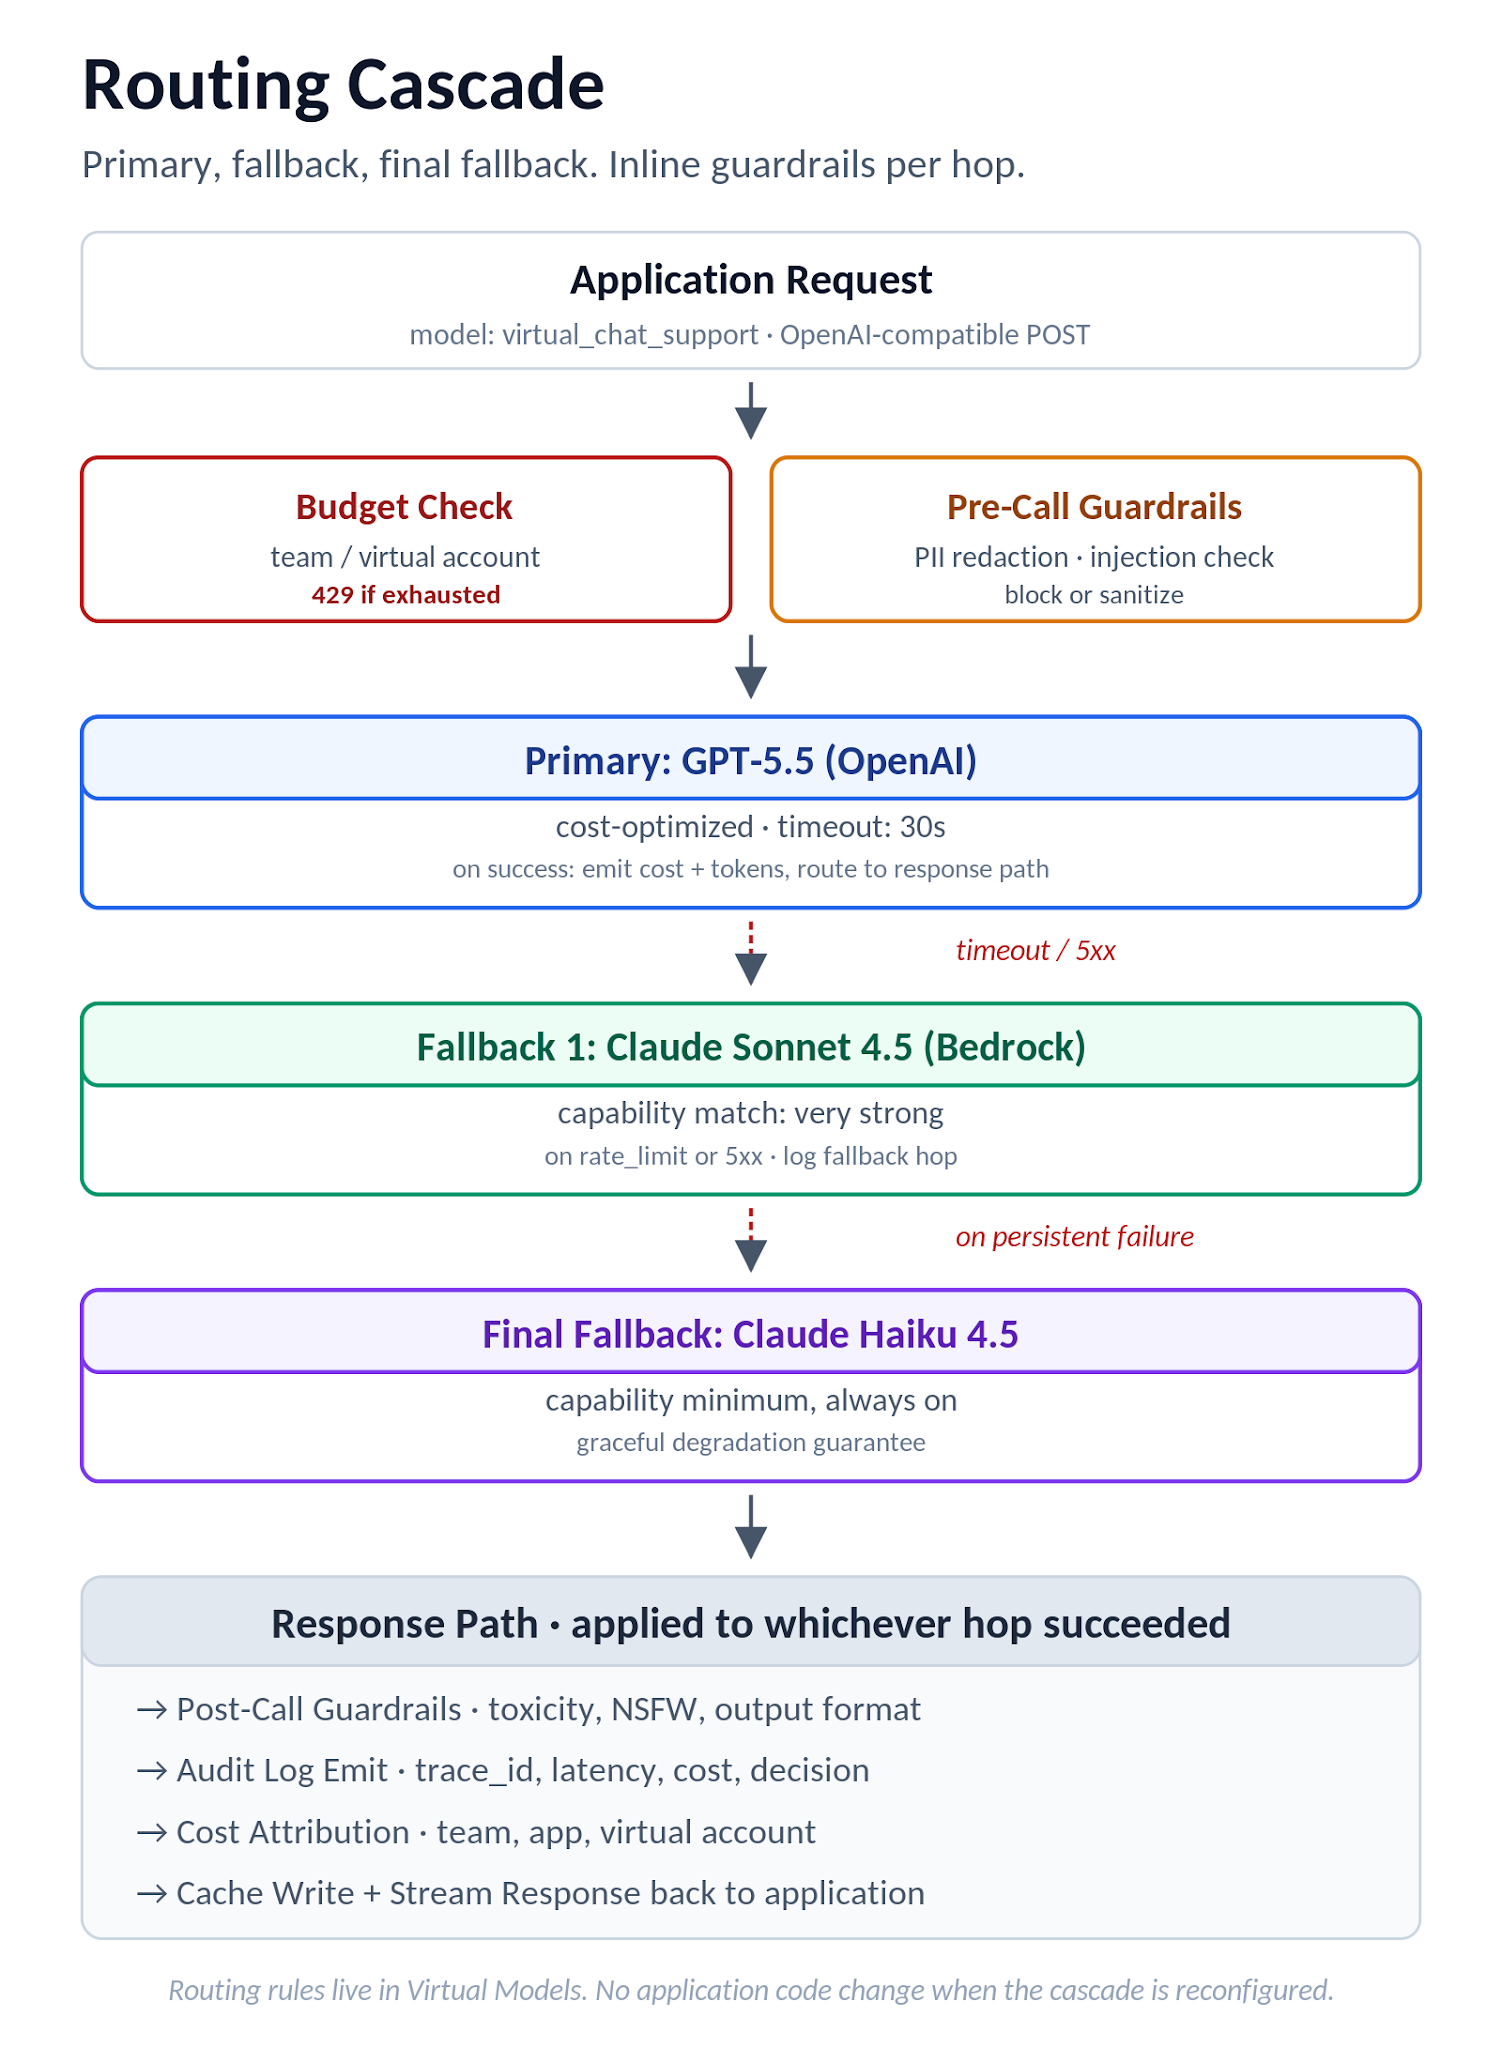
Afbeelding 4. Routing cascade-stroom: budgetcontrole, guardrails voorafgaand aan de aanroep, primaire modelpoging, fallback-keten en een verenigd responspad met audit, kosten en cache.
Deze sectie is waar de meeste AI-gatewayproducten het moeilijk zullen hebben, omdat de meeste zijn ontworpen voor het LLM-aanroepera en dateren van vóór het moment waarop MCP in echte enterprise-omgevingen begon te verschijnen. MCP is niet "meer observeerbaarheid voor tool-aanroepen". Het is een afzonderlijk governance-vlak: een register van goedgekeurde servers, een handhavingspunt voor welke tools elke rol kan aanroepen, auditlogs die overeenkomen met de LLM-aanroeplogs in velddekkingsgraad, en een policy engine die wordt uitgevoerd op het moment van aanroepen in plaats van als een rapport achteraf. Leveranciers die dit vlak niet hebben, zullen proberen de vragen in Sectie 4 te beantwoorden met beschrijvingen van LLM-observeerbaarheid. Let op de substitutie. Hoe directer het antwoord, hoe echter de functionaliteit.
Het te verwachten patroon: een sterke AI-gatewayleverancier zal de MCP-gateway beschrijven als een afzonderlijk productoppervlak met zijn eigen register, zijn eigen RBAC-toewijzing, zijn eigen auditlog-schema en zijn eigen beleidstaal. Een zwakkere leverancier zal het beschrijven als "uitgebreide observeerbaarheid" over hun bestaande LLM-observeerbaarheidsstack, wat het verraad is dat de governance schaars is. Scoor Sectie 4 specifiek; voeg het niet samen met Sectie 3.
Lees elk antwoord op directe handhavingstaal.
Updates voor deze regel moeten zich in seconden naar de gateway verspreiden (configuratiepush, geen herimplementatie). Als het antwoord van de leverancier is "beleid wordt geëvalueerd door de MCP-server zelf", is dat geen door de gateway gehandhaafd beleid. Het is een door de server gehandhaafd beleid en u moet de beleidspariteit behouden over elke MCP-server in de catalogus. Een heel ander probleem.
De gateway behoudt de trace-id bij elke stroomafwaartse aanroep (LLM-provider, MCP-server, secundaire gateway-hop) door deze in uitgaande headers te injecteren, en verzendt elke aanroep als een span onder dezelfde trace-id. In Datadog, Grafana Tempo of Jaeger is het resultaat een enkele waterval die het volgende toont: gebruikersverzoek → LLM-aanroep (claude-sonnet-4-6, 2,1s) → tool-aanroep (github.create_issue, 528ms) → LLM-aanroep (output-formatter, 380ms) → respons. Zonder dit verschijnt dezelfde stroom als vier ongerelateerde items en wordt oorzaakanalyse gokwerk.

Afbeelding 5. MCP Gateway-architectuur: één eindpunt voor ontwikkelaarstools en agents, met authenticatie-, register-, beleids- en logginglagen tussen clients en MCP-servers.
Het verschil tussen een AI-platform dat goed monitort en een platform dat goed observeert, blijkt uit de vragen die uw financieel team aan het einde van de maand stelt. Monitoring vertelt u dat de rekening met 40 procent is gestegen. Observeerbaarheid vertelt u dat de chatbot van het marketingteam drie weken geleden in een lus is geraakt op een grensgeval van de context-window, dat 70 procent van de stijging afkomstig is van één enkele applicatie, en dat de op hol geslagen verzoeken een specifieke handtekening hebben die u kunt omleiden naar een goedkoper model. Het eerste antwoord maakt financiën boos. Het tweede antwoord maakt van financiën een bondgenoot.
Hetzelfde onderscheid verschijnt bij het debuggen van agents. Monitoring vertelt u dat een agenttaak is mislukt. Observeerbaarheid vertelt u welke LLM-aanroep een verkeerd gevormde respons heeft geretourneerd, welke stroomafwaartse tool-aanroep als gevolg daarvan een timeout heeft gehad en tot welk gebruikersverzoek de fout is herleid. Zonder gecorreleerde tracing over de LLM- en MCP-vlakken (Sectie 4 vraag 8) is elke agentfout een forensische oefening. De onderstaande vragen dwingen de leverancier om te beschrijven wat er daadwerkelijk per aanroep wordt vastgelegd, hoe het opvraagbaar is en hoe de gegevens het platform verlaten wanneer uw financieel systeem deze nodig heeft.
Details zijn hier van belang.
Dit is wat van "kostentoewijzing voor agents" een signaal van financiële kwaliteit maakt in plaats van een technische curiositeit.
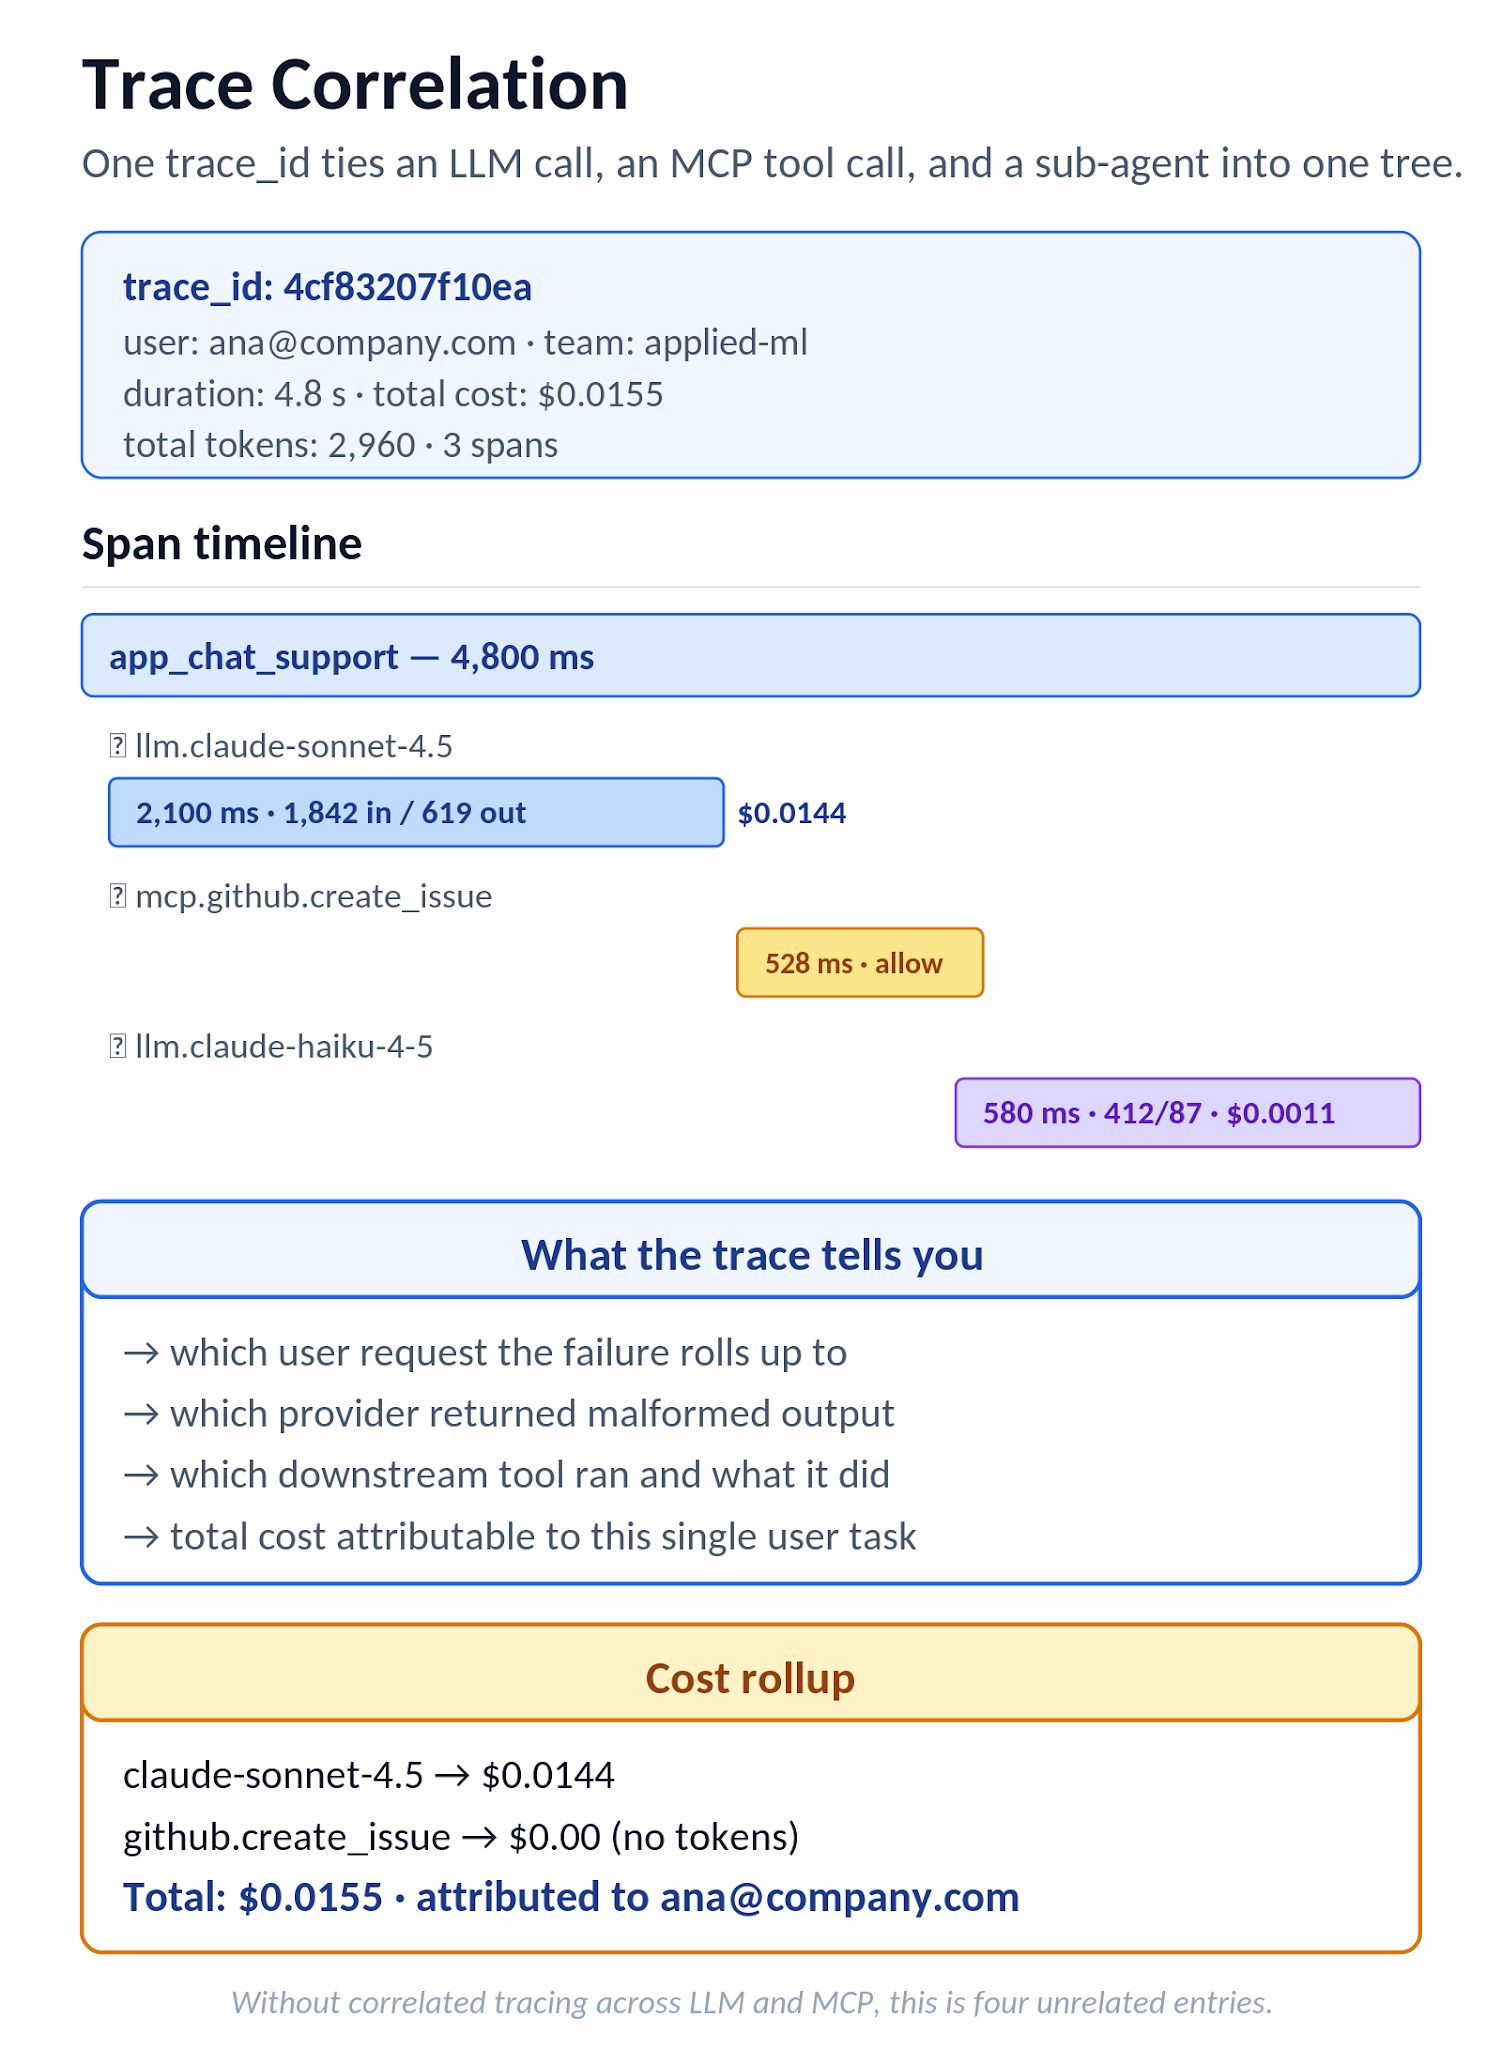
Afbeelding 6. Trace-watervalweergave van een enkele agenttaak: LLM-aanroep, MCP-tool-aanroep en tweede LLM-aanroep, allemaal onder één trace_id met kosten opgerold over spans.
De kosten van een integratiekloof zijn zelden zichtbaar bij de aanschaf. Het komt pas na zes maanden naar boven, wanneer de toegang van een uitdienstgetreden werknemer 48 uur duurt om in te trekken omdat SCIM niet echt werkt, wanneer een P1-storing om 2 uur 's nachts een automatisch antwoord krijgt met "we reageren tijdens kantooruren" omdat de SLA ambitieus is, wanneer een naamsverandering van een Okta-groep de roltoewijzingen verbreekt omdat de SSO-integratie van het platform nooit is getest met groepslevenscyclus-gebeurtenissen. Elk van deze is een eindige engineeringkost, maar ze stapelen zich op tot de operationele belasting waardoor platformteams aan het einde van het derde jaar stilzwijgend migreren van verder capabele producten.
Sectie 6 brengt de operationele realiteit aan het licht. Twee diagnostische patronen: elk "ja"-antwoord op een vraag over protocolondersteuning verdient een vervolgvraag over welke klanten dat protocol vandaag de dag in productie gebruiken versus welke klanten de eersten zullen zijn om het te proberen. En elke SLA-toezegging zonder expliciete credits moet worden behandeld als een marketingdoel. Contractuele SLA's worden geleverd met credits omdat leveranciers het risico van het missen ervan incalculeren; ambitieuze SLA's zijn geschreven door marketing en hebben dat niet.
Krijg de credits op schrift.
Als het platform slechts één vaste claimindeling kan verwerken, wordt de integratie met iets anders dan Okta/Azure AD pijnlijk. De bovenstaande flexibiliteit zijn eenmalige configuratiekosten; zonder deze wordt elke IdP-onboarding maatwerk.
Wanneer de gebruiker wordt ingetrokken in de IdP, ontvangt hetzelfde eindpunt een PATCH die 'active' omzet naar 'false', en het platform moet de toegang van de gebruiker onmiddellijk intrekken in plaats van bij de volgende inlogpoging. Test dit in de proof-of-concept: trek een testgebruiker in de IdP in, probeer vervolgens een nog geldige platformtoken te gebruiken en bevestig dat de intrekkingslevenscyclus van begin tot eind werkt. Als het platform intrekking pas honoreert bij de volgende gebruikersaanmelding, is dat een compliance-gat dat schriftelijk moet worden vastgelegd.
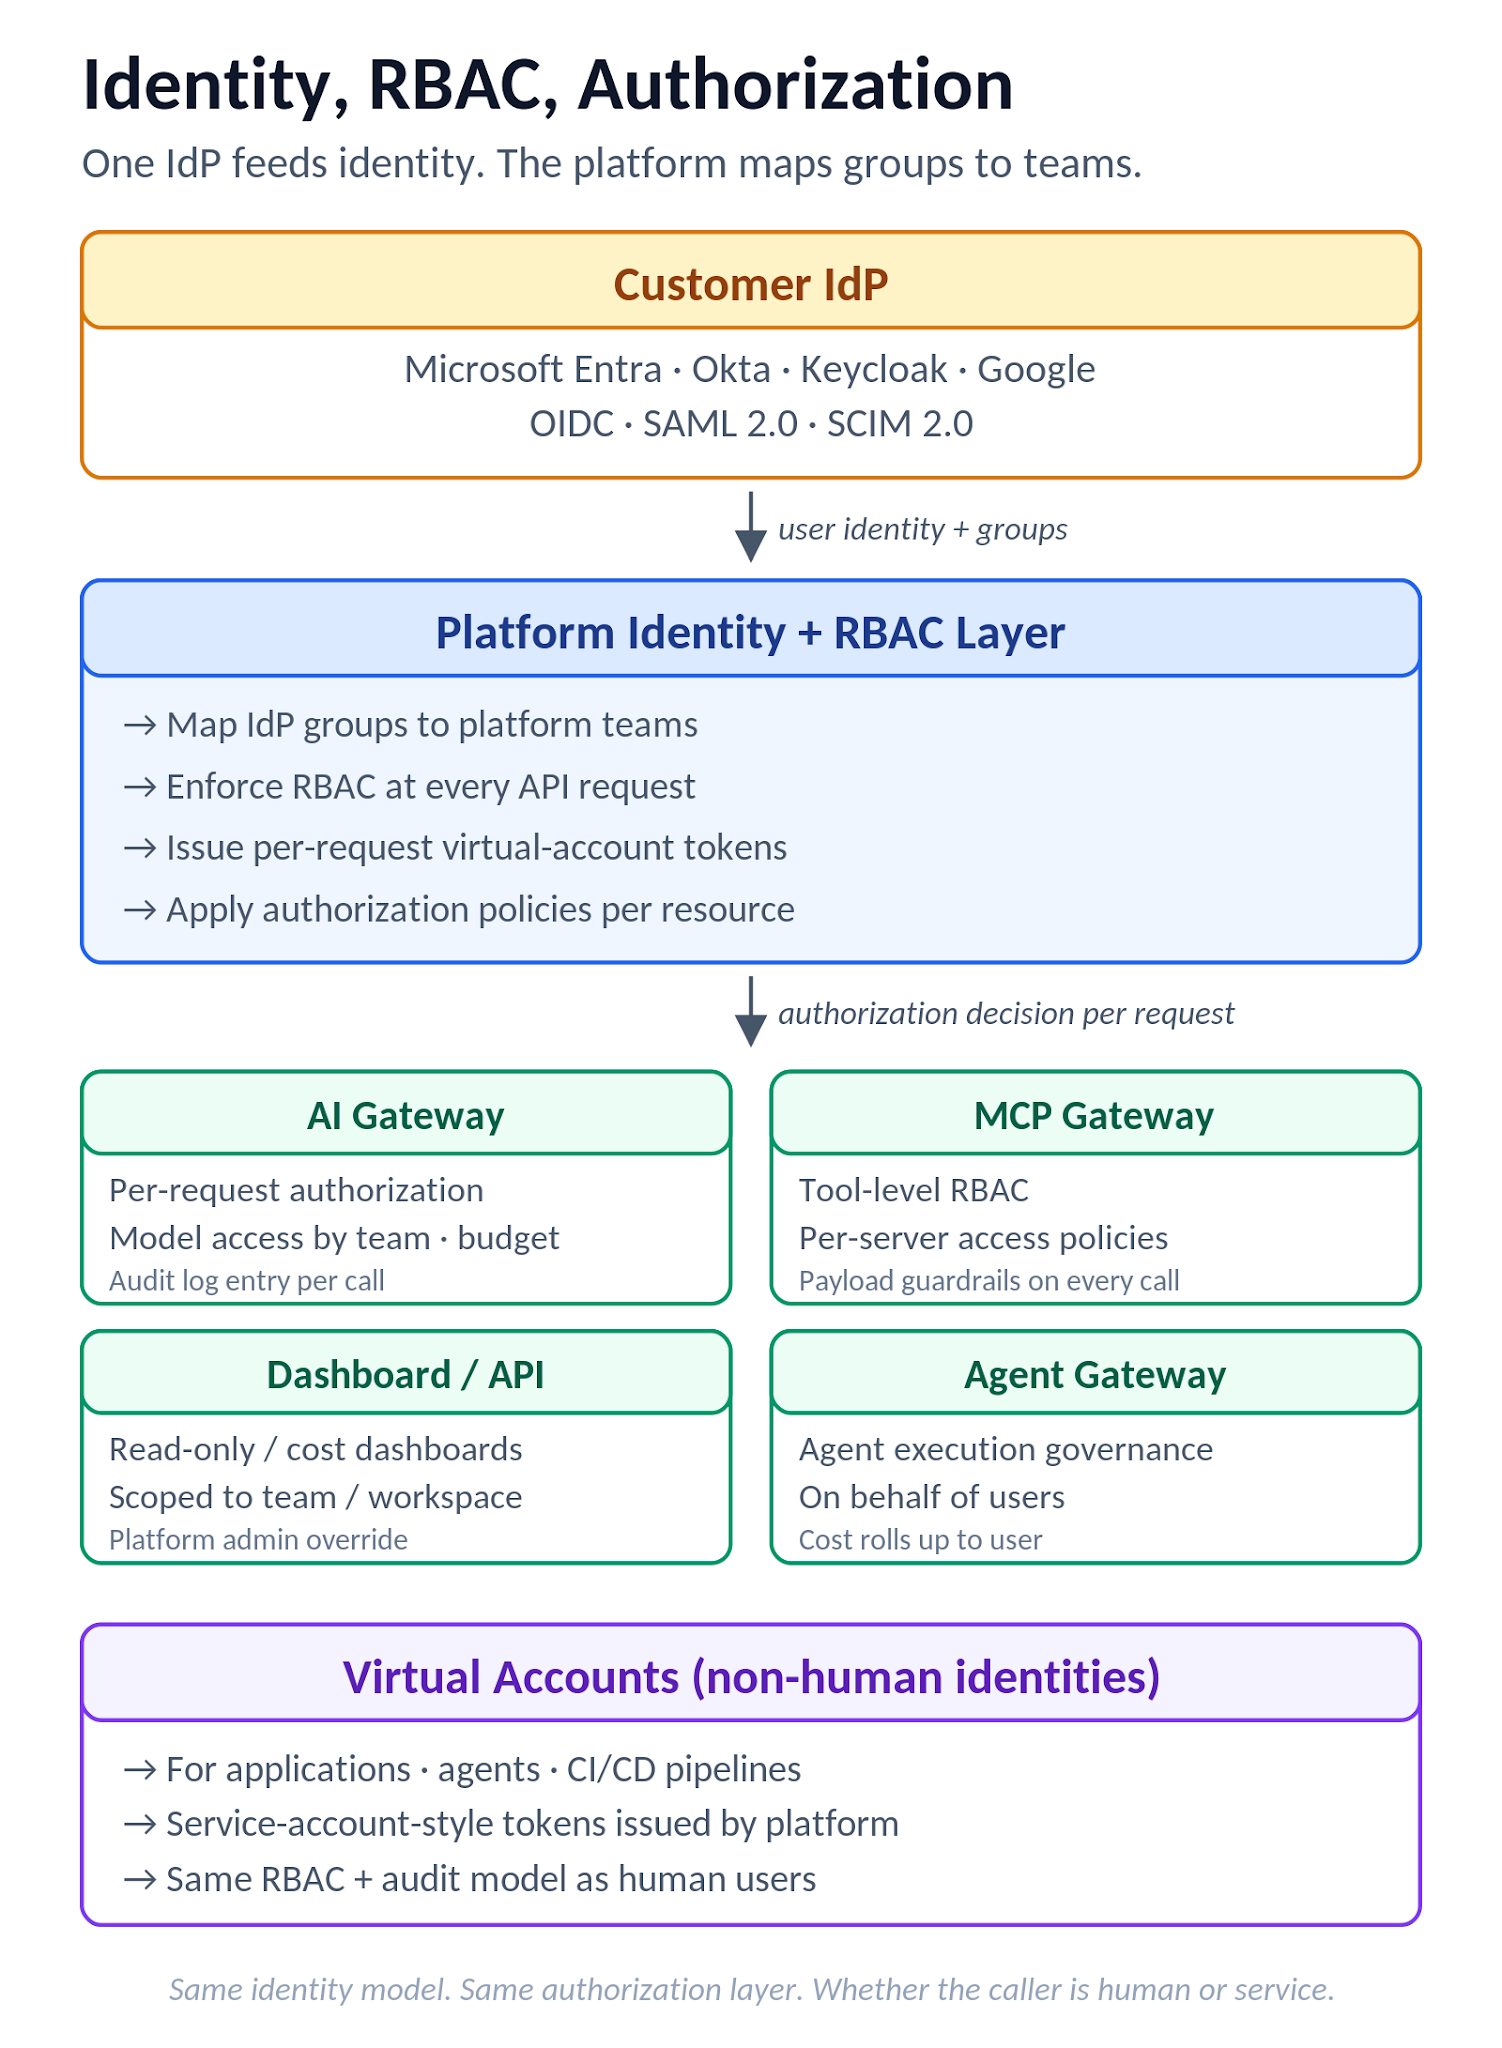
Afbeelding 7. Identiteits- en RBAC-stroom: IdP voedt identiteit, het platform koppelt groepen aan teams en Virtual Accounts, met handhaving op AI Gateway, MCP Gateway, dashboard en Agent Gateway.
Let op wanneer "responstijd" wordt gedefinieerd als "een automatische e-mail waarin staat dat we uw ticket hebben ontvangen". Dat is geen reactie. Een echte reactie is een engineer die zich met het probleem bezighoudt. En de creditclausule is de test: contractuele SLA's worden geleverd met credits, marketing-SLA's niet.
Het oplossingen-team van TrueFoundry behandelt deze RFP als de formele evaluatie, niet als een verkoopdocument. Elke vraag krijgt een schriftelijk antwoord met bewijs: SOC 2 Type II-rapporten, BAA-documentatie voor gezondheidszorgimplementaties, samenvattingen van penetratietests, referentiearchitecturen, voorbeeld-auditlogs, klantreferenties. Het resultaat is een document dat uw beveiligings-, inkoop- en platformteams gebruiken om een beslissing te nemen zonder een kennismakingsgesprek nodig te hebben om de hiaten op te vullen.
De architectuur onder de antwoorden komt rechtstreeks overeen met de sectiestructuur van dit sjabloon, wat verklaart waarom de meeste vragen helder worden opgelost. Laten we erdoorheen lopen:
Het implementatiemodel is split-plane. Het control plane is het orkestratiebrein, waar de configuratie, RBAC en dashboards worden gehost. Compute planes maken verbinding via een agent en hosten de daadwerkelijke workloads, waaronder de AI Gateway, MCP Gateway en eventuele geïmplementeerde applicaties of zelfgehoste modellen. Compute planes kunnen draaien in de cloudaccounts van de klant (AWS, GCP, Azure) of in Kubernetes op locatie, en meerdere compute planes worden gekoppeld aan één control plane om activiteiten in meerdere omgevingen onder één controleoppervlak mogelijk te maken. De AI Gateway kan zelf worden gehost binnen de infrastructuur van de klant (de implementatieopties zijn afzonderlijk gedocumenteerd) voor dataresidentie en soevereiniteitscontroles. Auditlogs en tracinggegevens worden opgeslagen met behulp van Gateway-verzoeklogging en tracingprojecten, waarbij RBAC de toegang tot traces en logs regelt. De split-plane architectuur zorgt ervoor dat dezelfde dataresidentiepositie beschikbaar is voor SaaS, single-cloud, multi-cloud en zelfgehoste implementaties, in plaats van ze elk te behandelen als een afzonderlijk product met afzonderlijke controleposities.
Datasoevereiniteit is de architectuur, geen marketingtekst.
Authenticatie gebruikt enterprise SSO via OIDC of SAML 2.0 met optionele IdP-tokenvalidatie direct bij de AI Gateway voor API-toegangsbeheer. Veelgebruikte IdP's (Microsoft Entra ID, Okta, Keycloak, Google) worden ondersteund, waarbij identity claims en groepslidmaatschappen vanuit de IdP worden gemapt naar TrueFoundry-teams om RBAC op schaal aan te sturen. SCIM-provisioning wordt ondersteund op alle SSO-configuraties — zowel OIDC als SAML — zodat deprovisioning in de IdP direct wordt doorgevoerd in plaats van te wachten op de volgende gebruikerslogin. RBAC werkt op Tenant-niveau (Admin/Member-rollen) plus aangepaste rollen met afgebakende rechten voor gebruikers, teams, clusters, workspaces, deployments, AI Gateway provider-accounts, MCP-servers en tracing-projecten. Niet-menselijke identiteiten (applicaties, agents) krijgen Virtual Accounts met service-account-achtige tokens, en autorisatie per verzoek bij AI Gateway-grenzen (modellen, agents, MCP-servers en tools) ondersteunt least-privilege-patronen. Provider-sleutels integreren met door de klant beheerde secret stores; gateway-authenticatie is als een laag boven op de IdP geplaatst in plaats van deze te vervangen, zodat MFA en conditional access gehandhaafd blijven door de IdP van de klant.
De AI gateway routeert naar meer dan 1.000 LLM's via één OpenAI-compatibel endpoint: OpenAI, Anthropic (direct en via AWS Bedrock), Azure OpenAI, GCP Vertex AI, Groq, Mistral en self-hosted modellen die worden geserveerd via vLLM, TGI of Triton. Routing wordt geconfigureerd via Virtual Models, die één modelinterface tonen en load-balancing of failover uitvoeren over meerdere onderliggende providers en modellen. TrueFailover voegt daar routing aan toe die rekening houdt met storingen en prestatieverlies, met ingebouwde multi-region en multi-cloud veerkracht. Harde token- en verzoeklimieten per gebruiker, team of Virtual Account retourneren een gestructureerde afwijzing wanneer een team zijn budget bereikt, in plaats van een zachte melding waarbij het verzoek alsnog wordt verwerkt. Provider-fallback verloopt automatisch en het latency-verlies wordt vastgelegd als een afzonderlijke metric op de call, in plaats van te worden verborgen in de totale latency. Semantic caching maakt gebruik van embeddings en cosine similarity met een configureerbare drempelwaarde en TTL; de documentatie vermeldt een latency-verbetering tot wel ~20x voor herhaalde of vergelijkbare query's. Guardrails zijn op regels gebaseerd (gericht op model, gebruiker of metadata), elk kan Validate (blokkeren) of Mutate (herschrijven/anonimiseren), en Bring-Your-Own Guardrail wordt ondersteund via een eigen guardrail-server met behulp van een FastAPI-template.
Routing is hier het product, niet een configuratie-optie.
De MCP- en agentic-stack maakt het verschil. TrueFoundry draait een native MCP Gateway en MCP Registry die centraal MCP-servers en tools registreren, ontdekken en veilig verbinden via beheerde toegangscontroles en enterprise auth-flows. Moderne MCP-transports, waaronder streamable HTTP voor proxy-verbindingen, worden ondersteund en de protocollaag gebruikt standaard JSON-RPC-messaging volgens de MCP-specificatie. Authenticatie is gelaagd: gateway-authenticatie, toegangsbeheer tot MCP-servers, en auth per server of per tool (inclusief op OAuth gebaseerde patronen die zijn gedocumenteerd voor enterprise MCP-servers). Gecentraliseerde configuratie betekent dat ontwikkelaarstools met één gateway-endpoint communiceren, in plaats van dat elke ontwikkelaar zijn eigen MCP-verbindingen opzet — het shadow-tooling-patroon dat de registry juist moet voorkomen. Agent Hub biedt organisatorische catalogisering en orchestratie voor complexe agents en reeds bestaande agents, en Agent Gateway biedt de enterprise governance-laag (veilige tool-toegang, observability, kostenbeheersing) voor het draaien van die agents in productie. Dezelfde identiteit die LLM-toegang beheert, beheert ook tool-toegang, waardoor de autorisatie voor beide in één IdP-configuratie leeft. En dezelfde trace-context die een meerstaps LLM-agenttaak verbindt, verbindt ook de onderliggende MCP-aanroepen. Dit maakt kostenberekening per taak en end-to-end debugging haalbaar in plaats van theoretisch.
Observability maakt gebruik van Gateway-verzoekslogging met traces. Token-aantallen, kosten, latency (TTFT en totaal), guardrail-beslissingen, policy-beslissingen en toewijzing aan teams en applicaties worden per call vastgelegd, opgeslagen als traces en toegankelijk gemaakt via tracing-projecten met hun eigen RBAC. Telemetrie-export is gebaseerd op standaarden: OpenTelemetry-data-export plus log- en trace-export naar externe systemen zoals Grafana, Datadog en Prometheus, zodat klanten integreren met bestaande observability-stacks in plaats van een eigen systeem aan te leren. Kostendashboards zijn realtime en deelbaar met teamleads via read-only RBAC. Dieselftde logging/trace-store creëert de auditeerbare dataset van prompt injection-pogingen, policy-hits en misbruikpatronen die klanten na verloop van tijd kunnen analyseren om guardrails te verfijnen.
Uw bestaande observability-stack blijft uw bestaande observability-stack.
Het bewijs van verwerkingscapaciteit hierachter: 10 miljard verzoeken per maand verwerkt over het gehele klantenbestand, 1.000+ Kubernetes-clusters beheerd door het platform, overhead aan de gateway-zijde onder 10ms p95 (TTFT) en 350+ RPS continu op een enkele vCPU. Klanten die in productie draaien zijn onder meer Resmed, Siemens Healthineers, Automation Anywhere, Zscaler en Nvidia. De Series A-financieringsronde werd in februari 2025 geleid door Intel Capital, waarmee de totale financiering op ongeveer $21 miljoen komt, met deelname van Peak XV Partners (Surge), Eniac Ventures en Jump Capital.
Productieschaal, geen pilotschaal.
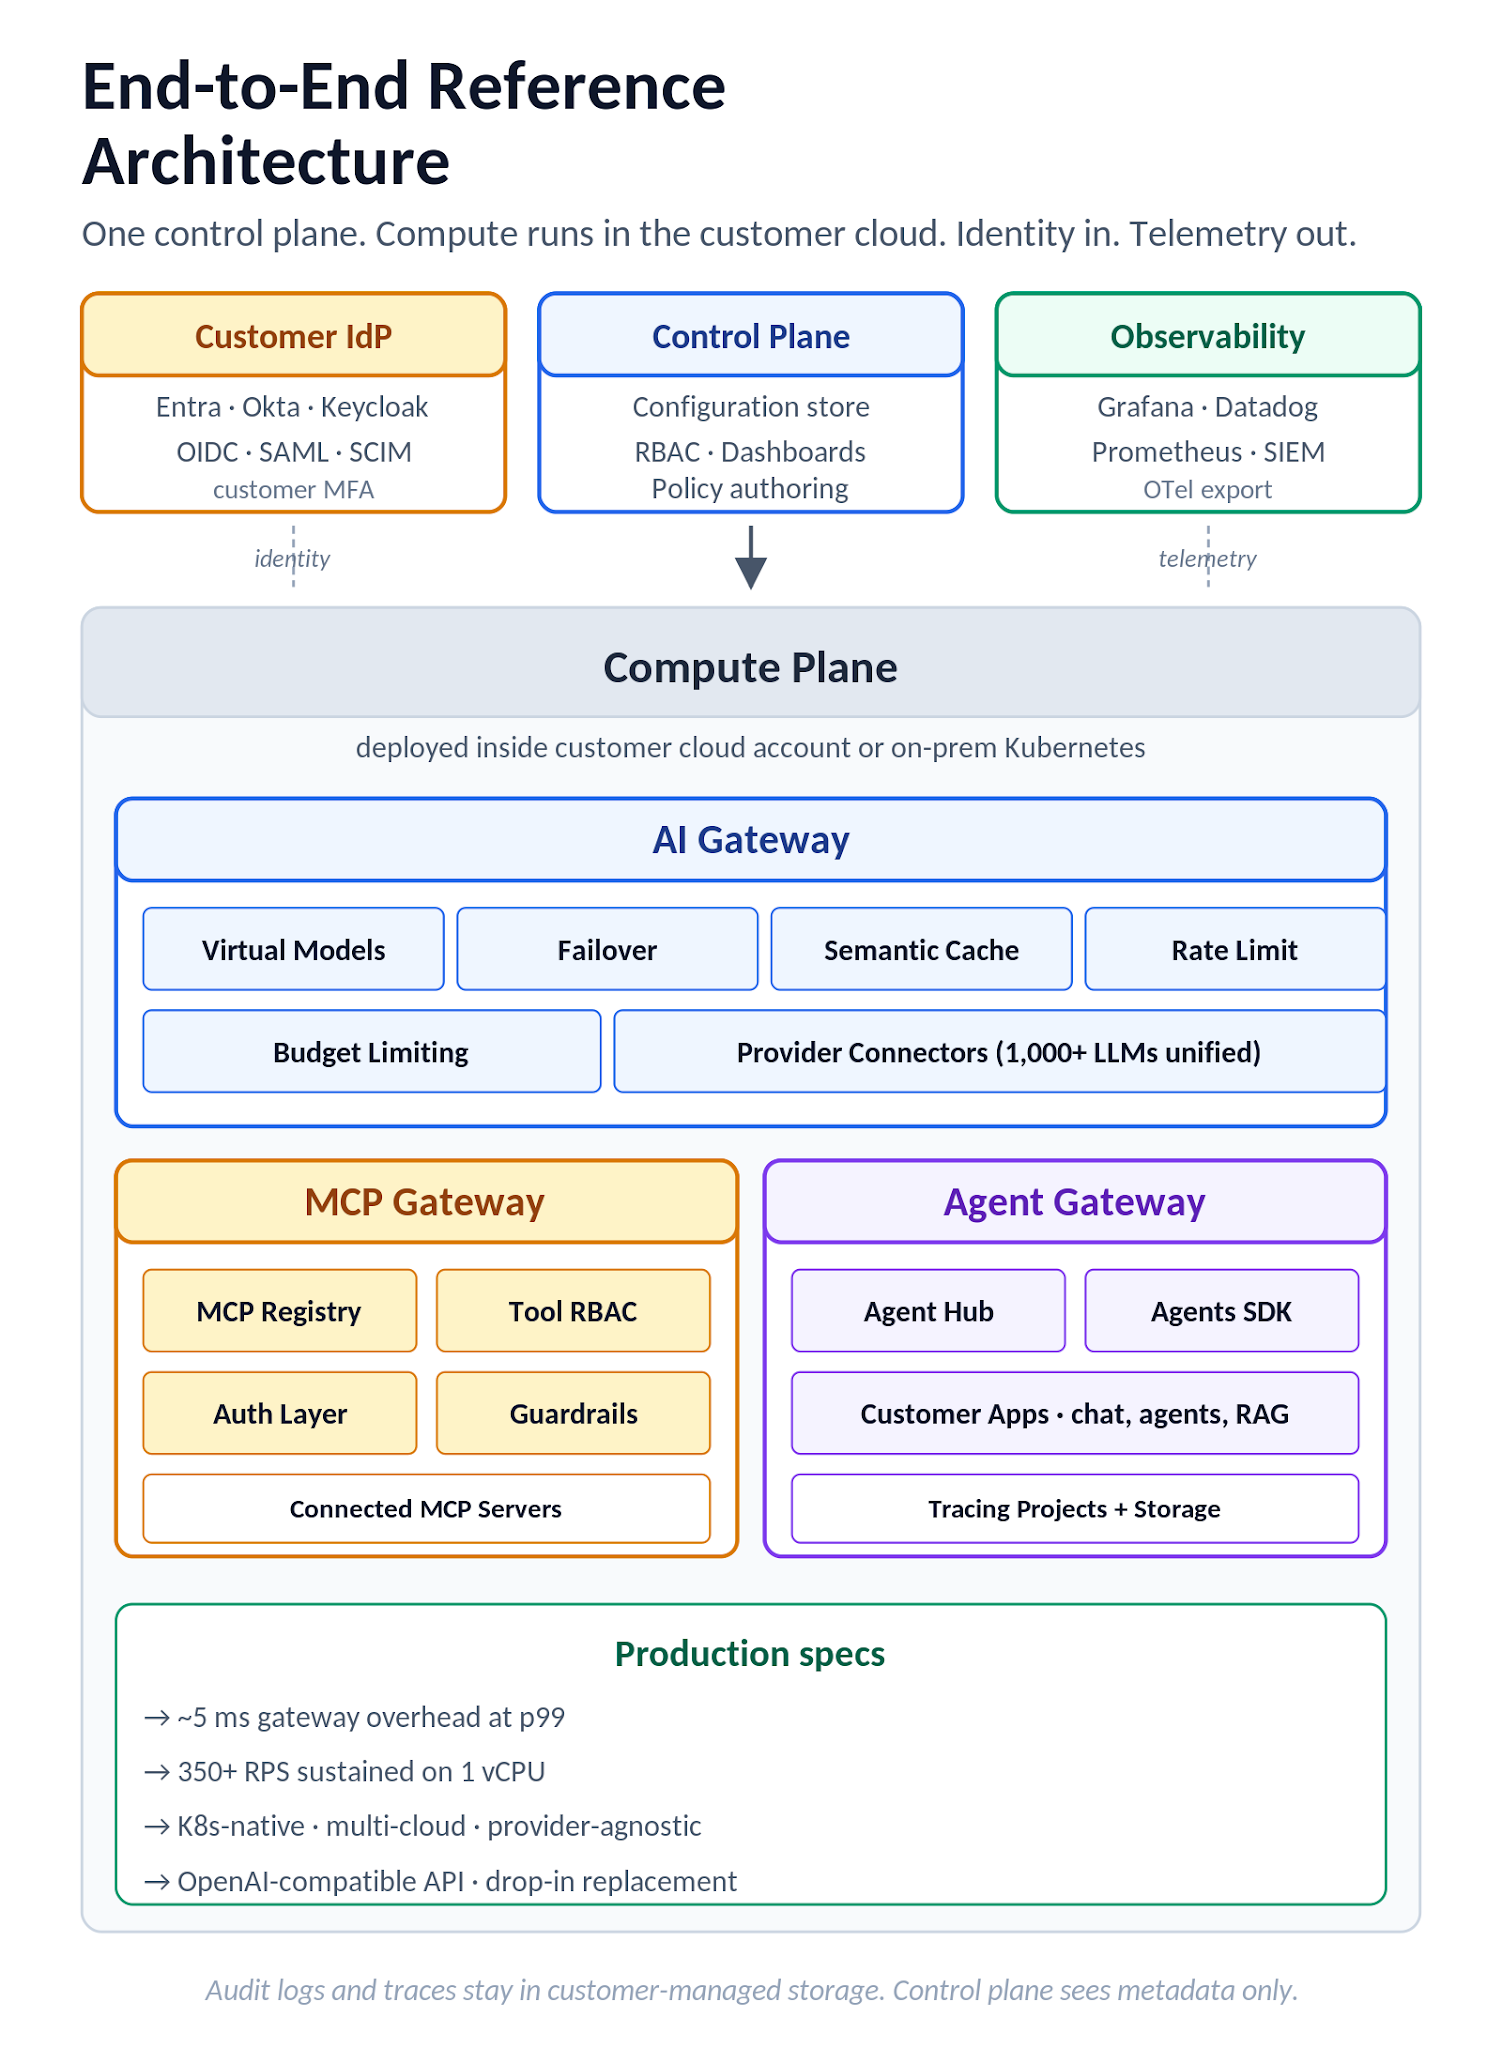
Figuur 8. TrueFoundry end-to-end referentiearchitectuur: control plane, compute plane (met AI Gateway, MCP Gateway, Agent Gateway en Customer Apps), klant-IdP en observability-doelen.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox