



November 10, 2026
|
5 min leestijd


Krijg direct toegang tot een live TrueFoundry-omgeving. Implementeer modellen, stuur LLM-verkeer aan en verken het volledige platform — je sandbox is binnen enkele seconden klaar, creditcard niet vereist.




De razendsnelle manier om je modellen te bouwen, volgen en implementeren!
Naarmate ondernemingen hun AI-initiatieven opschalen, is een van de grootste architecturale risico's waar ze mee te maken krijgen: vendor lock-in—te nauw verbonden zijn aan één enkele modelprovider of cloudplatform. In het snel evoluerende AI-ecosysteem, waar bijna wekelijks nieuwe basismodellen en API's verschijnen, kan deze afhankelijkheid innovatie en flexibiliteit snel beperken. Teams die zich in een vroeg stadium aan één ecosysteem binden, merken vaak dat ze niet kunnen overstappen op nieuwere, betere of kostenefficiëntere modellen zonder grote delen van hun stack te herschrijven. Het voorkomen van lock-in is daarom niet alleen een inkoopkwestie, maar een fundamentele uitdaging voor technisch ontwerp.
Het risico op vendor lock-in is een cruciaal punt bij het ontwerpen van AI-systemen voor ondernemingen. Als uw AI-applicaties nauw gekoppeld zijn aan de API's van één provider, kan het lastig zijn om u aan te passen wanneer technologie, prijzen of compliance-eisen veranderen. Een AI-modelgateway lost dit op door te fungeren als abstractielaag tussen uw applicaties en meerdere modelproviders. In de praktijk betekent dit dat uw code communiceert met de uniforme interface van de gateway in plaats van rechtstreeks met elke leverancier. De gateway routeert en vertaalt vervolgens verzoeken naar het optimale onderliggende model (OpenAI, Anthropic, Gemini, een zelf-gehoste LLaMA, enz.) zonder dat uw applicatiecode leveranciersspecifieke wijzigingen nodig heeft. TrueFoundry's AI Gateway illustreert deze aanpak – het biedt één enkele, OpenAI-compatibele API voor toegang tot 1000+ LLM's en vision-modellen, terwijl het tegelijkertijd bedrijfsbeveiliging, governance en observability afdwingt. Door het ontwerp TrueFoundry voorkomt lock-in: u behoudt volledige controle over implementatie en dataformaten, en uw applicatiecode blijft leverancier-agnostisch.
Vendor lock-in treedt op wanneer uw systeem zo sterk verbonden is met één provider dat overstappen naar een andere onpraktisch of kostbaar is. In AI/ML betekent dit vaak dat code rechtstreeks wordt geschreven voor de SDK of API van één leverancier. Hoewel het gebruik van één provider (bijv. OpenAI) in het begin eenvoudig kan zijn, creëert het gevaarlijke afhankelijkheden. Als uw integratie bijvoorbeeld gebruikmaakt van de eigen API-aanroepen van OpenAI, zult u moeite hebben om te migreren als de dienst van OpenAI niet beschikbaar is, de voorwaarden wijzigt, of als een nieuw model (zoals Google's Gemini of een geavanceerd open-source model) superieur wordt.
Het team van TrueFoundry benadrukt deze “Vendor Lock-in valstrik”: een hard-coded integratie dwingt u tot haastwerk wanneer providers hun prijzen wijzigen, modellen uitfaseren of offline gaan voor onderhoud. In bredere zin uit lock-in zich in hoge overstapkosten – technisch (code herschrijven voor nieuwe API's), contractueel (langetermijnverplichtingen verbreken), procesmatig (teams omscholen) of datagerelateerd (eigen data verplaatsen).
Software evalueren op het risico van lock-in betekent de volgende vraag stellen: Kunnen we indien nodig eenvoudig van provider wisselen?enZitten we vast aan propriëtaire SDK's of dataformaten? Zoals Progress Software opmerkt, gaat lock-in minder over het aanvankelijke gemak en meer over flexibiliteit op de lange termijn. Je moet lock-in zien als elke andere vorm van technische schuld: richt je architectuur zo in dat je opties open blijven. In de praktijk betekent dit dat je de voorkeur geeft aan open standaarden (bijv. OpenAI API, Parquet-data), container-gebaseerde implementaties en abstractielagen (zoals gateways) waarmee onderliggende componenten kunnen worden vervangen. De AI Gateway van TrueFoundry zorgt ervoor dat de applicatiecode nooit provider-specifieke aanroepen bevat, zodat je niet vastzit aan één AI-leverancier.
Een AI model gateway (ook wel een LLM- of AI-gateway genoemd) is een middleware -laag die zich tussen je applicatie en een willekeurig aantal AI-modelproviders bevindt. Het fungeert als een luchtverkeersleider of vertaler: je app verstuurt één API-verzoek naar de gateway, en de gateway bepaalt welk model of welke leverancier wordt gebruikt. De gateway standaardiseert vervolgens de input/output-formaten en regelt de beveiliging en routering op de achtergrond. Dankzij deze uniforme interface hoef je nooit modelspecifieke code in je applicatie te schrijven.
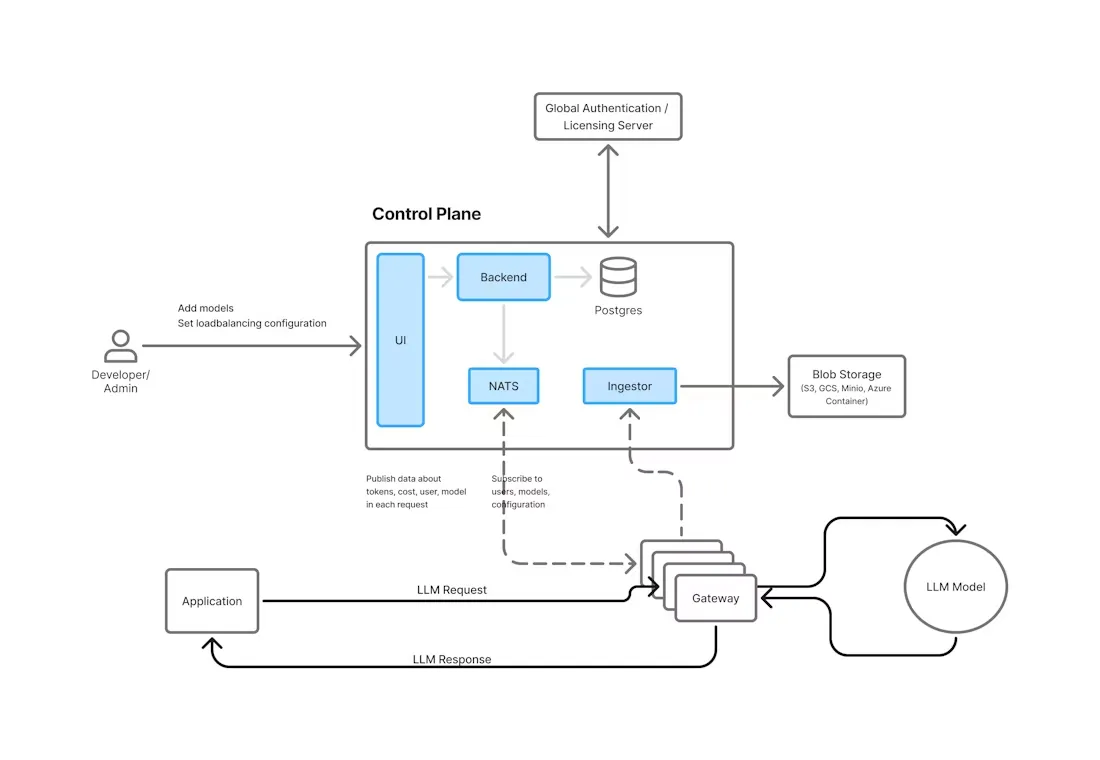
Afbeelding: Architectuur van de TrueFoundry AI Gateway (proxylaag tussen applicaties en meerdere LLM-providers).
Bijvoorbeeld, accepteert de gateway van TrueFoundry verzoeken in een OpenAI-compatibel formaat; het kan de query vervolgens doorsturen naar OpenAI, Anthropic, een zelf-gehost model of een andere geïntegreerde provider zonder dat je je code hoeft aan te passen.
In essentie biedt een AI-gateway modelabstractie, beleidshandhaving en multi-model orchestratie op één plek. Het voegt ook enterprise-functionaliteiten toe (zoals RBAC, snelheidslimieten, kostenbeheersing en audit-logging) aan elk verzoek, waardoor AI-modellen als beheerde services worden behandeld. Door de applicatie los te koppelen van provider-specifieke API's, verminderen gateways de technische werklast aanzienlijk bij het werken met meerdere LLM's.
Key Metrics for Evaluating Gateway
| Criteria | What should you evaluate ? | Priority | TrueFoundry |
|---|---|---|---|
| Latency | Adds <10ms p95 overhead for time-to-first-token? | Must Have | ✅ Supported |
| Data Residency | Keeps logs within your region (EU/US)? | Depends on use case | ✅ Supported |
| Latency-Based Routing | Automatically reroutes based on real-time latency/failures? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |

AI-gateways voorkomen lock-in door providerdetails abstraheren. Omdat je applicatie alleen communiceert met de uniforme API van de gateway, hoef je nooit leveranciersspecifieke endpoints hard te coderen. Bijvoorbeeld: De gateway van TrueFoundry ondersteunt elk OpenAI-compatibel model. Als je je code schrijft voor de OpenAI-stijl API van TrueFoundry, kun je met een simpele configuratiewijziging schakelen tussen OpenAI, Azure OpenAI, Anthropic of je eigen modellen – zonder dat je de code hoeft te herschrijven. Deze ontkoppeling is cruciaal.
TrueFoundry maakt bewust gebruik van het standaard OpenAI API-formaat voor alle verzoeken, wat betekent dat je de vertrouwde OpenAI SDK of clientbibliotheken kunt blijven gebruiken. Je stuurt verzoeken simpelweg naar de gateway van TrueFoundry in plaats van rechtstreeks naar een leverancier. Op de achtergrond vertaalt de gateway deze aanroepen naar de juiste API-aanroepen van de betreffende leverancier.
TrueFoundry vermijdt bovendien het introduceren van een eigen, aangepaste SDK. In plaats daarvan gebruiken ontwikkelaars hun bestaande tools en SDK's zoals voorheen – of het nu die van OpenAI is of een andere open-source client – en verwijzen ze naar het gateway-endpoint. In feite ontstaat er geen nieuwe "lock-in" door het gebruik van TrueFoundry, omdat je nooit vastzit aan een eigen, gesloten interface. Bovendien zijn de dataformaten en logs van TrueFoundry gebaseerd op open standaarden: logs worden bijvoorbeeld opgeslagen in Apache Parquet op een door de klant beheerde S3-bucket, en voor statistieken wordt OpenTelemetry gebruikt. Dit betekent dat je gegevens kunt exporteren en analyseren met elke gewenste tool, wat verdere verstrengeling met een dataleverancier voorkomt. Kortom, door te fungeren als een vertaler en controlepaneel,zorgen AI-gateways zoals die van TrueFoundry ervoor dat je modelproviders kunt wisselen, workloads naar een andere omgeving kunt verplaatsen of zelfs modellen zelf kunt hosten zonder de applicatiecode te herschrijven.
TrueFoundry’sAI Gateway is ontworpen voor hoge beschikbaarheid en minimale latentie, terwijl beleidsregels op schaal worden gehandhaafd. De kern is een gesplitste control-plane/data-plane architectuur. In essentie beheert de control-plane (een centrale service) de configuratie, modellen, gebruikers en beleidsregels, terwijl lichtgewicht gateway-pods de inferentieverzoeken verwerken. Deze gateway-pods zijn geschreven in een krachtig, event-driven framework (Hono) en zijn CPU-gebonden voor maximale efficiëntie.
Wanneer er een verzoek binnenkomt, voert de gateway alle controles in het geheugen uit: het valideert je JWT-token en rechten, past snelheidslimieten of budgetplafonds toe en bepaalt welk model moet worden gebruikt. Belangrijk is dat het verzoek binnenkomt in de standaard OpenAI-compatibele JSON-indeling. De gateway gebruikt vervolgens de geconfigureerde routeringsregels om een modelprovider te kiezen (bijvoorbeeld de snelste of goedkoopste). Een ingebouwde adapter component vertaalt het verzoek naar de specifieke indeling die door de API van die provider wordt verwacht. Als het gekozen model bijvoorbeeld op AWS Bedrock of Anthropic draait, converteert de gateway het verzoek in OpenAI-stijl op de juiste manier. Dit betekent dat de code van je app nooit verandert, ook al verwachten verschillende providers mogelijk andere parameters.
Zodra het model reageert, stuurt de gateway de output terug naar je app. Tegelijkertijd logt het asynchroon het verzoek en de reactie (tokens, latentie, kosten, enz.) in een centrale opslag. Deze logs stromen naar de analytics-backend in je eigen cloud (TrueFoundry schrijft ze als Parquet naar S3 of een S3-compatibele opslag). Kortom, het ontwerp van TrueFoundry zorgt ervoor dat er geen externe aanroepen nodig zijn in het verzoekpad (afgezien van caching), alle beleidsbeslissingen in het geheugen plaatsvinden en verzoeklogs ontkoppeld en duurzaam zijn. Het resultaat is een AI-gateway die slechts ~3–5ms aan overhead per aanroep toevoegt, zelfs bij honderden verzoeken per seconde. De geclusterde implementatie op Kubernetes (via Helm-charts) geeft je de vrijheid om het overal uit te voeren – publieke cloud, privaat datacenter of edge – zonder de applicatielaag te wijzigen..
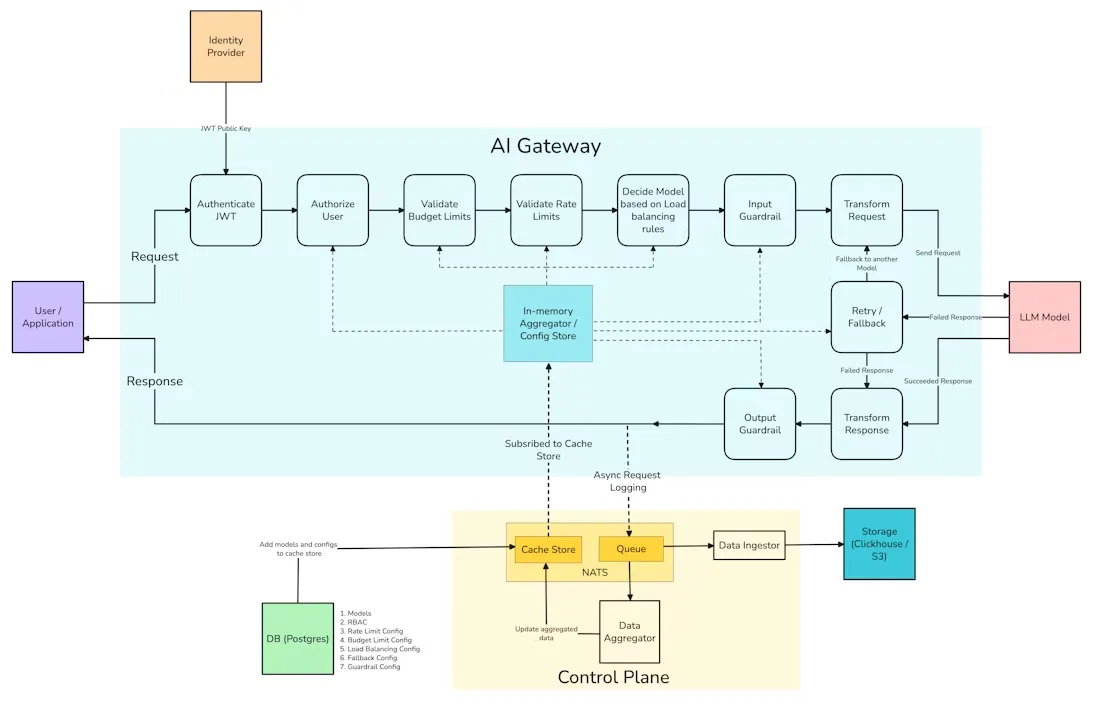
Afbeelding: High-availability architectuur van TrueFoundry’s AI Gateway (control-plane & gateway pods).
Intern gebruikt TrueFoundry een centrale database (bijv. PostgreSQL) en een NATS-berichtenwachtrij voor configuratiedistributie. Alle gateway-pods abonneren zich via NATS op realtime updates (gebruikers, modellen, quota, statistieken), zodat beleidswijzigingen direct worden doorgevoerd. Als een primaire provider niet beschikbaar is, kan de gateway automatisch opnieuw proberen of overschakelen naar een fallback-model. Dit modulaire, Kubernetes-native ontwerp – gecombineerd met een API-gestuurde aanpak – garandeert dat je nooit vastzit aan de infrastructuur van TrueFoundry. Je ontvangt de manifests en Helm-charts en behoudt volledige controle over de implementatiedetails.
1. Leveranciersonafhankelijkheid & Flexibiliteit: Door het ontwerp maakt een AI-gateway je AI-stack provider-agnostisch. Met de uniforme API van TrueFoundry kun je naadloos verbinding maken met elke OpenAI-compatibel eindpunt of 1000+ ondersteunde LLM's en vision-modellen. Je kunt wisselen tussen onderliggende modellen (bijv. GPT, Claude, LLaMA, Mistral, Gemini, enz.) zonder je applicatiecode aan te passen – een directe verdediging tegen vendor lock-in.
2. Uniforme interface & ondersteuning voor meerdere modellen: Eén gateway-eindpunt vervangt talloze vendor-API's. Dit vereenvoudigt de ontwikkeling (slechts één integratie om te onderhouden) en maakt intelligente orkestratie van meerdere modellen mogelijk. Je krijgt automatisch functies zoals slimme routering (verstuur verzoeken naar het snelste of goedkoopste model) en fallback-afhandeling.
3. Enterprise-beheer: Gateways voorzien standaard in enterprise-behoeften. De gateway van TrueFoundry dwingt authenticatie (API-sleutels, OAuth, enz.), fijnmazige RBAC, rate-limiting en content-guardrails af bij elke aanroep. Daarnaast worden auditlogs vastgelegd voor compliance. Deze beveiligingen gelden uniform voor alle modellen en providers, in tegenstelling tot maatwerk-integraties.
4. Kosten- en gebruiksbeheer: Omdat AI-gateways elk verzoek zien, kunnen ze het tokenverbruik en de budgetten bijhouden. TrueFoundry biedt real-time kostenbewaking en budgetlimieten per team of model, waardoor onverwachte kosten worden voorkomen. Deze gecentraliseerde kostenbeheersing is veel eenvoudiger dan het moeten inloggen op de console van elke individuele leverancier.
5. Observability & Open Standaarden: Logging en telemetrie via de gateway bieden ongeëvenaard inzicht in AI-workloads. De logs van TrueFoundry zijn OTel-compatibel en gebruiken open formaten, zodat je ze naar elke observability-tool kunt sturen (bijv. Datadog, Grafana). Omdat data als Parquet in je eigen S3-buckets staat, heb je echt eigendom over je eigen analytics; dit voorkomt verborgen vendor lock-in.
6. Schaalbaarheid & Betrouwbaarheid: Een goed gebouwde gateway voegt minimale overhead toe. Benchmarks van TrueFoundry laten slechts ~3–4 ms extra latentie zien bij ~250 RPS op één CPU-core. De gateway schaalt horizontaal en het ontwerp (geen single point of failure in het verzoekpad) garandeert een hoge beschikbaarheid. Kortom, je krijgt betrouwbaarheid op bedrijfsniveau zonder in te leveren op prestaties.
7. Ecosysteem-integratie: TrueFoundry biedt een 100% API-gestuurd platform. Je kunt het integreren in CI/CD (GitOps), gebruikmaken van hun Terraform-provider of Helm-charts, en koppelen aan externe tools. Resultaten van guardrails of statistieken van TrueFoundry kunnen bijvoorbeeld via OpenTelemetry worden doorgegeven aan SIEM- of governance-tools. Dankzij deze openheid behoud je de vrijheid in je eigen tooling.
Hanteer deze principes om lock-in te voorkomen:
Door deze gewoontes op te bouwen – abstractie, standaardisatie en controle – verkleint u het risico op vendor lock-in aanzienlijk.
Zoals de tabel laat zien, is directe integratie wellicht het eenvoudigst voor een kleinschalig proof-of-concept met één model, maar in een productieomgeving wordt dit al snel kwetsbaar. De AI Gateway van TrueFoundry introduceert een kleine, voorspelbare prestatiekost (slechts enkele milliseconden) in ruil voor enorme winst in flexibiliteit en controle. In de meeste bedrijfsscenario's is die afweging de moeite waard om vendor lock-in te voorkomen en direct te profiteren van functies van enterprise-niveau.
Houd bij het kiezen van een AI-gateway (of welk AI-platformdan ook) rekening met deze lock-in-factoren:
Kortom, zoek naar open, modulaire ontwerpen (zoals de split-plane en plugin-gebaseerde modules van TrueFoundry), draagbare gegevens en volledig inzicht in de werking van het systeem. De aanpak van TrueFoundry – modulair, Kubernetes-native en gebaseerd op open standaarden – voldoet aan deze eisen om lock-in te minimaliseren. Hun filosofie is helder: "geen vendor lock-in", zodat je je AI-stack op je eigen voorwaarden kunt migreren of verder ontwikkelen.
Vendor lock-in is een verborgen kostenpost bij AI-ontwikkeling die organisaties kwetsbaar kan maken voor prijsverhogingen, storingen en stagnatie. Het gebruik van een AI-modelgateway is een van de meest effectieve manieren om deze valkuilen te vermijden. Door alle modelverzoeken via een uniforme, agnostische interface te laten verlopen, elimineren gateways hard-coded afhankelijkheden van één specifieke aanbieder. De AI Gateway van TrueFoundry belichaamt deze aanpak: het ontkoppelt je applicatie van specifieke LLM-API's, omarmt open standaarden en zorgt ervoor dat je volledige controle behoudt over infrastructuur en data. Het resultaat is meer wendbaarheid: je kunt nieuwe modellen evalueren, workloads tussen clouds verplaatsen of on-premises implementeren zonder de kerncode te herschrijven.
Kortom, zie een AI-gateway als een verzekeringspolis tegen lock-in.TrueFoundry’simplementatie gaat nog een stap verder door enterprise-grade functies (RBAC, observability, kostenbeheersing) en open portabiliteit te bieden, zodat je AI-systemen flexibel, schaalbaar en toekomstbestendig blijven.
TrueFoundry AI Gateway levert een latentie van ~3–4 ms, verwerkt 350+ RPS op 1 vCPU, schaalt moeiteloos horizontaal en is klaar voor productie, terwijl LiteLLM last heeft van hoge latentie, moeite heeft boven een gemiddeld aantal RPS, geen ingebouwde schaling heeft en het meest geschikt is voor lichte workloads of prototypes.





Het laatste nieuws, artikelen en bronnen in je inbox


















