


Elk model fine-tunen
Fine-tune LLM's en klassieke ML-modellen met behulp van Hugging Face-integraties en productieklare templates
No-code of full-code fine-tuning
Ga snel van start met een no-code UI of gebruik je eigen trainingsscripts voor volledige controle en flexibiliteit.
PEFT & Full Fine-tuning
Ondersteuning voor LoRA, QLoRA en full fine-tuning om een balans te vinden tussen kosten, geheugengebruik en modelprestaties.
Checkpointing & Versiebeheer
Maak automatisch checkpoints van runs, hervat trainingen en beheer versies van modellen en datasets voor reproduceerbaarheid.
Ingebouwde experiment-tracking
Houd hyperparameters, statistieken, datasets en outputs bij over verschillende fine-tuning runs heen.
Adapterbeheer
Train, hergebruik, voeg samen en wissel LoRA-adapters om fine-tuning te versnellen en kosten te verlagen.

Fine-tune elk Hugging Face-model / klassiek ML-model
- Ondersteunt het fine-tunen van LLM's zoals LLaMA, Mistral, BERT, Falcon en GPT-J
- Begin binnen enkele minuten met het fine-tunen van LLM's via de ingebouwde Hugging Face model hub
- Voorgeconfigureerde sjablonen vereenvoudigen het proces van het fine-tunen van grote taalmodellen
- Schaalbare infrastructuur die alles aankan, van kleine experimenten tot fine-tuning van LLM's op productieniveau
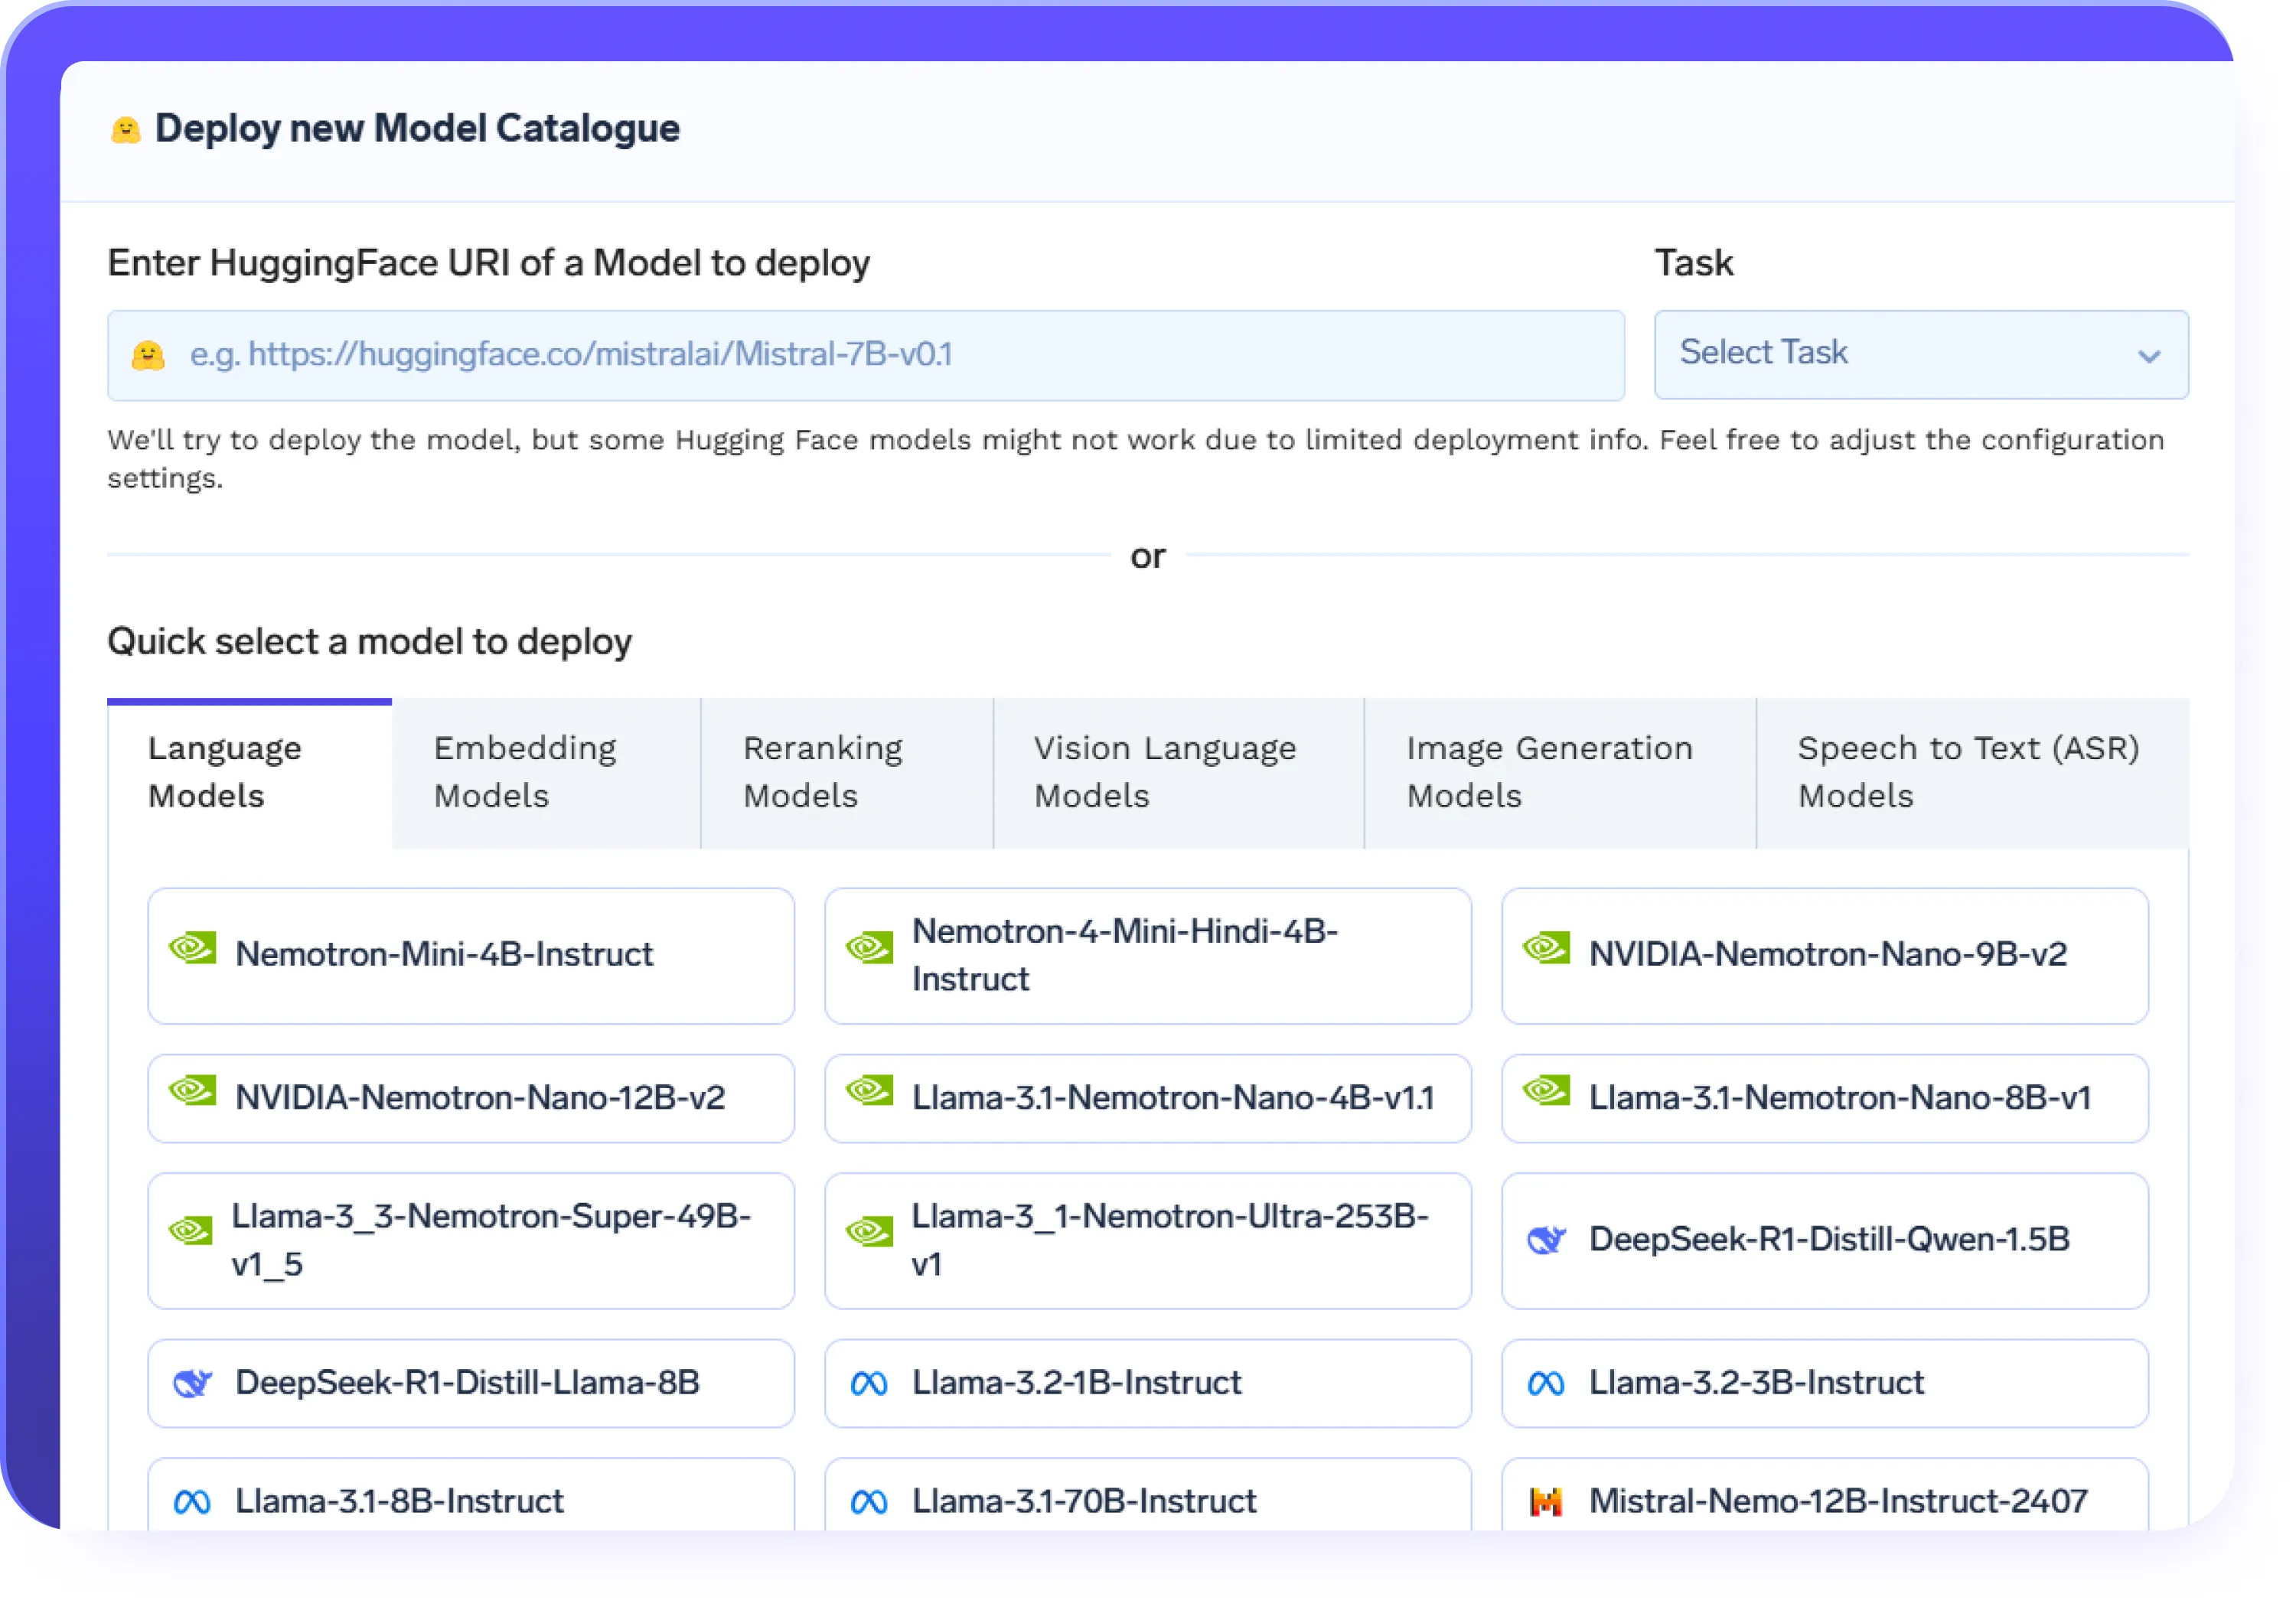
No-code of full-code - de keuze is aan jou
- Fine-tune LLM's met een no-code UI voor een snelle setup en iteratie
- Gebruik je eigen trainingsscripts met volledige controle in de code-modus
- Beheer automatisch de infrastructuur en schaling van resources
- Krijg volledig inzicht in elke fine-tuning run, met ingebouwde logs, statistieken en versiebeheer.
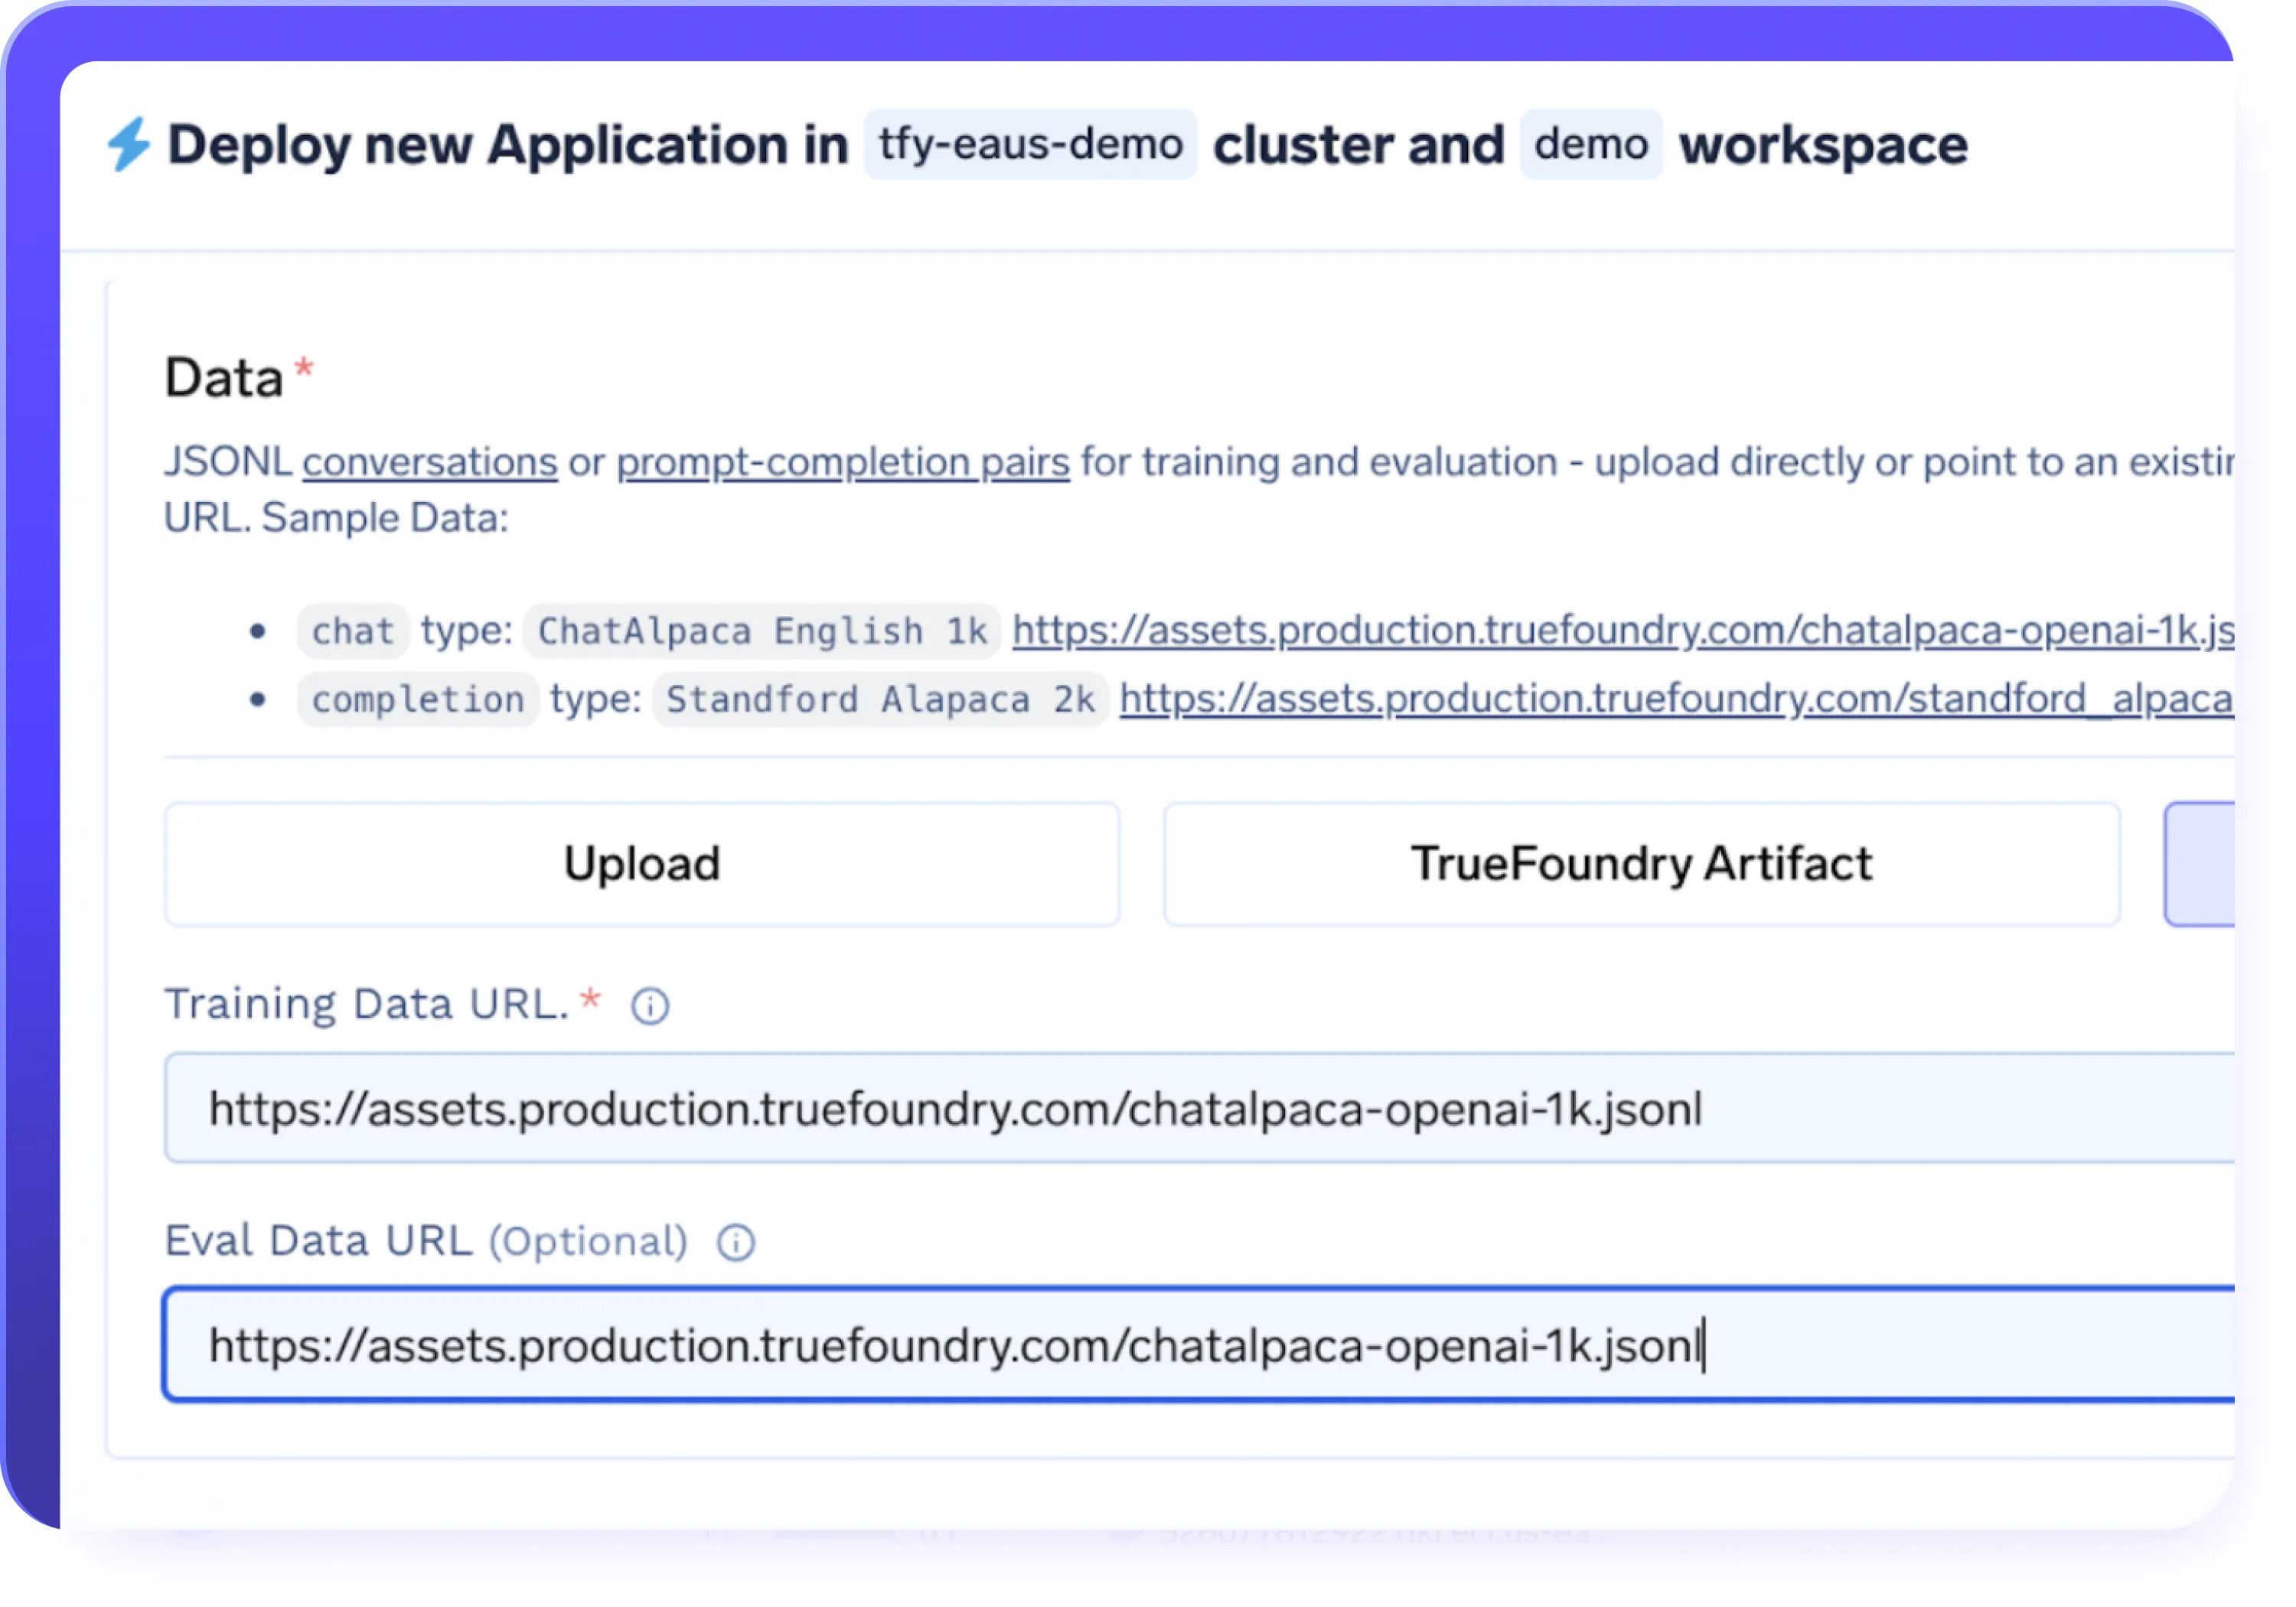
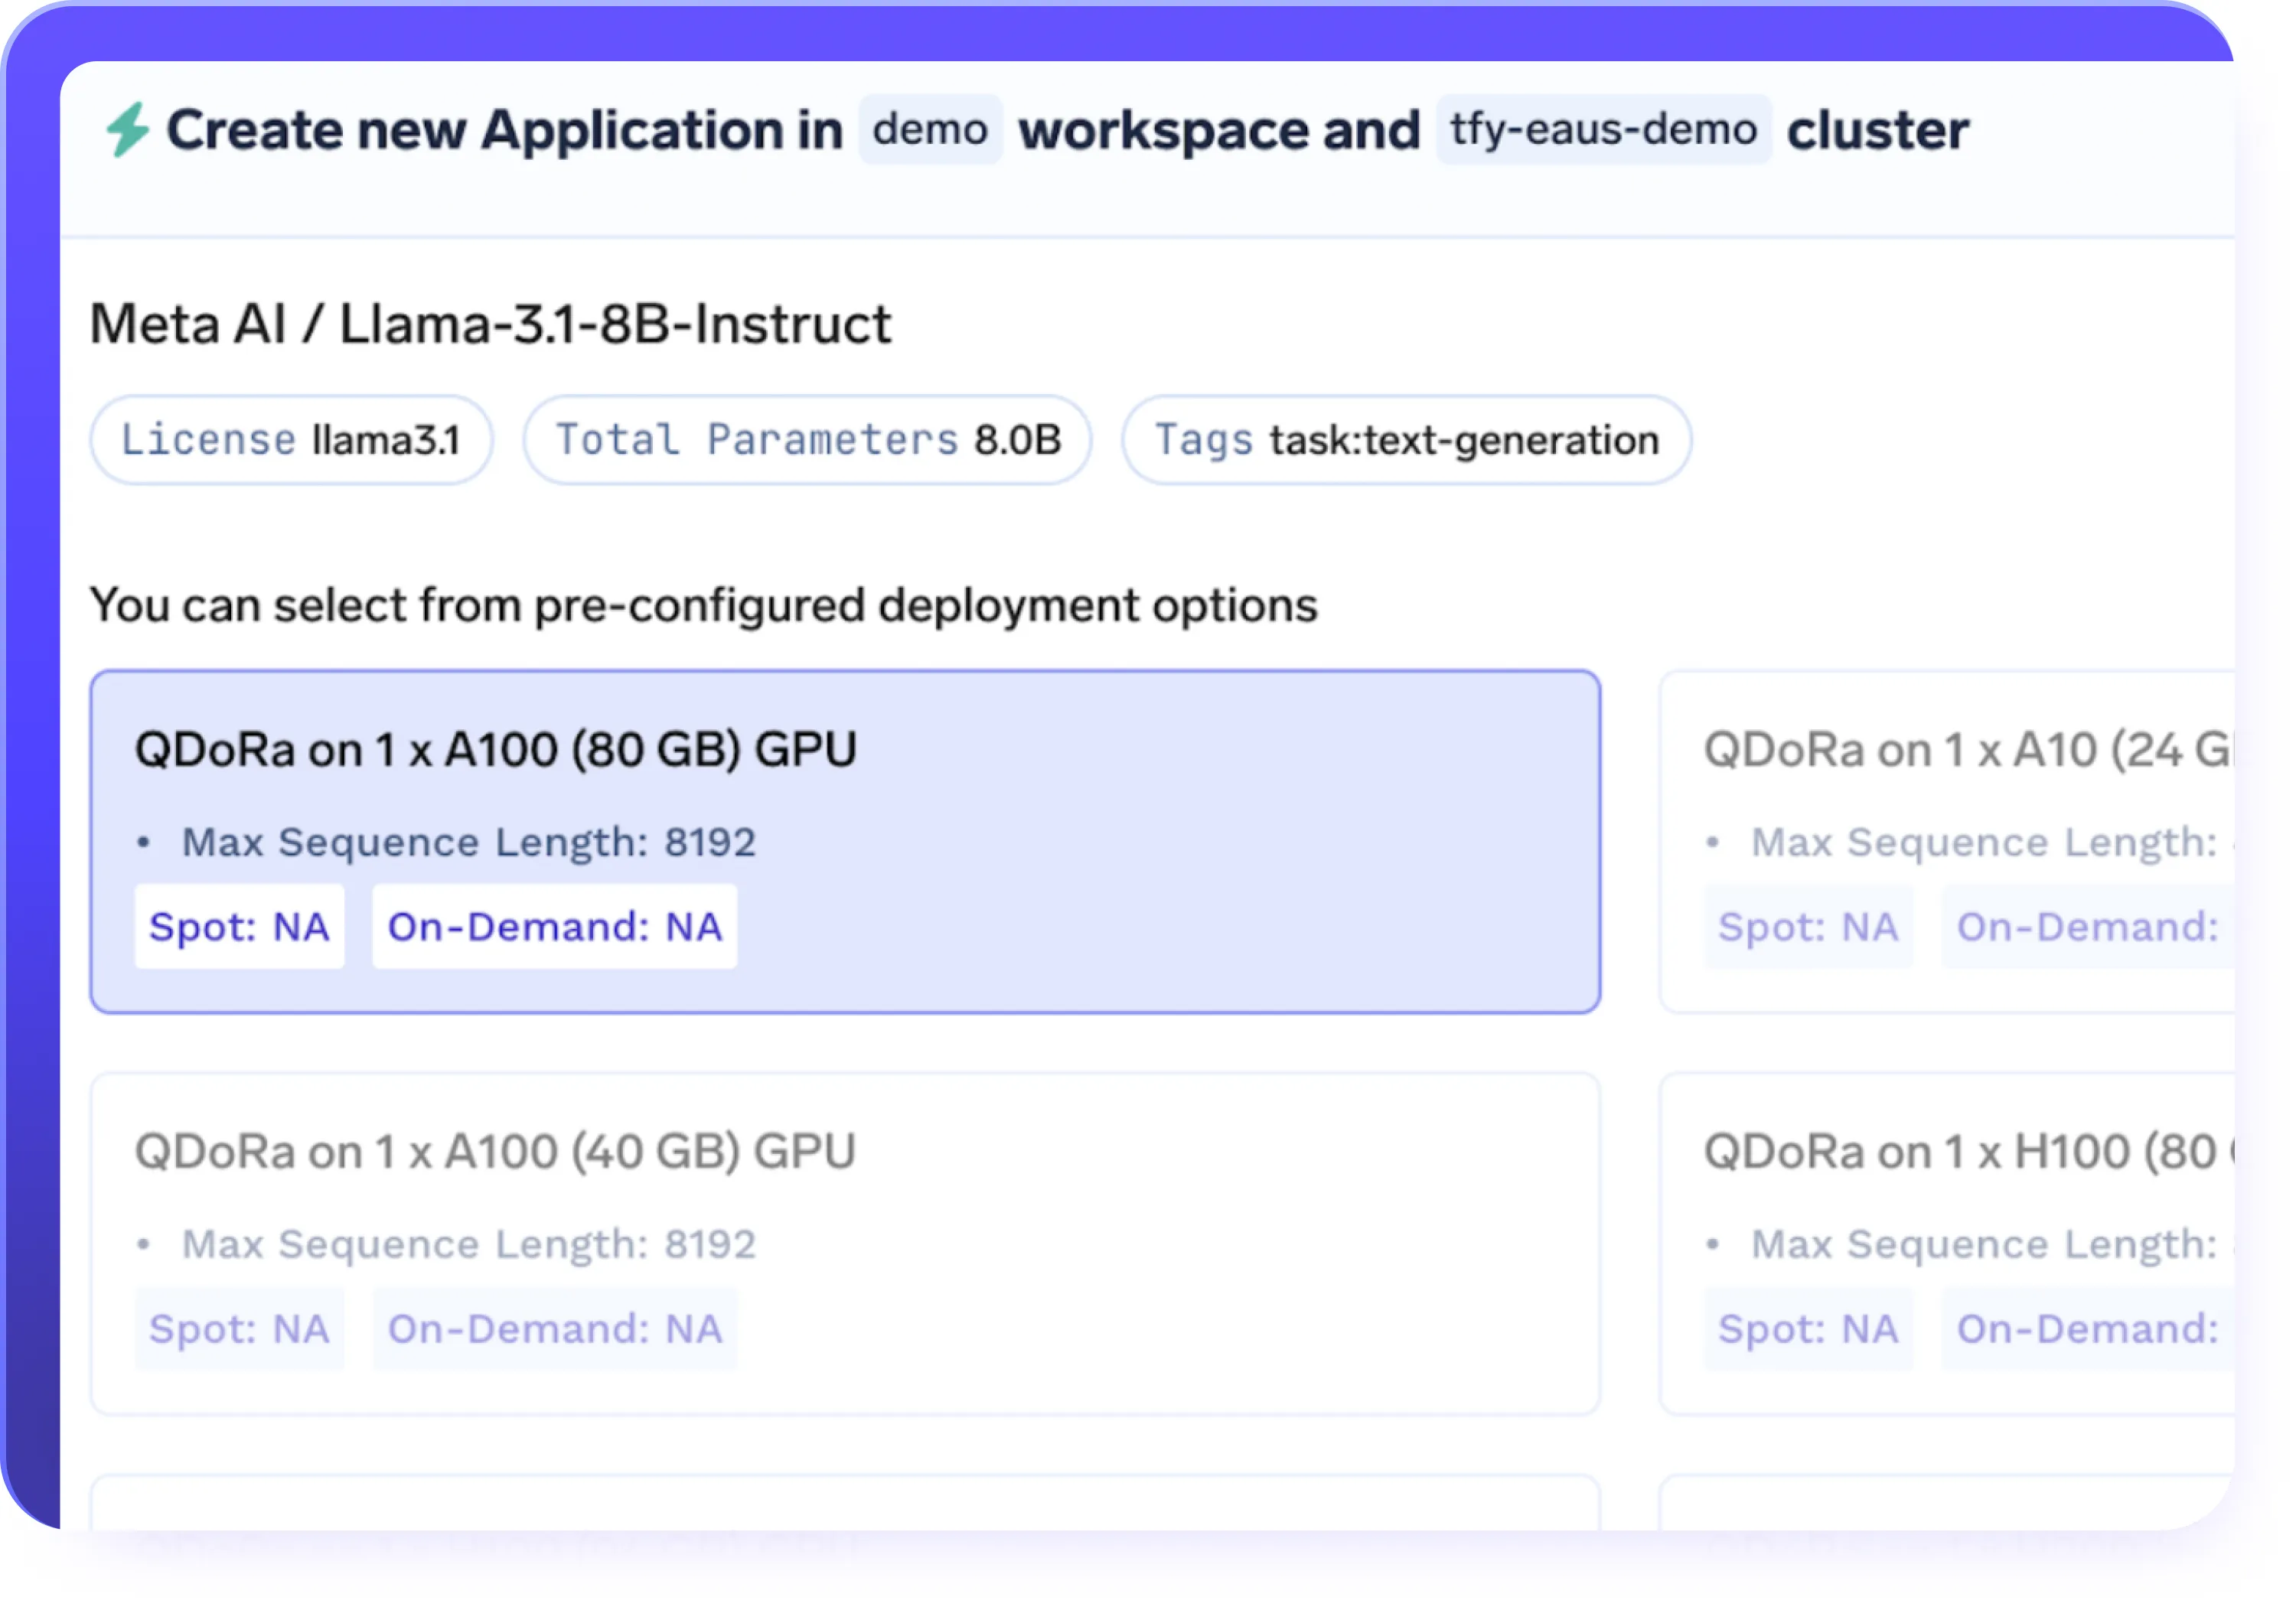
Ondersteuning voor PEFT (LoRA / QLoRA) & Full Fine-tuning
- Ondersteuning voor parameter-efficiënte fine-tuning (LoRA, QLoRA) en full-model fine-tuning
- Kies voor LoRA of QLoRA voor snellere en kostenefficiëntere fine-tuning van grote LLM's
- Verlaag het GPU-geheugengebruik met behoud van modelkwaliteit en prestaties
- Kies de juiste fine-tuning-aanpak op basis van modelgrootte, kosten en workloadbehoeften
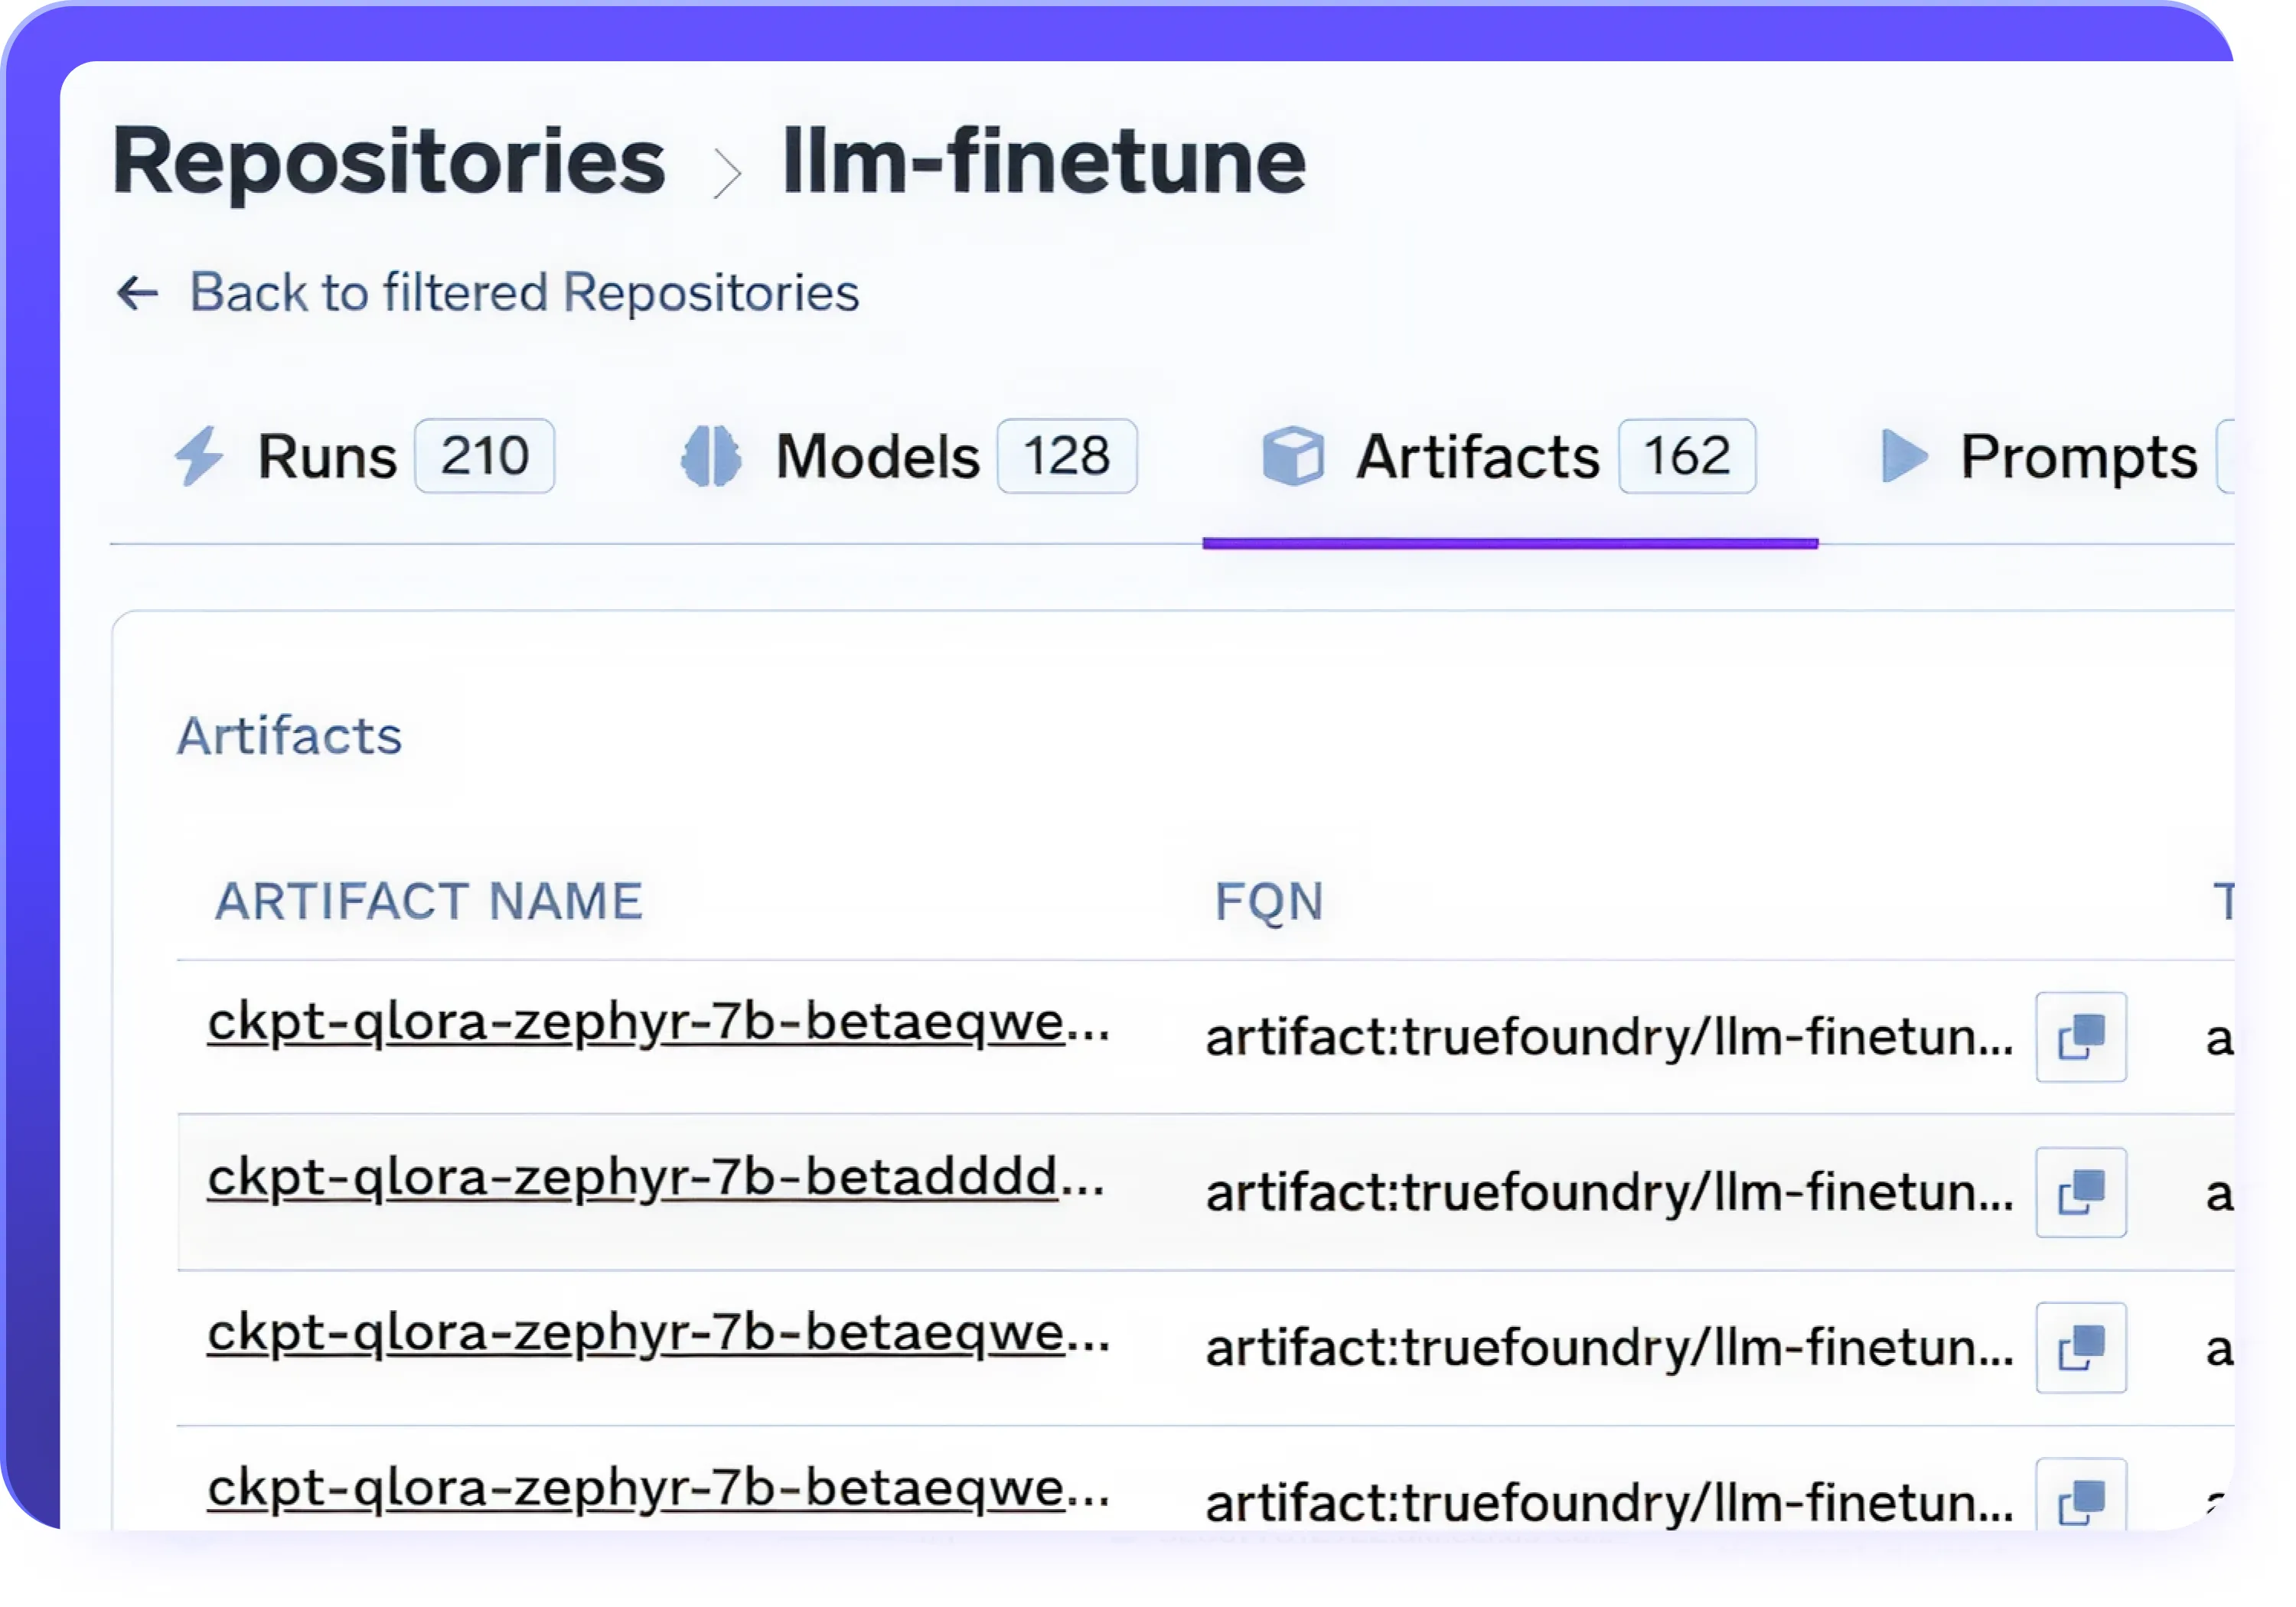
Checkpointing & Versiebeheer
- Sla automatisch checkpoints op tijdens het fine-tunen om verlies van trainingsvoortgang te voorkomen
- Hervat onderbroken of gepauzeerde fine-tuning-taken vanaf elk checkpoint
- Versioneer modellen, datasets en trainingsruns voor volledige reproduceerbaarheid
- Keer terug naar eerdere checkpoints en vergelijk prestaties tussen versies
Ingebouwde experiment-tracking
- Log automatisch alle trainingsmetadata: hyperparameters, statistieken, datasets en outputs
- Vergelijk meerdere runs om LLM's effectiever te fine-tunen
- Integreer met je LLMops-stack of gebruik onze eigen visuele interface
- Ingebouwd versiebeheer zorgt voor reproduceerbaarheid en controleerbaarheid

Adapterbeheer voor efficiënte LLM-finetuning
- Maak gebruik van LoRA-adapters om modellen te fine-tunen door slechts een klein aantal parameters bij te werken.
- Hergebruik voorgetrainde adapters voor verschillende projecten en domeinen
- Combineer of wissel adapters voor verschillende taken, wat snelle experimenten en modulair modelontwerp mogelijk maakt
- Versnel training en verlaag kosten door compacte adaptermodules te trainen in plaats van volledige LLM-gewichten
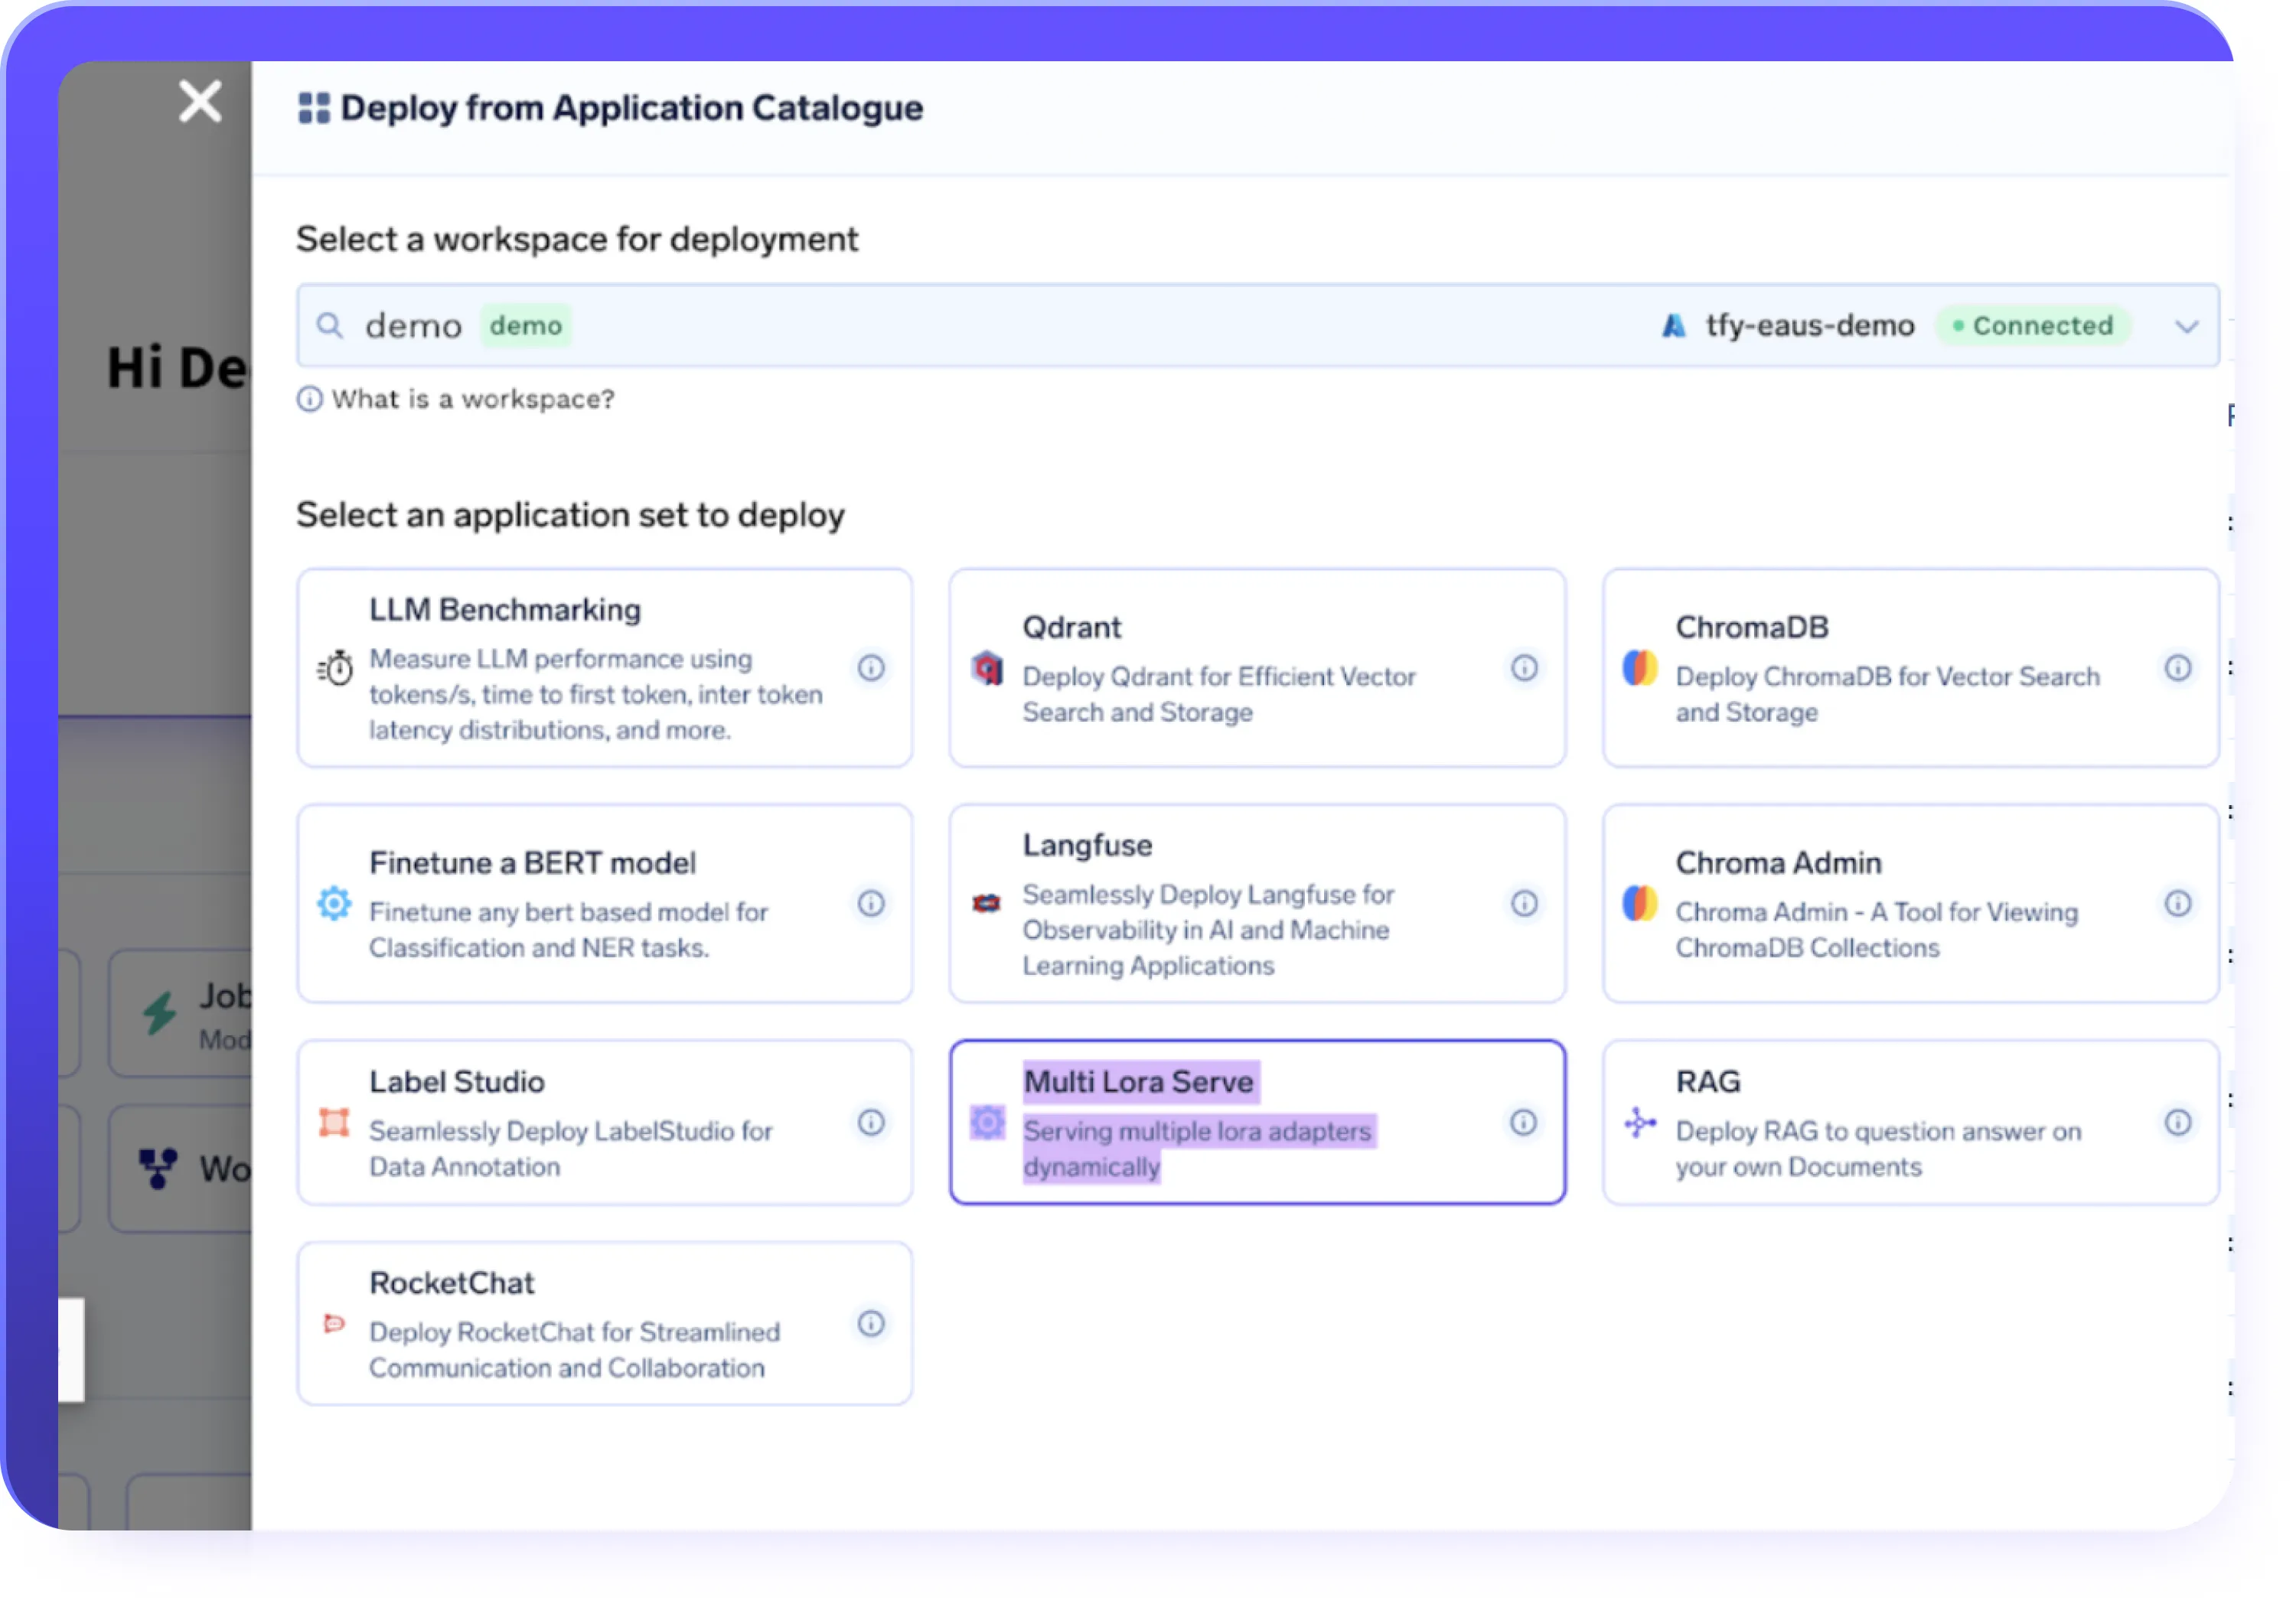
Data- & infra-integraties
- Importeer datasets vanuit S3, GCS, Azure Blob of Hugging Face Datasets
- Voer fine-tuning-taken uit op volledig beheerde infrastructuur of op je eigen clusters
- Implementeer workloads in cloud-, hybride of on-premise omgevingen
- Gebruik standaard GPU-autoscaling, time-slicing en kostenbewuste provisioning
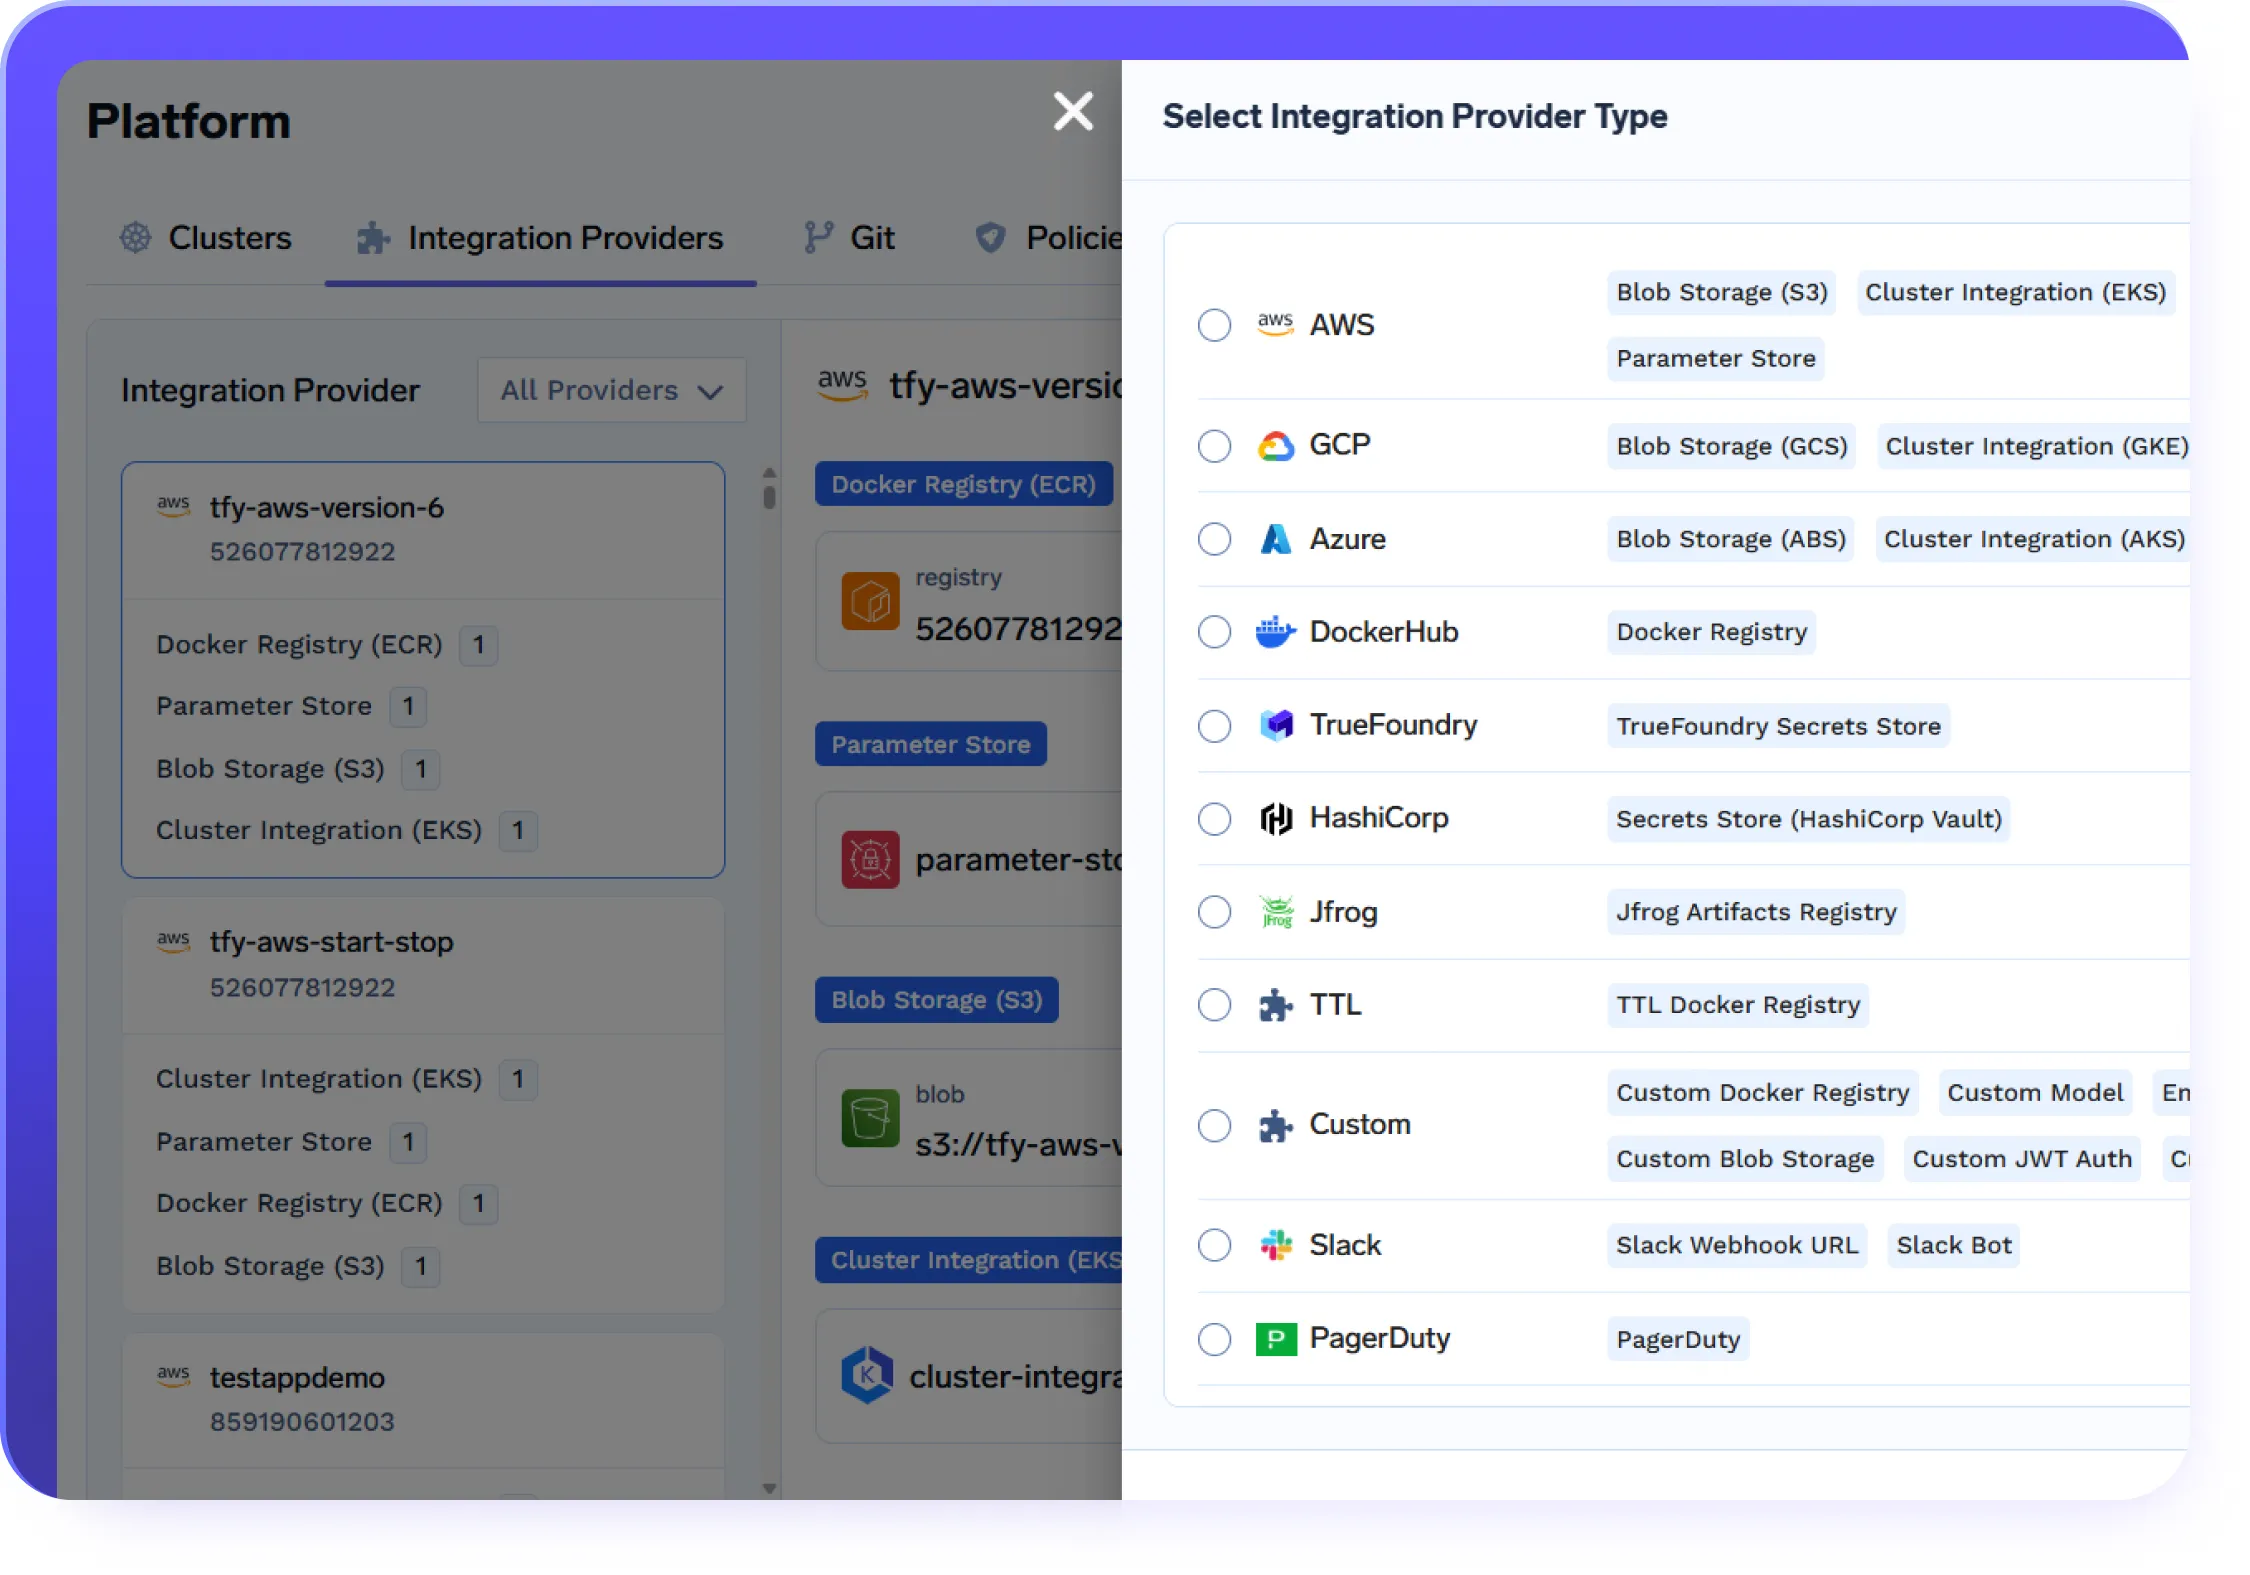
Gemaakt voor AI in de praktijk op grote schaal
Enterprise-ready
Uw gegevens en modellen worden veilig gehost binnen uw cloud- of on-premise-infrastructuur


Compliance & beveiliging
SOC 2-, HIPAA- en GDPR-normen voor robuuste gegevensbeschermingGovernance & toegangsbeheer
SSO + op rollen gebaseerd toegangsbeheer (RBAC) & audit-loggingEnterprise-ondersteuning & betrouwbaarheid
24/7 ondersteuning met SLA-gegarandeerde responstijden
VPC, on-premise, air-gapped of in meerdere clouds.
Er verlaat geen data je domein. Geniet van volledige soevereiniteit, isolatie en enterprise-grade compliance, waar TrueFoundry ook draait.


Echte resultaten bij TrueFoundry
Waarom ondernemingen voor TrueFoundry kiezen
3x
sneller resultaat met autonome LLM-agents
80%
hogere benutting van GPU-clusters na geautomatiseerde agent-optimalisatie
Aaron Erickson
Founder, Applied AI Lab
TrueFoundry veranderde ons GPU-park in een autonome, zelfoptimaliserende engine – wat leidde tot 80% hogere benutting en ons miljoenen aan ongebruikte rekenkracht bespaarde.
5x
snellere ingebruikname van het interne AI/ML-platform
50%
lagere cloudkosten na het migreren van workloads naar TrueFoundry
Pratik Agrawal
Sr. Director, Data Science & AI Innovation
TrueFoundry hielp ons in recordtempo van experimenteren naar productie te gaan. Wat meer dan een jaar zou hebben geduurd, was in enkele maanden klaar – met een betere adoptie door ontwikkelaars.
80%
kortere doorlooptijd voor het in productie brengen van modellen
35%
cloudkostenbesparing vergeleken met de vorige SageMaker-opstelling

Vibhas Gejji
Staff ML Engineer
We hebben de DevOps-last verminderd en de uitrol naar productie voor teams vereenvoudigd. TrueFoundry heeft de levering van ML versneld met een infrastructuur die schaalt van experimenten naar robuuste services.
50%
snellere implementatie van RAG/Agent-stack
60%
reductie in onderhoudslast voor RAG/agent-pipelines

Indroneel G.
Intelligent Process Leader
TrueFoundry hielp ons bij het implementeren van een volledige RAG-stack - inclusief pipelines, vector-databases, API's en UI - twee keer zo snel, met volledige controle over onze eigen infrastructuur.
60%
snellere AI-implementaties
~40-50%
Effectieve kostenreductie in ontwikkelomgevingen

Nilav Ghosh
Senior Director, AI
Met TrueFoundry hebben we de implementatietijden met meer dan de helft verkort en de overhead van de infrastructuur verlaagd via een uniforme MLOps-interface, waardoor we sneller waarde kunnen leveren.
<2
weken om alle productiemodellen te migreren
75%
reductie in coördinatietijd voor data science, wat modelupdates en de uitrol van functies versnelt

Rajat Bansal
CTO
We hebben flink bespaard op infrastructuurkosten en de coördinatietijd voor data science met 75% verminderd. TrueFoundry heeft onze snelheid van modelimplementatie over alle teams heen vergroot.
Veelgestelde vragen
Wat is LLM-fine-tuning en waarom is het belangrijk?
Hoe vereenvoudigt TrueFoundry LLM-fine-tuning?
- No-code & full-code workflows: Gebruik een intuïtieve UI of aangepaste trainingsscripts
- Ingebouwde experiment-tracking: Automatisch loggen van hyperparameters, statistieken en modelversies
- Infrastructuur-orkestratie: Taken uitvoeren op door TrueFoundry beheerde infrastructuur of je eigen cloud/VPC
- Ondersteuning voor PEFT-methoden: Inheemse ondersteuning voor LoRA- en QLoRA-gebaseerde fine-tuning
- Checkpointing & versiebeheer: Training naadloos hervatten en reproduceerbaarheid behouden
- Adapterbeheer: Adapters hergebruiken, samenvoegen of inzetten voor meerdere taken/modellen
Welke soorten modellen kan ik fine-tunen op TrueFoundry?
- Decoder-gebaseerde LLM's (bijv. LLaMA, GPT-J, Falcon, Mistral)
- Encoder-modellen (bijv. BERT, RoBERTa, DistilBERT)
- Encoder-decoder-modellen (bijv. T5, FLAN-T5)
Kan ik mijn eigen dataset en trainingscode gebruiken?
- Gebruik je eigen datasets uit S3, GCS, Azure, Hugging Face Hub of lokale bestanden.
- Gebruik je eigen code via aangepaste trainingsscripts (PyTorch, Transformers, PEFT, enz.).
- Of gebruik kant-en-klare sjablonen voor veelvoorkomende finetuning-workflows.
Hoe ondersteunt TrueFoundry LoRA- en QLoRA-finetuning?
- Gebruik onze UI om LoRA-lagen en hyperparameters te configureren.
- Sla LoRA-adapters op en implementeer ze onafhankelijk van basismodellen.
- Voeg adapters samen met basismodellen voor implementatie of offline inferentie.
- Verlaag het GPU-geheugengebruik drastisch — ideaal voor bedrijven die hun infrastructuurkosten willen optimaliseren.
Kan ik gefinetunede modellen vanuit TrueFoundry in productie nemen?
- Implementeer modellen met vLLM, SGLang of andere inferentieservers.
- Stel je model beschikbaar als API met geïntegreerde rate limiting en RBAC.
- Monitor real-time latentie, tokengebruik en prestaties.
- Gebruik adapters voor snelle implementatie of voeg ze samen met het basismodel voor standalone inferentie.

GenAI-infrastructuur: eenvoudiger, sneller, goedkoper
Vertrouwd door meer dan 30 ondernemingen en Fortune 500-bedrijven





