Blank white background with no objects or features visible.

「Gartner Hype Cycle for AI Governance 2026」の全編を無料で公開しています。レポートを入手する →

TypeSafe AIのJevと「システム1モデル」:実際にリリースされたものとは

By アシシュ・ドゥベイ

Updated: October 7, 2026

Published: September 18, 2026

TypeSafe AIの発表内容

TypeSafe AI は、OpenAIでChatGPTの基盤となった指示追従研究に携わったDiogo Almeida氏が、Erik Gafni氏およびSasha Sheng氏と共に設立したAIラボです。約2年間のステルス期間を経て、2026年9月15日にローンチを発表し、DCVCが主導する4,000万ドルのシード資金調達も明らかにしました。その後数日間で、DataCampや複数の業界メディアがこれを取り上げました。

ローンチ記事の切り口は、ベンチマークではなく一つの問いかけでした。「AIモデルは長年チャットにおいて人間を超越してきたのに、なぜ自動化が進まないのか?」TypeSafeの答えは、ボトルネックは生の知能ではなく、文章で返答するモデルがソフトウェア構築のコンポーネントとして扱いづらい点にある、というものです。同社のマニフェストでは、より端的に「今日のAIは、その向こう側に人間がいることを前提に学習されている」と指摘しています。

Jevはこの前提に基づいて構築された最初のモデルです。名称は、コストの低下が消費の増大を招くというパラドックスを提唱したウィリアム・スタンレー・ジェヴォンズに由来します。「システム1」という呼称は、ダニエル・カーネマンが提唱した、遅く熟慮的な「システム2」とは対照的な、速く直感的な「システム1」の思考プロセスにちなんでいます。

「システム1モデル」の正体

本番環境で利用可能な AIモデルの種類 の中でも、このモデルは「何をあえて捨てるか」によって定義されています。チャットモデルは文字列を返しますが、文字列は何にでもなり得ます。回答、拒否、推論の段落、あるいはパーサーが処理できない不正な形式などです。しかし、Jevは文字列を一切返しません。

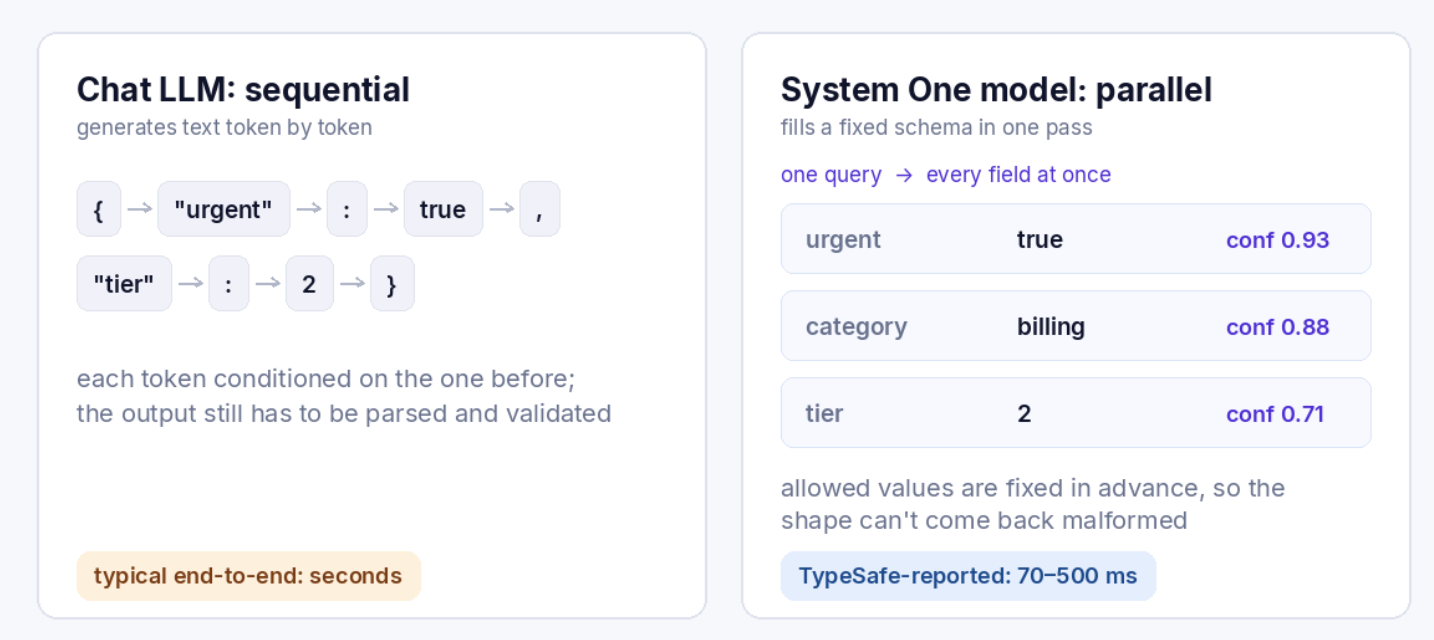
その代わり、回答の形式を事前に宣言します。必要なフィールドと、各フィールドが取り得る値を指定すると、モデルは確率を付与した状態でフィールドを埋めて返します。TypeSafeは、この結果を「フロンティア・インテリジェンスによる関数呼び出し」と表現しています。非構造化データを受け取り、型定義された確率的決定を出力するのです。実際には、チャットボットというよりは、 AI意思決定エンジン としてコードから呼び出すような挙動をします。

この設計により、以下の3つの特性が生まれます。

  • 並列サンプリング。 各フィールドはトークン単位ではなく一度のパスで生成されるため、高速な処理が可能となります。
  • 構造によるスキーマ準拠。 可能な出力が事前に列挙されているため、型エラーが発生する可能性は排除されています。TypeSafeは、反例が一つでもあれば容易に否定できると述べています。
  • すべての回答に対する調整済みの信頼度。 各出力には確率が付随しており、TypeSafe社が「RLCD(Reinforcement Learning for Calibrated Decisions:調整された意思決定のための強化学習)」と呼ぶ学習目的は、人間の好み(RLHF)やプログラムによる検証可能な報酬(RLVR)ではなく、それらの確率が誠実であることを最適化します。

チャットLLMはトークンごとに回答を生成しますが、System Oneモデルは固定スキーマの全フィールドを一度のパスで埋め、それぞれに信頼度スコアを付与します。

この3つ目の特性こそ、最も過小評価されがちなものです。95%の確率で正解を出せても、残りの5%がどれなのかを教えてくれないモデルでは、自動化は困難です。一方、誠実な不確実性を報告するモデルであれば、信頼度スコアに基づいて条件分岐を行い、信頼度の低いケースを人間やより大規模なモデルに振り分けるといった自動化が可能になります。

チャットLLMとの違い

Chat / Reasoning LLM vs Jey Comparison
Chat / reasoning LLM Jey (System One)
Returns Strings — text to be parsed and validated Typed values from a pre-declared schema
Sampling Sequential, one token at a time Parallel, all fields in one query
Confidence Overconfident and inconsistent when asked Calibrated probability on every field
Latency 3–329 s across frontier models, per the third-party benchmark TypeSafe cites 70–500 ms, TypeSafe-reported
Input price ~$0.20–$10 / MTok $0.042 / MTok
Output price Roughly 5x input Free — "too cheap to meter"
Failure mode Can hallucinate, refuse, or emit an unparsable shape Cannot leave the schema; can still pick the wrong allowed value
Best fit Drafting, summarising, tool-using agents, human-in-the-loop work Classify, route, score, extract, verify — decisions inside code
Availability Broadly available, many providers Waitlisted early access, one hosted API

知っておくべき実用上の制限として、Jevは選択肢ごとに最大255個のカーディナリティ(濃度)をサポートしています。これを超える場合、TypeSafeは候補を個別にスコアリングしてから明示的に選択するという2段階のアプローチをとりますが、これについては処理速度が低下することを認めています。

検証可能なものとベンダーの主張

発表された数値は異例の大きさであり、その根拠も非常に自己完結的であるため、この部分は立ち止まって検討する価値があります。TypeSafe社を評価すべき点として、同社の投稿には各結果の下に「ニュアンス」に関する注釈が含まれており、以下の内容の大部分はそこから引用しています。

‍

現時点で独自に確認可能なもの:

‍

  • 価格設定。 公開されています。検証できないのは、それが補助金によるものではなく持続可能なものかどうかという点ですが、TypeSafe社自身もその点に触れており、価格は上昇するのではなく低下していくと見込んでいます。
  • スキーマ準拠。 出力形式に関する保証は、一度でも誤った応答があれば反証可能です。TypeSafeが掲げる「型エラー率0%」という数値は、測定されたものではなく、その構造から導き出されたものです。
  • 呼び出しごとのレイテンシ。 アーリーアクセス権を持つ人なら誰でも計測可能ですが、公開されている実行結果は米国西海岸にあるチーム自身のラップトップから得られたものであるという点には注意が必要です。
  • ローンチそのもの。 資金調達、創業者の経歴、および可用性については、いずれも独立した報道機関によって裏付けられています。

‍

自己申告であり、まだ独自に再現されていないもの:

‍

  • 193.6倍の高速化と444.6倍のコスト削減という数値について。 これらはTypeSafe社独自のワークフロー評価に基づくものです。同社が設計したこの新しい評価形式では、すべてのモデルが同一の計算グラフを実行し、GPT-6 AstraとFable 5.1の平均値から導き出された参照確率と照らし合わせてスコアリングされます。TypeSafe社自身も、以下の3つの制限事項を指摘しています。ワークフローが同社のモデル能力チームによって構築されたこと、参照モデルの選択がOpenAIやAnthropicに有利に働くバイアスがあること、そして競合するLLMがTypeSafe独自のSystem Oneアダプターを介して実行されていることです。
  • フロンティアモデルと同等の知能。 この主張は、 System One形式のタスクにおいて 同等であるというものです。具体的には、主にGPT-5.6 Terraを基準としてベンチマークが行われています。これは一般的な能力に関する主張ではなく、そのように解釈すべきではありません。
  • ハルシネーション(幻覚)の比較について。 そのグラフにあるLLMの数値はOpenRouterのトラフィックから得られたものですが、TypeSafe社も指摘している通り、難易度の高いクエリほど高性能なモデルにルーティングされるため、バイアスがかかっている可能性があります。

‍

依然として不明な点: 公開ベンチマークでのパフォーマンス、明確に意思決定の形をしていないタスクでの挙動、第三者が使用した場合のドメイン特化型作業における精度、そして大規模な本番環境での信頼性については一切不明です。アーリーアクセスは今週始まったばかりです。

‍

また、要約される過程で単純化されてしまう可能性があるため、正確に理解しておくべき表現上の問題もあります。TypeSafe社はJevについて ハルシネーションを起こさないと述べており、自由記述のテキストを一切出力しないモデルであれば、存在しない引用やツール名を捏造することはないという意味では、その通りと言えます。しかし、 LLMのハルシネーション と正確性は、同じ問題ではありません。許可された3つのカテゴリから選択するように制約されたモデルであっても、自信を持って間違った選択をする可能性はあります。排除されたのは「形式の誤った回答」であって、「判断の誤り」ではないからです。TypeSafe社はこれに対する回答としてキャリブレーション(調整)を挙げていますが、このキャリブレーションこそが、第三者による検証を必要とする主張なのです。すでに JSONスキーマを用いた構造化出力 を利用しているチームであれば、この違いを理解できるはずです。回答の形式を制限したからといって、その内容の正しさが保証されるわけではないのです。

プロダクションスタックにおける意思決定モデルの役割

具体的なローンチの内容は一旦脇に置いておきましょう。その数値よりも、構造の方がはるかに興味深いからです。TypeSafeが主張し、また多くのチームが独自に到達しつつある結論は、あらゆるリクエストに対して汎用モデル一つで対応するのはプロトタイプ段階のパターンであり、プロダクション(本番環境)向けではないということです。

‍

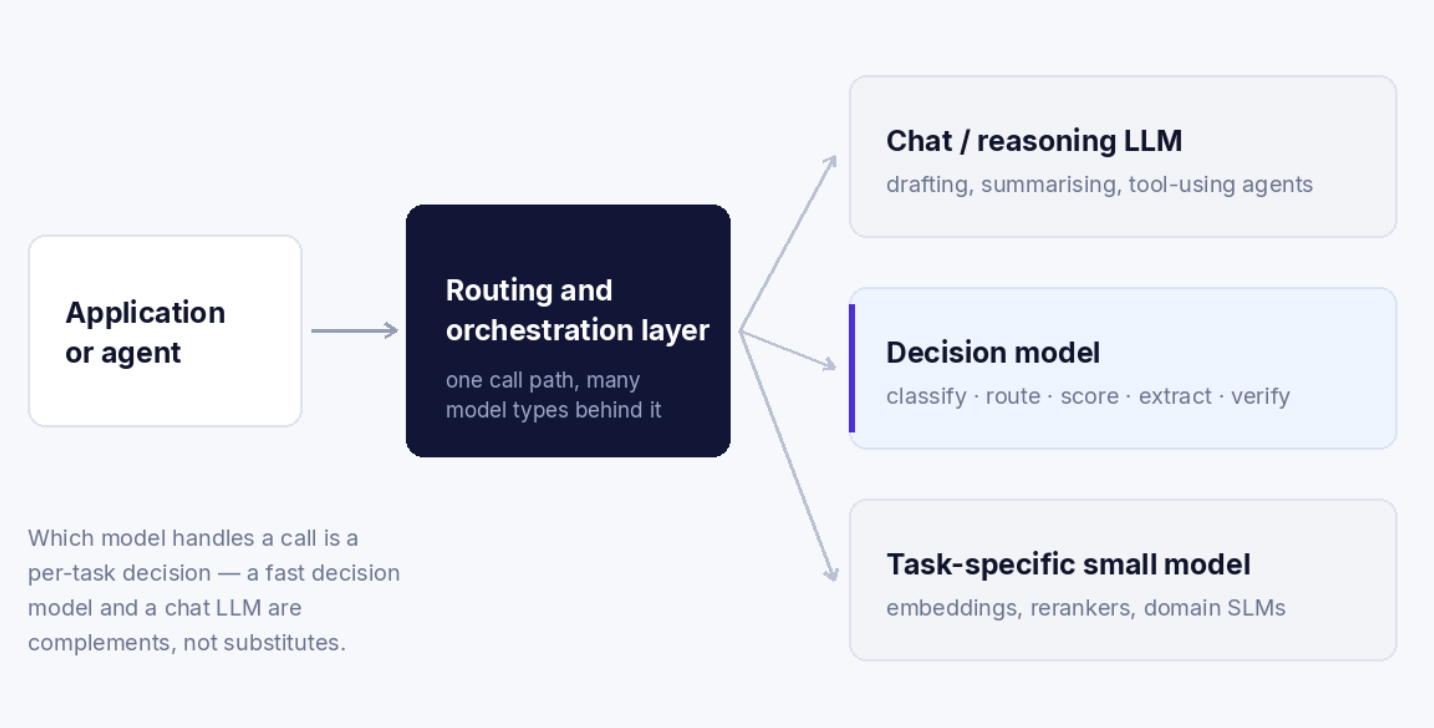
プロダクションスタックは、最終的に複数のモデルタイプを同時に保持するようになり、ルーティング層がどのリクエストにどのモデルを割り当てるかを判断するようになります。 

‍

稼働中のシステム内で行われる意思決定のほとんどは、小規模で反復的なものです。例えば、「このチケットは緊急か?」「どのキューに属するか?」「この回答はポリシーに違反していないか?」「これらのフィールドのうちどれが請求書番号か?」といった判断です。これらすべてを最先端のチャットモデルに送ることは可能であり、実際にそうしているチームもありますが、それは単なる照会に近い処理に対して、生成コストと生成レイテンシを支払っていることになります。これと同じ計算が、 大規模モデルにプロンプトを投げる代わりに、小規模モデルを特化させるタイミングを選択する際にも働いています。そして、これこそがスコアリング、判定、脱獄(ジェイルブレイク)検知、 エージェントのガードレール といった検証型のタスクにおいて、TypeSafeが先陣を切っている理由です。ガードレールはすべてのリクエストに対して実行される必要があるため、純粋な性能よりもコストとレイテンシが制約条件となります。

‍

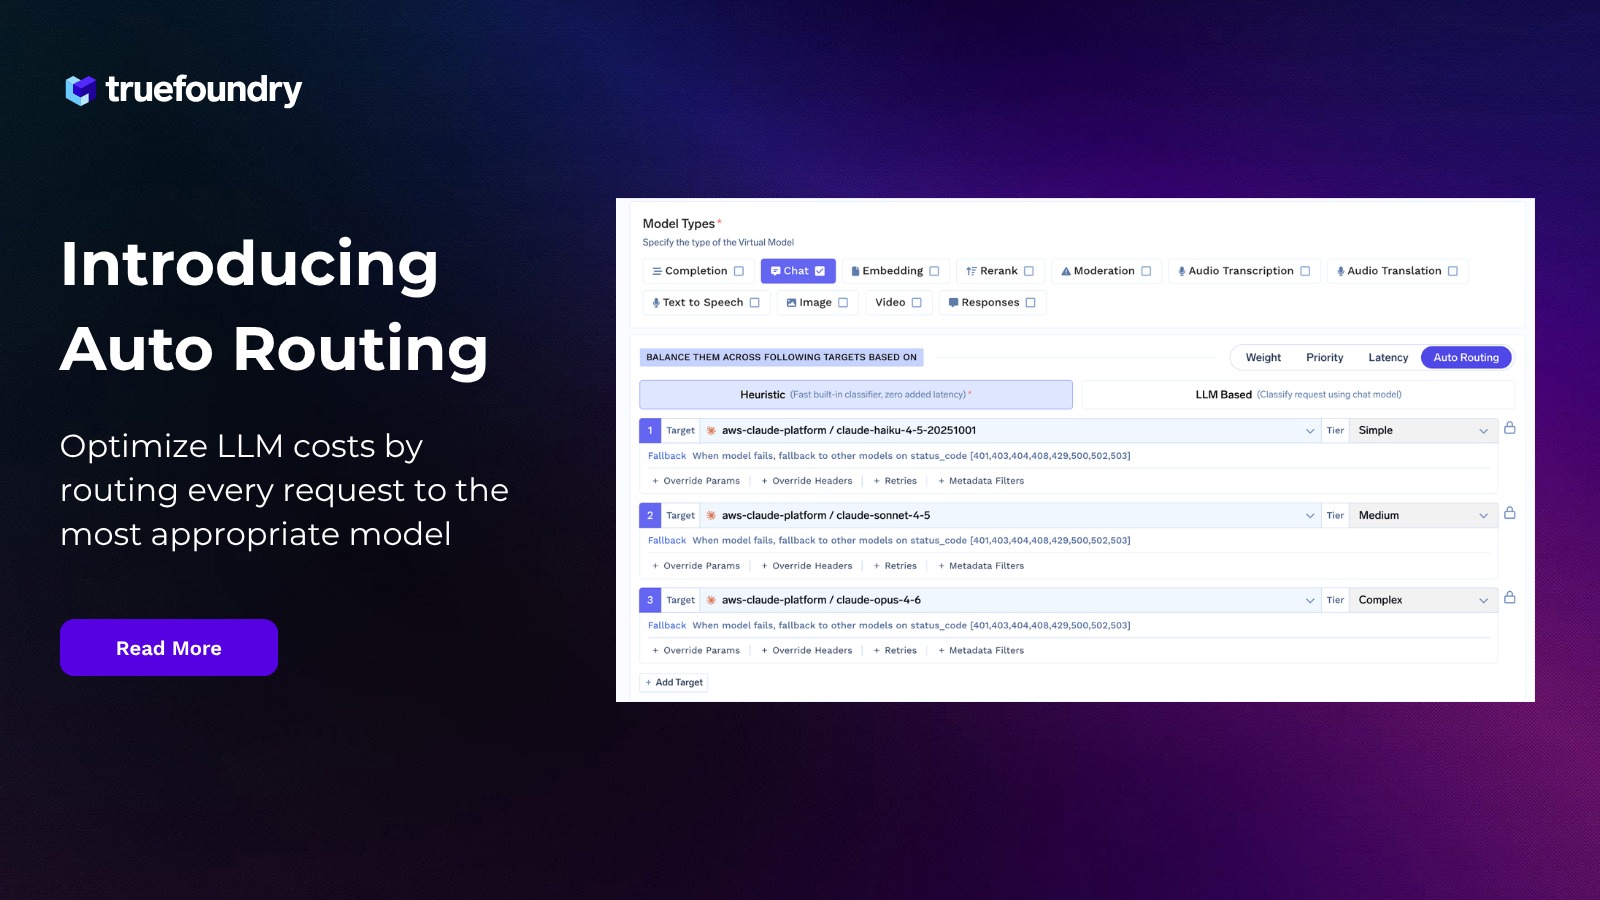
AIを本番環境で運用するすべての人にとって、これはモデル選択の問題ではなく、 AIオーケストレーション の問題となります。あるリクエストにはチャットLLM、別のリクエストには高速な意思決定モデル、さらに別のリクエストにはファインチューニングされた小規模モデルが最適であるならば、安定させるべきはそれらの手前にある層です。つまり、単一の呼び出しパス、一貫した認証とログ記録、そしてアプリケーションを書き直すことなく特定のタスクを処理するモデルを自由に入れ替えられる柔軟性が必要なのです。これこそが、 TrueFoundry AI Gatewayの自動ルーティングの背後にある前提であり、今回のローンチがベンチマークとしてよりも、アーキテクチャ上のシグナルとして興味深い理由です。

‍

現時点では、Jevはアーリーアクセス版のクローズドなホスト型APIであり、デプロイや評価すべき統合先はありません。今後状況は変わるかもしれませんが、それが示すパターンが変わることはまずないでしょう。

‍

Try now.

One gateway for all your models, MCP servers, and agents.
No credit card needed.

Start free
Table of Contents

One Gateway for Every LLM, Agent and MCP Server

Book a 30-min with our AI expert

Book a Demo

The fastest way to build, govern and scale your AI

Book Demo
Summarize with
ChatGPT logo by OpenAI
Perplexity AI logo
Blurry red snowflake on white background, symmetrical frosty design with soft edges and abstract shape.

Discover More

No items found.
 What is an LLM Gateway
November 2, 2026
|
5 min read

What Is an LLM Gateway? A Complete Guide

エンジニアリングとプロダクト
 Everything you need to know about AI agent harness
November 2, 2026
|
5 min read

What is an Agent Harness? Running Governed Managed Agents in Production

エージェントAI
November 1, 2026
|
5 min read

The Identity-Broker Pattern for AI Agents: One Trust Boundary for Every Credential

No items found.
November 1, 2026
|
5 min read

Claude API Pricing: A Model-by-Model Cost Breakdown

No items found.
September 16, 2026
|
5 min read

Fine-Tuning vs Prompting: When to Specialize an SLM

No items found.
October 6, 2026
|
5 min read

構造化出力:AIの本番運用になぜ文章だけでなくスキーマが必要なのか

No items found.
October 6, 2026
|
5 min read

AIエージェントのガードレール:すべてのツール呼び出しとモデルホップを検査する

No items found.
October 7, 2026
|
5 min read

TrueFoundry AI GatewayのAuto Routingのご紹介

No items found.
October 7, 2026
|
5 min read

トークン消費からワークフローの経済学へ:BCGの「Return-on-AI」フレームワークが求めるもの

No items found.

Recent Blogs

Black left pointing arrow symbol on white background, directional indicator.
Take a quick product tour
Start Product Tour
Product Tour