October 14, 2026
|
5 min read

Published: October 7, 2026
Blazingly fast way to build, track and deploy your models!
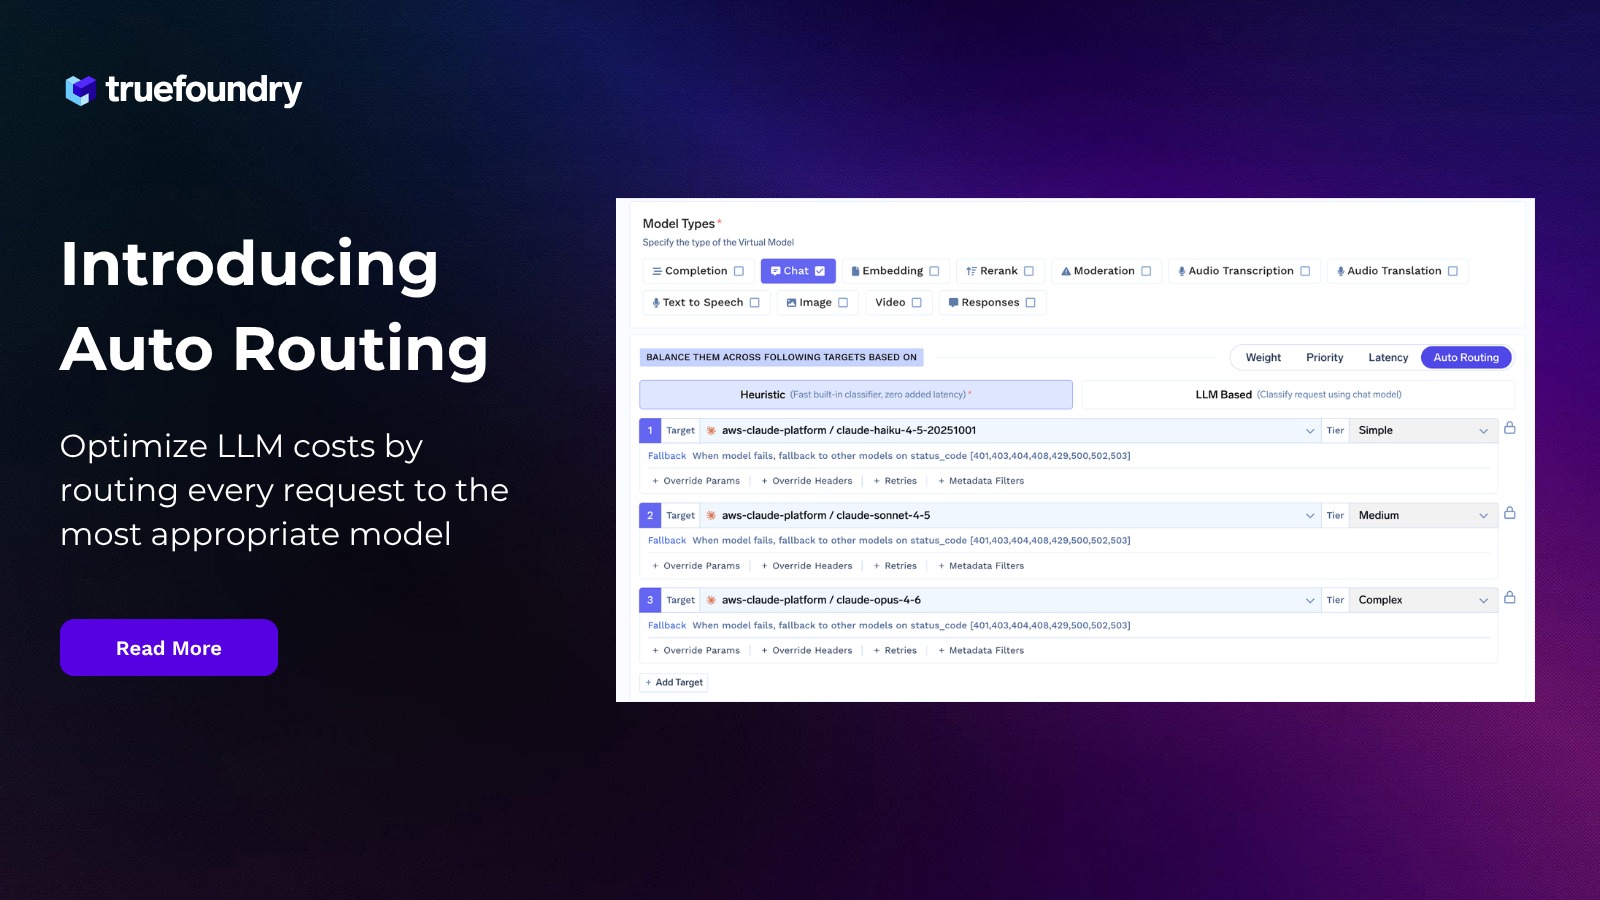
TrueFoundry AI Gatewayに新しい機能が追加されました。この自動ルーティング機能は、受信した各リクエストを読み取り、3つの複雑性レベルのいずれかに分類した上で、そのレベルに割り当てられた最適なモデルへと送信します。
この機能は、お客様のトラフィックによく見られるパターンを解決するために開発されました。通常、クエリの大半は単純なものであり、軽量なモデルで処理可能です。複雑なモデルへのルーティングが必要なクエリはごく一部に過ぎません。しかし実際には、複雑さに関係なく、すべてのクエリに対して一律のモデルが割り当てられているケースがほとんどです。その結果、企業はサイクルごとに不必要な高額請求に直面することになります。ルーティングルールをハードコーディングする方法では、各チームが独自のルーティングロジックを適用してしまい、標準化が図れないため、拡張性もありません。
その役割を担うのが、このゲートウェイです。
過去2年間の大半において、チームはAIの導入状況を消費量で測定してきました。消費されたトークン数が、成果の代わりとなっていたのです。一部の企業では、最も多く利用した人を称える社内ランキングまで作成していました。AI導入の初期段階において、どれだけの作業をモデルにオフロードできるかを把握することが目的であったなら、これは理にかなっていたかもしれません。
しかし、請求書が届き始めました。ある IDCによるクラウドおよびAIの意思決定者を対象とした調査によると、61%の組織が2025年度のクラウドAI予算を大幅に超過しました。UberのCTOは、チームの年間AI予算を4月中旬までに使い果たしたことを明らかにしています。推論ループは長くなり、コンテキストウィンドウは肥大化し、エージェントは誰の監視もないまま、1日に何千回も自律的にモデルを呼び出すようになりました。
そこで優先順位が変わりました。「トークン最大化」に代わって「トークンエコノミクス」が重視されるようになり、導入や実験のスピードを落とすことなくAI支出を抑制する戦略が求められています。つまり、リアルタイムのコスト可視化、チャージバックモデル、チームごとのコスト配分、利用上限設定への注目が高まっています。これらはすべて重要な機能ですが、支出を監視・制限するだけであり、最適化するものではありません。
請求額を左右する決定は、もっと早い段階で、もっと迅速に行われます。それは「どのモデルにこのリクエストを割り当てるか」という判断です。これこそが、自動ルーティングが機能する領域です。
自動ルーティングは 仮想モデル上で設定されます。これはアプリケーションが呼び出す単一の名前付きエントリーです。特定のモデルを割り当てることができる3つの複雑性階層が用意されています。
階層の割り当ては仮想モデル上で行われるため、より優れた、あるいは安価なモデルが登場した際には、アプリケーション側のコードを変更することなく、背後のモデルをいつでも入れ替えることができます。ルーティングポリシーは、所有者や変更履歴が管理され、一元的に編集可能な設定オブジェクトとなります。
各クエリが3つの階層のいずれかに分類される方法には、以下の2通りがあります。
ヒューリスティック分類器はプロンプトを読み取り、あらかじめ定義された一連のシグナルに基づいてスコアリングを行い、ティアを選択します。ゲートウェイプロセス内で実行されるため、レイテンシやコストは発生せず、完全に決定論的な動作をします。
以下のパラメータに基づいてクエリの複雑さを判断します。
ここでは分類器モデルを選択します(仮想モデルではなく、カタログ内のチャットモデルである必要があります)。また、タイムアウト時間をミリ秒単位で設定します。さらに、その呼び出しが失敗した場合の動作も設定する必要があります。フォールバックオプションは2つあり、組み込みのシグナルによる判断に戻す「ヒューリスティック」と、指定したティアにすべて送信する「静的」から選択可能です。分類器の失敗によってリクエスト自体が失敗することはありません。
これには2つのトレードオフがあります。分類器はリクエストの前にモデル呼び出しとして実行されるため、レイテンシが発生します。また、これは課金対象のゲートウェイリクエストとなり、トリガーとなったリクエストと同じテナントおよびサブジェクトに帰属します。
自動ルーティングは単純なルーティングルールを超え、精度を維持しながらモデルの利用コストを最適化するための追加機能を提供します。
私たちは、すべてのリクエストをClaude Opus 5に送信するベースラインと比較して、16の公開データセットと約4,700件の呼び出しを用いてAuto Routingをテストしました。これには無料のヒューリスティック分類器と、Haiku、Sonnet、Opusの階層構造を使用しています。評価は決定論的です。生成されたコードは各ベンチマークのユニットテストをサンドボックス内で実行し、数学や選択問題の回答は正解キーと照合されます。
いずれのケースにおいても、品質を損なうことなく大幅なコスト削減が実現しました。
詳細な手法、データセットごとの内訳、および本番環境のトラフィック分析については、エンジニアリングの深掘り記事をご覧ください: 品質を落とさずにLLMコストを3分の1に削減する方法。
Auto Routingは仮想モデル上で動作します。 AI Gateway → Models → Virtual Modelに移動し、 Complexity をルーティングタイプとして選択し、分類戦略を選んで、利用したい各階層のターゲットを設定してください。その後、アプリケーションの接続先を仮想モデルの名前に変更し、プレイグラウンドでさまざまな複雑さのプロンプトを使用してテストを行ってください。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.