



October 28, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
数百ものツールに接続されたエージェントであっても、すべてのモデル呼び出しに数百ものツールスキーマを含める必要はありません。読み込みを遅延させることで、カタログを永続的に保持することなく、必要な時に利用可能にできます。
エージェントをツールサーバーに接続することは、「ランタイムがどの機能に到達できるか」という問いに対する答えです。一方、すべてのツール定義をモデルのコンテキストに読み込むことは、「このステップでモデルが考慮すべき説明やスキーマは何か」という別の問いに対する答えとなります。
これらの問いは混同されがちです。小規模なデモであれば、1つのサーバーが少数のツールを公開しているため、それらをプリロードしても問題はありません。しかし、エンタープライズ規模のカタログでは、エージェントが多数のMCPサーバーに接続し、それぞれが数十もの操作を持つ可能性があります。定義には名前、説明、入力スキーマ、そして場合によっては出力スキーマが含まれます。モデルは、ユーザーがそれらを必要とするかどうかを知る前に、そのコンテキストコストを支払うことになります。
TrueForgeの遅延ツール読み込み機能は、到達可能性と即時的な可視性を分離します。ドキュメント化されたデフォルト設定では、プリロードは無効になっています。起動時、モデルはMCPサーバーの名前と説明のみを認識します。個々のツールスキーマは、タスクで必要になった時点で検出されます。
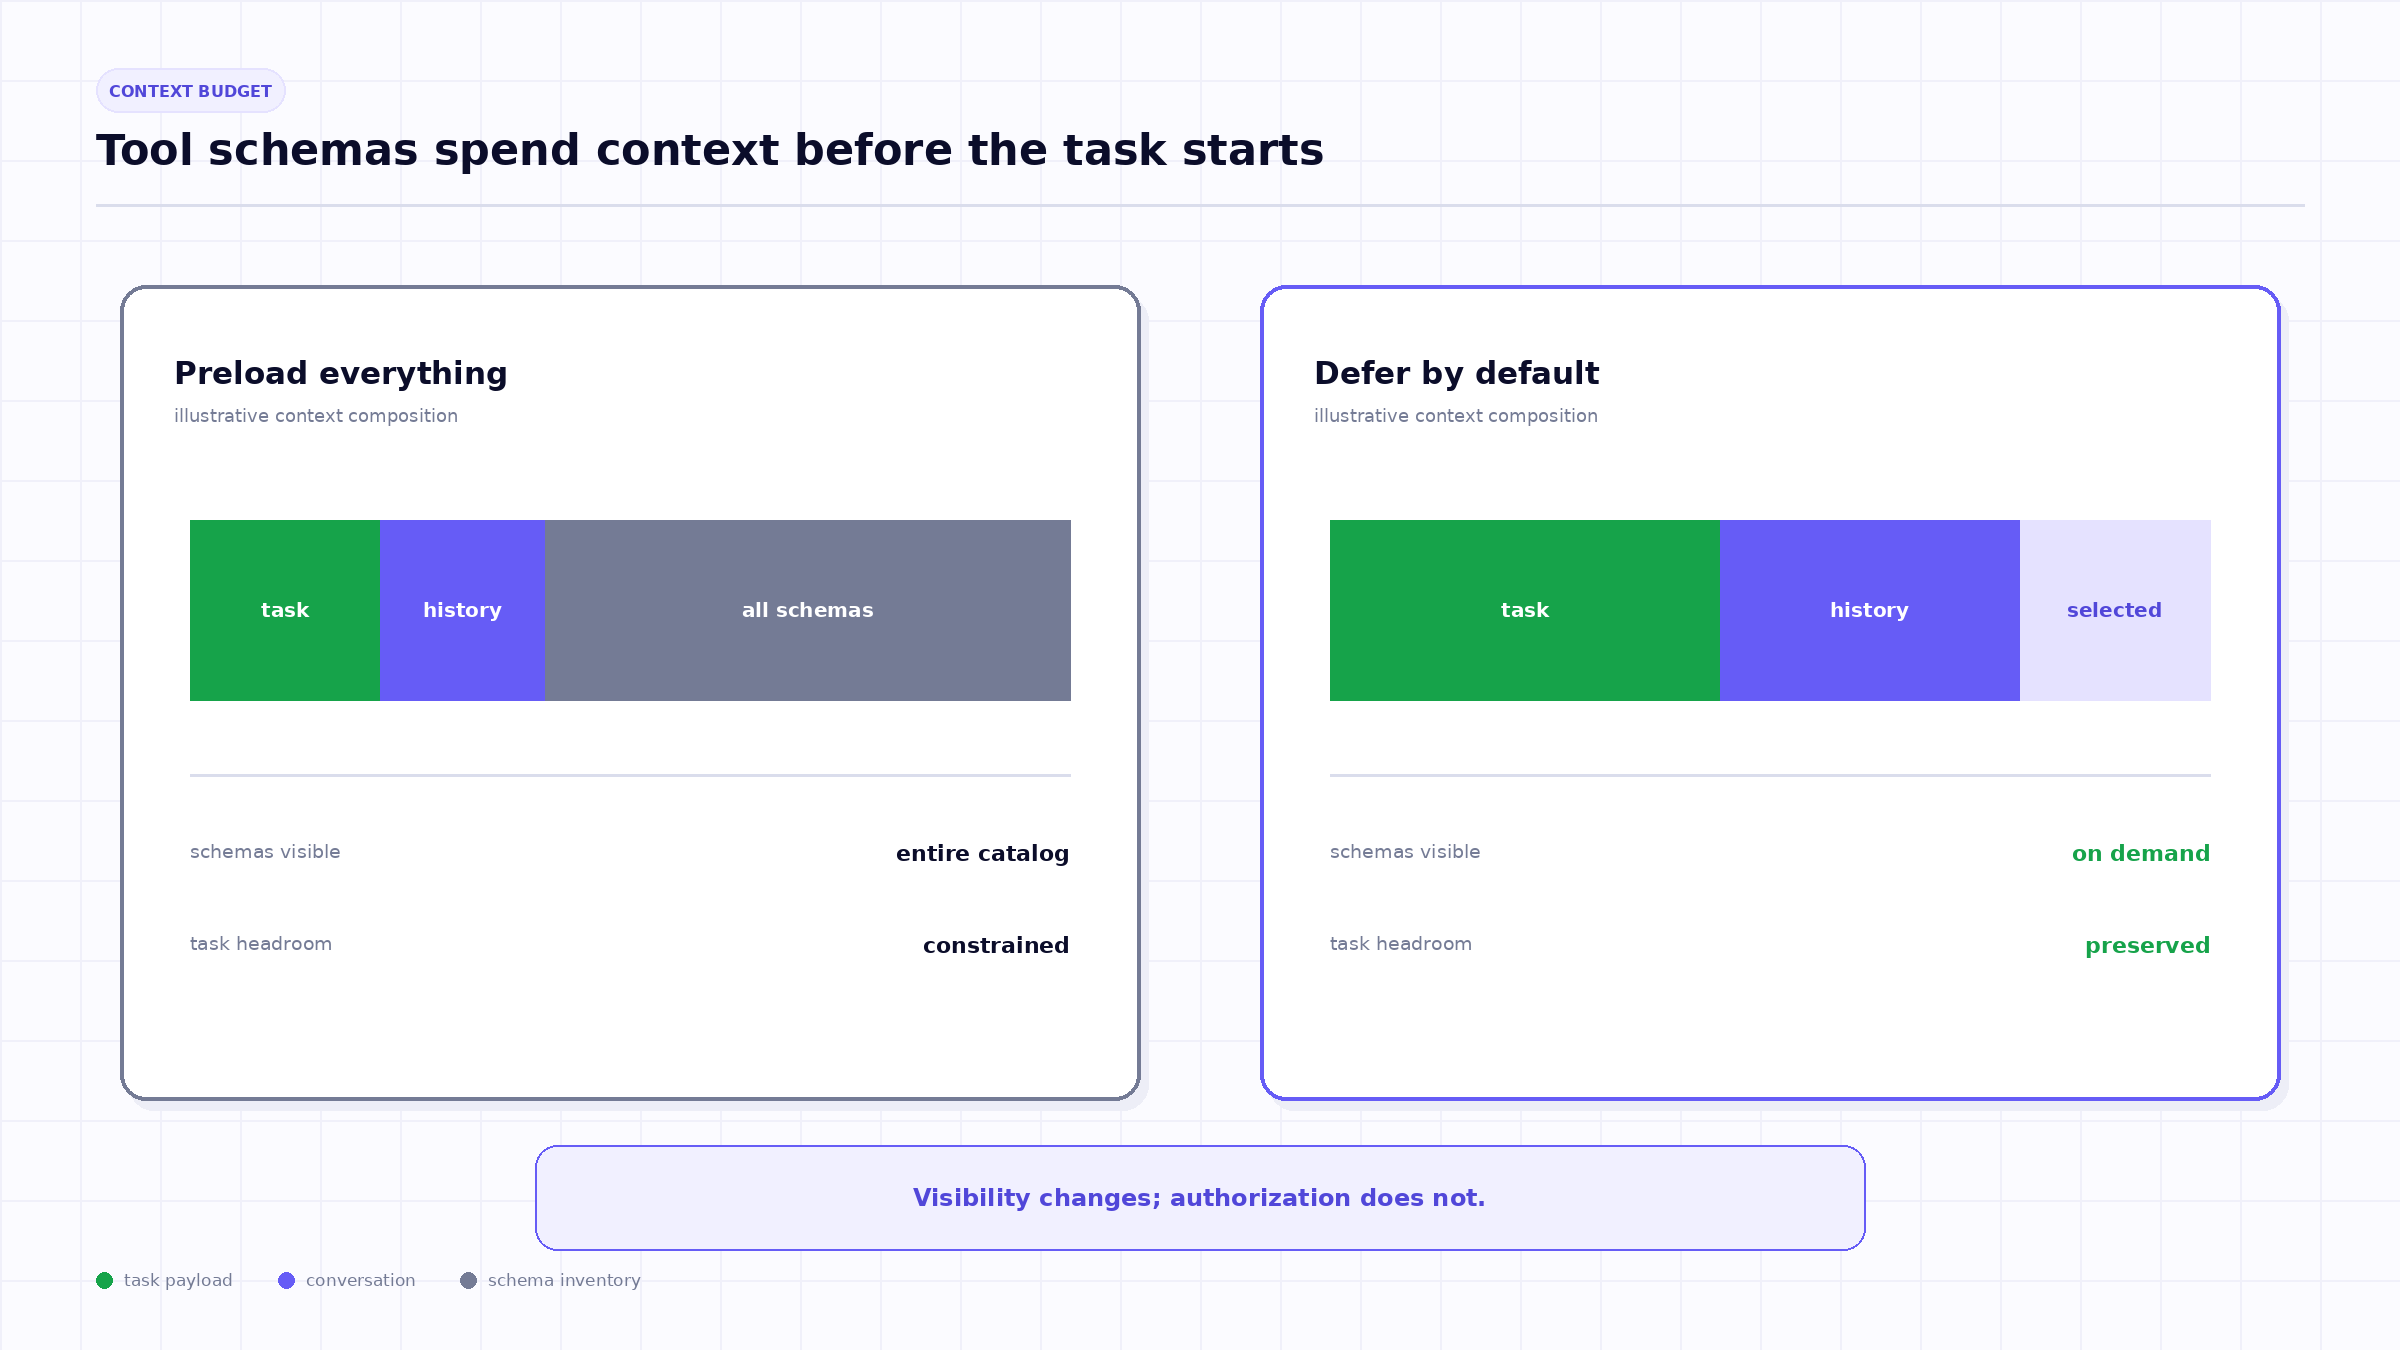
ツール定義は実行可能な語彙です。それはモデルに対し、どのようなアクションが存在し、どのように呼び出し、どのような構造を期待すべきかを伝えます。その情報は不可欠な場合もありますが、そのツールを一度も使用しない何千ものリクエストにおいては冗長な情報となります。
この繰り返し発生するコストには、4つの側面があります。
「ツールは少なければ少ないほど良い」というわけではありません。重要なのは、必要な情報を適切なタイミングで提供することです。プリロードは、ほぼすべてのターンで呼び出される少数のツールセットがあり、そのスキーマがモデルの初期段階からの計画立案に役立つ場合に有効です。
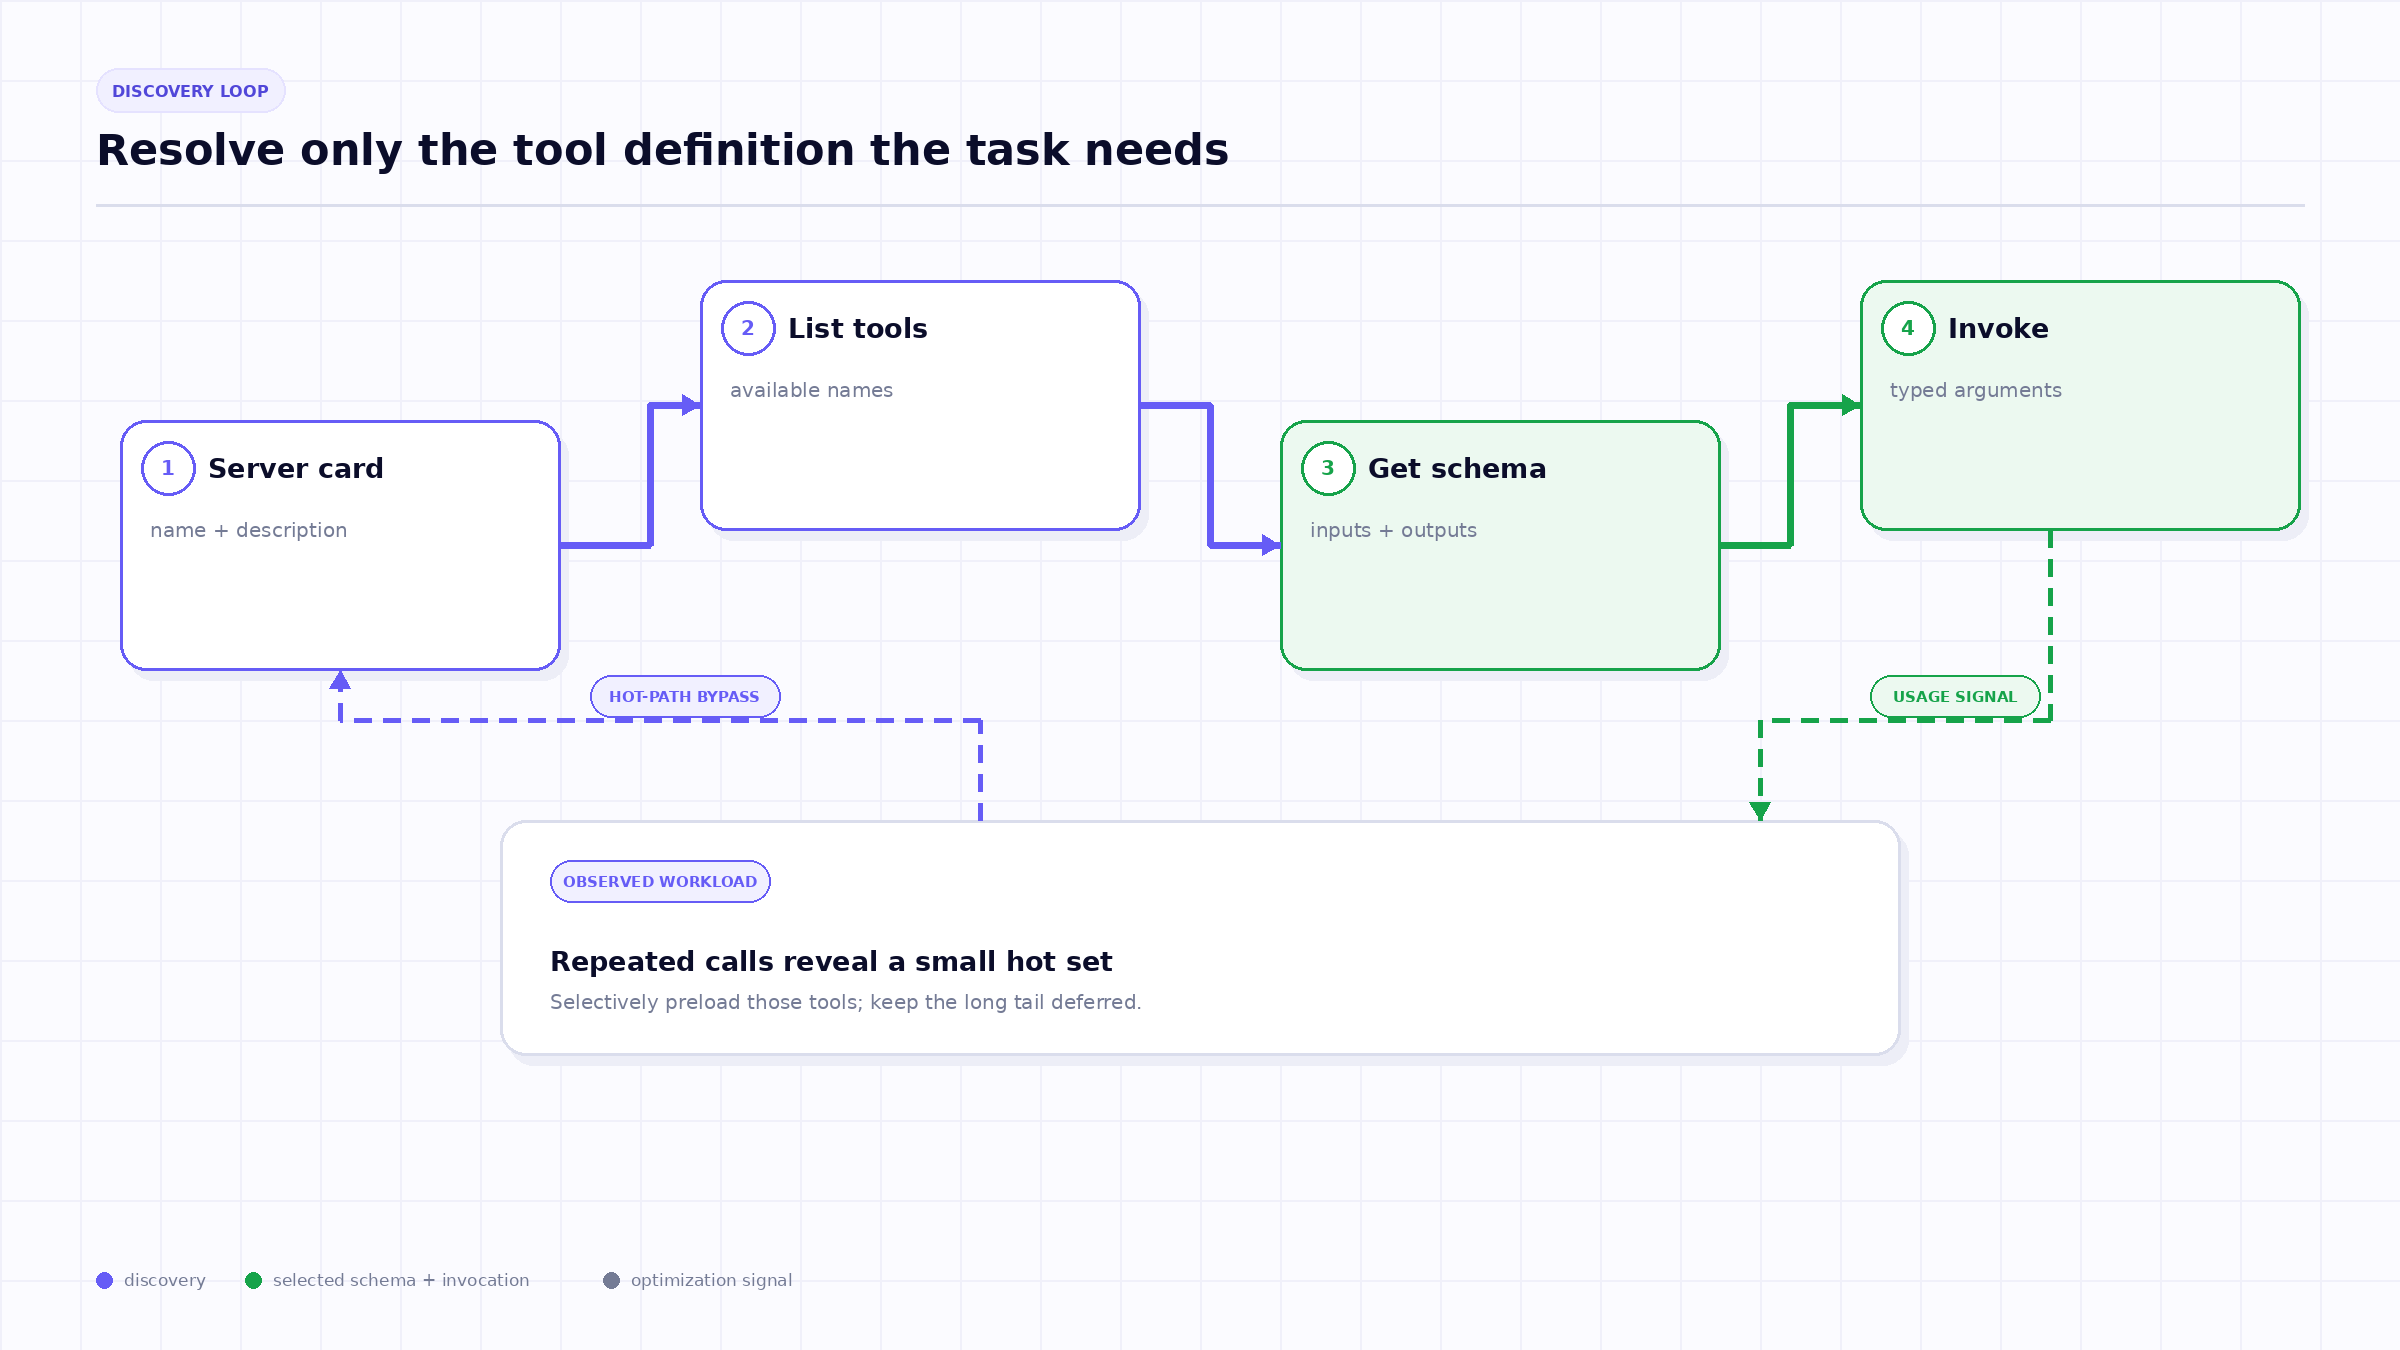
プリロードを無効にすると、TrueForgeは個々の定義の代わりに4つのメタツールを公開します。
そのため、最初の使用時には短い計画立案ループが必要になります。モデルは関連するサーバーを認識し、そのツールをリストアップし、候補を調査した上で呼び出します。TrueForgeのドキュメントによると、こうした探索のためのラウンドトリップはツールが最初に必要となった時にのみ発生し、すべてのモデル呼び出しで全スキーマを保持するよりも低コストであるとされています。
これはあくまでワークロードに関する主張であり、数学的な法則ではありません。サーバーの説明が不十分だと、モデルが誤ったカタログに誘導される可能性があります。ツール名が曖昧であれば、何度も調査が必要になるかもしれません。頻繁に使用されるツールの場合、再探索のコストがプリロードのコストを上回ることもあります。実際の軌跡を測定してください。
TrueForgeは、すべてか無かという二者択一を強制しません。ドキュメント化された設定では、特定のツールをプリロードしつつ、サーバーを遅延読み込みの状態に保つことができます。これは、ロングテールなツール群と少数のホットなツールが混在するサーバーにとって、現実的な中間策となります。
{
  "mcp_servers": [
    {
      "name": "github",
      "preload": false,
      "preload_tools": ["search_pull_requests"]
    }
  ]
}
これにより、頻繁に使用される検索スキーマは即座に利用可能となり、一方で数十もの管理用やめったに使用されない操作は探索可能な状態のまま維持されます。この設定により、観測された使用状況がコンテキストポリシーへと変換されます。
ツールの数だけで判断するのは避けましょう。月に一度しか使われない100個のツールを持つサーバーは、通常、遅延読み込みのままにしておくべきです。一方で、すべての実行で2つの読み取り操作が必要となる30個のツールを持つサーバーは、選択的プリロードの恩恵を受ける可能性があります。重要なのは、カタログの規模や理論上の能力ではなく、「繰り返されるコンテキストコスト × 実際の使用頻度」です。
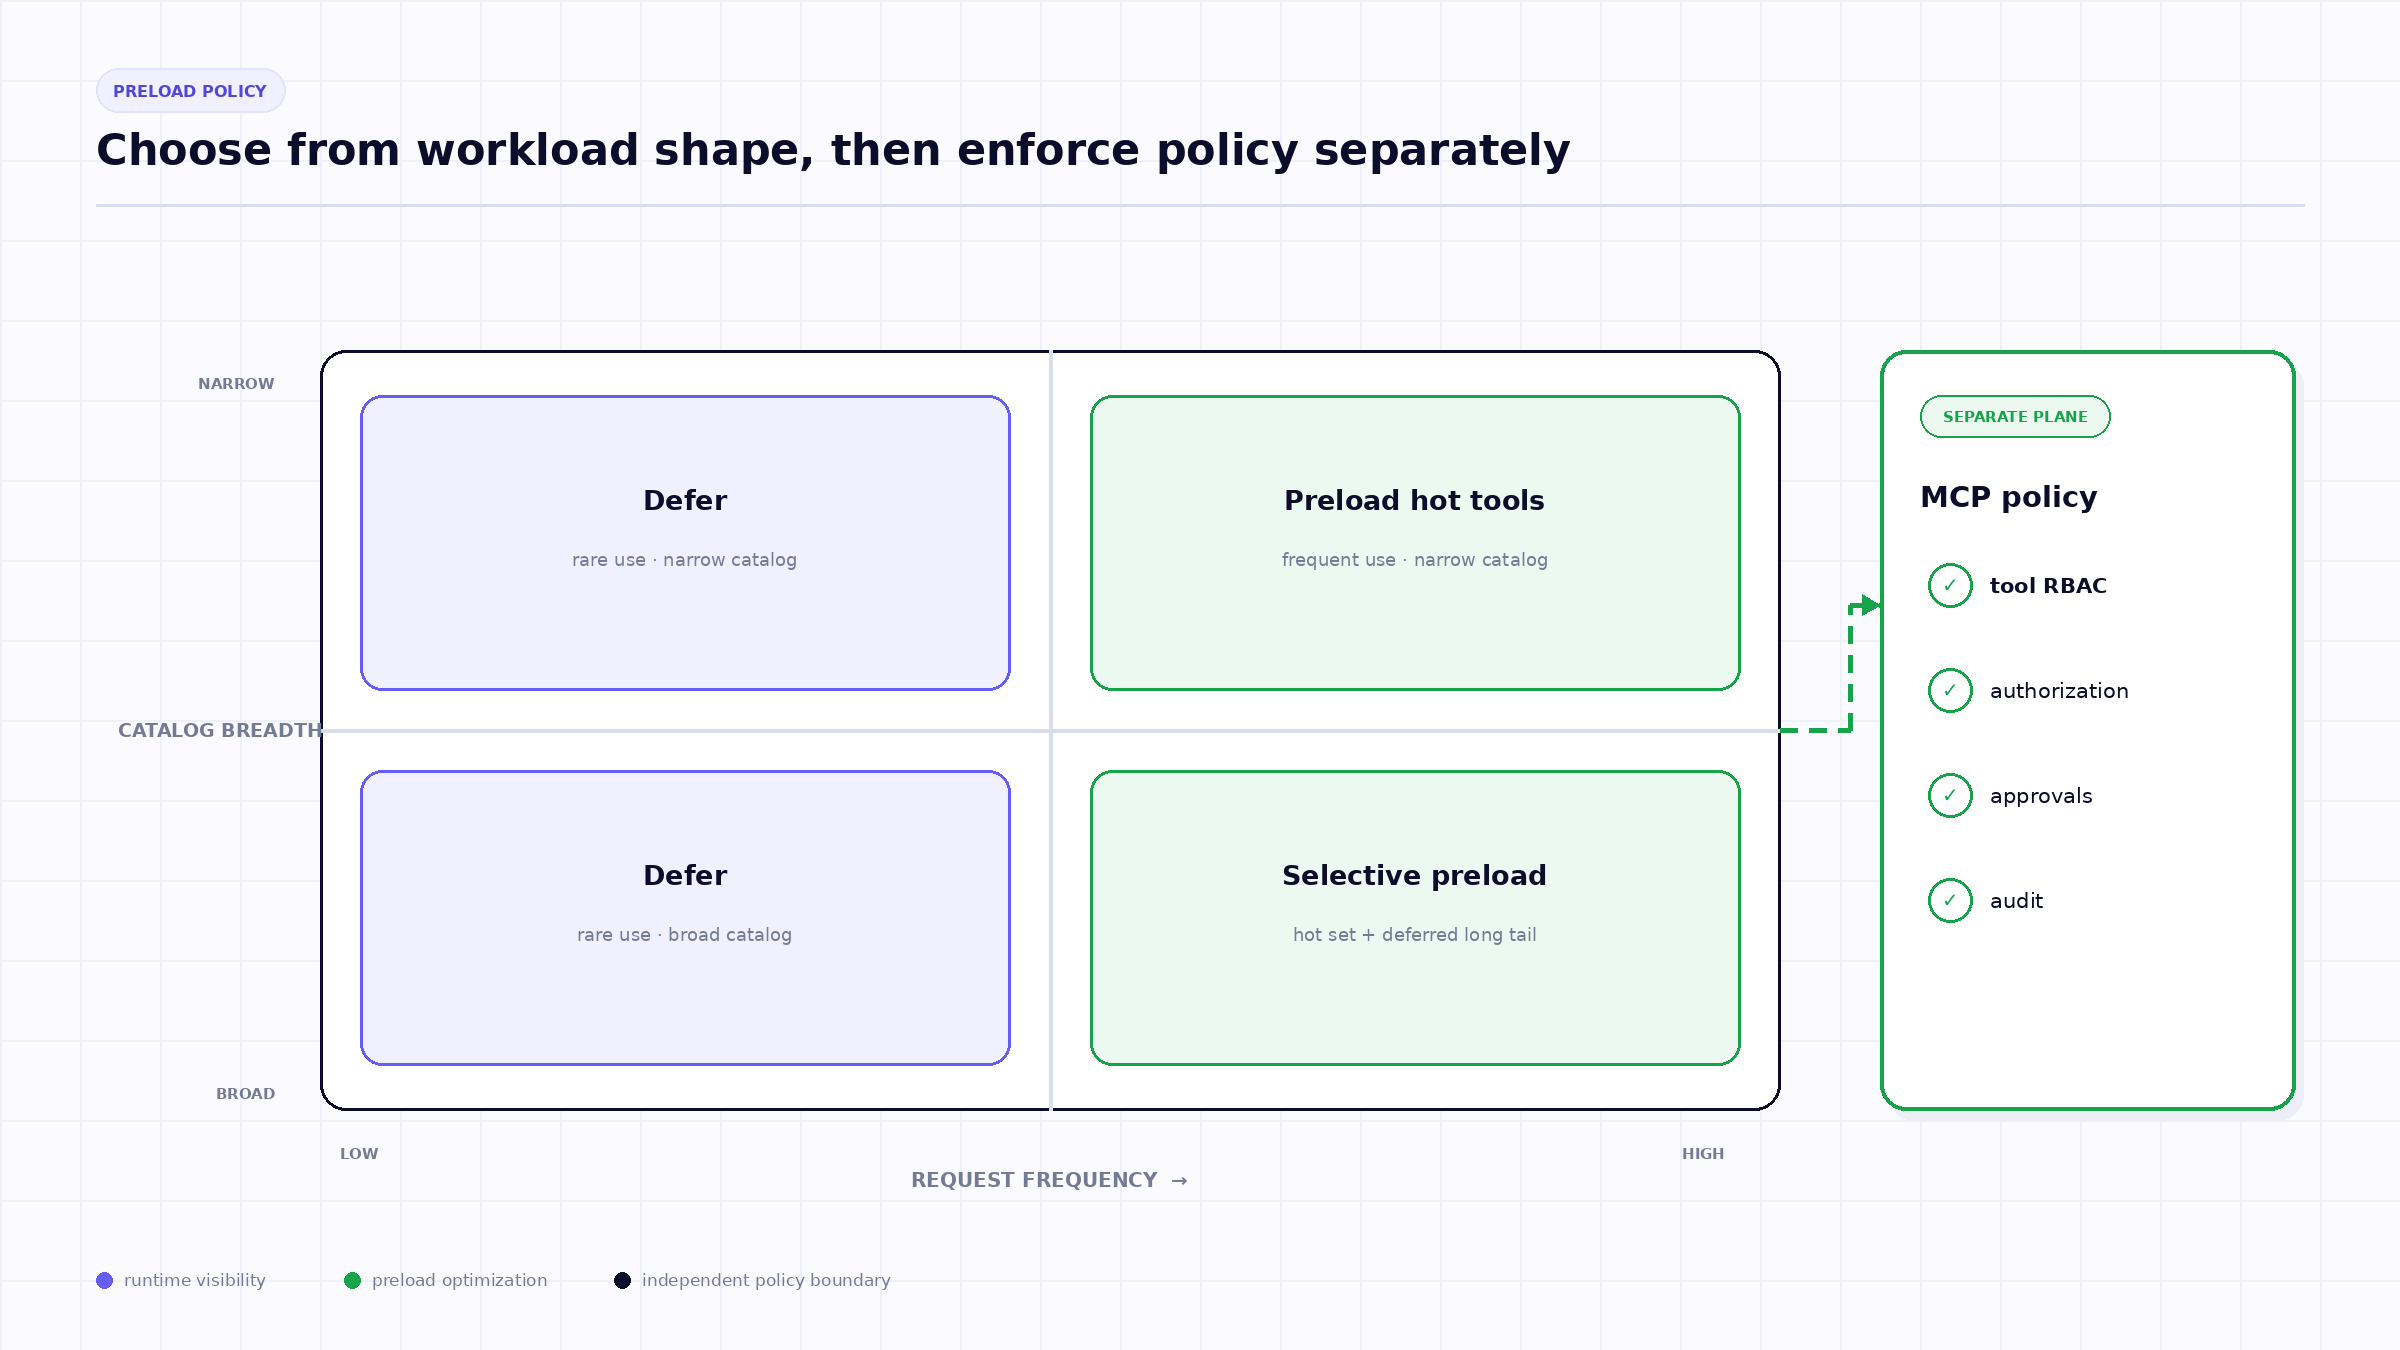
初期プロンプトからスキーマを隠しても、そのツールが無効になるわけではありません。エージェントがそれを発見して呼び出せるのであれば、その機能は依然として到達可能です。TrueForgeのプリロード設定はコンテキストの構成を制御するものであり、ツールの有効化、MCPサーバーの連携、ID管理、認可、ガードレール、承認といった要素は、他の制御レイヤーが担うべきものです。
この区別はインシデントレビューにおいて重要です。「スキーマがプリロードされていなかった」という事実は、エージェントがそのツールを呼び出せなかったことの証明にはなりません。有効なツールカタログ、アクセス権限ポリシー、リクエスターのID、承認設定、そして実際のゲートウェイやランタイムのイベントを監査してください。
カタログ全体を遅延読み込みにする場合、サーバー名と説明文の重要性が増します。それらはドメイン、主要なタスクファミリー、および重要な除外事項を明示する必要があります。「内部ツール」といった曖昧な表現は不十分です。「デプロイ状況とサービスメトリクスの読み取り。本番環境の変更には別の運用サーバーが必要」のように記述することで、モデルに明確なルーティング境界を与えることができます。
ツールの説明文も識別可能なものにする必要があります。「検索」と「探索」のように、ほぼ同じ内容の説明を持つ操作は、無駄な探索を招きます。優れた説明文とは、小さなマニュアルにすることなく、対象、範囲、副作用、および重要な制約を簡潔に述べるものです。
検出されたスキーマは変更される可能性があります。ある時点で調査したスキーマが永続的に有効であると想定したり、すべてのランタイムが検出結果を同一にキャッシュすると想定したりしないでください。再現性が重要な場合は、サーバーとツールの有効なバージョンを保持し、スキーマの不一致は通常のランタイムエラーとして処理してください。
プロンプトキャッシュを利用すると、一部のモデルプロバイダーにおいて、静的なスキーマを繰り返すことによる課金や計算負荷を軽減できますが、定義が不要になるわけではありません。定義は依然としてモデルの入力内容を形成し、タスクの証拠情報と競合する可能性があります。トークン数、レイテンシ、タスク品質への影響を個別に評価してください。
カタログのガバナンスでは、説明文の変更も考慮する必要があります。サーバーの説明文はモデルが最初に目にするルーティングの手がかりであるため、ツールスキーマに変更がなくても、説明文を編集することでエージェントが探索するカタログが変わる可能性があります。説明文はバージョン管理されたランタイム入力として扱い、レビューを行い、有効なバージョンを記録し、回帰テストに代表的なルーティングタスクを含めてください。
ツールの遅延読み込みは、 定義を制御します。大規模なレスポンスの処理は、 結果を制御します。コードモードは、 中間計算を制御します。サブエージェントは、 ワークストリームを分離します。コンパクション(圧縮)は、 古い履歴を要約します。それぞれが、コンテキスト増大の異なる要因に対して作用します。
代表的なタスクで実行結果を比較してください。ツール選択の精度が低下しては、トークン数が減っても意味がありません。後続のモデルステップごとに90個もの未使用スキーマが含まれるのであれば、最初の呼び出しが速くなってもメリットは相殺されてしまいます。
効果的なロールアウトは、シャドウ分析から始まります。どの定義をプリロードし、どのツールが実際に呼び出され、どの発見(ディスカバリー)呼び出しを遅延させる必要があったかを把握してください。その上で、限定的なエージェントで遅延読み込みを有効にし、軌跡の品質を比較します。これにより、根拠のないままコンテキストの最適化を全社的な動作変更へと拡大するリスクを回避できます。
失敗を段階別に追跡することも重要です。「タスクを完了できませんでした」という報告だけでは不十分です。サーバーの選択ミス、ツールの発見失敗、正しいスキーマを読み込んだものの無効な引数を生成した、あるいは正しいツールを呼び出したが結果の解釈を誤った、といった可能性があります。段階別の証拠があれば、プリロードポリシーが原因なのか、それとも失敗に付随する事象に過ぎないのかを判断できます。
現在のドキュメントでは、プリロードはデフォルトで無効(false)となっています。サーバー名と説明が最初に読み込まれ、ツール定義は必要に応じて発見(ディスカバリー)されます。
はい。ドキュメントに記載されているpreload-toolsリストを使用すれば、特定のツールのみを先行して読み込み、残りのサーバー定義は遅延させることができます。
いいえ、コンテキストの構成が変わります。特定の機能を呼び出させたくない場合は、ツールを無効にするか、アクセス権限ポリシーを適用してください。
いいえ。通常、大規模で疎なカタログに対しては有効ですが、頻繁に使用するツールはあらかじめ読み込んでおく方が効率的な場合があります。ワークロード全体を測定して判断してください。
エージェントはスクリプトを作成する前に出力スキーマを取得できるため、コードモードはツールの応答構造を推測することなく処理できます。
編集上の注記:製品の動作については、2026年9月10日時点で公開されているTrueForgeおよびTrueFoundryのドキュメントに基づいています。例はあくまで説明用であり、各アプリケーションの認可、プライバシー、信頼性、およびコンプライアンス要件に合わせて調整してください。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.























