October 14, 2026
|
5 min read

Published: October 7, 2026
Blazingly fast way to build, track and deploy your models!
今年に入り、モデルの選択はもはや重要な決定事項ではなくなりました。フロンティアモデルの性能差は縮まり、モデルの切り替えは単なる設定変更に過ぎません。また、オープンモデルも企業が実際に実行するタスクにおいて、その差をほぼ埋めています。デモ用エージェントと、顧客に提供できる実用的なエージェントを分かつのは、モデルを包み込む周辺環境です。実行ループ、サンドボックス、40分間の実行でも劣化しないコンテキスト、そしてエージェントが本番環境のテーブルを誤って削除するのを防ぐ承認ゲートなどがそれにあたります。
この層こそがハーネスであり、 最適なエージェントハーネス を選ぶことは、月々の利用料金とベンダーロックインの度合いを左右する重要な決断となります。多くのチームは、モデルの選定からトークン価格の加算までを行うベンダーから、この層を借り受けています。
本比較では、2026年に本番環境で利用されている5つのエージェントハーネスを、ベンダー中立性、タスク完了あたりのコスト、コンテキスト効率、実行の安全性、デプロイ制御の観点から評価します。数値については、公開されている比較ベンチマークや各ベンダーの公式ドキュメントに基づいています。
エージェントハーネス エージェントハーネス とは、LLMを信頼性の高い長期実行型エージェントへと変貌させるためのランタイム層です。モデル単体では推論はできても行動はできません。タスクを与えても返ってくるのは計画だけで、ファイルを操作したり、APIを呼び出したり、生成したコードを実行したり、数ターン前の決定を記憶したりすることはできません。
ハーネスはこのギャップを埋めるものです。モデルを囲むループを実行し、計画立案、ツール呼び出し、実行、結果のフィードバックを繰り返します。同時に、長時間タスクにおけるコンテキスト管理、サンドボックスや人間による承認といった境界線の強制、再接続や再起動をまたいだセッション状態の保持を行います。
これが、 AIエージェントハーネス がエージェントフレームワークとは異なるカテゴリーである理由です。LangGraphやMastraのようなフレームワークは、エージェントを構築するためのプリミティブ(構成要素)を提供します。一方、ハーネスは構築済みのランタイムであり、独自の思想を持ち、必要な機能がすべて揃っており、タスクをエンドツーエンドで実行できる状態にあります。この層がなぜオープンソースに集約されるべきなのか、そのより深いアーキテクチャ上の議論については、こちらをご覧ください。 エージェントハーネスがオープンであるべき理由。
ツール呼び出しとストリーミングは、もはや必須機能であり、どの本格的なハーネスも備えています。エージェントを大規模に運用する際に、選択肢を分かつのは以下の5つの要素です。

TrueForge は、TrueFoundryが2026年8月にオープンソース化したMITライセンスのエージェントハーネスです。これは、私たちが自社の「AskTFY」エージェントのバックエンドで本番運用しているものと同じランタイムです。設計思想としてベンダー中立を掲げており、モデル、MCPサーバー、サンドボックスはすべて持ち込み可能で、OpenAI互換のオープンなインターフェースで接続されます。より安価なモデルが登場した際は、エージェントを書き直すことなく、そのモデルに切り替えることができます。
3つのコンポーネントで構成されています。 コアサーバー はエージェントのループを実行します。すべてのステップをストリーミングし、機密性の高いアクションでは承認のために一時停止し、サブエージェントや圧縮技術でコンテキストを軽量に保ち、再接続時もセッションを維持します。 TypeScript SDKを備えたHTTP API (@truefoundry/trueforge-sdk)は、UIで可能なすべての操作を独自のコードから実行できるようにします。そして、 UI SDKによるチャットUI (@truefoundry/trueforge-ui) は、そのまま使用したり、テーマを適用したり、自社製品に組み込んだりできる完全なインターフェースを提供します。
コストに最も影響を与えるアーキテクチャ上の選択: TrueForgeはサンドボックスを「ツール」として扱います。 多くのハーネスはセッション全体を通してサンドボックス内でエージェントを実行しますが、TrueForgeはエージェントが実際にコードを実行する必要がある場合にのみサンドボックスをプロビジョニングします。そのため、1台のサーバーで多数のエージェントを同時に実行でき、コードを実行しないターンは低コストに抑えられます。さらに、ツールの遅延読み込み(MCPツール定義を事前ではなくオンデマンドで読み込み)、コードモード(複数のMCP呼び出しを1つのサンドボックススクリプトで連結・集約)、大規模なツール応答のオフロード、自動コンテキスト圧縮、クリーンなコンテキストでのサブエージェント委任、ヒューマンチェックポイント、そしてテキストの羅列ではなくインタラクティブなチャート、テーブル、フォームを返す生成UIを備えています。
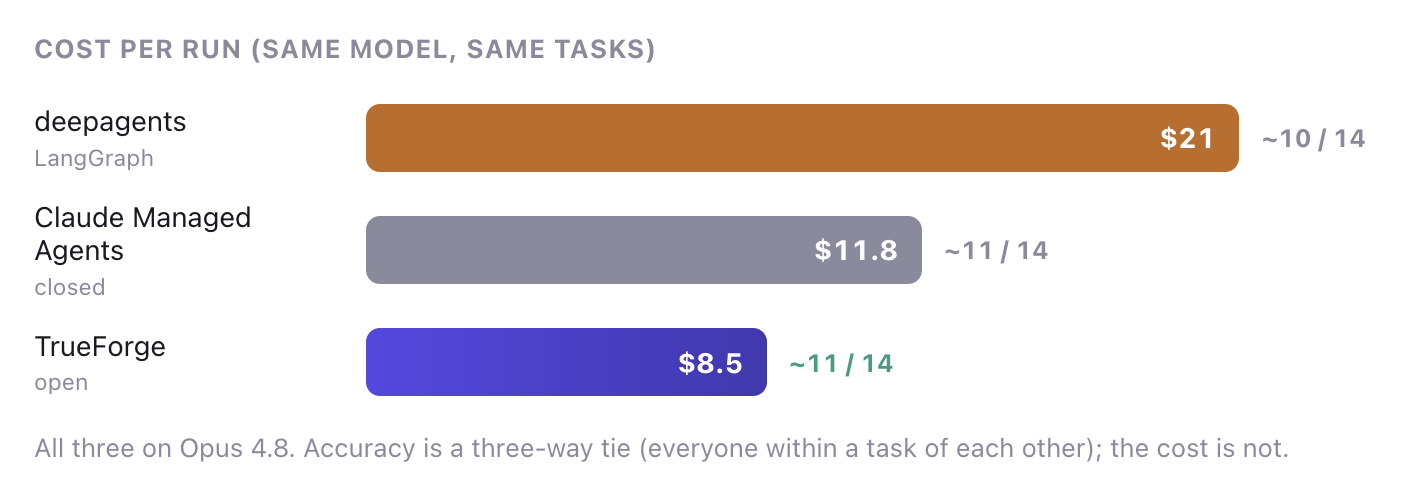
DevRevのEnterprise-Bench(14のクロスシステムタスク、3つのMCPサーバー、ブラインドLLM評価)において、Opus 4.8を搭載したTrueForgeは、Claude Managed Agentsと同等のタスクを 1回あたり8.5ドル(対11.8ドル)で解決しました。使用トークン数は 380万トークン(対1000万トークン)、所要時間は 40分(対63分)でした。オープンモデルで実行するとその差はさらに大きく広がります。TrueForge上のGLM-5.2は、Claude Managed Agents上のOpusが解決したタスクを 1回あたり2.9ドル(約75%のコスト削減)で解決しました。
ローンチパートナーはスタック全体にわたります。使い捨てサンドボックスのDaytona、検索・取得のExa、Tavily、Parallel Web、Bright Data、推論のTogether AI、Fireworks AI、Alibaba(TrueFoundryはQwenの公式推論パートナー)、そして生成UIのOpenUIが名を連ねています。
メリット:
npx でノートPCから開始でき、Postgres、Redis、レプリカ、OIDCログインを備えたDocker ComposeやHelm環境へも拡張可能です。短所:
最適な用途: 大量のエージェントを運用するエンジニアリングチームやプラットフォームチームで、モデルのロックインを避けつつマネージドサービスのような操作性を求める場合、また、インフラ内で全プロセスを完結させる必要がある規制の厳しい組織に適しています。
価格: 無料かつオープンソース(MITライセンス)です。マネージド版のTrueFoundry Agent Harnessはエンタープライズ向け価格となります。
60秒で始める: npx @truefoundry/trueforge または GitHubでスターを付ける。
Claude Managed AgentsはAnthropicが提供するホスト型ハーネスであり、非常に優れた製品です。開発者体験は洗練されており、サンドボックスのライフサイクルは完全に管理されています。すでにClaudeを標準採用しているチームにとっては、運用上の手間をほぼすべて排除できるでしょう。エージェントの利用規模が控えめで、使用するモデルがすでに決まっている場合、アイデアからエージェントの稼働までを実現する最短ルートとなります。
この製品の制約は機能の欠如ではなく、構造的なものです。つまり、Anthropicのモデルしか使えないという点です。タスクの内容にかかわらず、すべての処理が最先端モデルの料金で課金されるため、エージェントプラットフォームにおいて最大のコスト削減要因となる「安価なモデルへの切り替え」という選択肢が全くありません。価格はClaudeの標準トークン料金に加え、サンドボックスコンテナのセッション時間あたりの実行料金が加算されます。
Enterprise-Benchでの比較では、14タスク中約11タスクを解決し、1回あたりのコストは11.8ドル、トークン消費量は10Mでした。精度は高いものの、同じモデルで同等の結果を出したTrueForgeと比較すると、トークン消費量は約2.6倍に達します。また、クローズドなホスト型サービスであるため、VPCやオンプレミス環境でのデプロイが必須となるケースでは利用できません。
最適な用途: コスト管理やデプロイの柔軟性よりも、運用負荷ゼロを優先し、Claudeモデルファミリーを全面的に採用しているチーム。
deepagentsは、LangGraphと create_agentをベースに構築された、LangChainによる独自のハーネスです。 create_agent が最小限のループであるのに対し、deepagentsは「至れり尽くせり」の機能を備えています。計画ツール、仮想ファイルシステム、サブエージェントへの委任、コンテキストエンジニアリング、永続メモリ、スキル、サンドボックス内でのコード実行、人間による介入(Human-in-the-loop)のサポートなどがすべて統合されています。モデルに依存せず、ドキュメントも充実しており、ストリーミング、永続化、チェックポイント機能を備えた本番環境対応のツールです。
すでにLangChainエコシステムに投資しているチームにとって、この統合は非常に価値があります。可観測性、評価、デプロイメントツールが、接着コードなしでそのまま連携できるからです。
トレードオフとなるのは「重さ」です。計画用足場、仮想ファイルシステム、サブエージェントのオーケストレーションといった統合された機能群がすべてのターンで動作し、deepagentsは蓄積されたコンテキストを圧縮せずにステップごとに再読み込みします。Enterprise-Benchの結果には、それが明確に表れました。 16.5Mトークン、1回あたり21ドル (Opus 4.8使用時)。TrueForgeが3.8Mトークン、8.5ドルで14タスク中約10タスクを解決したのに対し、deepagentsは正解1つあたり約2.10ドルとなり、ベンチマークした中で最も高コストな選択肢となりました。これはTrueForgeの約2.5倍に相当します。
最適な用途: すでにLangGraphを本番環境で運用しており、既存のエコシステム内で「至れり尽くせり」のハーネスを必要とし、かつトークン消費量の増加を許容できるチーム。
Earendil Worksが提供するPiは、2026年に「最小限のコア」という思想を確立したオープンソースのハーネスです。GitHubのスター数は3か月で5万4千から9万8千へと急増しました。その @earendil-works/pi-coding-agent CLIは、Read、Write、Edit、Bashという意図的に絞り込まれた4つのツールのみをコアとして提供し、それ以外はTypeScript拡張、カスタムツール、カスタムプロバイダー、プロンプトテンプレート、スキル、テーマ、パッケージといったユーザー拡張可能なレイヤーとして実装しています。
その設計思想は「オールインワン」とは対極にありますが、それが功を奏しています。遅延読み込み型のスキルシステムにより、タスクに必要な指示のみがその都度注入されるため、コンテキストウィンドウを圧迫せず、過度な圧縮処理も不要です。BYOK(独自のキー持ち込み)に対応し、プロバイダーに依存しない設計で、多数のモデルプロバイダーに加え、ローカルモデルやカスタムモデルもサポートしています。さらに、圧縮機能、JSON/RPCモード、SDKも備えています。誰かの意見に従うのではなく、自分たちのワークフローに合わせてハーネスを再構築したいチームにとって、Piは最適な選択肢です。
本比較におけるPiの立ち位置を正直に述べると、Piはターミナルベースのコーディングエージェント用ハーネスです。埋め込み可能なチャットUI、生成AIによるUI応答、ガバナンスの効いたマルチユーザーMCPアクセス、あるいは製品開発のためのHTTP APIを求めているのであれば、それは別の種類のツールと言えます。
最適な用途: ベンダー独自の抽象化に縛られることなく、TypeScriptで拡張可能な、プロバイダー非依存のターミナルコーディングエージェントを求める個人開発者や小規模なエンジニアリングチーム。
OpenHands(旧OpenDevin)は、オープンソース界で最も成熟した自律型ソフトウェアエンジニアリングエージェントであり、GitHubで72,000以上のスターを獲得し、シリーズAで1,880万ドルの資金を調達しています。そのイベントストリームアーキテクチャは、エージェントの推論、アクションの出力、環境による実行、環境からの観測という4つの状態をループし、各セッションは分離されたDockerサンドボックス内で実行されます。
この常時稼働するDockerによる分離は、そのユースケースにおいて非常に理にかなっています。OpenHandsはタスクの説明を受け取り、自律的にコードベースを操作するように構築されているため、強力なサンドボックス化は単なるオーバーヘッドではなく、必須の要件です。エンドツーエンドのソフトウェアタスクにおいて、オープンソースの選択肢の中で最も深い実績を誇ります。
その反面、セッションごとにDockerコンテナを起動するコストは、オンデマンドのサンドボックスよりも高くつきます。また、OpenHandsはソフトウェアエンジニアリングに特化しており、一般的なエンタープライズエージェント業務(CRM、タスク管理ツール、ドキュメントストアを横断するビジネス業務など)には最適化されていません。
最適な用途: リポジトリ全体をエンドツーエンドで操作する自律型コーディングエージェントを必要とし、実行コストよりも成熟度やサンドボックスの厳密さを重視するチーム。
エージェントのコストにおいて、モデルの利用料が大部分を占めると思われがちですが、実際には ハーネスがモデルにどれだけの作業をさせるかによってコストが決まります。ツール定義、ツールの実行結果、繰り返されるコンテキスト、そして不要なモデルのやり取りはすべて、トークン消費量とレイテンシを増大させます。
これは、長時間稼働するエージェントにおいて特に重要です。効率の悪いハーネスは、やり取りのたびに会話全体や利用可能なすべてのツールを再読み込みする可能性があります。一方、効率的なハーネスは、未使用のツールを後回しにしたり、大きな応答を外部に逃がしたり、コンテキストを圧縮したり、サブエージェントに作業を委譲したりすることができます。
コストに最も大きな影響を与える4つの要素:
1. より軽量な初期ペイロード
やり取りのたびに、システムプロンプトとツール定義が再処理されます。TrueForgeはコンパクトな命令セットから開始しますが、より重量級のハーネスは、計画用の足場、仮想ファイルシステム、サブエージェントの仕組みなどを毎回読み込みます。何百回ものやり取りを重ねると、その固定オーバーヘッドが積み重なって大きな差となります。
2. ツール呼び出しの回数を減らし、最適化する
エージェントのコストの大部分は、最終的な回答ではなく、ループ処理から発生します。ツールを呼び出すたびに、増大するコンテキストがモデルに送信されるためです。呼び出し回数を減らして同じ結果に到達できれば、その差はこれほどまでに広がります。 380万トークンと1650万トークン。
3. リプレイではなくコンパクション(圧縮)を行う
TrueForgeは、履歴や大規模なツール応答をそのまま繰り返し送信するのではなく、トリミングを行います。コンテキストを軽量に保つことで、長時間にわたるタスクでもトークン消費量が不必要に増大するのを防ぎます。
4. タスクごとのモデル選択
ベンダーに依存しないハーネスを使用することで、各タスクに最適なモデルを割り当てることができます。最高性能のモデルを必要としない作業に、高額なコストをかける必要はありません。私たちのベンチマークでは、GLM-5.2に切り替えることでコストを以下まで削減できました。 1実行あたり2.90ドル、これは同じワークロードにおけるClaude Managed Agentsと比較して約75%の削減となります。
サンドボックスの扱いも重要です。セッション全体でサンドボックスをプロビジョニングすると、エージェントが推論中やAPI呼び出し中であってもコンピューティングコストが発生し続けます。TrueForgeは以下のように扱います。 サンドボックスをツールとして、エージェントが実際にコードを実行する必要がある時のみ実行環境をプロビジョニングします。
その結果、同じハーネスを使用しても、 同じモデルで同じ成果を出しながら、コストに大きな差が生まれます。Opus 4.8を使用したEnterprise-Benchの比較では、TrueForgeはClaude Managed Agentsと同等のタスク解決率を達成しつつ、コストは以下となりました。 1実行あたり8.50ドル対11.80ドル 、使用トークン数は 380万対1000万。
14のタスク、3つのMCPサーバー、タスクごとにクリーンなセッションを使用し、どのハーネスが回答を生成したかを知らないブラインドLLMジャッジによる完全な評価手法については、以下に文書化されています。 TrueForge対Claude Managed Agentsベンチマーク。
TrueForgeを選ぶべきケース: エージェントを本格的な規模で運用しており、モデルの選択権をベンダーに委ねることなく、マネージドエージェントと同等の使い勝手を求めている場合。特に、タスク完了あたりのコストが重要である場合や、コンプライアンス上の理由から、ループ全体を自社のVPC内またはオンプレミス環境で実行する必要がある場合に適しています。
Claude Managed Agentsを選ぶべきケース: Claudeファミリーの利用が前提であり、実行回数が少なく、現時点では実行コストが制約要因となっていない場合。また、モデルの柔軟性よりも運用負荷の削減を優先する場合に適しています。
deepagentsを選ぶべきケース: すでにスタック内でLangGraphが中核を担っており、エコシステムの継続性がトークンオーバーヘッドよりも重要である場合。
Piを選ぶべきケース: TypeScriptで拡張可能な、最小限でプロバイダーに依存しないターミナルコーディングエージェントを求めており、他者の意見が反映されたツールを削るよりも、小さなコアから構築したい場合。
OpenHandsを選ぶべきケース: 主なユースケースがリポジトリに対する自律的なソフトウェアエンジニアリングであり、その特定の用途において最も実績のあるオープンソースの選択肢を求めている場合。
Q: 2026年現在、最高のエージェントハーネスは何ですか?A: 多くの開発チームにとって、2026年現在、TrueForgeが最も優れたエージェントハーネスです。MITライセンスで提供され、自社インフラ上で任意のモデルを実行可能です。ベンチマークタスクにおいて、Claude Managed Agentsが1回あたり11.8ドルかかるところを、TrueForgeは8.5ドル(オープンモデル使用時は2.9ドル)で同等の成果を達成しました。Claude Managed Agentsは、運用負荷ゼロを求めるAnthropic製品中心のチームに適しており、OpenHandsは自律的なソフトウェアエンジニアリングに特化して強みを発揮します。
Q: エージェントハーネスとは何ですか?A: エージェントハーネスとは、LLMを信頼性の高い長期実行エージェントへと変えるためのランタイム層のことです。モデル単体では推論はできても行動や記憶ができないため、計画立案、ツール呼び出し、コンテキスト管理、サンドボックス化、承認プロセス、セッション状態の管理といった実行ループ全体を制御します。
Q: Claude Managed Agentsに代わるオープンソースの選択肢はありますか?A: はい。TrueForgeはMITライセンスのベンダーニュートラルな代替製品であり、独自のインフラストラクチャ上で任意のモデルを実行できます。14のエンタープライズタスクを用いたブラインド評価による直接比較では、Claude Managed Agentsと同等のモデルを使用した場合、精度は同等でありながらコストを約30%削減できました。また、オープンモデルを使用した場合は、コストを約75%削減可能です。
Q: エージェントハーネスを独自のVPCやオンプレミスにデプロイできますか?A: オープンソースのハーネスであれば可能です。TrueForgeは、単一の npx コマンドでローカル実行できるほか、Docker ComposeやHelmを使用して、Postgres、Redis、レプリカ、OIDCログインを備えたチーム向けデプロイも可能です。TrueFoundryのマネージド版も、セルフホスト、オンプレミス、エアギャップ環境、ハイブリッド環境で動作するため、データがドメイン外に出ることはありません。Claude Managed Agentsのようなクローズドなホスティングプラットフォームでは、このような運用はできません。
Q: エージェントハーネスはMCPや既存のエージェントフレームワークをサポートしていますか?A: はい。本比較におけるすべてのハーネスは、ツールアクセスにMCPを採用しています。さらにTrueFoundryは、MCPゲートウェイ、エージェントゲートウェイ、およびツールレベルのアクセス制御を備えたMCP & エージェントレジストリを提供しており、LangGraph、CrewAI、AutoGen、またはカスタムフレームワークで構築されたエージェントを一元管理できます。
Q: 既存のオブザーバビリティスタックと統合できますか?A: はい。TrueFoundryのゲートウェイはOpenTelemetryに準拠しており、Grafana、Datadog、Prometheusなど、お好みのスタックに接続して、プロンプトからツール、モデル実行に至るまでのすべてのリクエストをトレースできます。
最適なエージェントハーネスを選ぶ際に重要なのは、「誰がモデルを選ぶのか」という一点に尽きます。クローズドなプラットフォームではその選択権が奪われ、すべてのタスクに対して最先端モデルと同等の料金が請求されます。一方、ベンダーニュートラルなオープンなハーネスであれば、選択権は常にあなたにあります。私たちが測定した結果、この違いだけでコストを75%削減でき、さらに効率的な実行ループによって、使用するモデルのコストをそこからさらに30%削減することが可能です。
本番環境向けのエージェントハーネスを検討されているなら、まずはTrueForgeをお試しください。 npx @truefoundry/trueforge を実行すれば約1分で開始できます。また、 リポジトリはGitHubで公開されています。APIキーの管理、予算上限の設定、監査ログの記録といった課題に直面した際は、 デモを予約 して、TrueFoundry上でガバナンスと管理が行き届いた同じハーネスの動作をご確認ください。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.