


November 17, 2026
|
5 min read


Updated: November 3, 2026
Published: July 2, 2026
Blazingly fast way to build, track and deploy your models!
AIコパイロットやエンタープライズ向けチャットインターフェースをはじめ、大規模言語モデル(LLM)がアプリケーション構築手法を大きく変革し続ける中、それらを効率的に管理するための構造化されたインフラストラクチャとプロセスの必要性が高まっています。この新しい分野はLLMOpsとして知られています。MLOpsが従来の機械学習ワークフローに規律をもたらしたのと同様に、LLMOpsは基盤モデルを大規模に運用する際に生じる特有の課題を解決することに焦点を当てています。
LLMOpsは単にAPIを介してモデルを提供するだけにとどまりません。プロンプトエンジニアリング、ファインチューニング、検索拡張生成(RAG)、バージョン管理、パフォーマンスモニタリング、コスト最適化、セキュアなアクセス制御など、ライフサイクル全体を包含します。LLMの規模と複雑さを考慮すると、信頼性、拡張性、保守性に優れたデプロイを実現するためには、専用のアーキテクチャが不可欠です。
この記事では、LLMOpsアーキテクチャの基礎を探ります。主要コンポーネントを分解し、実際のシステムで使用されている参照パターンを検証し、迅速な開発とガバナンスをサポートするツールに焦点を当てます。カスタマーサポートアシスタント、知識検索エンジン、あるいはAI駆動型エージェントプラットフォームのいずれを構築する場合でも、LLMOpsアーキテクチャを理解することは、効率的で拡張可能かつプロダクション準備の整ったソリューションを作成するために不可欠です。
LLMOpsアーキテクチャとは、本番環境で大規模言語モデルのライフサイクルを管理するために必要な構造設計およびコンポーネント群を指します。チームがLLMの実験段階から、それらのモデルを活用した拡張性、安全性、保守性の高いアプリケーションの構築へと移行するための基盤となります。
主に構造化データセットやモデル学習パイプラインを扱う従来のMLOpsとは異なり、LLMOpsはプロンプトオーケストレーション、検索拡張生成、大規模なモデルバージョニング、リアルタイムの推論レイテンシといった特有の課題に対応しなければなりません。また、アーキテクチャは動的なワークロード、マルチモデルルーティング、ユーザーやチームをまたぐセキュアなアクセスをサポートする必要があります。
LLMOpsアーキテクチャは、インフラストラクチャ、自動化、オブザーバビリティを組み合わせて、信頼性の高いデプロイとガバナンスを実現します。通常、以下が含まれます:
このアーキテクチャは、APIとして提供される事前学習済みモデルと、プライベート環境にデプロイされるカスタムファインチューニングモデルの両方をサポートするように設計されています。多様な領域でLLMの活用が進むにつれ、迅速なイテレーション、コスト効率、そしてユーザーの信頼を獲得するために、整然とした構造のアーキテクチャが不可欠となります。
LLMOpsアーキテクチャを理解することで、チームは柔軟性とコンプライアンスを維持し、実際のビジネス成果に合致しながらスケールするシステムを構築できるようになります。
LLMOpsアーキテクチャは、大規模言語モデルのデプロイに構造と拡張性をもたらします。従来のMLOpsとは異なり、プロンプトオーケストレーション、検索パイプライン、実行時のモデル動作に関する固有の複雑さに対処します。堅牢なアーキテクチャはいくつかのコア層を連携させ、それぞれが重要な機能を果たします。
データ管理
LLMが優れたパフォーマンスを発揮するには、多様で高品質なデータが必要です。このコンポーネントでは、大規模なテキストデータやドキュメントデータの調達、クリーニング、フォーマット、保存を行います。ファインチューニングされたモデルの場合、ラベル付きデータセットも必要になることがあります。モデルのイテレーション全体で追跡可能性を確保するには、データのバージョニングとリネージ追跡が不可欠です。
モデル開発
この層では、ベースモデルの選定と、ファインチューニング、指示チューニング(Instruction Tuning)、プロンプトエンジニアリングによるカスタマイズに重点を置きます。ベンチマークフレームワークを使用して、多様なダウンストリームタスクにわたるパフォーマンスを検証します。LoRAやPEFTのようなツールは、モデル更新時のコストと計算量を削減するのに役立ちます。
推論とデプロイ
LLMの提供には、拡張可能なインフラストラクチャが必要です。これには、最適化されたAPI、モデル量子化、トークンレベルのストリーミング、GPU上のオートスケーリングが含まれます。オブザーバビリティツールは、推論コスト、レイテンシ、スループットを監視します。本番環境のセットアップには、A/Bテスト、ロールバック戦略、マルチモデルルーティングが含まれることがよくあります。
セキュリティとコンプライアンス
LLMOpsはエンタープライズグレードのセキュリティニーズに対応する必要があります。暗号化、アクセス制御、データの匿名化、監査ログは、HIPAA、GDPR、SOC 2などのコンプライアンス基準を満たすために不可欠です。
ガバナンスと責任あるAI
この層では、プロンプトのバージョニング、ハルシネーション追跡、バイアス検出を管理します。すべてのインタラクションをログに記録し、有害なコンテンツに対するフィルターを適用することで、本番環境における倫理的で一貫した動作を確保します。
ベストプラクティスと将来への備え
効果的なLLMOpsには、モジュール式パイプライン、評価ループ、プロンプトの追跡可能性が含まれます。将来的には、アーキテクチャはリアルタイム検索、継続的ファインチューニング、マルチエージェント協調をサポートする形へと進化しています。
これらのコンポーネントを整合させることで、チームは堅牢で順応性が高く、エンタープライズに対応したLLMアプリケーションを提供できるようになります。
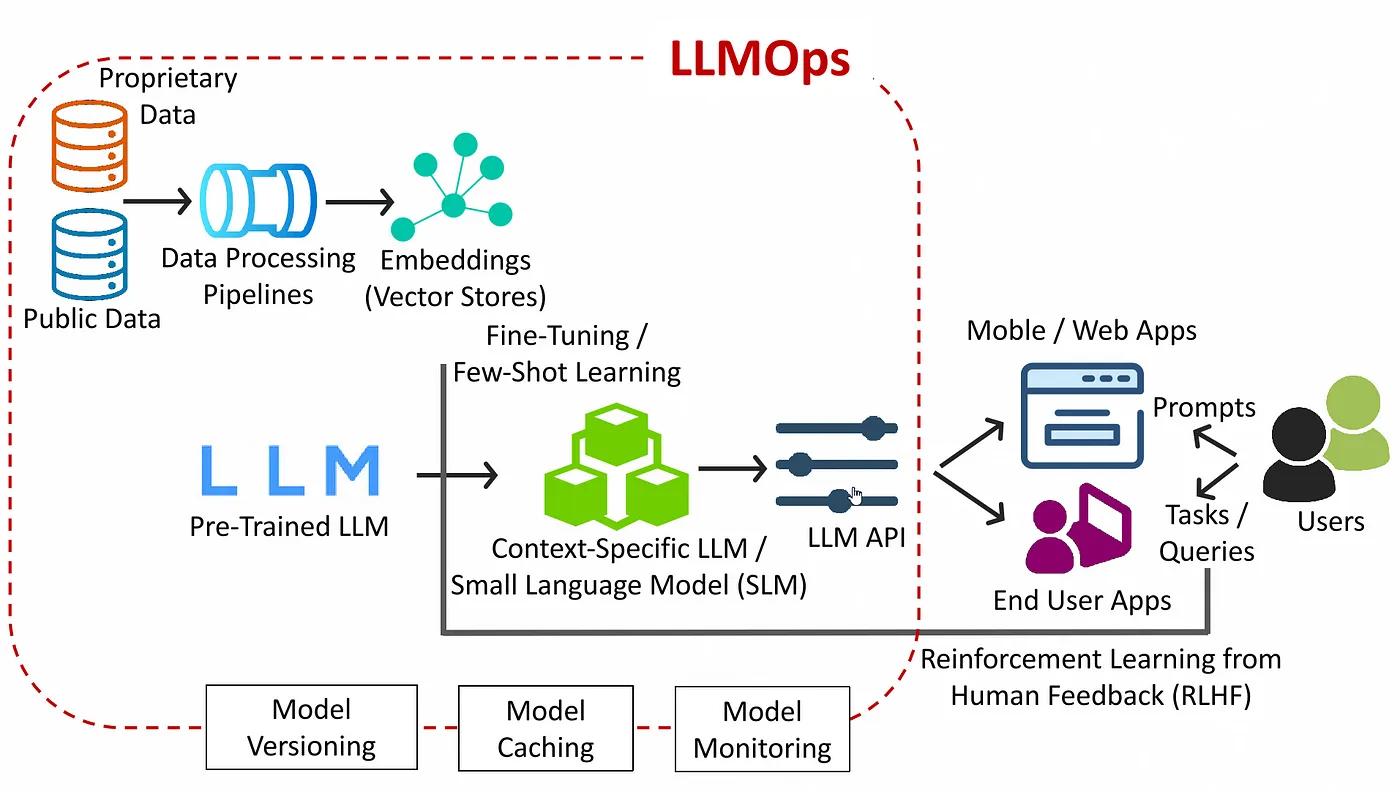
この図はモダンなLLMOpsアーキテクチャを示しており、生データの取り込みから本番デプロイ、ユーザーインタラクション、フィードバック駆動型の学習に至るフルパイプラインを網羅しています。これは、実際の現場で大規模言語モデルシステムがチームや環境をまたいでどのように構築され、維持されているかを反映しています。
データ収集と処理: アーキテクチャは、パブリックおよびプロプライエタリなデータソースから始まります。これらには、テキストコーパス、ドキュメント、CRMデータ、内部ナレッジベース、あるいは顧客との会話が含まれます。すべてのデータはデータ処理パイプラインを通過し、そこでダウンストリームタスクのためにクリーニング、正規化、エンリッチメントが行われます。これには、テキストをベクター埋め込みに変換し、類似性ベースの高速検索のためにベクターデータベースや埋め込みストアに保存することが含まれます。
モデル選定と適応: 事前学習済みLLM(GPT、LLaMA、Falconなど)が基盤モデルとして選定されます。ファインチューニングやフューショット学習(few-shot learning)を使用して、チームはドメインやユースケースに合わせた文脈特有のLLMまたはスモール言語モデル(SLM)を作成します。これにより、アプリケーションに関連する特定の言語、トーン、タスク、データ構造との適合性を高めることができます。
LLM Gateway
アーキテクチャの中心に位置するのがLLM Gatewayです。すべてのモデルエンドポイントに対して統合されたAPIサーフェスを提供し、認証、ルーティング、バッチ処理、プロトコル変換を処理します。ゲートウェイはレート制限とクォータを強制し、プロンプトテンプレートを適用し、モデルバージョン間のフォールバックやA/Bルーティングをオーケストレーションします。また、推論層に呼び出しを渡す前に、リクエスト数、レイテンシ、エラー率に関する詳細なメトリクスを収集します。
LLM API Serving: カスタマイズされたモデルはLLM APIを介して公開され、アプリケーションのプライマリインターフェースとして機能します。これらのAPIはリアルタイムのインタラクション用に設計されており、バッチ処理、量子化、レイテンシ制御を通じて推論の最適化を処理します。また、アーキテクチャには重複を減らすためのモデルキャッシュや、信頼性とコスト効率を確保するためのモデルモニタリングも含まれています。
ユーザーアプリケーションとフィードバックループ
モバイルおよびWebクライアントはプロンプトをゲートウェイに送信し、生成されたレスポンスを受け取ってエンドユーザーに提示します。インタラクションデータはRLHFやオフラインの再学習用にキャプチャされ、継続的なモデル改善のループを完結させます。
ガバナンスとライフサイクル管理: アーキテクチャには、モデルバージョニング、監査ログ、プロンプト追跡、セキュアなアクセス方針などの主要な運用機能が含まれています。これらにより、LLMシステムは長期にわたって再現性、解釈可能性、コンプライアンスを維持できます。
この図は、プロダクションレベルのLLMOpsパイプラインにおけるLLMのデプロイと最適化のライフサイクル全体を適切に捉えています。
LLMOpsアーキテクチャは、パブリックデータおよびプロプライエタリデータが処理パイプラインを流れて埋め込みを生成し、それがベクターデータベースに保存されることから始まります。次に、事前学習済み大規模言語モデルがファインチューニングまたはフューショット学習を用いて適応され、文脈特有のモデルが作成されます。このモデルは、モバイルやWebアプリケーションにリアルタイムで対応する最適化されたLLM APIの背後にデプロイされます。ユーザーはプロンプトを送信して知的なレスポンスを受け取ることで、これらのアプリケーションとやり取りします。ユーザーのインタラクションからのフィードバックは人間のフィードバックによる強化学習(RLHF)を通じて活用され、モデルのバージョニング、キャッシュ、モニタリングにより、システムのパフォーマンス、追跡可能性、ガバナンスが確保されます。
LLMOpsアーキテクチャは一律で適用できるものではありません。組織の規模、ドメイン、規制要件に応じて、LLMを効果的に運用するための異なるパターンが存在します。これらのパターンは、チームがパフォーマンス、コスト、ガバナンス、開発速度のバランスをとるのに役立ちます。以下は、実際のデプロイで広く採用されているリファレンスパターンです。
API中心型LLMデプロイ
これは初期段階のチームや軽量なユースケースにおいて最も一般的なパターンです。事前学習済みまたはファインチューニングされたLLMがREST APIの背後にホストされ、ダウンストリームアプリケーションが同期リクエストを行います。プロンプトテンプレートはバージョン管理され、最小限のオーケストレーションが使用されます。このパターンは実装が簡単で、コンテンツ生成、要約、または基本的なチャットインターフェースに適しています。
検索拡張生成(RAG)パターン
高度な知識を要する環境で使用されるこのアーキテクチャは、LLMと、文脈に関連する情報を検索するベクターデータベースを組み合わせています。入力はまず、内部または外部のナレッジベースからの埋め込みベースの検索によって拡張され、その後にLLMへ渡されます。このパターンは、事実に基づく根拠付けとドメイン特有性を高めます。カスタマーサポート、法的文書の分析、またはエンタープライズ検索に最適です。
LLM + ワークフローオーケストレーションパターン
より複雑なシステムでは、LangChain、LangGraph、Airflowなどのオーケストレーションフレームワークを使用して、LLMがより大きなワークフローに組み込まれます。これらのアーキテクチャは、検索、プロンプト生成、推論、後処理、アクションのトリガーといった複数のステップを連鎖させます。これにより、動的な意思決定、マルチエージェントシステム、自律的なタスク実行が可能になります。エージェンティックAI、AIコパイロット、マルチターンアプリケーションで使用されます。
ファインチューニング済みプライベートLLMパターン
規制の厳しい業界や機密データを扱うユースケースでは、組織はオープンソースのLLMをファインチューニングし、自社のインフラストラクチャやVPC内にホストすることがあります。アーキテクチャには、データの匿名化、ファインチューニングパイプライン、隔離された推論環境、そして完全なモニタリングとアクセス制御が含まれます。このパターンは、医療、金融、防衛分野で一般的です。
ハイブリッドクラウド・エッジパターン
エッジAIのシナリオで登場しつつあるこのパターンは、メインのLLMをクラウドに保持しながら、軽量モデルやプロンプト処理ロジックをエッジデバイスに押し出します。機密データをローカルに保持しながら、レイテンシと帯域幅の使用量を削減します。IoT、自動車、モバイルの現場でますます使用されています。
これらのパターンは、LLMOpsの柔軟性と順応性を反映しており、以下の手段を提供します:
LLMOpsのエコシステムは急速に拡大しており、単一のツールで全てのニーズをカバーすることはできません。ハイパフォーマンスなチームは、自社のインフラストラクチャやワークフローに適合するモジュール式スタックを構築します。多くのエンタープライズグレードのスタックの核心において、TrueFoundryはデプロイ、オブザーバビリティ、オーケストレーション、自動化の各層にわたるサポートを提供することで中心的な役割を果たします。以下は、主要な層とそれらを支えるツールの内訳です。
1. データ&埋め込み層
この層は、検索拡張生成(RAG)のためのデータのクリーニング、変換、チャンク分割、埋め込みを処理します。これにより、LLMが文脈を意識して機能できるようになります。
これらのツールにより、モデルは推論時に関連情報を引き出すことができ、事実に基づく根拠付けと出力品質が向上します。
2. モデルサービング&推論層
これはLLMOpsスタックのバックボーンです。モデルを効率的にホストおよび提供し、GPU使用率を管理し、APIをスケーリングするために必要なコンポーネントが含まれています。
この層により、本番トラフィック下であってもLLMのレスポンスが迅速かつコスト効率よく提供されることが保証されます。
3. プロンプト&オーケストレーション層
この層はプロンプトテンプレート、エージェントフロー、動的なインタラクションを管理します。LLMアプリケーション内のロジックのルーティングやマルチステッププロセスの連鎖に役立ちます。
プロンプトオーケストレーションにより、チームは複雑なビジネスユースケース全体でLLMがどのように動作するかをコントロールできます。
4. モニタリング、フィードバック、ガバナンス層
信頼性、透明性、倫理性を維持するには、堅牢なモニタリングおよびガバナンスシステムが必要です。この層は、出力、ユーザーフィードバック、パフォーマンスメトリクスをキャプチャします。
5. ワークフロー&自動化層
この最後の層は、学習、評価、デプロイの自動化、CI/CDを管理します。これにより、反復的な開発をサポートする、追跡可能で再現可能なワークフローが可能になります。
これらのツールが各層で整合している場合、LLMOpsは散発的な実験から、再現可能で拡張可能なエンジニアリング手法へと変革されます。現代のチームは単一のエンドツーエンドソリューションに依存するのではなく、インフラストラクチャ、スケール、コンプライアンスのニーズに合った拡張可能なスタックを構築します。
重要なのは相互運用性であり、スムーズに統合され、主要な段階を自動化し、モデルのライフサイクル全体にわたって透明性を提供するツールを選択することです。適切なスタックを配置することで、LLMはプロトタイプから意味のあるビジネス成果を生み出すプロダクションレベルのシステムへと進化できます。
LLMOpsは、大規模言語モデルを活用したアプリケーションを構築するチームにとって、急速に不可欠な基礎分野になりつつあります。LLMが実験的な使用から本番環境のクリティカルなシステムへと移行するにつれ、組織は複雑さ、コスト、パフォーマンスを管理するために、構造化されたアーキテクチャ、専門的なツール、再現可能なワークフローを必要としています。適切に設計されたLLMOpsアーキテクチャは、デプロイを加速させるだけでなく、倫理的な整合性、データガバナンス、フィードバックを通じた継続的な改善を確実なものにします。
データ管理、推論、オーケストレーション、モニタリングの各層にわたってモジュール式ツールを採用することで、チームはLLMライフサイクルのあらゆる側面において柔軟性と制御を獲得できます。オープンソースモデルを提供する場合でも、プロプライエタリなモデルをファインチューニングする場合でも、スケーラブルなLLMOpsプラクティスは持続可能なAIシステムのバックボーンとなります。
LLMOpsの未来は、モデルの急速な進化、新たなリスク、高まるエンタープライズの需要に追従する能力にかかっています。責任を持ってスケーリングを行う準備ができている組織にとって、LLMOpsアーキテクチャへの投資はもはや選択肢ではなく、戦略的優位性です。
LLMOpsアーキテクチャとは、本番環境における大規模言語モデルの全ライフサイクルを管理するために設計された構造的フレームワークです。データ取り込み、プロンプトのバージョニング、モデルのオーケストレーションに必要なインフラストラクチャを提供し、AIを単なる実験から信頼性の高いエンタープライズデプロイへと進化させます。このアーキテクチャにより、アプリケーションは進化してもスケーラブルで、セキュアで、保守可能な状態を維持できます。
LLMOpsアーキテクチャはいくつかの重要な層で構成されています。RAGベースのコンテキスト用のベクターデータベース、バージョン管理用のプロンプト管理システム、モデル提供用の集中型AI gatewayなどです。さらに、レイテンシとトークン使用量を追跡するオブザーバビリティモジュールや、特化したタスク用のファインチューニングパイプラインも含まれる必要があります。TrueFoundryはこれらのコンポーネントを単一のコントロールプレーンに統合し、断片化したAIスタックの管理に伴う複雑さを軽減します。
LLMOpsアーキテクチャの主な違いは、学習重視のワークフローからオーケストレーション重視のパイプラインへのシフトです。従来のMLOpsがカスタムモデルの構築や特徴量エンジニアリング(Feature Engineering)に焦点を当てていたのに対し、LLMOpsはプロンプトエンジニアリングと検索拡張生成(RAG)を通じた事前学習済み基盤モデルの管理を優先します。TrueFoundryは両方のパラダイムをサポートするプラットフォームを提供し、チームが確立された運用標準を捨てることなく生成AIへ移行できるようにします。
LLMOpsアーキテクチャ内の標準的なツールには、PineconeやWeaviateのようなベクターストア、LangChainのようなオーケストレーションフレームワーク、特化したモニタリングスイートなどがあります。しかし、これらを個別のエンティティとして管理すると、統合のサイロ化が発生することがよくあります。TrueFoundryは包括的なオーケストレーション層として機能し、任意のクラウドプロバイダーにわたってモデルデプロイ、シークレットのローテーション、コストを意識したルーティングを管理するために必要なインフラストラクチャを提供します。
TrueFoundryがLLMOpsアーキテクチャにとって理想的なプラットフォームである理由は、自社のセキュアなクラウド環境内でネイティブに動作する開発者中心のコントロールプレーンを提供するためです。Kubernetesやインフラ構築の複雑さを抽象化しながら、高性能なゲートウェイと高度なオブザーバビリティを提供します。データをVPC内に保持し、リソースの最適化を自動化することで、エンタープライズAIのスケーリングをセキュアかつコスト効率の高い状態に保ちます。
LLMOpsアーキテクチャは通常、データ層、モデル層、アプリケーション層、インフラストラクチャ層のいくつかの層で構成されます。データ層はデータセットを管理し、モデル層は学習や推論を扱い、アプリケーション層はAIをプロダクトに統合し、インフラストラクチャ層はデプロイ、スケーリング、モニタリング、システム管理をサポートします。
LLMOpsには、プロンプト、モデル、ファインチューニングのイテレーションに対する構造化されたバージョニングが含まれます。バージョン管理により再現性が保証され、ロールバックが容易になり、本番システムを妨害することなく実験が可能になります。チームは改善を追跡し、モデルのパフォーマンスを比較し、監査や規制の要件へのコンプライアンスを維持できます。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























