August 31, 2026
|
5 min read

Published: October 12, 2026
Blazingly fast way to build, track and deploy your models!
大規模言語モデルが実験段階から本番環境へと移行するにつれて、チームはAIトラフィックの管理、セキュリティ、監視の方法を再考しています。かつてはシンプルなAPI統合に見えたものが、今ではプロンプト、トークン、モデルルーティング、リトライ、コスト追跡、信頼性といった、従来のアプリケーションインフラストラクチャでは対応しきれなかった懸念事項を伴うようになっています。
多くのエンジニアリングチームは、この道のりを、使い慣れたAPIゲートウェイ(例えば Kong)の機能を拡張し、既存のルーティング、認証、レート制限パターンを活用することから始めます。LLMの利用が拡大するにつれて、AIネイティブなゲートウェイ(例えば Portkey )が登場し、プロンプト、モデル、トークンレベルの可観測性に特化した抽象化を提供しています。
どちらのアプローチも実際の問題解決を目指していますが、根本的に異なる出発点を持っています。KongはHTTP APIとマイクロサービスの管理に根ざしているのに対し、PortkeyはLLMアプリケーションのワークフローに特化して設計されています。これらの哲学の違いは、AIシステムがチーム、環境、本番ユースケース全体でスケールするにつれて、ますます重要になります。
本稿では、アーキテクチャ、可観測性、ガバナンス、エンタープライズ対応の観点からKongとPortkeyを比較します。各ツールが最も適している場所、限界が見え始める場所、そしてAIがインフラストラクチャスタックの核となるにつれてプラットフォームチームが考慮すべき点について考察します。
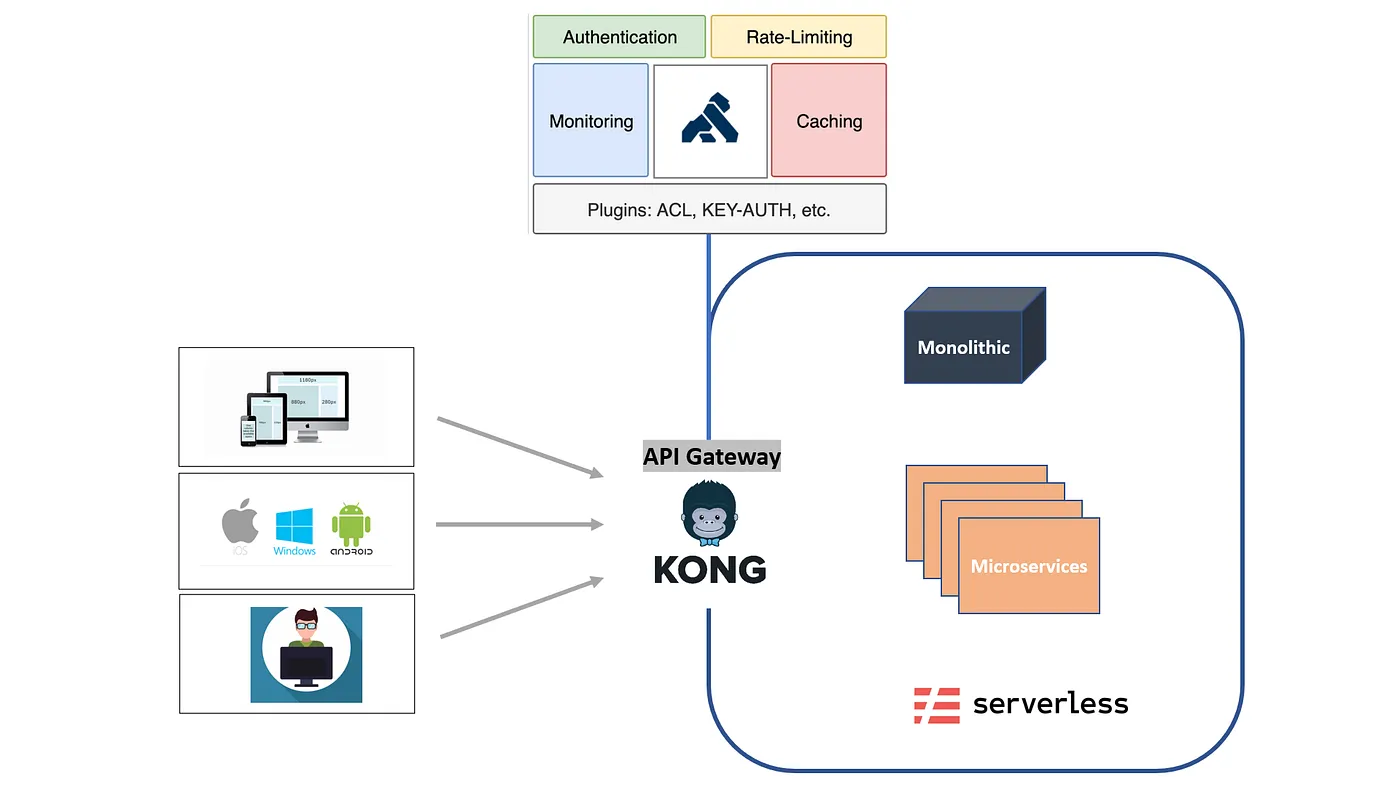
Kong は、マイクロサービス間のHTTPトラフィックを管理、保護、ルーティングするために構築された、広く採用されているAPIゲートウェイです。Kubernetesベースのアーキテクチャではイングレスレイヤーとして一般的に使用されており、認証、レート制限、トラフィックルーティング、リクエストレベルの可観測性といった懸念事項の処理でよく知られています。
アーキテクチャの観点から見ると、Kongは APIファーストシステムに最適化されています。その核となる抽象化はエンドポイント、サービス、ルート、プラグインを中心に展開されており、リクエストがステートレスで予測可能かつ均一である従来のバックエンドおよびマイクロサービス環境に非常に適しています。
チームがLLMを導入する際、Kongはしばしば 最初に再利用されるツール AIトラフィックを管理するために、LLM呼び出しを単なる別のAPIエンドポイントとして扱います。これは当初、以下の目的で機能します:
しかし、LLMトラフィックは従来のAPIにはきれいにマッピングできない特性をもたらします。
AIの利用が単純な実験段階を超えて拡大するにつれて、これらの課題は、特に複数のチームが関わる環境やコストに敏感な環境でますます顕著になります。
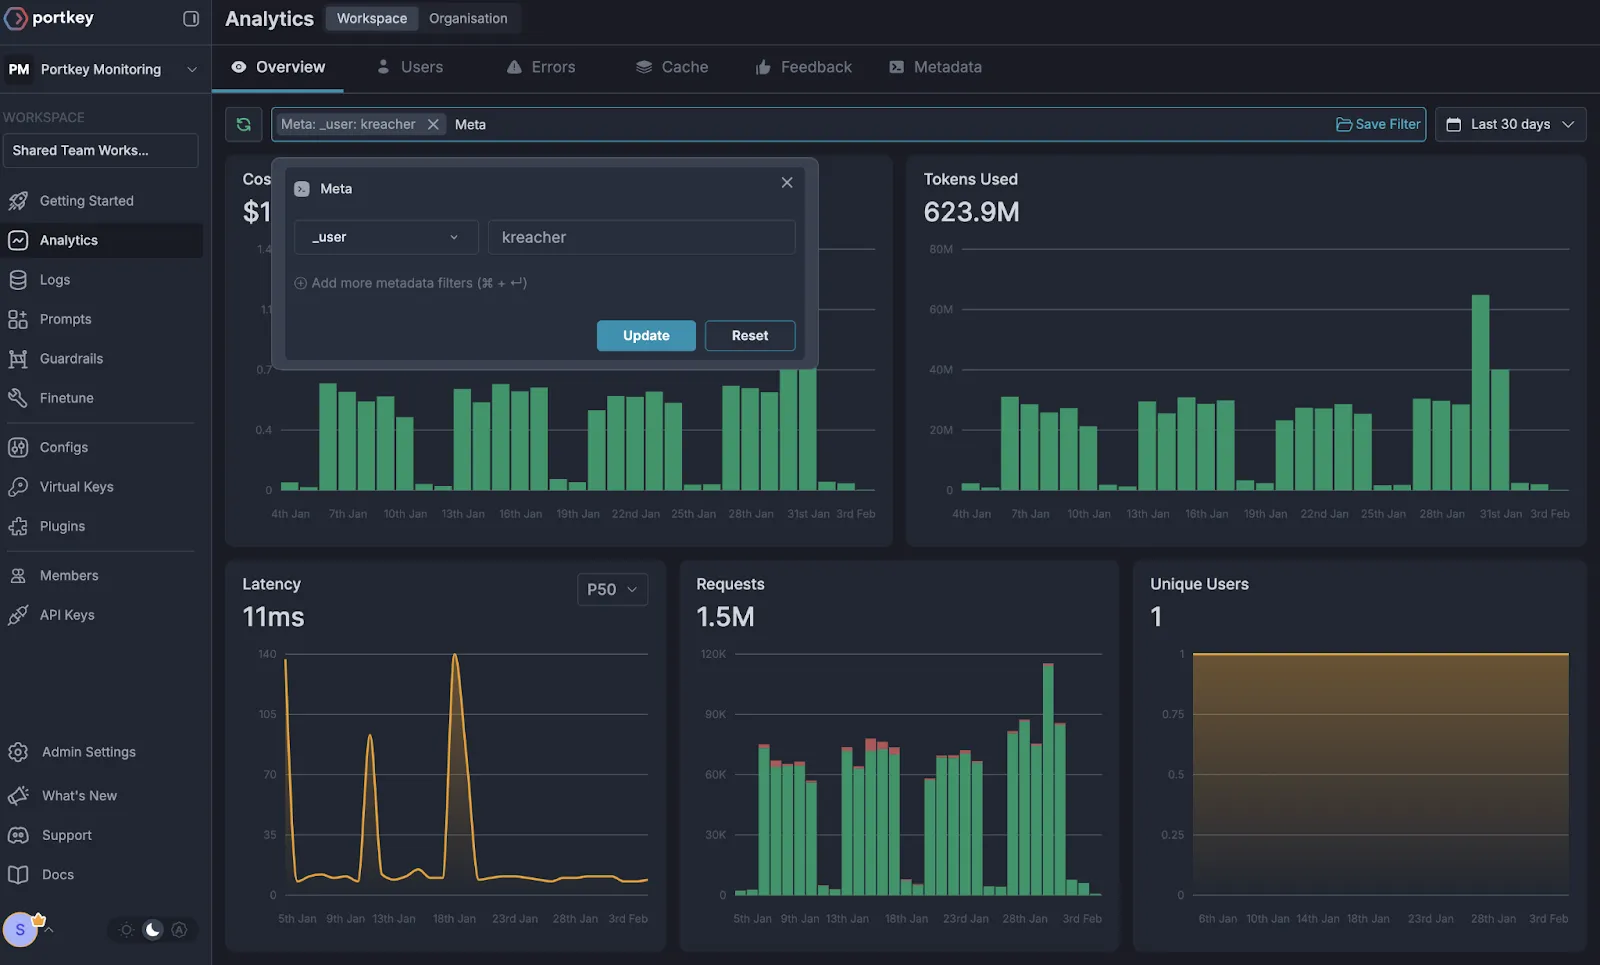
Portkey は、大規模言語モデル(LLM)上に構築されたアプリケーション向けに特別に設計されたAIネイティブなゲートウェイです。LLMの呼び出しを一般的なAPIリクエストとして扱うのではなく、PortkeyはAIアプリケーションが実際に機能する方法(プロンプト、モデル、トークン、プロバイダー)に合わせた抽象化を導入しています。
Portkeyは、AIアプリケーションと複数のLLMプロバイダー間の仲介レイヤーとして機能します。これにより開発者は、アプリケーションコードを特定のプロバイダーのAPIに密接に結合させることなく、モデルの切り替え、トラフィックのルーティング、利用状況の監視を行うことができます。
KongのようなAPIゲートウェイと比較して、Portkeyは 設計上LLMを認識しています.それは以下の点を認識しています。
このため、Portkeyは、特に初期または中期のプロダクション環境でLLMを活用したアプリケーションを構築・反復するチームにとって強力な選択肢となります。
LLMの利用がチームや環境全体に拡大するにつれて、いくつかの限界が明らかになります。
これらの制約は、AIがアプリケーションの機能から 共有されるエンタープライズ機能へと移行する際に重要になります。
Key Metrics for Evaluating Gateway
| Criteria | What should you evaluate ? | Priority | TrueFoundry |
|---|---|---|---|
| Latency | Adds <10ms p95 overhead for time-to-first-token? | Must Have | ✅ Supported |
| Data Residency | Keeps logs within your region (EU/US)? | Depends on use case | ✅ Supported |
| Latency-Based Routing | Automatically reroutes based on real-time latency/failures? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
| Key Rotation & Revocation | Rotate or revoke keys without downtime? | Must Have | ✅ Supported |
一方、 Kong と Portkey はどちらもAIワークロードの前に配置できますが、それぞれ異なるアーキテクチャ上の前提に基づいて構築されています。この違いを理解することは、単一のアプリケーションを超えてAIをスケールさせる方法を決定するプラットフォームチームにとって非常に重要です。
Kongは次のような場合に良い選択肢です。
この設定では、Kongは既存のAPIインフラストラクチャの 一時的な拡張 として機能します。
Portkeyは次のような場合に最適です。
Portkeyは アプリケーション層で真価を発揮します、特に、迅速に開発を進めるAI製品チームにとって。
KongとPortkeyはどちらも Kong and Portkey AIスタックにおける実際的な課題に対処しますが、その対応は異なる、そして最終的には限定的な層にとどまります。AIが単一のアプリケーション機能から 企業全体で共有される機能 複数のチーム、環境、規制の境界をまたぐものへと進化するにつれて、これらの限界は明らかになります。
KongはAPIリクエストを管理するように設計されており、AIの振る舞いを管理するものではありません。プロンプト、トークン、モデル選択、エージェントの実行は、ゲートウェイからは見えません。
PortkeyはLLMを意識した制御を導入していますが、ガバナンスは依然として主に アプリケーションの範囲内に限定されます.
しかし、エンタープライズAIチームは、次のような質問への答えを必要としています。
KongもPortkeyも提供していません 組織全体のAIガバナンス 主要な機能としては。
AIのコストは、以下の要素の組み合わせによって決まります。
Kongは、これらのAI固有のコスト要因を把握していません。
Portkeyはトークンレベルのメトリクスを公開していますが、使用が複数のチーム、アプリケーション、環境にまたがるにつれて、コストのアトリビューションはますます困難になります。
インフラレベルのアトリビューションがなければ、プラットフォームチームと財務チームは、基本的な質問に答えるのに苦労します。 誰が何を、なぜ費やしているのか?
本番AIシステムでは、以下の間の厳格な分離が必要です。
KongはAI環境の分離を念頭に置いて構築されていませんでした。
Portkeyは、厳格な環境境界を強制するのではなく、アプリケーションワークフローに最適化されています。
規制対象業界の企業にとって、この分離の欠如はすぐにデプロイの妨げとなります。
企業におけるAIデプロイメントは、次のような要件を満たす必要があります。
これらの制約は適用される必要があります インフラストラクチャ層で、アプリケーションコードに組み込まれたり、チームによって手動で処理されたりするのではなく。
KongはAIトラフィックを一般的なHTTPリクエストとして扱います。
Portkeyは、クラウドファーストのアプリケーションレベルでの利用を前提としています。
どちらのアプローチも、 コンプライアンスを最優先するAIデプロイメント。
本番環境のAIは、同期的なプロンプト・応答コールに限定されません。実際のシステムには以下が含まれます。
APIトラフィックやプロンプトルーティングのみに焦点を当てるゲートウェイでは、 AIワークロードのライフサイクル全体を管理できません。
AIの導入が成熟するにつれて、企業は同じ認識に至っています。 ゲートウェイだけでは不十分です。 AIを本番環境で実行するには、 アクセス、デプロイメント、可観測性、ガバナンス、コンプライアンスを統合するインフラストラクチャ層が必要です。このため、組織は最終的にAPIゲートウェイやLLMアプリケーションゲートウェイを超えて、 エンタープライズ規模向けに構築されたAIネイティブなインフラストラクチャプラットフォームへと移行します。
の限界は Kong と Portkey が同じ根本原因に起因しています。それは、どちらも解決するために設計されたという点です。 ゲートウェイレベルの問題ではなく、 エンタープライズAIインフラの問題。
AIが共有され、本番環境で不可欠な機能となるにつれて、企業はトラフィックルーティングやプロンプトの抽象化以上のものを必要としています。企業が必要としているのは、 AIガバナンス、デプロイメント、可観測性、セキュリティ を最優先のインフラ課題として扱うプラットフォームです。ここで TrueFoundry が他と一線を画しています。
TrueFoundryは、AIワークロードは他の重要な本番システムと同様に管理されるべきであるという考えに基づいて構築されていますが、 AIネイティブなプリミティブを備えています。リクエストパス内でのみ動作するのではなく、TrueFoundryは 統合されたAIコントロールプレーンとして機能します。
大まかに言えば、TrueFoundryは以下を統合します。
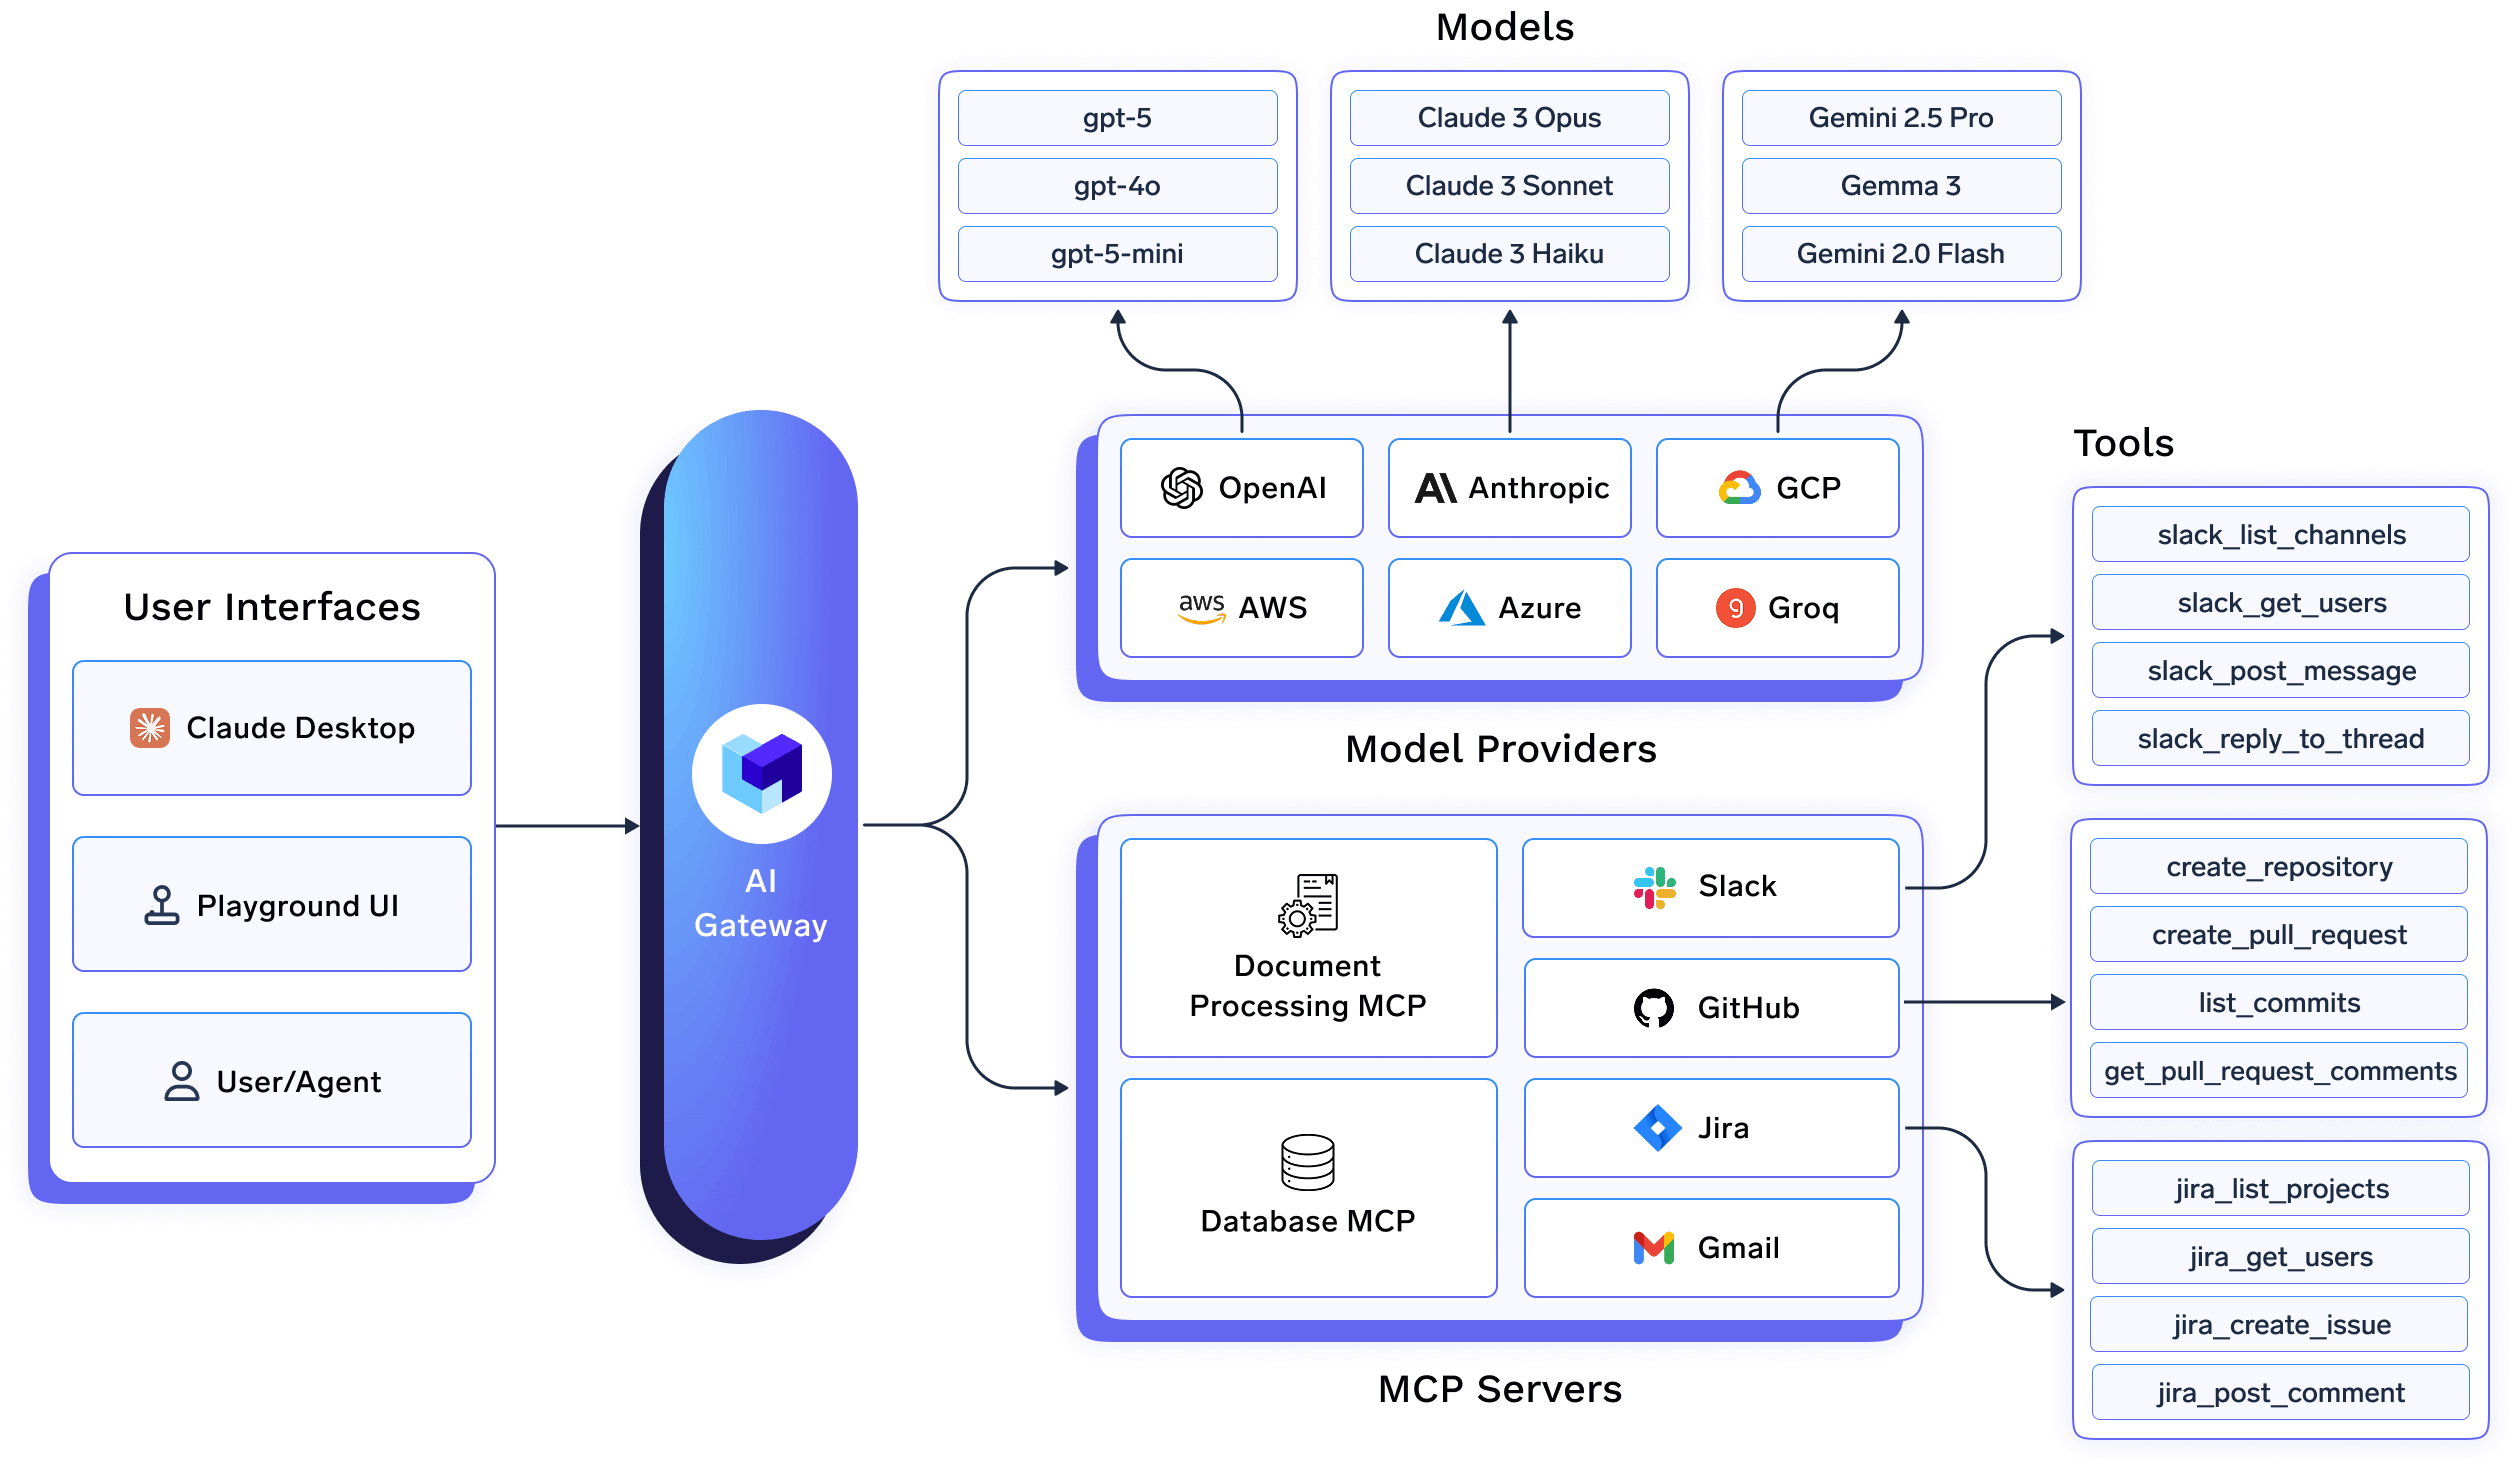
多くのAIスタックでは、LLMの利用はAPI統合の問題として扱われます。リクエストはルーティングされ、認証され、ログに記録されますが、リクエストの境界を越えたすべては個々のアプリケーションに委ねられています。TrueFoundryは、AIワークロード(サービス、ジョブ、エージェント)を ライフサイクル、所有権、運用上の境界を持つインフラストラクチャオブジェクト.
単に リクエストを許可すべきかどうか を決定するだけでなく、TrueFoundryは AIシステムがどこで、どのように、どのような制約の下で実行されるかをデプロイからランタイムまで制御します。このリクエストルーティングからライフサイクル制御への移行こそが、AIの利用が拡大するにつれて一貫したガバナンスを可能にするものです。
具体的には、これはいくつかの重要な側面で現れます。
ゲートウェイ中心のアーキテクチャでは、 アクセスポリシー は通常、アプリケーションコード、SDK設定、またはサービスごとのゲートウェイルールに組み込まれています。チーム、サービス、環境が増えるにつれて、これはすぐに脆くなります。
TrueFoundryは、アクセスおよび使用ポリシーを ワークスペースおよび環境レベルで適用します。モデル、エージェント、ツールは、開発、ステージング、本番などの環境にスコープされ、その環境にデプロイされたすべてのワークロードにわたって、権限と制御が一貫して適用されます。
ポリシーが個々のアプリケーションではなく環境に紐付けられているため、以下のメリットがあります。
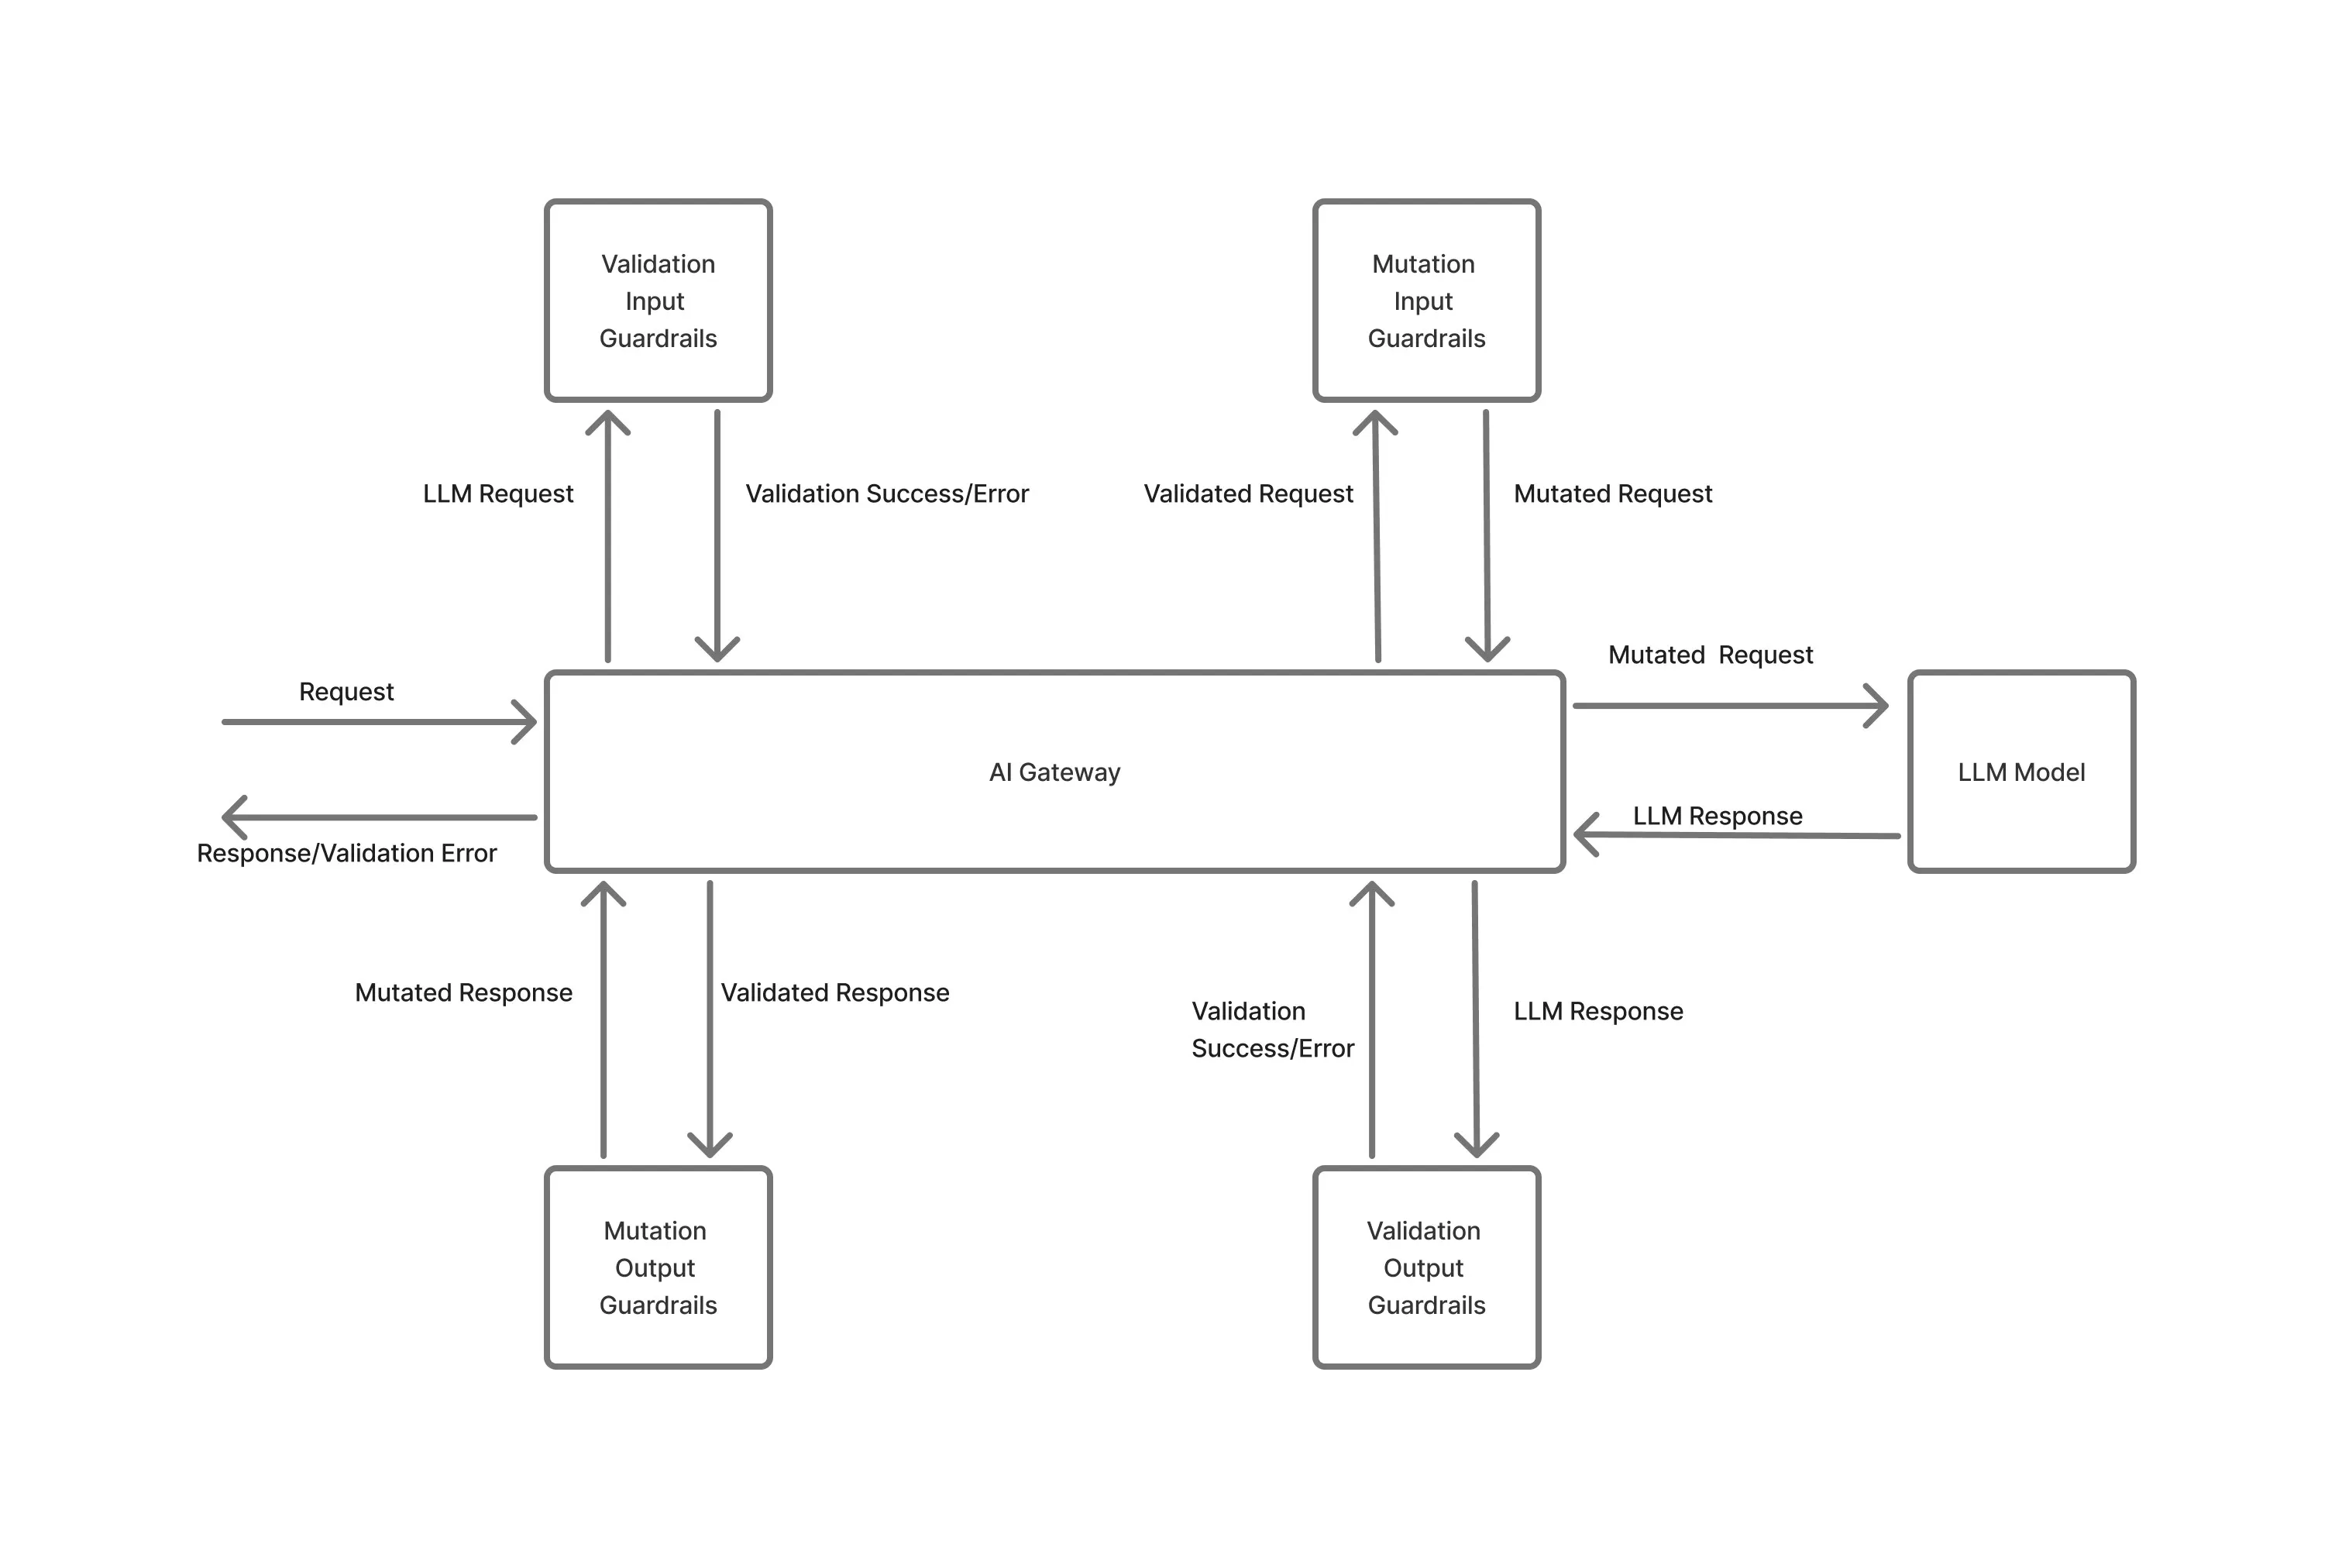
AIシステムが本番環境で失敗するのは、単一のリクエストが無効であるためではなく、同時実行の急増、リトライの集中、大規模なバックグラウンドワークロードなどにより、予期せぬ形で使用量が蓄積されるためです。
TrueFoundryは使用量 ガードレール を実行時に適用します。ワークロードがランタイムでどのように動作するかを可視化しながら、同時実行制限、スループット制約、使用量上限は、基盤となるモデルやインフラストラクチャを共有するサービスやジョブ全体にわたって一元的に適用されます。
これらの制限はプラットフォーム層で適用されるため、以下のメリットがあります。
これは、アプリケーションが正しく独立して動作することを前提とするクライアント側またはSDKレベルの制御とは根本的に異なります。
TrueFoundryは、 デプロイメントおよび環境レイヤーで分離を徹底しています、リクエスト受付時だけでなく。AIサービス、バッチジョブ、エージェントワークフローは、定義された環境内で分離されたワークロードとしてデプロイされ、アクセス、ポリシー、リソースは環境ごとにスコープ設定されます。
これらのワークロードは、 独立したランタイムプロセスと障害ドメインを持つ個別のデプロイメントおよびジョブとして、ゲートウェイの背後で単一のフラットな実行コンテキストを共有するのではなく実行されます。その結果、以下のようになります。
主にリクエストパスで動作するアプリケーションレベルのLLMゲートウェイは、ランタイムの実行やインフラストラクチャの状態を制御しません。その結果、このレベルのデプロイメントおよび環境分離を提供することはできません。これは、AIワークロードがチームや本番環境全体に拡大するにつれて、ますます顕著になる問題です。

トークンレベルのメトリクスは有用ですが、AIワークロードが長時間実行されるサービス、バックグラウンドジョブ、エージェントワークフローにまたがるようになると、それだけでは不十分です。本番システムでは、コストとパフォーマンスは以下の要素間の相互作用から生まれます。
TrueFoundryは、これらのシグナルをプラットフォームレイヤーで相関付け、チームが他の本番システムについて推論するのと同じ方法でAIの動作について推論できるようにします。環境、サービス、および所有者別、個々のAPI呼び出しごとではなく。
多くの企業AI導入は、アプリケーションレベルのゲートウェイが暗黙的に前提としない制約の下で運用されており、具体的には以下のようなものがあります。
TrueFoundryのコントロールプレーンは、これらのデプロイメントモデル全体で動作するように設計されており、推論がどこで実行されても、ガバナンス、分離、可観測性が一貫して維持されることを保証します。その結果、データ境界や監査可能性といったコンプライアンス特性は、アプリケーションロジックやプロセス制御によって後から追加されるのではなく、インフラストラクチャ自体の一部として強制されます。
KongとPortkeyはそれぞれ、AI導入の異なる段階で重要な問題を解決します。Kongは、おなじみのAPIゲートウェイパターンをAIトラフィックに拡張する一方、PortkeyはLLMネイティブの抽象化を導入し、AI搭載アプリケーションの構築と運用を容易にします。
しかし、AIが共有され、本番環境で不可欠な機能となるにつれて、企業はリクエストルーティングやプロンプト管理を超えた課題にすぐに直面します。ガバナンス、コスト配分、環境分離、コンプライアンスといった要素はすべて、ゲートウェイだけでなくインフラストラクチャレベルでの制御を必要とします。
これが、多くの組織がAPIおよびLLMアプリケーションゲートウェイを超えて、AIネイティブのインフラストラクチャプラットフォームへと移行する理由です。例えば、 TrueFoundryは、チームや環境をまたいでAIシステムを確実に実行、管理、スケーリングするように設計されています。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.