



November 16, 2026
|
5 min read



Blazingly fast way to build, track and deploy your models!
Google Cloud Platform (GCP) 上にGenerative AIを展開するには、 Google Kubernetes Engine (GKE)、Cloud TPU、 Vertex AI などの複雑なプリミティブ群をオーケストレートする必要があります。GCPは生のマシンリソースを提供しますが、これらを要件に準拠したInternal Developer Platform (IDP) として組み上げるには、大規模なカスタムエンジニアリングが必要です。
TrueFoundryはインフラストラクチャオーバーレイとして機能します。当社がオーケストレーションを処理するため、お客様はVPCやデータレジデンシーに対する完全な制御権を保持できます。本記事では、特にスプリットプレーンアーキテクチャ、 Workload Identity Federation、TPU管理に関するGCPとの統合パターンを詳しく解説します。
管理インターフェースとワークロード実行環境を分離するために、スプリットプレーンアーキテクチャを採用しています。
セキュリティ境界 インバウンドのファイアウォールルールは不要です。クラスタ内のAgentが、当社のコントロールプレーンへの安全なアウトバウンド専用WebSocketまたはgRPCストリームを開始します。Agentはデプロイマニフェストをポーリングし、テレメトリを送信します。お客様のVPCは外部からのイングレスアクセスに対してプライベートに保たれます。
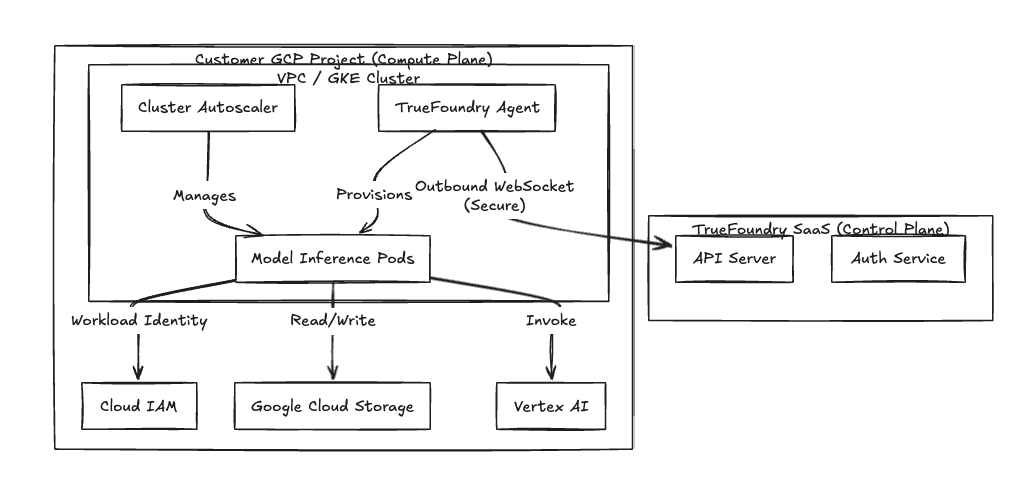
図1:スプリットプレーンアーキテクチャにより、データ処理が顧客のVPC内に隔離されます。
高いパフォーマンスを実現するため、 Alias IP を使用したVPCネイティブクラスタとしてコンピュートプレーンを構成します。すべてのコンピュートリソースはプライベートサブネット内に配置されます。
イングレス(推論リクエスト) アプリケーションのトラフィックは、 Cloud Load Balancing(通常はGlobal External ALB)を経由してVPCに入ります。ALBはTLSをターミネートし、GKEクラスタ内で動作する Istio Ingress Gateway にリクエストを転送します。
Private Google Access コンプライアンスを維持するため、Google API(Cloud Storage、Vertex AI)へのトラフィックは Private Google Access を経由してルーティングされます。これにより、推論podとGCPマネージドサービス間のトラフィックはパブリックインターネットをバイパスし、Googleのネットワークバックボーン上に維持されます。
エグレス GKEワーカーノードが Artifact Registry からコンテナ画像をプルするには、アウトバウンドアクセスが必要です。このトラフィックは、プライベートサブネットにアタッチされた Cloud NAT を経由してルーティングします。
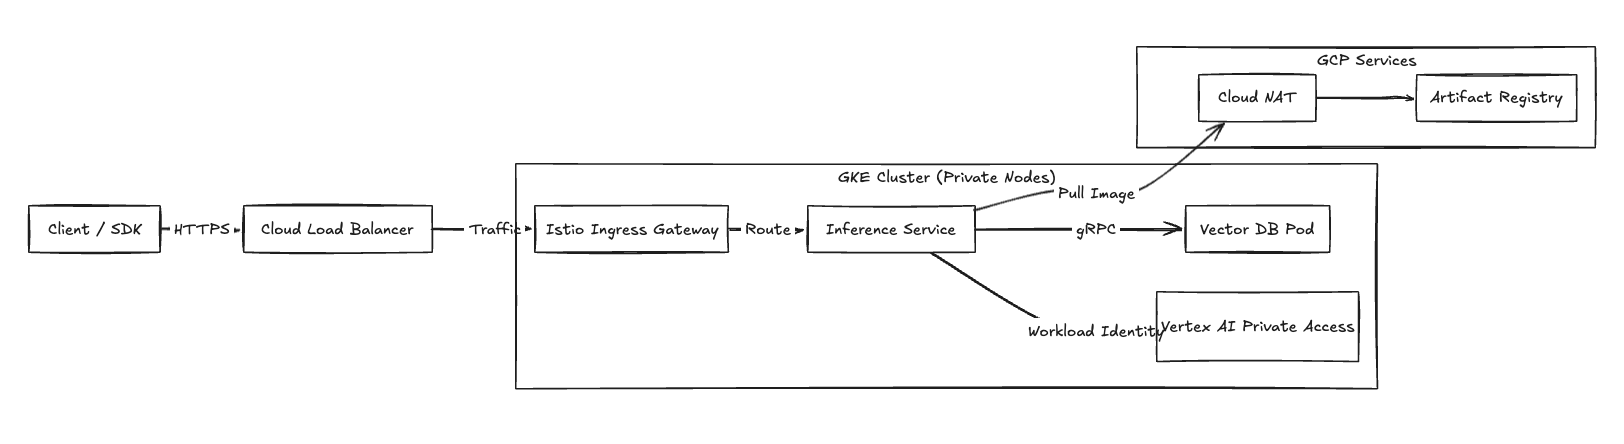
図2:イングレスとプライベート接続の詳細を示すネットワークトラフィックフロー。
静的なService Accountキー(.jsonファイル)の廃止を徹底しています。TrueFoundryは、すべてのワークロード認証に対してGKE Workload Identityを実装します。
認証シーケンス
万が一podが侵害された場合でも、被害の最小化範囲(ブラストレディアス)はその特定のGSAに付与されたIAMロールだけに厳密に制限されます。
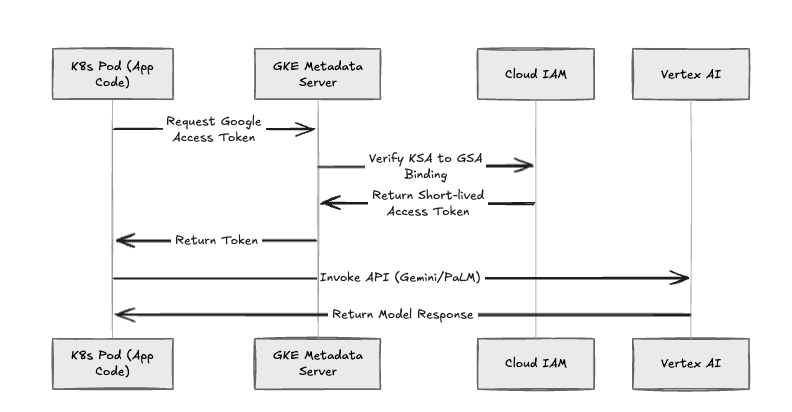
図3:GKE Workload Identity認証フロー。
NVIDIA GPUおよびCloud TPUをオーケストレートするために、 GKE Node Pools と統合されています。
TPUオーケストレーション TPU上でのスケジューリングには、特定のトポロジー制約への対応が必要です。TrueFoundryは、podをTPUスライス(v4-8、v5eなど)にスケジュールするために必要なnodeSelectorやtolerationsを管理します。デプロイマニフェストに必要なドライバーとリソース制限を自動挿入し、低レベルなKubernetes設定を抽象化します。
Spot VM管理 バッチ処理や開発ワークロード向けに、コスト削減(オンデマンド比で通常60〜90%の削減)を実現する Spot VMs の管理を行います。
Gemini Pro などのモデルごとに個別キーを管理することは、運用上のオーバーヘッドを生み出します。TrueFoundryは統合APIインターフェースとして機能するAI Gatewayを提供します。
この統合により、チームは生のKubernetes管理に伴う運用の摩擦に悩まされることなく、GCPのハードウェア優位性(特にTPUと高スループットネットワーク)を最大限に活用できるようになります。TrueFoundryはインフラストラクチャのフォースマルチプライヤー(効果増幅装置)として機能します。セキュリティとデータレジデンシーに対する完全な統制権はお客様が保持したまま、GKEオーケストレーションの複雑さを抽象化します。このバランスにより、GenAIワークロードを即座に運用化し、インフラを制約から競争上のスピードという強みへと変換できます。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























