



November 16, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
Difyを使ったAIアプリケーションの構築は実に強力です。大量のコードを書くことなく、チャットボット、AI agent、スマート検索システムなどを非常に簡単に作成できます。コンポーネントをドラッグ&ドロップし、さまざまなAIモデルに接続するだけで、わずか数分でプロトタイプを稼働させることができます。
しかし、本質的な課題は開発からプロダクション(本番環境)への移行段階で発生します。数人のテストユーザーで完璧に機能したアプリが、何千人もの実際のユーザーによって使用され始めると、途端に大きなトラブルを引き起こすことがあります。TrueFoundry AI Gatewayはこのギャップをシームレスに埋めます。本番環境に対応したセーフティネットとして機能し、クラッシュ、セキュリティ上の脆弱性、プロジェクトを破綻させかねない予期せぬ請求といった一般的な問題に悩まされることなく、Difyアプリを開発環境から本番環境へと移行させます。
この包括的なガイドでは、DifyをTrueFoundryのAI Gatewayと連携するプロセスを順を追って解説します。この強力な組み合わせにより、AIアプリケーションでエンタープライズグレードの機能が解放されます。また、AI gatewayを利用する戦略的重要性や、安全で拡張性が高くコスト効率に優れたAIエコシステムの構築方法についても詳しく説明します。
率直に言って、DifyでAIアプリを構築することはスタート段階としては優れていますが、プロダクション環境は全く異なる領域です。TrueFoundry AI Gatewayを構成に組み込むことで、以下の変化がもたらされます:
コストの完全なコントロールを獲得
システムを停止させずにセキュリティを強化
AIプロバイダーの障害時にもシステムダウンを回避
AIスタックの将来性を確保
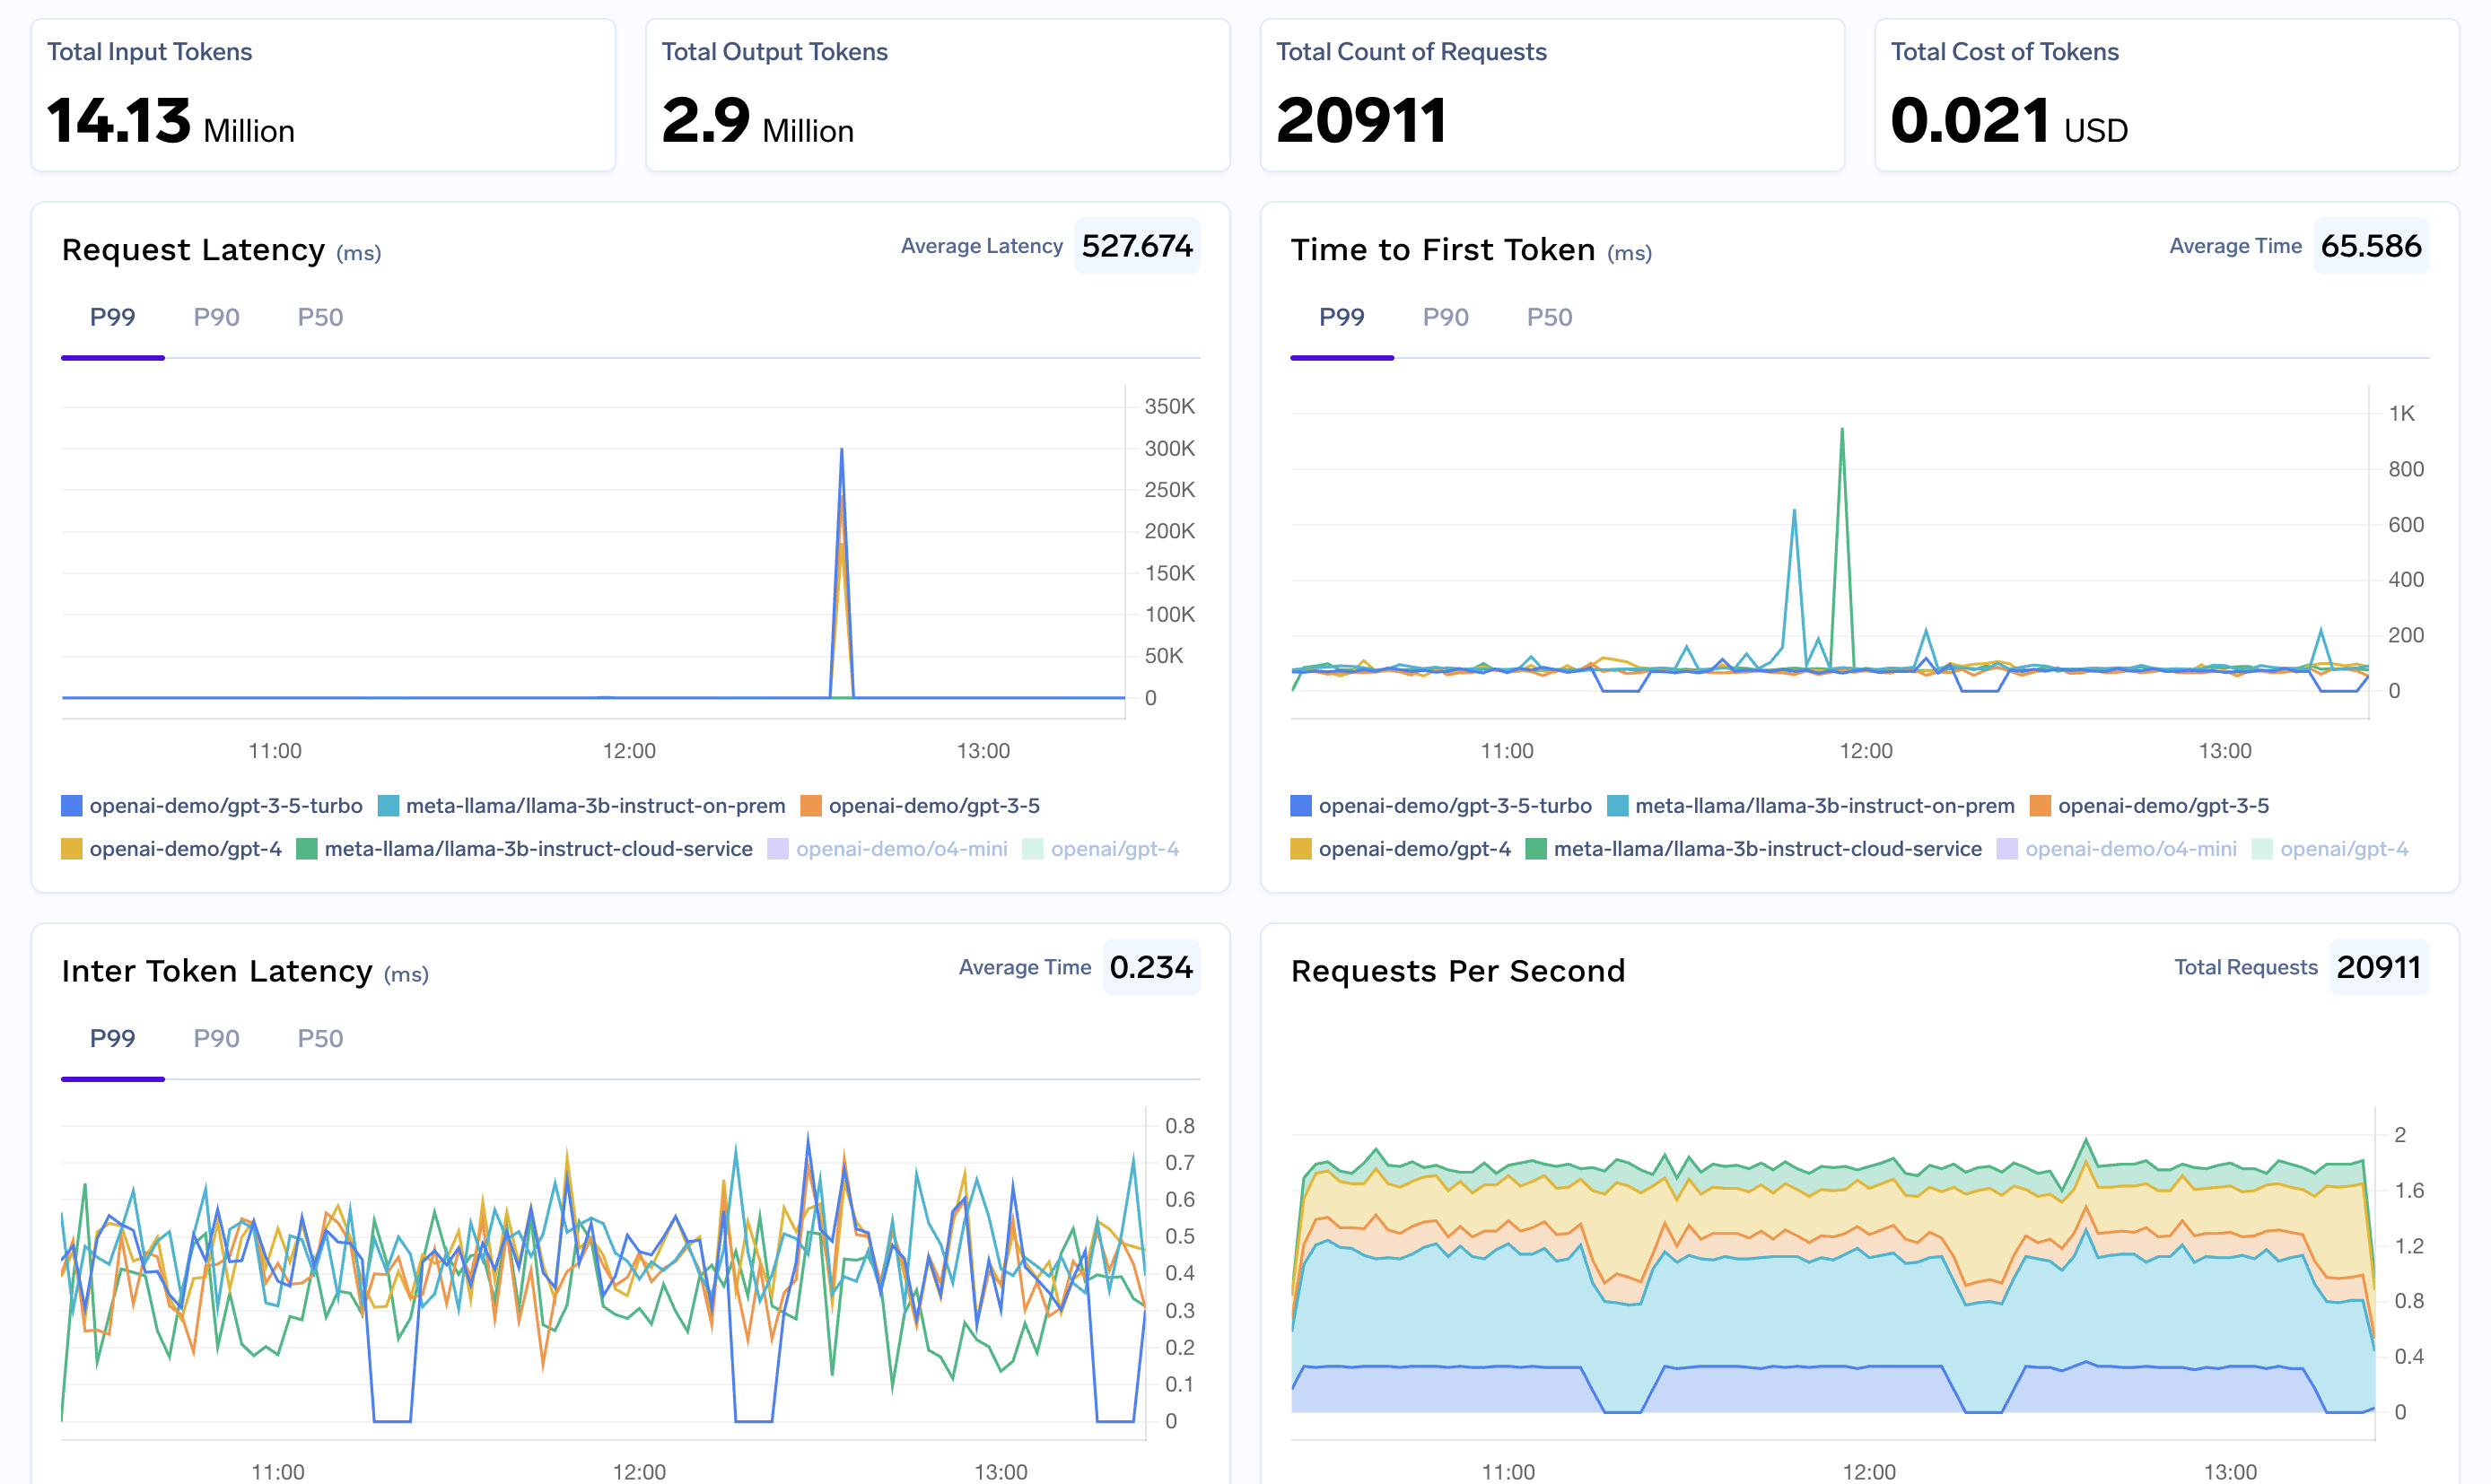
Gateway評価の主要指標
| 評価基準 | 何を評価すべきか? | 優先度 | TrueFoundry |
|---|---|---|---|
| レイテンシ | Time-to-first-tokenのオーバーヘッドは<10ms p95以下か? | 必須(Must Have) | ✅ 対応済み |
| データレジデンシー | ログを指定リージョン(EU/US)内に保持できるか? | ユースケースによる | ✅ 対応済み |
| レイテンシベースのルーティング | リアルタイムのレイテンシや障害に基づいて自動的にルーティングを変更できるか? | 必須(Must Have) | ✅ 対応済み |
| キーのローテーションと失効 | ダウンタイムなしでキーのローテーションや失効を行えるか? | 必須(Must Have) | ✅ 対応済み |
| キーのローテーションと失効 | ダウンタイムなしでキーのローテーションや失効を行えるか? | 必須(Must Have) | ✅ 対応済み |
| キーのローテーションと失効 | ダウンタイムなしでキーのローテーションや失効を行えるか? | 必須(Must Have) | ✅ 対応済み |
| キーのローテーションと失効 | ダウンタイムなしでキーのローテーションや失効を行えるか? | 必須(Must Have) | ✅ 対応済み |
| キーのローテーションと失効 | ダウンタイムなしでキーのローテーションや失効を行えるか? | 必須(Must Have) | ✅ 対応済み |

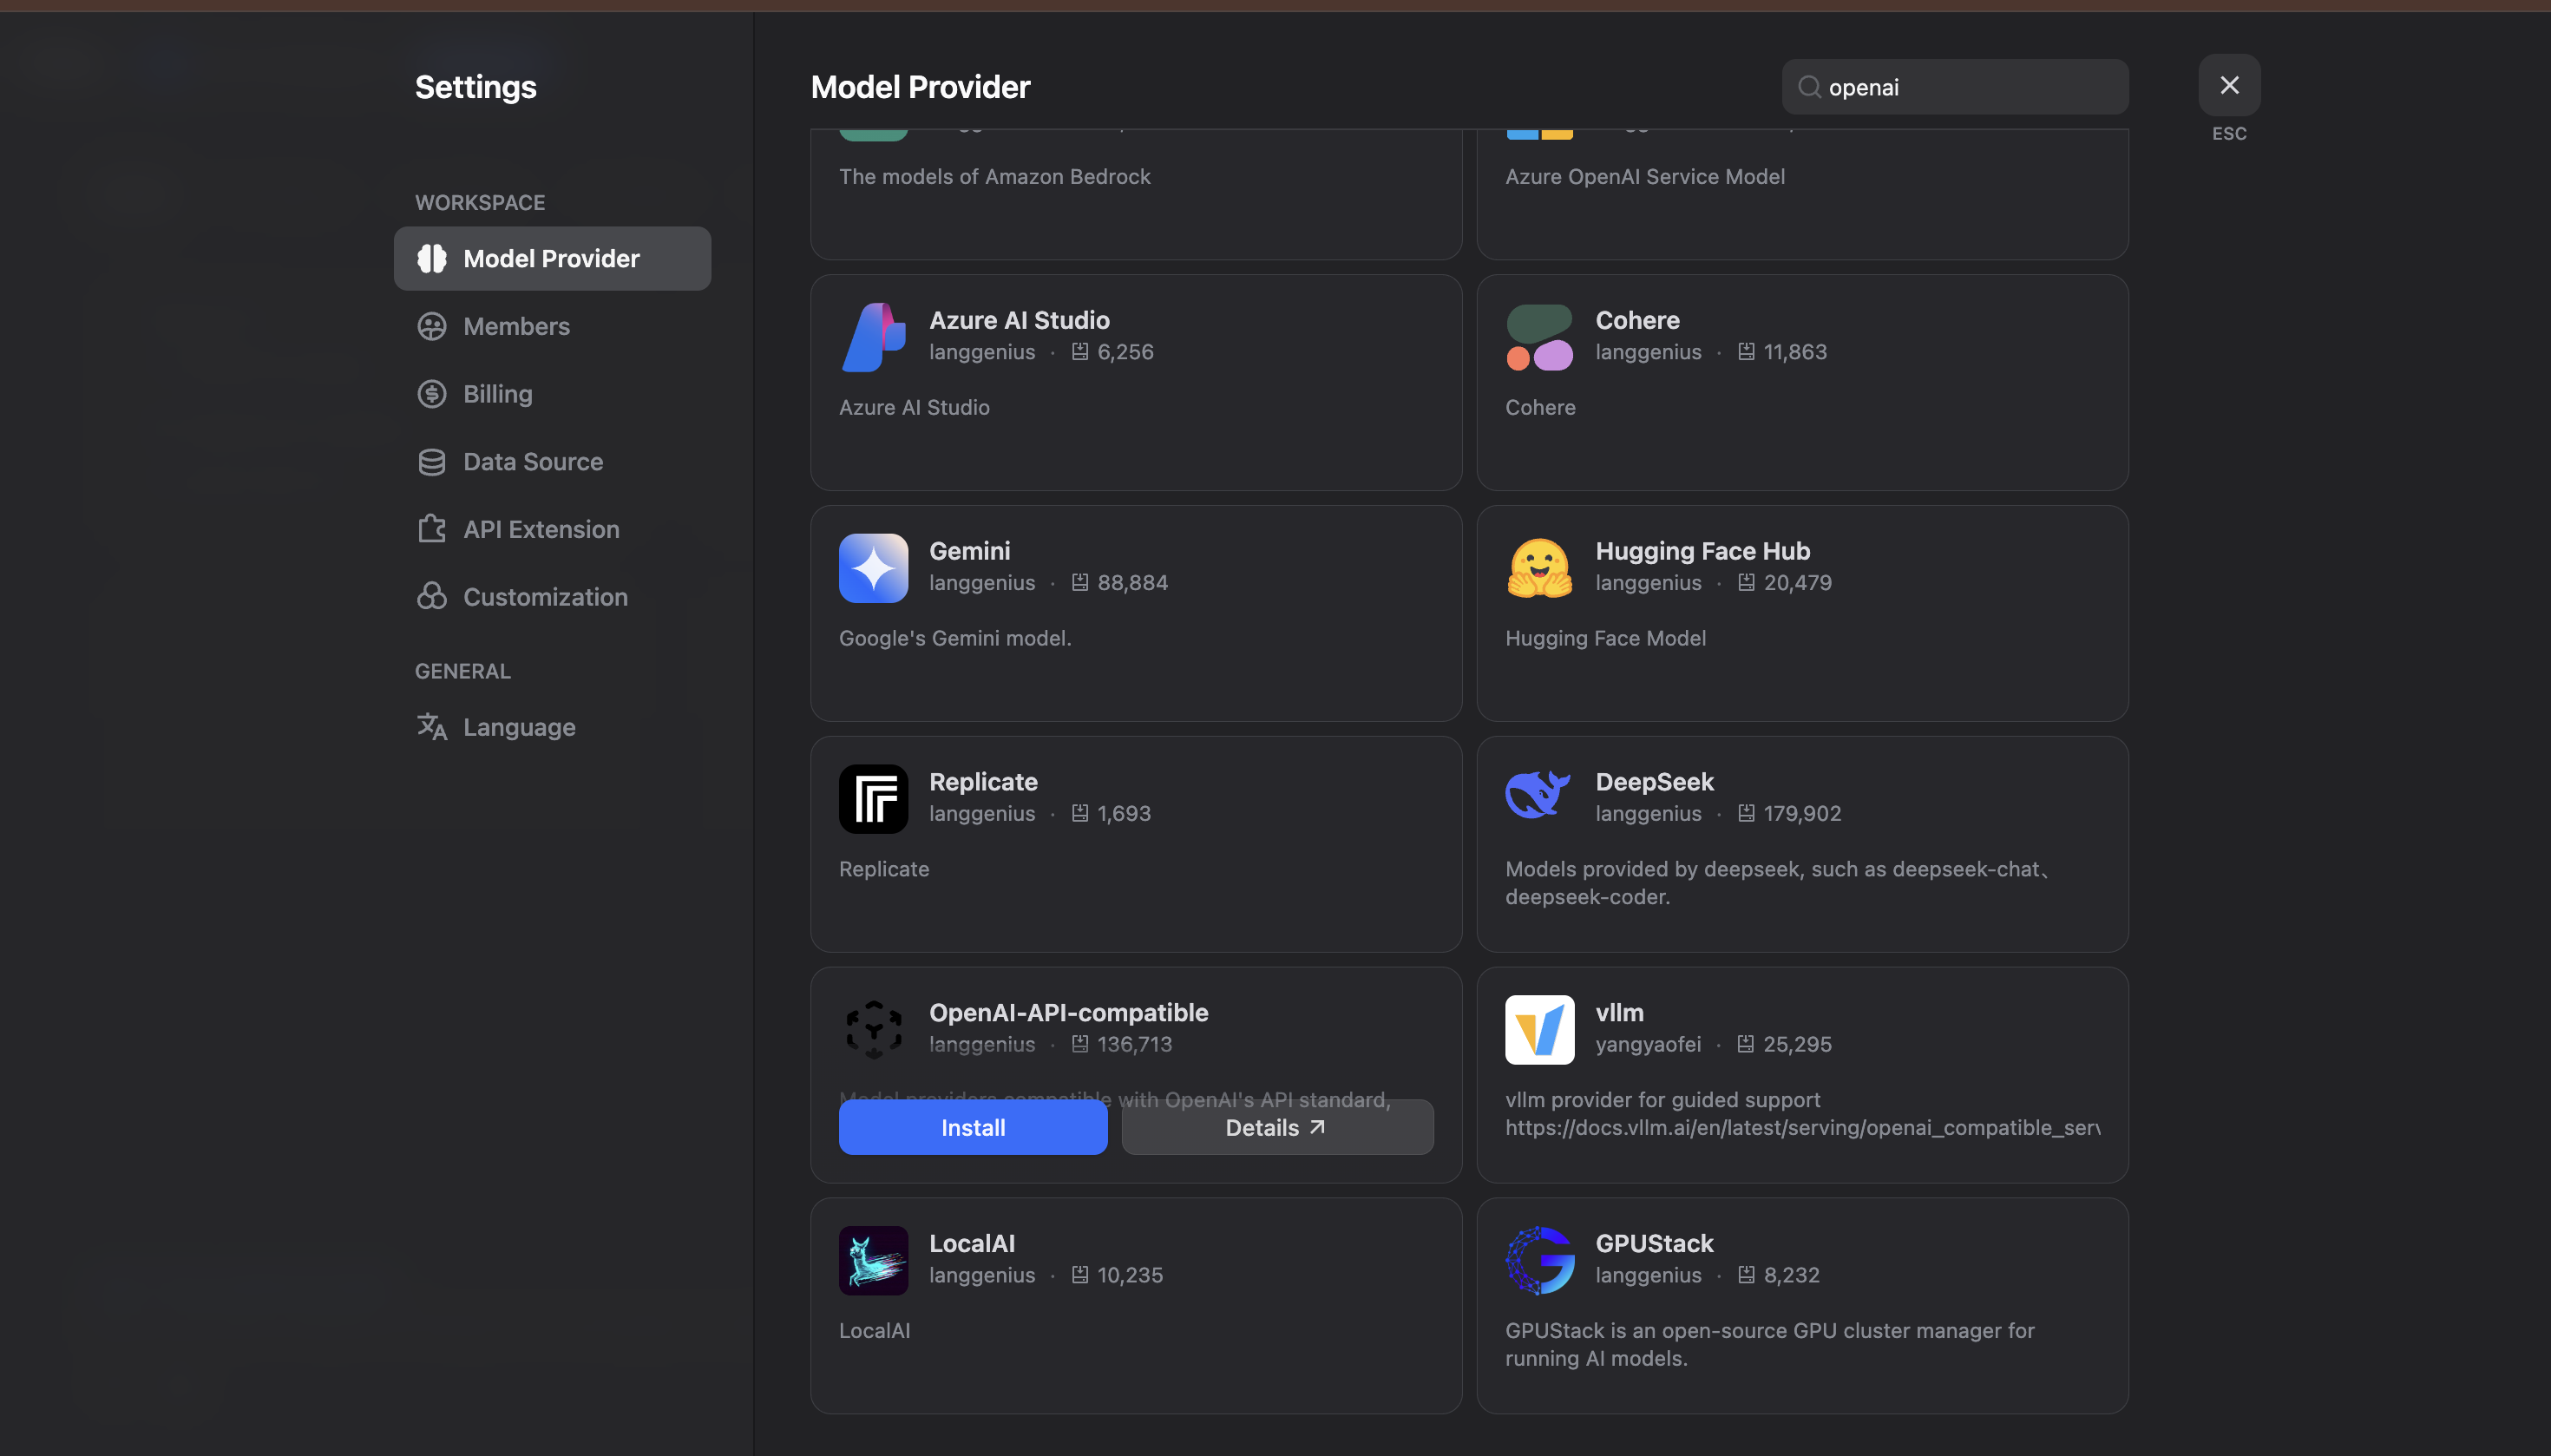
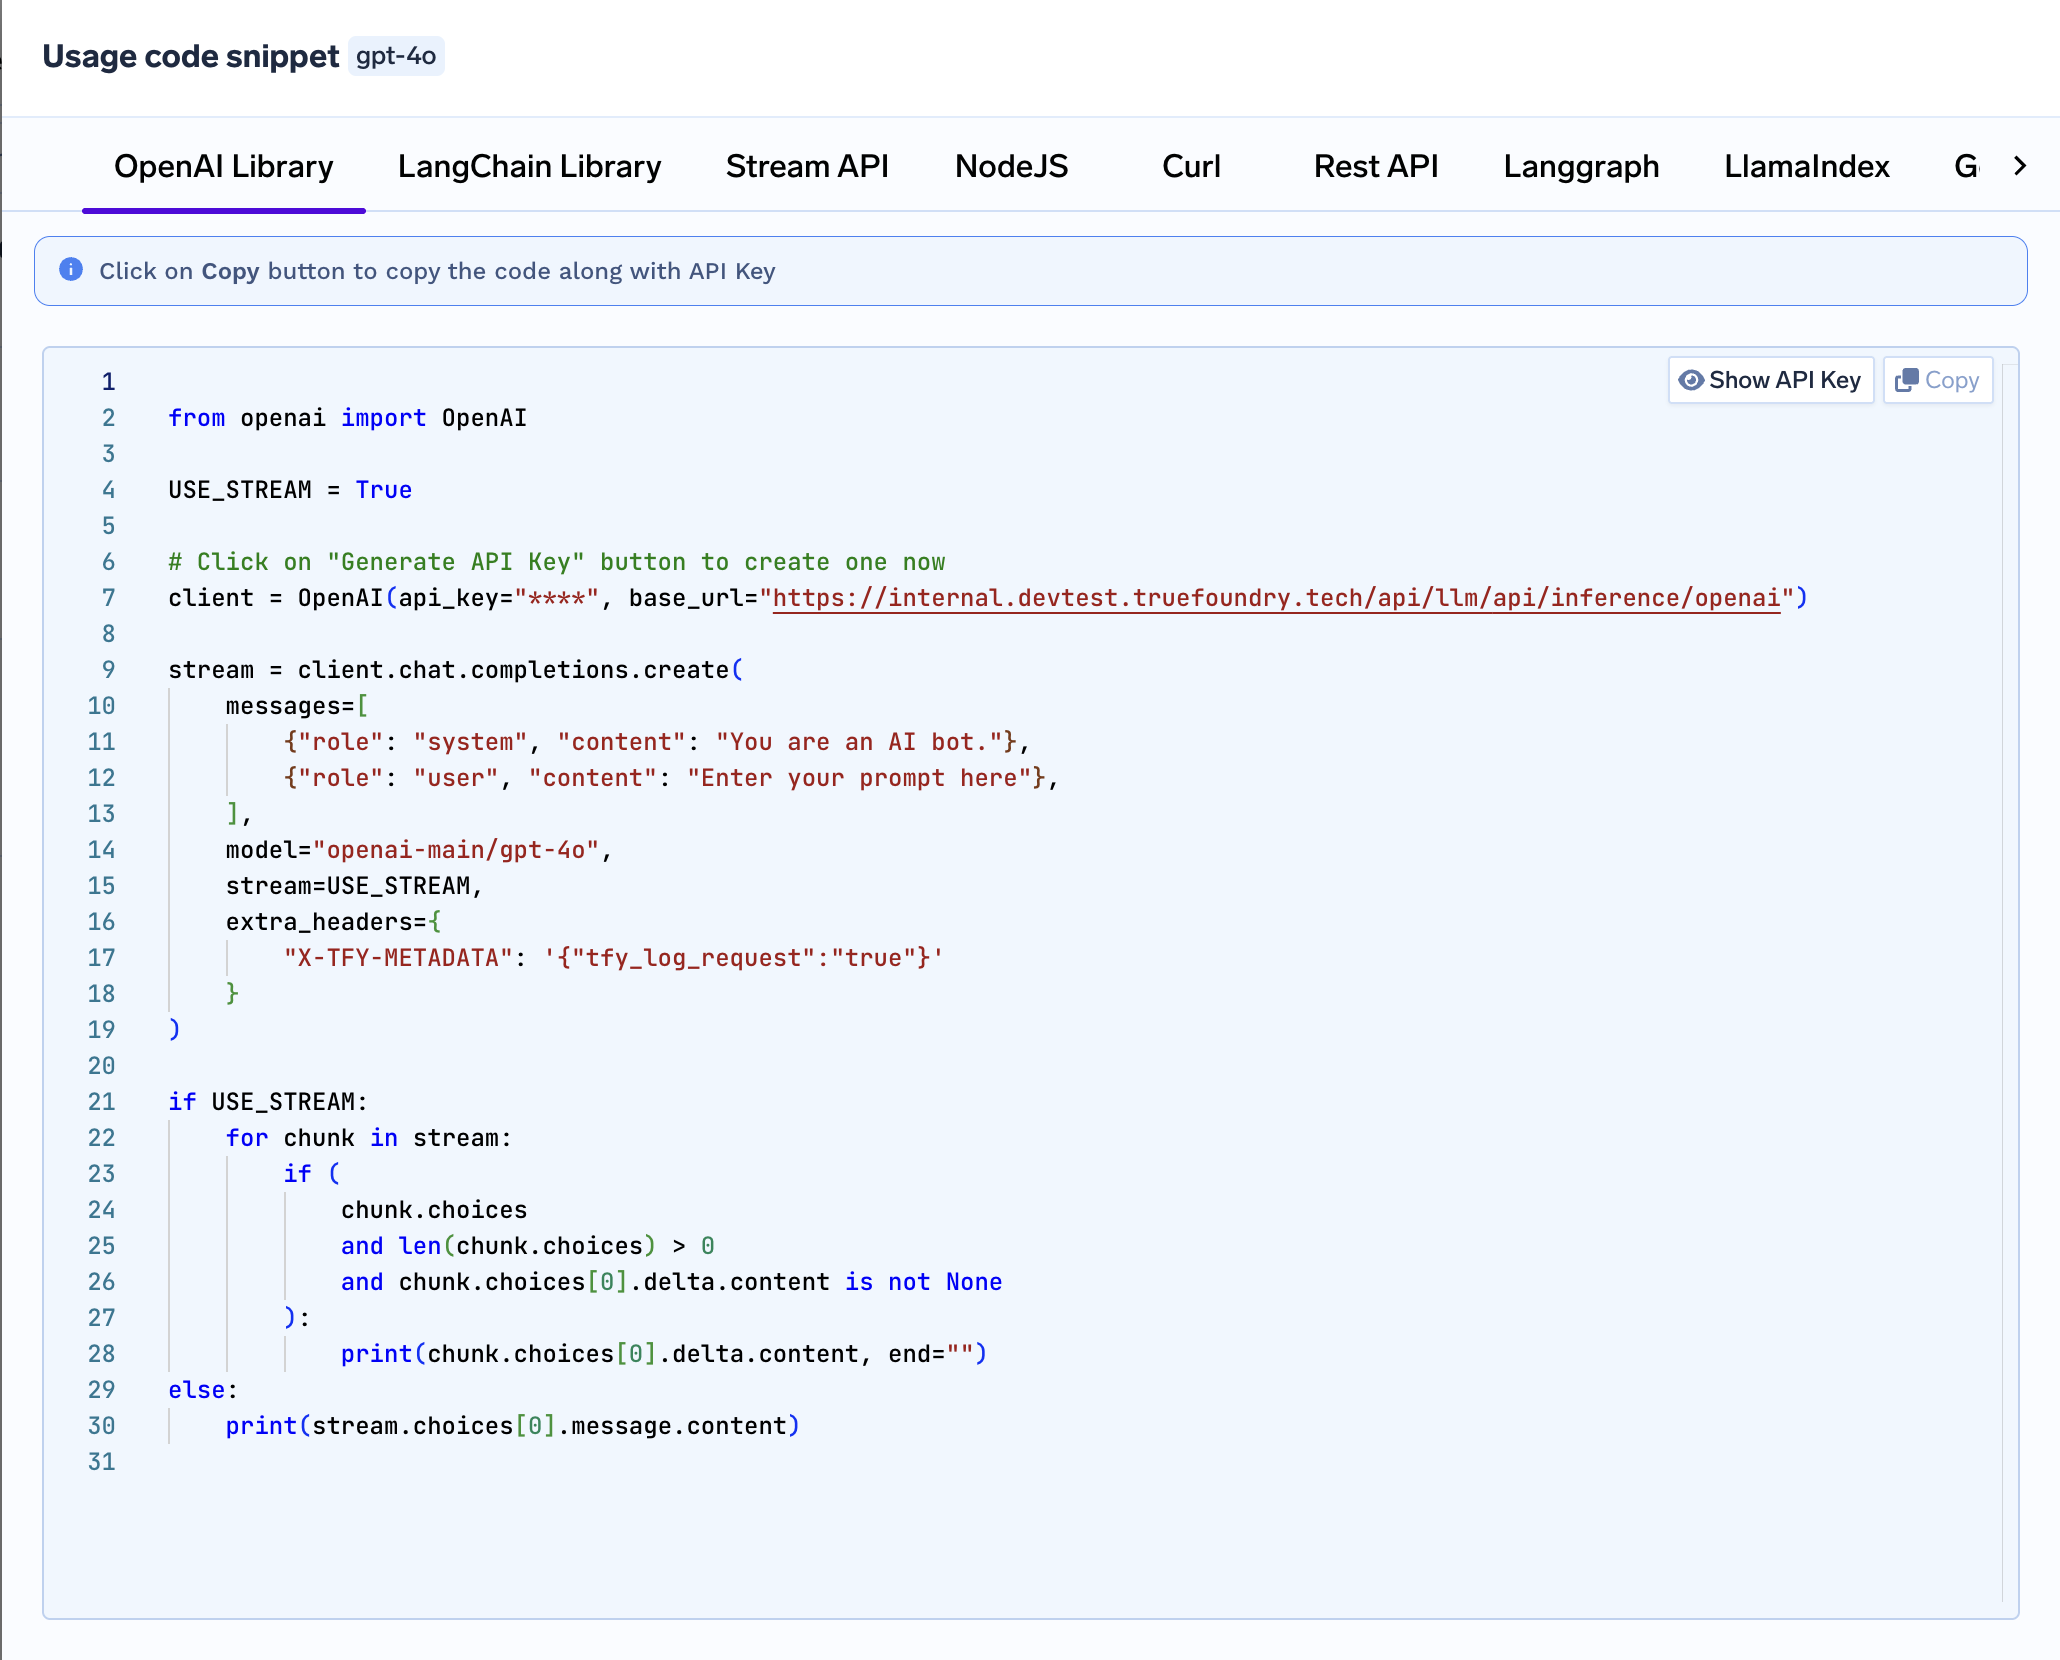
DifyのOpenAI-API互換プロバイダー設定で、以下の情報を入力します:
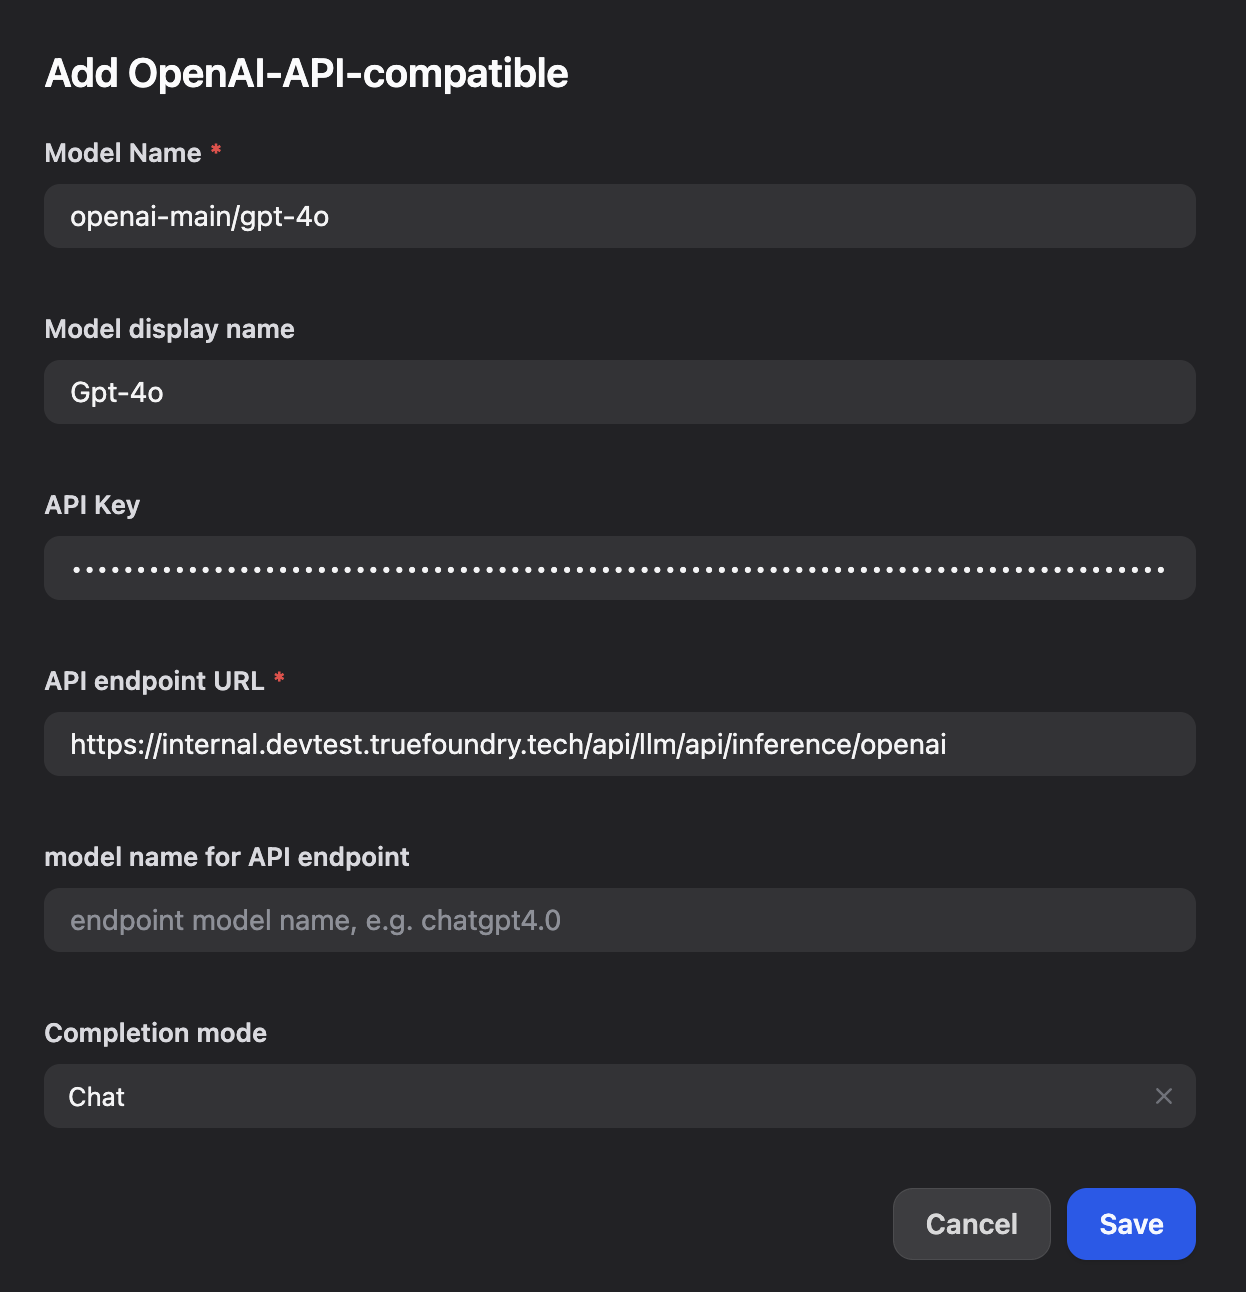
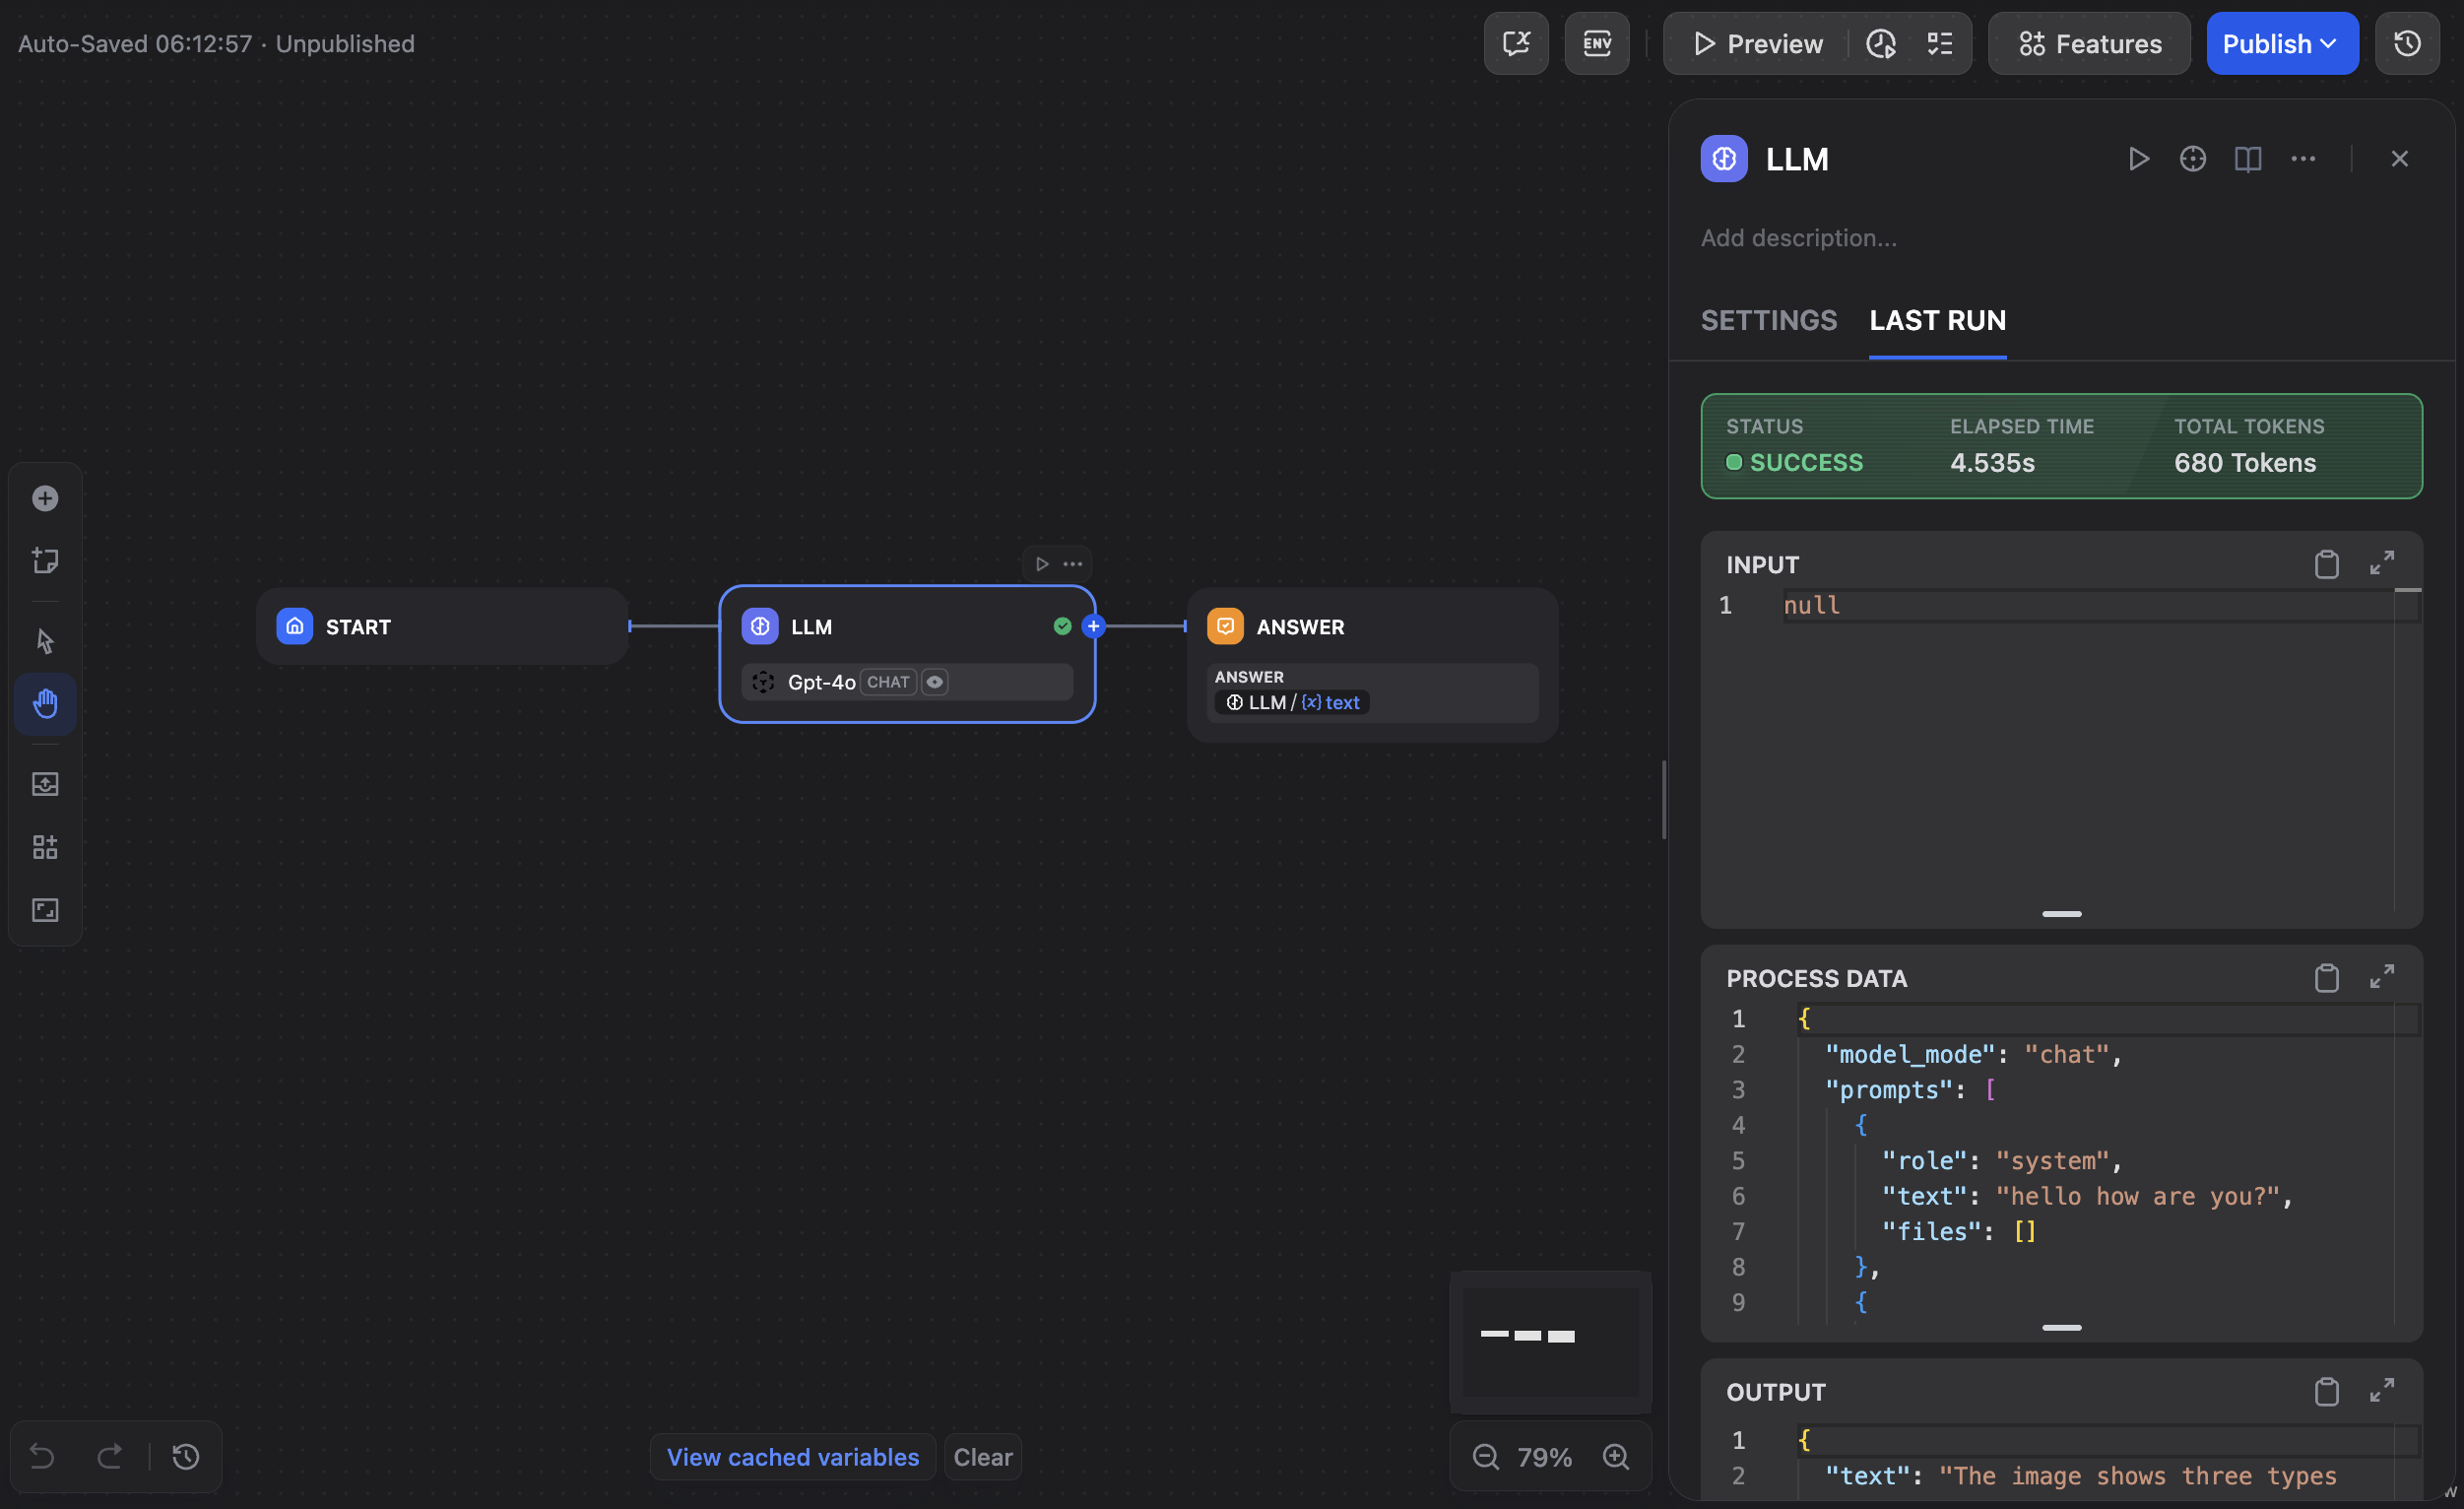
これで完了です。DifyとTrueFoundry AI Gatewayの連携が正常に完了しました。エンタープライズグレードのガバナンスと管理機能を備え、安心して強力なAIアプリケーションの構築を開始できます。
さまざまなタイプのチームがこのセットアップをどのように活用しているかを見てみましょう:
ニュース・コンテンツ作成チーム
Difyを使ったAIニュースボットやコンテンツ生成ツールを構築している場合、gatewayは以下の点で役立ちます:
カスタマーサポートチーム
カスタマーサービスチャットボットの場合:
エンジニアリングチーム
社内AIアシスタントやコード補助ツールの場合:
MLOpsの統合
gatewayは、Dify MLOpsの中核(中枢神経)として機能します。以下の操作が可能です:
Infrastructure as Code(IaC)
本格的なDify AIインフラスタックを運用するチーム向けに、すべてAPI経由で設定可能です:
セットアップの準備はできましたか?以下のクイックチェックリストをご確認ください:
DifyとTrueFoundry AI Gatewayを組み合わせることで、両者の最高のメリットを享受できます:
これは単に2つのツールを接続するだけではありません。実際のビジネス要件に耐えうるAIアプリケーションを構築することを意味します。数千件のカスタマーサポートチケットを処理する場合でも、数百万人の読者向けにコンテンツを生成する場合でも、この組み合わせは確実なスケールを可能にする基礎を提供します。
今すぐ始めましょう。TrueFoundryアカウントを作成し、上記のセットアップ手順とともにクイックスタートガイドに従うことで、約15分で本番環境対応のAIスタックを稼働させることができます。複雑な移行やコードの書き直しは不要です。AIアプリケーションのパフォーマンス、セキュリティ、コントロールを今すぐ向上させましょう。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























