大規模言語モデル(LLM)利用におけるコスト管理は、大規模なAIデプロイを進める企業にとってミッションクリティカルな課題となっています。従来のソフトウェアとは異なり、LLMベースのサービスではトークンベースの課金 (プロバイダーが入力/出力トークンごとに課金する仕組み)が採用されることが多く、予算の予測や制御が困難になります。以下のような複数の要因が、この複雑さを生み出しています:
モデルごとの異なる価格設定: LLMプロバイダー(OpenAI、Anthropic、Cohereなど)やモデルのサイズごとにトークンあたりの単価が異なり、大型モデル(例:GPT-4クラス)は小型モデルよりもトークンあたりのコストが大幅に高くなります。予測不能な利用パターン: トークン消費量はユーザー、機能、ワークフローによって大きく変動します。ある機能が別の機能の10倍のトークンを静かに消費している場合や、ユーザーの行動によって利用量が予想外に急増する場合があります。動的なプロンプトパイプライン: 検索拡張生成(RAG)、ツールを使用するエージェント、マルチステップチェーンなどの高度なユースケースでは、意図せずプロンプトサイズや応答長が膨らみ、クエリごとに必要なトークン(およびコスト)が倍増することがあります。その結果、適切な可視性と管理機能がなければ、請求書が届くまでコストがどれほど急速に蓄積しているかにチームが気付かないことが多々あります。支出が予想外に膨れ上がり 、プロジェクト予算を脅かし、スケールアップの取り組みを妨げることが珍しくありません。最近のGartnerのレポートでも、AIの取り組みにおいてコストの可視性とガバナンスが欠如していると、急速な予算オーバーにつながる可能性がある と警告されています。要するに、企業がLLMを製品に組み込む際、利用コストの管理はモデルの精度や稼働時間と同等に重要です。トークンベースの課金は、アクティブに管理されない限りROIを台無しにしかねない不確実性をもたらします。
ここで登場するのがAI Gateway の概念です。AI Gatewayは、LLMの利用と支出に対するコントロールを取り戻すための主要コンポーネントとして注目されています。コスト要因と対策を詳しく調べる前に、AI Gatewayとは何か、そしてそれがコストにどのように影響を与えるかを定義しましょう。
AI Gatewayとは?(そしてコストにどう影響するか) VIDEO
AI Gateway とは、アプリケーションと複数のAIモデルまたはプロバイダーとの間のすべての相互作用を管理する専門的なミドルウェア層です。AIワークロード専用に構築されたAPI gatewayと考えてください。トークンベースの課金、推論レイテンシ、動的ルーティングなど、モデル固有のニュアンスを理解しています。すべてのAIリクエストに対して統一されたエンドポイントを提供し、コスト、パフォーマンス、可用性のポリシーに基づいて、適切なモデルバックエンドにトラフィックをインテリジェントにルーティングします。
Gatewayを追加すると、ホスティングコストや設定の手間といったわずかなオーバーヘッドが生じますが、それがもたらすコントロールと可視性に比べれば軽微なものです。すべてのリクエストを単一のレイヤー経由でルーティングすることで、組織は利用状況を監視し、予算を適用し、どのモデルが最高のコストパフォーマンスを提供するかをリアルタイムで判断できるようになります。Gartnerは、AI gatewayを、企業がアプリケーション全体でモデルの利用状況を評価・最適化するのに役立つ「インテリジェントなトラフィックコントローラー」と表現しています。
TrueFoundryのAI Gateway
LLM利用における主なコスト要因 本番環境で大規模言語モデルを使用する場合、いくつかの主要な要因がオペレーション全体のコストを決定します。これらの要因を理解することが、LLM関連コストを管理・削減するための第一歩となります:
モデルの選択とサイズ: モデルの選択はコストに圧倒的な影響を与えます。より大きく高度なモデル(パラメータ数が多く機能が豊富なモデル)は、通常、トークンあたりのコストが非常に高くなります。例えば、GPT-4やその他の「推論」モデルは、小型モデルよりもトークン単価が桁違いに高くなることがあります。些細なクエリを含め、すべてのリクエストに最高目方のモデルを使用すると、コストが不必要に膨らんでしまいます。トークン使用量(プロンプトと応答の長さ): プロンプトで送信されるトークン数と応答で生成されるトークン数の合計が、請求額に直接影響します。長い会話やドキュメント、非常に長いコンテキストウィンドウ、無関係な情報を含む最適化されていないプロンプトは、すべてトークン数を増加させます。モデルに長文での回答を求めたり、広範な説明を返させたりする機能は、利用量を飛躍的に増大させる可能性があります。プロンプトを簡潔にし、出力を要点に絞る効果的なプロンプトエンジニアリング を行うことで、コストを大幅に削減できます。1トークンあたり1セントの何分の一かであっても、何百万回も支払うとなると、すべてのトークンが重要になります。トラフィックのボリュームとパターン: AI機能が使用される頻度や範囲がコストに影響を与えるのは明白ですが、単なる総量だけでなくパターンも重要です。スパイク状の予測不能なトラフィックは、ピーク時に予算を突破するコストを発生させる可能性があります。ユーザーや機能ごとのばらつきにより、一部のパワーユーザーや内部ツールが秘密裏にトークンの大半を消費している場合もあります。利用急増(例:新機能のバズ)は、スロットリング(制限)を行わないと想定外の請求につながります。コストの監視体制をスケールアップせずに利用量だけをスケールアップすることは、予算オーバーの要因となります。マルチモデル利用とプロバイダーの選択: 多くのチームがモデルを組み合わせて使用しています。例えば、一部のタスクにはオープンソースモデルを使用し、他のタスクにはプロプライエタリAPIを使用したり、言語ごとに異なるプロバイダーを使用したりします。各モデル/プロバイダーには異なる価格単位(1000トークンごと、リクエストごとなど)があり、追加料金が発生する場合もあります。さらに、「安全のため」にチームが常に最も高額なモデルをデフォルトにしていると、節約の機会を逃してしまいます。タスクごとに適切なモデルを選択すること が、大きなコストレバーとなります。小型(かつ安価)なモデルで十分な場合、単純なクエリに高額な175Bパラメータモデルを使用する必要はありません。逆に、一部の複雑なタスクでは、優れたモデルのコストをかける正当性があります。トラフィックをモデルにルーティングする戦略(またはその欠如)は、大きなコスト要因です。インフラとオーバーヘッド: トークンごとの料金以外にもコストが存在します。APIコストを回避するためにオープンソースLLMをセルフホストする場合、GPUサーバー、メモリ、メンテナンス、MLOpsの手間などのインフラ費用が発生します。ある分析が簡潔に述べているように、「オープンソースLLMは無料ではありません。ライセンス料からエンジニアリング、インフラ、メンテナンス、戦略的リスクへと請求先が変わるだけです。」 クラウドAPIを使用する場合でも、リクエストを処理するための追加インフラ(内部サービスやgatewayの実行、RAG用のベクトルデータベースなど)が必要になり、クラウドコンピューティングコストが発生します。統合のオーバーヘッドやエンジニアリング時間は、忍び寄る「隠れた」コストとなります。ライセンス料またはサブスクリプション料: 一部のモデルやサービスでは、利用料に加えて固定料金が発生します。例えば、特定のエンタープライズAI APIでは、月額サブスクリプションやコミットメントが必要です。オープンソースモデルであってもライセンス制限があり、企業が有料オプションを選択せざるを得ない場合があります。プロプライエタリなモデルサービングプラットフォームを採用する場合、ライセンスコストが発生する可能性があります。これらの費用は特定モデルを使用するための総所有コスト(TCO)に考慮する必要があります。「トークンあたりが安い」モデルであっても高額なライセンスが必要な場合があり、節約効果が相殺されることがあります。統合および非効率によるコスト: 最後に、システムにAIを統合する方法によってコスト効率が低下することがあります。冗長な呼び出し、キャッシュの欠如、不十分な負荷管理はトークンを無駄にします。初期のエンタープライズ採用者たちは、標準的なAPI gatewayやアードホックな統合を使用することが大幅なコストオーバー (初期予測より300%増のケースも)につながることを発見しました。これは、ツール類が類似プロンプトのキャッシュやモデル間のロードバランシングといったAI固有の最適化を考慮していなかったためです。マルチモデルへのアクセスや監視のための独自インフラを構築・維持するにはコストがかかります。各チームが独自にAI APIを呼び出していると、スケールメリットや中央集権的な監視が失われ、総支出が必要以上に高くなることがよくあります(例:複数のチームが同じリクエストで同じモデルを呼び出し、二重に支払うなど)。これらのコスト要因を理解すると、単にチームへLLM APIへのアクセス権を与えるだけでは不十分である理由が浮き彫りになります。多くのアプリやユーザーにわたって管理されていない利用を行うと、ほぼ確実に想定外の事態を招きます。AIの利用がミッションクリティカルで広範になればなるほど、ガバナンスの必要性が高まります。ここでAI Gatewayが真価を発揮します。AI Gatewayはこれらのコスト要因を直接ターゲットにし、パフォーマンスや信頼性を犠牲にすることなくコストを抑制するメカニズムを提供します。
AI GatewayによるLLMコストの管理と削減 AI Gatewayは、上記のコスト要因に対処するためのツール群とスマートな戦略を提供します。すべてのAI利用に対する中央のコストガバナンス層 として機能します。Gartnerによると、AI gatewayはAIの利用者とプロバイダーの間の管理ポイントとして機能することで、「不十分なガバナンスによるAIコストの急増」 のリスクを軽減できます。例としてTrueFoundryのAI Gatewayは、コストを監視・最適化するための多数の機能を組み込んでいます。AI gatewayがLLMコストの管理と削減にどのように役立つか、詳しく見ていきましょう:
一元化されたコストの可視性: すべてのリクエストはgatewayを経由するため、使用されたモデル、消費トークン数、レイテンシ、ユーザー/チームの属性など、各呼び出しの詳細な利用メトリクスが記録 されます。これにより、トークン費用がどこに消費されているかがリアルタイムで詳細に可視化されます。リーダーは「OpenAIの請求額の大半を占めているのはどのアプリケーションやユースケースか?」という疑問に正確に答えることができるようになります。チームがモデルを直接呼び出している場合、このようなクロスアプリでの可視性を得ることはほぼ不可能です。Gatewayを使用することで、AIの利用と支出に関する信頼できる唯一の情報源(Single source of truth) ダッシュボードが得られます。このような透明性によりチャージバック/ショーバック会計(部門へのコスト割り当て)が可能になり、結果としてコスト意識が高まります。予算の強制適用とガードレール: 可視性だけでは十分ではありません。Gatewayは暴走した利用を防ぐためのポリシーも強制適用 します。レート制限やクォータ (例:特定ユーザーや機能に対して1日あたり最大NトークンまたはXドルまで)を定義でき、gatewayはこれを超えるリクエストを拒否または制限します。これにより、1つの誤作動したスクリプトや予期せぬ利用急増によって予算が破綻するのを防ぎます。また、予算アラートや自動停止 ルールを設定することも可能です。チームの月間利用量がしきい値を超えた場合、gatewayが通知を送信するか、承認されるまで一時的に追加の呼び出しを遮断し、予期せぬ請求を防ぎます。さらに、gatewayはアクセス制御とモデル制限 を可能にします。例えば、GPT-4のような高価なモデルは特定の重要なワークフローのみで使用を許可し、重要度の低い用途は安価なモデルに制限するといった運用が可能です。ガードレールのもう1つの形式はプロンプトフィルタリングです。極端に長い応答を引き起こすプロンプトや、その他のコスト効率の悪いリクエストをブロックします。これらのガバナンスルールを中央で適用することにより、組織はコスト露出に対する厳格な制限を作成します。インテリジェントなモデルルーティング: 最大のコスト削減要因は、コンテキストに基づいて各リクエストを最適なモデルまたはプロバイダーに動的にルーティングする gatewayの機能でしょう。一律の対応ではなく、クエリの複雑さ、必要な精度、レイテンシ、コストなどの要因を評価し、最低限のコストでニーズを最も満たすモデルを選択(または自動的に切り替え )します。例えば、簡単な事実に関する質問であれば、顕著な品質の差を生じさせることなく、より小さく安価なモデルで回答できます。一方、複雑なタスクはより強力なモデルに送信されます。このようなリアルタイムのモデル選択 により、過剰なスペックを回避してコストを大幅に削減できます。TrueFoundryのAI Gatewayは、スマートルーティングルール とロードバランシングを介してこれを実現します。例えば、速度と低コストのためにデフォルトのリクエストをMistralのようなオープンソースモデルに送信し、プロンプトが複雑に見える場合や小型モデルの確信度が低い場合には、GPT-4のような大型モデルにルーティングするよう設定できます。数十万件のリクエスト全体で見れば、このアダプティブルーティングにより全体的な品質を維持しながら大幅な削減を達成できます。「高パフォーマンス」か「低コスト」かの二者択一を乗り越え、それぞれの強みが活きる場面で使い分けることで両立 が可能になります。レスポンスのキャッシュ: もう1つのコスト最適化は、繰り返し使われる一般的なAIレスポンスのキャッシュ です。複数のユーザーが同じ質問をしたり、システムが同じクエリを繰り返し実行したりする場合、AI gatewayはモデルを再呼び出しする代わりにキャッシュされた回答を返すことで、トークンを完全に節約できます。高額な中間ステップなどの部分的な結果をキャッシュすることすら有効です。これは、同じプロンプトが頻繁に使用されるバックエンドタスクやアプリで特に役に立ちます。キャッシュはコストを削減するだけでなく、それらのクエリのレイテンシも改善します。TrueFoundryの gatewayは、直接的なキャッシュとより高度なセマンティックキャッシュ の両方をサポートしています。セマンティックキャッシュでは、意味的に類似したプロンプトをキャッシュヒットとして扱うことができます。(プロンプトのわずかな違いで回答が変わる可能性があるため、セマンティックキャッシュは慎重に使用する必要がありますが、適切なシナリオではキャッシュヒット率を高め、コストを削減できます。)研究によると、エンタープライズのユースケースにおいてセマンティックキャッシュ機構によりLLM APIコストを最大70% 削減できたとされています。実際には、同一リクエストに対するシンプルなキャッシュであっても、高トラフィックのアプリにとって大きなコストクッションとなります。オブザーバビリティと異常検知: Gatewayはすべてのリクエストを監視しているため、バグや不正利用を示す可能性のある異常な利用パターンを検知 することも可能です。例えば、今時間のトークン使用量が前時間の5倍になった場合や、1つのアプリケーションが突然大きなプロンプトでモデルへのスパム送信を開始した場合、gateway(および統合ダッシュボード)はその異常を表面化させます。早期検知により、予算を使い果たす前に対処できます。また、オブザーバビリティは信頼性向上にも役立ちます。エラー率やレイテンシを追跡し、コストに関連する低速化とモデル自体の問題を区別するのに役立ちます。TrueFoundryのような一部のgatewayはOpenTelemetryなどのツールと統合されているため、LLMの利用メトリクスを全体的な監視スタックと統合できます。この包括的なオブザーバビリティにより、コストと パフォーマンスの両方の目標を維持できます。また、利用状況が中央でログに記録されるため、AI請求額の担当分について各チームに責任を持たせることができ、効率的な運用の動機付けとなるインナーチャージバックが可能になります。統合された可視性、予算の強制適用、インテリジェントなモデルルーティング、キャッシュ、オブザーバビリティを1つのコントロールレイヤーに組み合わせて、AI GatewayがどのようにLLMコストを管理・削減するかを示しています。
これらすべての機能が組み合わさることで、絶えず手動で監視することなくコスト規律を強制できます。AI gatewayを使用することで、コスト管理はプロアクティブかつ自動的になります 。コスト制限 が設けられているため超過支出が発生せず、利用パターンを調整するためのリアルタイムのインサイト が得られ、自動最適化 (ルーティング、キャッシュ)によって実行時に非効率性が排除されます。不透明で制御不能になりがちなコストセンターを、管理されたユーティリティへと変革します。
TrueFoundryのAI Gatewayは、これらのコストコントロールを実践する代表例です。組み込みのコスト追跡ダッシュボード、予算ポリシー設定、 マルチモデルルーティング ルール、キャッシュ機能 を備えており、すべてエンタープライズに使いやすいインターフェースから設定可能です。その結果、企業は予期せぬ請求を恐れることなく、より多くのAIユースケースを受容する ことができます。もちろん、このようなgatewayの採用にあたってはパフォーマンスとアーキテクチャに関する考慮事項も存在します。次にそれらについて説明します。
コスト、精度、レイテンシ、複雑さのバランス コストを積極的に抑制する戦略は、他の技術的・ビジネス的要件とのバランスを取る必要があります。トレードオフ は避けられません。LLMのデプロイにおいては、コスト、精度(結果の品質)、レイテンシ(応答速度)、アーキテクチャの複雑さという主要な要素のバランスを取ることが重要です。AI gatewayはこれらのトレードオフを管理するのに役立ちますが、適切なポリシーを設定するにはこれらを理解することが不可欠です:
コスト vs. 精度: 高品質なモデルは通常高コストを伴いますが、すべてのタスクがGPT-4レベルの推論を必要とするわけではありません。小型の7Bモデルであっても「フランスの首都は?」という質問にはフラッグシップモデルと同等に正確に答えることができますが、複雑な法的質問には対応できません。重要なのは、gatewayのルーティングインテリジェンス を使用して、最高レベルの精度がその価格に見合う価値があるかを判断することです。日常的なタスクは小型モデルにルーティングし、ハイエンドモデルは複雑な推論のために確保します。時間をかけてアナリティクスを活用することでこれらのしきい値を改良し、許容可能な精度と大幅なコスト削減のバランスを実現します。コスト vs. レイテンシ: 安価なモデルは、特にローカルでホストされている場合、より高速な応答を提供することがよくあります。しかし、ナイーブなマルチモデルルーティングでは、システムが1つのモデルを試した後に別のモデルへフォールバックしようとするとレイテンシが発生する可能性があります。TrueFoundryのGatewayは、レイテンシベースおよび負荷を考慮したルーティング によってこれを軽減し、無駄なホップなしで最速の実行可能モデルにリクエストが流れるようにします。そのアーキテクチャが追加するオーバーヘッドはわずか数ミリ秒(リクエストあたり約3〜4 ms)であり、モデルの推論時間に比べれば無視できるレベルであるため、チームはユーザー体験を損なうことなく効率性を得ることができます。コスト vs. アーキテクチャの複雑さ: AI Gatewayを追加するとインフラの層が1つ増えますが、単一モデルの構成にはない可視性、ガードレール、信頼性ももたらされます。小規模チームやプロトタイプであれば、直接モデルを呼び出すだけでも十分かもしれません。しかし、利用規模が拡大するにつれて、一元化されたルーティング、キャッシュ、コストガバナンスが不可欠になります。結局のところ、これらの要素のバランスを取ることは継続的な取り組みとなります。ベストプラクティスは、コスト削減策がモデルの出力品質やユーザー体験に与える影響を継続的に監視し(gatewayのオブザーバビリティがこれに役立ちます)、それに応じて設定(ルーティングルール、キャッシュ設定など)を調整することです。AI gatewayアプローチの素晴らしい点は、調整可能なこれらの設定が手元にある ということです。一律のモデル利用に固定されることはありません。応答時間であれ回答の精度であれ、アプリケーションにとって最も重要な要素を維持しながら、特定の領域での支出を増減させることができます。
Gatewayを活用したLLMコスト最適化のベストプラクティス AI gatewayから最大のメリットを得るために、組織はテクノロジーと適切な利用戦略を組み合わせる必要があります。パフォーマンスを維持しながらLLMコストを最適化するための実践的なベストプラクティスを以下に示します:
1. プロンプトと出力を最適化する。 2. ハイブリッドモデルルーティングを使用する。 3. 呼び出しをバッチ化・並列化する。 バッチ推論 APIを使用すると、関連するタスクをグループ化できます。これは、大規模なドキュメントセットの要約などの定期的なジョブに最適です。場合によっては、安価なモデルと高額なモデルの両方に並列リクエストを送信し、最初のモデルが満足のいく結果を返した場合には高額な方の呼び出しをキャンセルすることもできます。4. 高頻度のクエリをキャッシュする。 5. モデルをファインチューニングまたは特化させる。 6. オープンソースまたはセルフホスト型モデルの活用。 これらのプラクティスに加えて、常に。Gatewayからのデータを活用して、どの戦略が最も影響を与えているか(例:キャッシュヒット率、ルーティングによって削減されたトークン数など)を確認し、それに応じて調整します。コスト最適化は一回限りの設定で完了するものではありませんが、Gatewayを利用することで、緊急対応的な事態を避け、継続的かつ管理可能な取り組みにすることができます。 コスト追跡とガバナンスに対するTrueFoundryのアプローチ コスト最適化はLLMデプロイメント全体における普遍的な課題ですが、TrueFoundryのAI Gateway LLMコスト追跡ソリューション
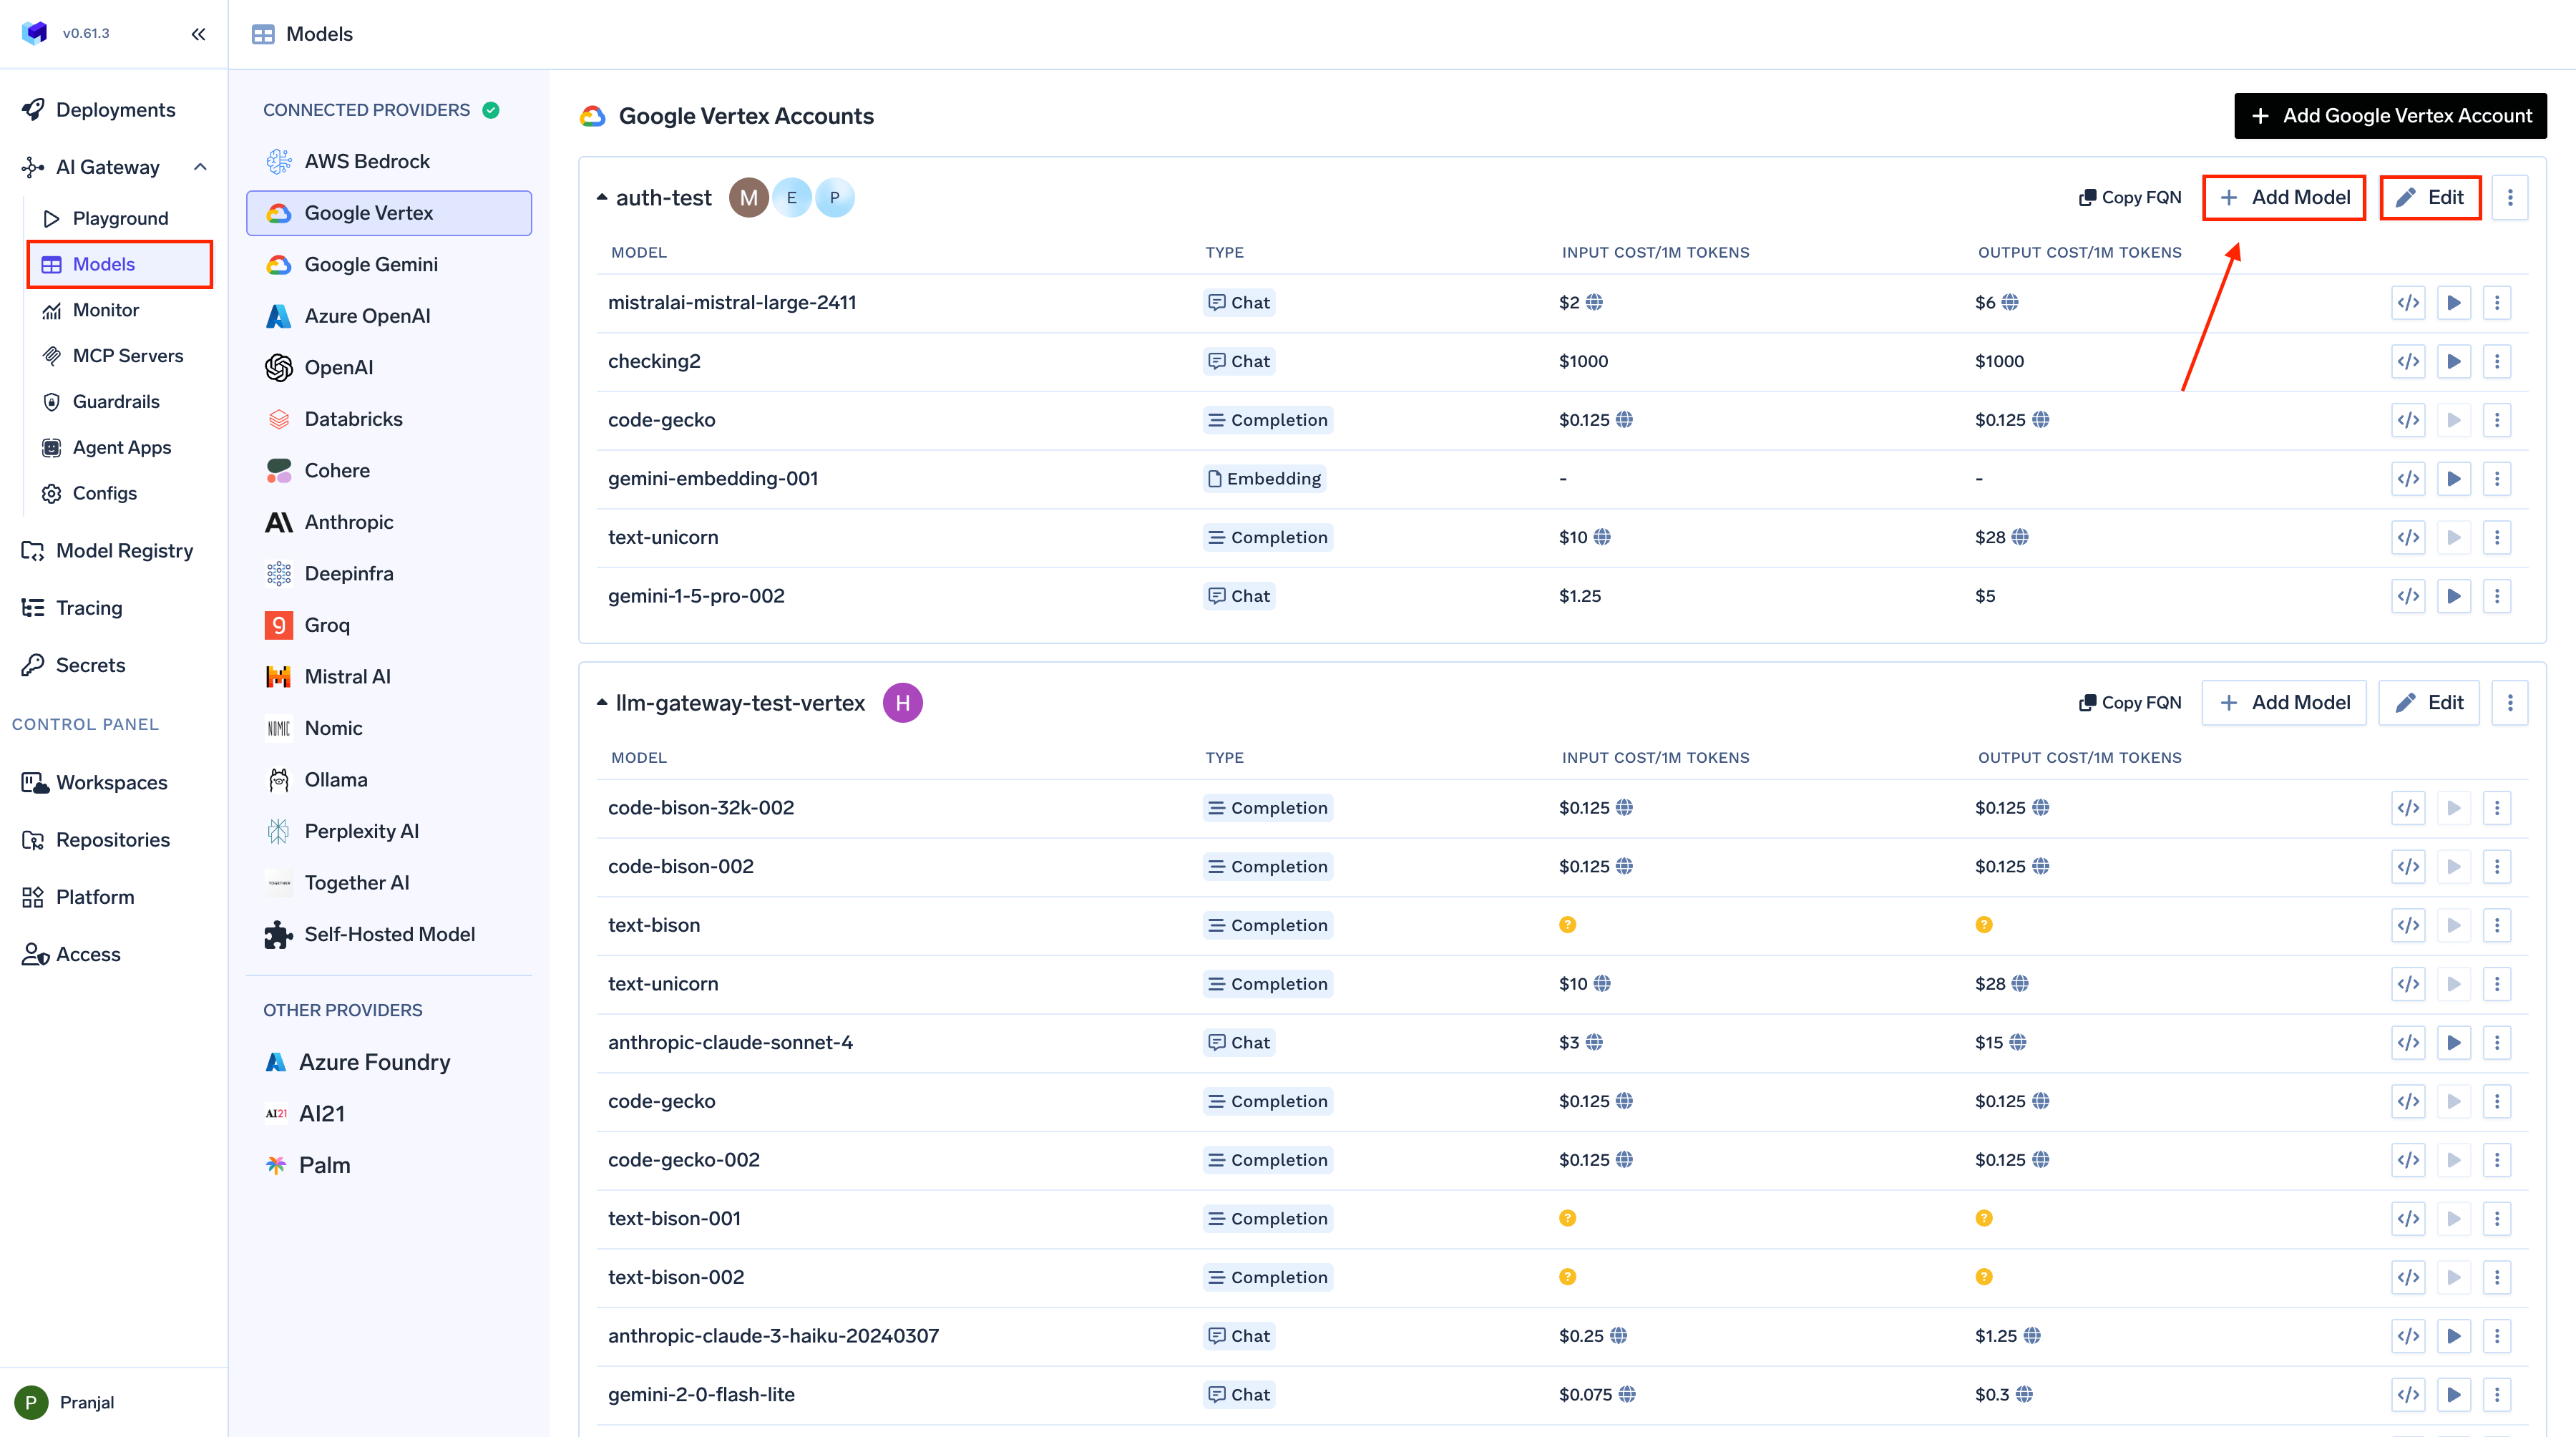
TrueFoundryのモデルコスト設定インターフェース 1. リアルタイムコスト属性 TrueFoundryのGatewayを通過するすべてのリクエストは、自動的にタグ付けされ、価格設定されます 。システムは、入力/出力トークン数と、パブリックAPIからか企業交渉済みのレートからかを問わず、モデル固有の価格設定データ を組み合わせ、インファレンスあたりの正確なコストを計算します。モデル、チーム、環境、またはユーザー ごとにフィルタリングでき、誰が、あるいは何が支出の原因となっているかを正確に可視化できます。これにより、コスト配分、内部チャージバックの実行、またはAI機能のROIの証明が簡単になります。
2. 設定可能なモデル価格と予算 TrueFoundryを使用すると、企業はモデルごとのカスタム価格設定 を定義でき、内部の追跡を実際のプロバイダー契約やセルフホスト型の計算コストと一致させることができます。予算の閾値やクォータ(上限) を作成できます。支出が定義された制限を超えると、Gatewayは手動での介入なしでコスト抑制を確実にするため、自動アラートをトリガーしたり、一時的なスロットリングを実行したりすることができます。
3. 統合されたオブザーバビリティ TrueFoundryはコストと使用状況のデータをPrometheusとOpenTelemetry にエクスポートし、既存のモニタリングパイプラインとシームレスに統合します。これにより、インフラストラクチャおよびアプリケーションのモニタリングに使用されるものと同じダッシュボードに、AIのコスト、レイテンシ、および信頼性のメトリクスを表示できます。単一の統合画面(single pane of glass) が実現します。
4. 設計によるガバナンス(Governance by Design) すべての呼び出しにメタデータタグ付け (チーム、プロジェクト、環境)が含まれているため、組織は部門全体で構造化された責任を実装できます。ロールベースのアクセス制御(RBAC) およびモデルレベルの権限と組み合わせることで、高コストまたはリスクの高いモデルには承認されたチームのみがアクセスできるようになります。手動ではなく自動的 になります。
AI Gatewayの導入が適さない場合 AI Gatewayは大規模環境で計り知れない価値を提供しますが、すべての組織がすぐに必要とするわけではありません。単一のモデルと少ないリクエストボリュームを使用する小規模チームや初期段階のプロジェクトの場合、フル機能のGatewayをデプロイすることは不要なオーバーヘッドになる可能性があります。1日に数千トークンで1つのOpenAIモデルを呼び出すプロトタイプは、直接のAPI呼び出しと基本的なモニタリングで簡単に管理できます。
業界のガイダンスでは、使用量が限定的(月間数万トークン程度)で、コンプライアンスや信頼性のニーズが最小限である場合、軽量なプロキシや手動追跡で十分な場合があると示されています。Gatewayの本当の強みは、ワークロードが拡大するか、モデルやプロバイダー全体で多様化するにつれて現れます。組織がまだLLMの実験段階にあるか、インフラストラクチャが最小限である場合は、まずは反復的な開発に集中しつつ、将来に備えて計画を立ててください。たとえば、TrueFoundryのGatewayは効率的にスケールダウンでき、重いセットアップなしで初期の可視性とガバナンスを提供します。要するに、自社のAIの成熟度とスケール を評価してください。単一モデルで少ボリュームのユースケースでは、Gatewayの導入は時期尚早かもしれません。採用が進むにつれて、コスト管理、信頼性、長期的なガバナンスのために不可欠な存在となります。
まとめ エンタープライズ環境におけるLLMコストの管理は複雑ですが、AI Gatewayはまさにその問題を解決するために構築されています。 コストを運任せにするのではなく、TrueFoundryの
AI Gatewayを使用している企業は、高い信頼性とセキュリティとともに、インファレンスコストが40〜60%削減された と報告しています。特にTrueFoundryのGatewayは、詳細な可視性、コスト属性、チャージバックをチームに提供する設計による責任追及(accountability by design) と、自動化された制限およびフェイルセーフによる大規模でのリスク軽減 を実現します。また、使用パターンに対する完全な透明性 を提供し、コストやレイテンシの問題が見逃されないようにします。
地域やチーム間でポリシーを統合することにより、Gatewayは一貫したガバナンスとコンプライアンスを保証します。これは機密データを扱う業界にとって極めて重要です。その結果、AIプロジェクトは予測可能な支出と運用上の確信を持って実験から本番環境へと移行します。
要するに、AI GatewayはLLMの導入を持続可能なものにします。 トークンベースの価格設定は予測不能かもしれませんが、TrueFoundryの集中コントロールプレーンを使用することで、企業は支出を最適化し、ガードレールを適用し、責任を持って拡張できます。これこそがイノベーションと財政的規律が共存する方法であり、AIをガバナンスの効いた効率的なエンタープライズ対応機能へと変化させます。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.