



November 16, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
ChatGPTのCode Interpreter(現在の「Advanced Data Analysis」)を使って感動した経験は誰にでもあるでしょう。乱雑なCSVファイルをアップロードし、「日付を修正して傾向をプロットして」と依頼すると、リアルタイムでPythonコードが記述・実行される様子を驚かされながら見守ることになります。
これは生産性を飛躍的に向上させる強力な武器です。しかし同時に、機密データを扱っている場合には巨大なセキュリティホールとなり得ます。
CSVをアップロードした瞬間、そのデータは自社の境界線の外へと出ていきます。私たちのチームの目標は、データ流出のリスクを負うことなく、LLM agentにコードの記述と実行の能力を与えるという、この「OpenCode」機能を再現することでした。私たちが求めていたのは「ブラックボックス」なAPIではなく、データに近接した場所で計算が行われるPrivate Code Interpreterでした。
ここでは、TrueFoundryのインフラコンポーネントを使用して、安全なTool Usageおよびコード実行を実装した方法を紹介します。
「OpenCode」は、単にPythonを書けるモデルを用意するだけで完結するものではありません。以下の3つの異なるコンポーネントが連携して動作する必要があります。
多くの人が「Hands」の部分で行き詰まります。本番環境のクラスタ上でLLMに自由気ままにos.system('rm -rf /')を実行させるわけにはいきません。サンドボックスが必要なのです。
TrueFoundryは、サンドボックスとして機能するエフェメラルな実行環境(ServicesまたはJobs)のデプロイを可能にすることで、この問題を解決します。LLM Gatewayがツール定義を処理し、実際の実行はVPC内のロックダウンされたコンテナ内で行われます。
以下は、ユーザーのリクエストが安全なコード実行へと変換されるワークフローです。
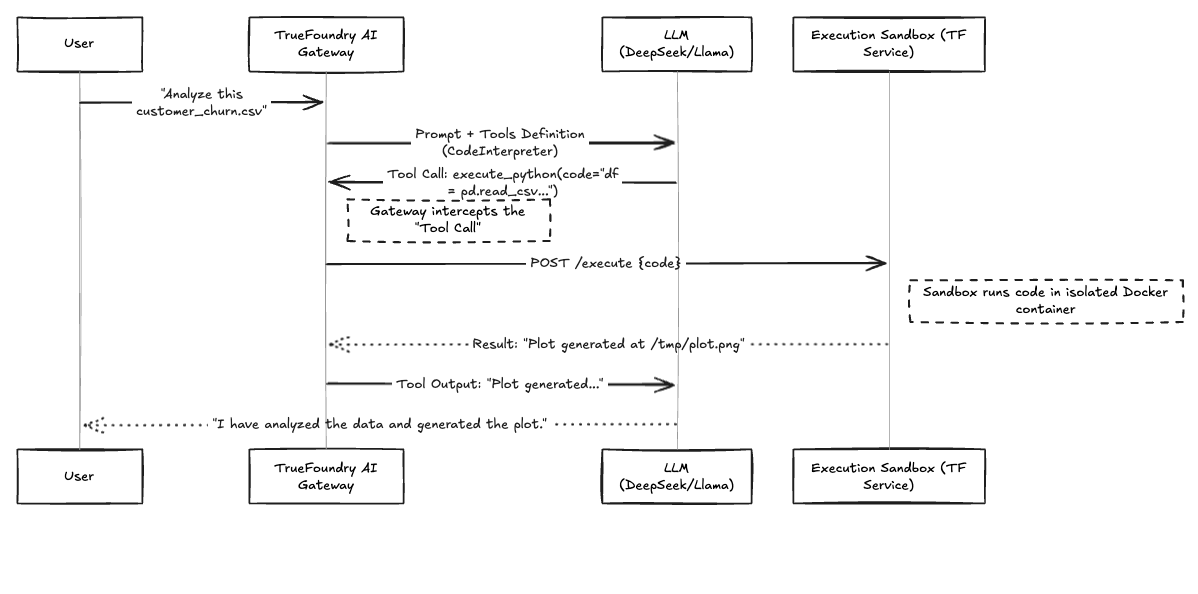
図1: OpenCodeの実行ループのワークフロー
最初にこれを構築しようとした際、私たちは実行環境の複雑さを軽視していました。標準的なSaaSのCode Interpreter APIを使用する場合、データを相手側の企業に送信することになります。ローカルで実行する場合は、ホスト環境が侵害されるリスクが生じます。
私たちはTrueFoundryのServicesを活用して、カスタムの「Code Execution Agent」をホストしています。これは実質的に、以下の機能を備えたDockerコンテナにラップされたPython FastAPIサービスです。
TrueFoundryが基盤となるKubernetesマニフェストを管理するため、デプロイUIやTerraformから直接これらのセキュリティ制約(SecurityContext、NetworkPolicies)を注入でき、サンドボックスが確実に機能することを保証できます。
利便性とコントロールのトレードオフは常に存在します。TrueFoundryを活用して「OpenCode」パターンをオーケストレーションすることで、そのバランスをシフトさせることができます。データリスクを回避しながら、マネージドデプロイメントの利便性を享受できます。
表1: GatewayとSandboxの比較例
本当の価値が発揮されるのは、Tool Usageを自社の内部APIと組み合わせた時です。
私たちはTrueFoundry LLM Gatewayを設定し、「Python Interpreter」ツールだけでなく、内部データレイク用のツール(例: get_user_churn_metrics(user_id))も公開できるようにしました。
LLMはGateway経由でルーティングされ、Gatewayはプライベートサービスに接続されているため、モデルは以下の処理を行えるようになります。
これらすべてのプロセスが、顧客データをプライベートサブネットから一バイトも外に出すことなく実行されます。
「OpenCode」の実装は、単なるハッカソンのアイデアにとどまらず、現代のAI agentにとって必須の要件となっています。しかし、これをLangChainなどで手軽に組み合わせるだけで成功を期待することはできません。
私たちはCode Interpreterをミッションクリティカルなインフラとして扱っています。TrueFoundryの可観測性(observability)スタックを使用して監視し、LLMトークンだけでなく、サンドボックス内のCPUスパイクや実行レイテンシーもトラッキングしています。万が一ユーザーが50GBのRAMを割り当てようとするスクリプトを実行しても、TrueFoundryはクラスタに影響が出る前にPodを破棄し、ユーザーには適切なエラーメッセージが返されます。
これが単なるデモと、真のプラットフォームとの違いです。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.



























