November 16, 2026
|
5 min read


Blazingly fast way to build, track and deploy your models!
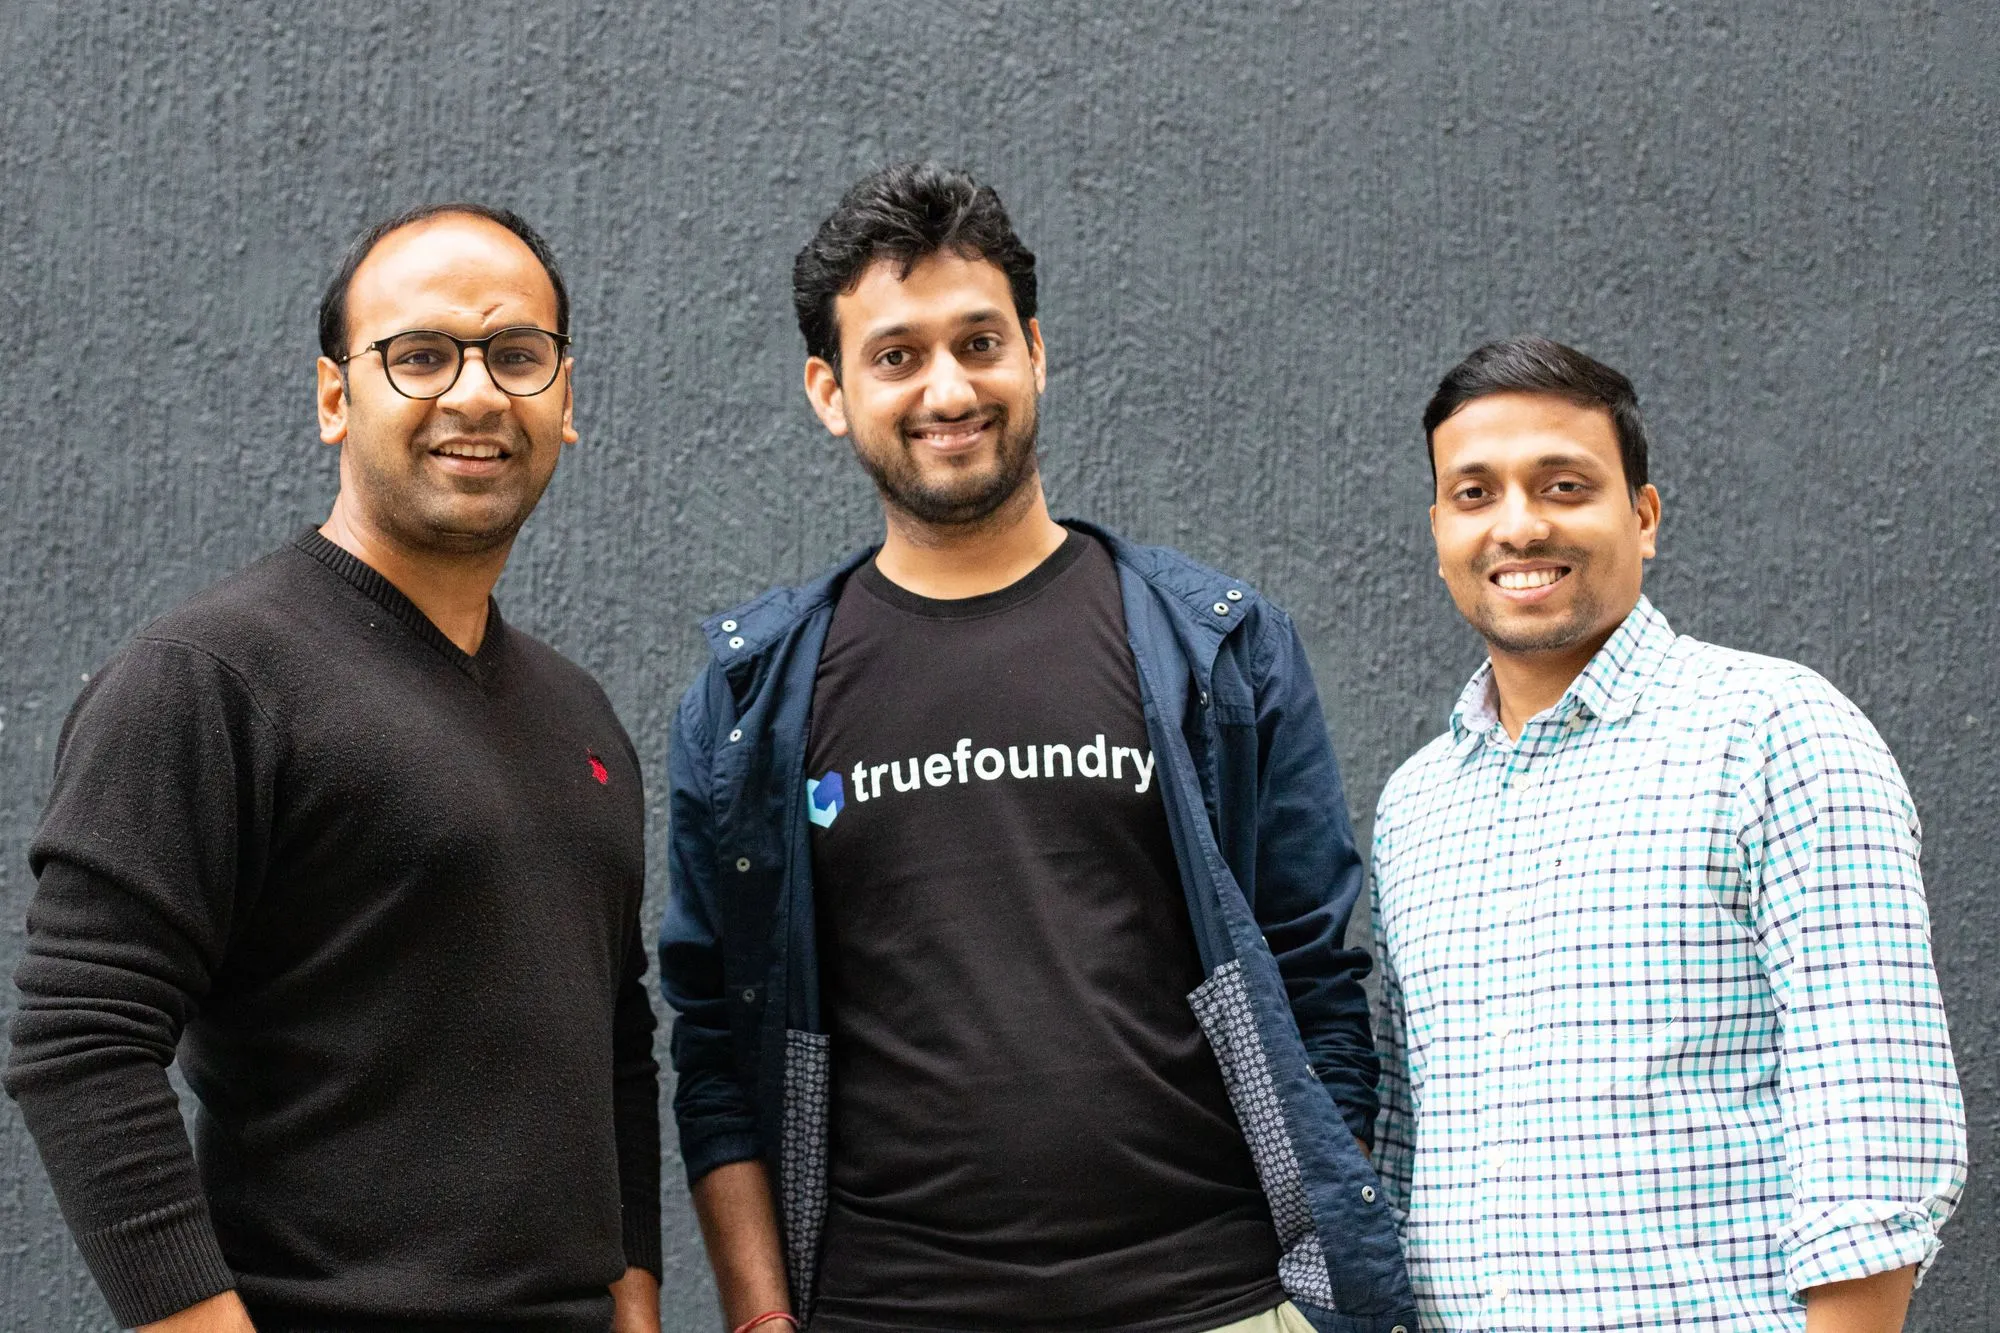
本日、TrueFoundryのジャーニーにおける、願わくばこれから幾多と続くマイルストーンの記念すべき第一歩を世界に向けて発表いたします。当社は、Sequoia IndiaおよびSoutheast AsiaのSurgeが主導し、Eniac Venturesに加え、AngelList共同創業者のNaval Ravikant氏、Deutsche Bank Global CIOのDilip Khandelwal氏、GitHub India責任者のManeesh Sharma氏、Greenhouse Software CTOのMike Boufford氏、Kaggle創業者のAnthony Goldbloom氏などの著名なエンジェル投資家らが参加したシードラウンドで、230万米ドルを調達したことを謹んでお知らせいたします。
この場所に到達するまでに歩んできた道のりを非常に誇りに思う一方で、私たち3人と優秀なチームが真の成功を収めたと言えるようになるまでには、これから歩むべき1000マイルの道のりの最初の大きな一歩にすぎません。「データは新しい石油である」というのは使い古された陳腐な表現になっていますが、それにもかかわらず、誰もがその潜在能力を最大限に引き出せているわけではありません。機械学習はビジネスに莫大な機会をもたらしますが、MLモデルの開発とローンチは、ソフトウェアエンジニア、MLエンジニア、データサイエンティストにとって時間のかかる複雑なプロセスです。その結果、MLモデルのほぼ90%が本番環境に到達せずに終わっています。デプロイまでたどり着いたモデルについても、50%は監視システムの不在によって失敗し、30%はデータのトレーニング段階で見落とされがちなスケーリングやレイテンシの問題により切り戻しを余儀なくされています。大企業であれば、大規模でハイエンドなMLプラットフォームチームを配置してMLモデルを設計・ローンチすることでこのギャップを埋めることができますが、成長途中の企業やスタートアップにとって、会社を構築する中でそれほどの巨額投資を行うことは現実的ではありません。
Facebookでの勤務時代、私たちは市場にある中小企業がビッグテック企業と比較して、機械学習モデルの構築とデプロイに格段に長い時間を要していることに気づきました。そのため、TrueFoundryは「大企業か中小企業かを問わず、いかなるビジネスも機械学習の機会を逃すべきではない」という考えから誕生しました。当社の自動化プラットフォームにより、データサイエンティストやエンジニアはビッグテック企業と同等のスピードと成熟度で機械学習モデルをデプロイできるようになり、本番化までの期間を数週間から数時間に短縮できます。データは新しい石油であり、私たちは企業が機械学習をより迅速に活用し、より大きなビジネス価値を生み出せるようにしたいと考えています。インフラやデプロイメントといったMLパイプラインにおける反復的なタスクを自動化することで、データサイエンティストやMLエンジニアがより価値が高くクリエイティブなタスクに集中できるようにすることを目指しています。これにより、企業は既存モデルを継続的にアップグレードし、新しいモデルをリリースして競合優位性を獲得できるようになります。TrueFoundryは、機械学習の本番化と監視を民主化し、すべての人にポジティブな価値を提供することをミッションとしています。
この結果を達成する上での最大の課題は、ML開発ワークフローの成熟度に応じた、組織ごとの多様な要件です。そして、これこそが既存製品の多くが失敗しているポイントです。例えば、スタートアップが最初のモデルを本番環境に投入しようとしている場合、彼らにとって重要なのはベストプラクティスを気にすることなく、いかに迅速にモデルをデプロイできるかということだけです。一方で、複数のチームで機械学習モデルを構築しているスケールアップ企業は、トラッキング、バージョニング、スケーリング、CI/CD、監視に関するベストプラクティスを重視します。既存製品の多くは、MLデベロッパーにとって設定が複雑すぎるか、成熟した組織にとっては技術的負債が大きすぎるかのどちらかであり、このバランスを取ることに失敗しています。
Amazon Web Services (AWS)、Google Cloud、TensorflowからKubernetesに至るまで、当社のプラットフォームは非依存的(プラットフォームアグノスティック)であり、既存のスタックと簡単に統合してシームレスな実装が可能です。その結果、当社のプラットフォームによってMLチームは10倍の速度向上を実現できます。非常に簡単に使い始めることができ(セットアップ時間は5分未満)、モデルを本番環境に投入できますが、ニーズが成熟するにつれて、プラットフォームに備わっているバージョン管理、監視セットアップ、CI/CD、Auto-scalingなどを迅速に有効化できます。私たちは自社のソリューションを、Herokuのように始めてAWSのようにスケールするものと考えています。
最終的に、これらすべての計画は机上では良く聞こえるかもしれませんが、これらを構築して実行に移すことはまったく別の苦労を伴います。その点において、私たちと同じビジョンを共有する、この領域で最高峰の優秀な人材を集めることができたのは非常に幸運でした。彼らは私たちがビジョンに忠実であり続け、考え得る限りの最高の製品を作り上げることを確実にしてくれています。
このニュースの詳細は以下でもお読みいただけます:
TechCrunch
Economic Times
Business Insider
Inc42
これらの取り組みに興味をお持ちいただけましたか? anuraag@truefoundry.com までお気軽にご連絡ください。お話ししましょう!
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.