



November 6, 2026
|
5 min read

Blazingly fast way to build, track and deploy your models!
モデルそのものが最大の難所となることは、もはや滅多にありません。フロンティアモデルは非常に優秀であり、多くのエージェントワークロードにおいて、モデルの切り替えは設定フィールドを変更するのと同じくらい簡単です。デモで動作するエージェントと、本番環境で3ヶ月経過しても信頼性を維持できるエージェントを分けるのは、モデルの周囲にあるすべての要素、つまりループ、コンテキスト、ツール、サンドボックス、承認、そして取り消不能な操作を防ぐ制御機能です。
このレイヤーこそがエージェントハーネスであり、ここで下す決定は、モデルの選択自体よりも信頼性とコストに大きな影響を与える可能性があります。私たちは、オープンソースのエージェントハーネスであるTrueForgeを構築および運用する中でそのことを学びました。これらは、今日プロダクションエージェントを構築する際に推奨したい10のエージェントハーネスベストプラクティスです。
以下の説明すべての前提となる数値から始めましょう。私たちはDevRevのEnterprise-Benchを使用しました。これは、実際のB2B運用業務のような、さまざまな難易度のシステム横断タスク14個で構成されています。これらに回答するには、エージェントは計画を立て、3つのシステム(SalesforceスタイルのCRM、Jiraスタイルのプロジェクトトラッカー、Driveスタイルのドキュメントおよび通話文字起こしストレージ)にわたるMCPツールを呼び出し、結果を正確に結合し、適切な詳細度で回答を提示する必要があります。
精度は実質的に互角です。モデルが能力の上限を決定するため、ハーネスがベースとなるモデルを賢くすることはありません。
ハーネスが決定するのは、その上限に達するためにどれだけの作業が必要かということです。
このベンチマークにおいて、TrueForgeはClaude Managed Agentsとほぼ同数のタスクを解決しながら、トークン数を約62%削減し、実行あたりのコストを約28%削減しました。deepagentsと比較すると、トークン数の差はさらに大きくなりました。
これは、エージェントインフラストラクチャにおいて見落とされがちな部分です。2つのエージェントが同じモデルを使用し、同じツールへのアクセス権を持ち、同じタスクを実行しようとしても、生成される実行コストには非常に大きな差が生じる可能性があります。
その違いは、モデルの周囲で何が起こるか、つまり、どれだけのコンテキストを保持するか、どのツールをロードするか、大きなレスポンスをどう処理するか、いつ状態を圧縮するか、そしてループをいかに効率的に実行するかによって生じます。
このベンチマークにおけるコスト差のほぼすべては、最初の4つのプラクティスに起因しています。
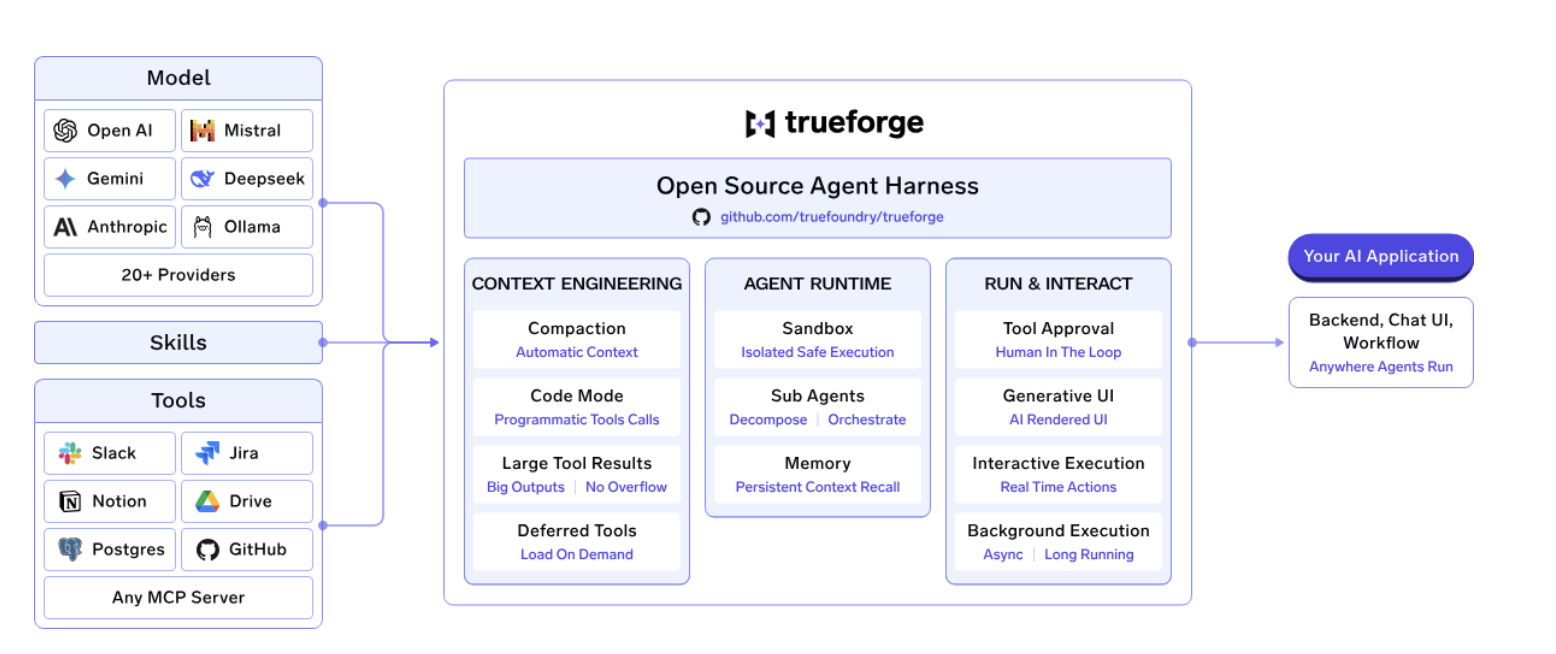
TrueForgeは、本番環境でのエージェントの実行方法をより細かく制御したいチームのための、TrueFoundryによるオープンソースでベンダーニュートラルなエージェントハーネスです。ランタイムを単一のモデルプロバイダーに縛り付ける代わりに、TrueForgeでは独自のモデル、MCPサーバー、インフラストラクチャを持ち込むことができ、エージェントループ、ツール実行、コンテキスト管理、承認、サンドボックス処理をコントロールできます。
Hermesのようなセルフホスト型エージェントが本番インフラの大部分を開発者に委ねるのに対し、TrueForgeはチームや環境にわたってエージェントを運用するために必要な周辺コントロールプレーンを提供します。これには、一元化されたMCPアクセスとクレデンシャル、Human-in-the-Loopでの承認、サンドボックス化された実行、可観測性(Observability)、ガバナンスが含まれます。
npx @truefoundry/trueforgeを使用してローカルで実行することも、Docker ComposeやHelmを使用してチーム用にデプロイすることもできます。
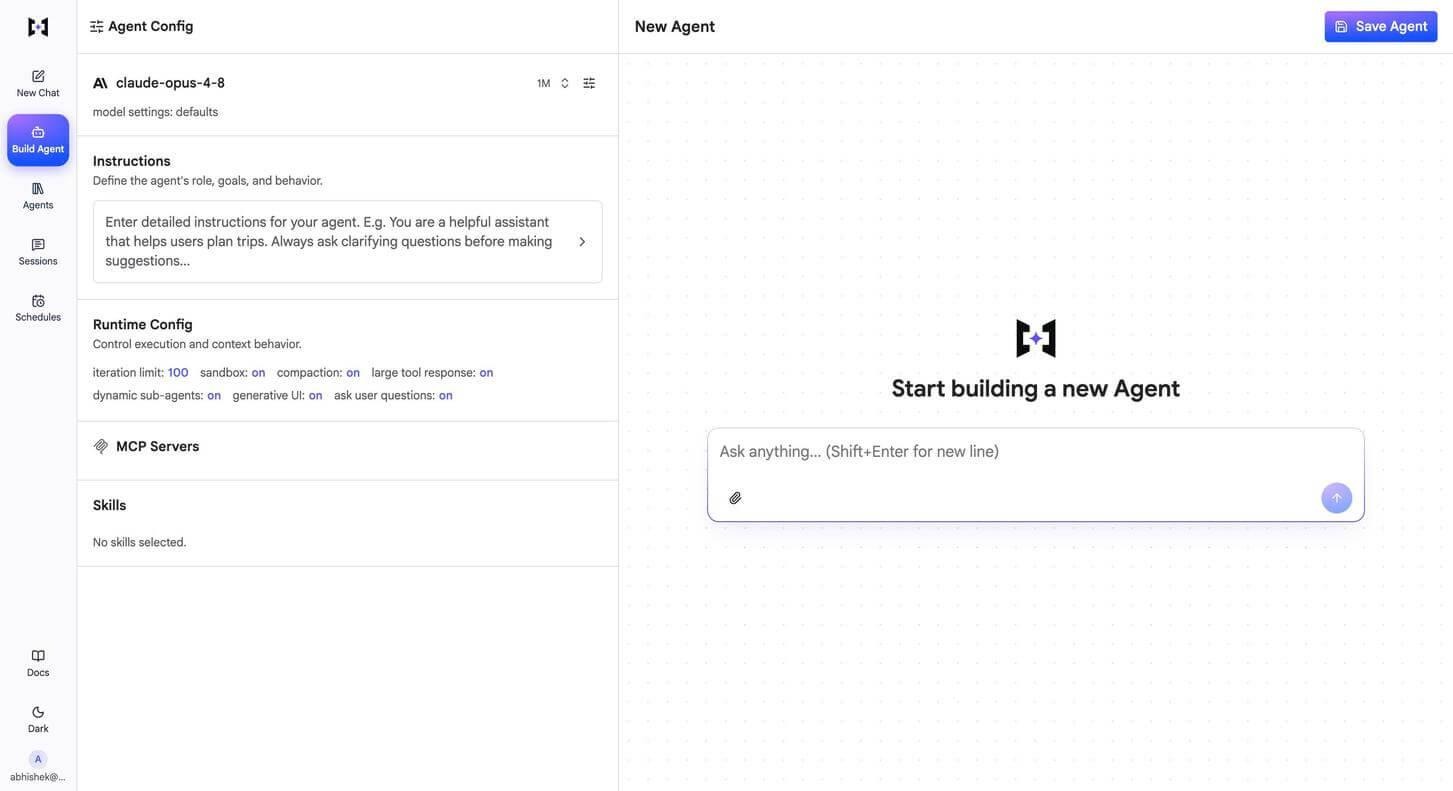
TrueForgeはまた、エージェントランタイムをモデルレイヤーから分離します。これにより、チームはエージェント自体を再構築することなく、モデルを切り替えたり、ワークロードを異なるプロバイダーにルーティングしたりできます。TrueFoundryのAI Gatewayと組み合わせることで、モデルルーティングとコスト制御を適用し、不要なタスクで高価なフロンティアモデルを使用することを回避できます。その結果、完全管理型ランタイムとエージェントインフラ全体をゼロから自作するアプローチの中間に位置する、本番大規模運用のための制御機能を備えたオープンソースエージェントハーネスが実現します。
TrueFoundryはまた、AI GatewayのAuto Routingを通じてモデルコストを削減する第2の手段も提供します。すべてのリクエストをフロンティアモデルに送信する代わりに、Auto Routingは複雑さに基づいてリクエストを分類し、異なるモデルティアにルーティングします。550のプロンプトにわたるTrueFoundryのベンチマークでは、Haiku、Sonnet、Opus間でルーティングを行うことで、ベースラインの品質を98%維持しながらコストを69%削減し、平均レイテンシは7.6秒から4.0秒に低下しました。本番規模のトラフィックでは、全体のコスト削減率は80%に達しました。
これら2つのレイヤーは、コスト方程式の異なる部分に対処します。TrueForgeはエージェント自体の実行オーバーヘッドを削減し、モデルルーティングはタスクに必要ない場合に高価なモデルの使用を回避します。大規模にエージェントを運用するチームにとって、両方の制御機能を持つことはモデル単体の価格よりも重要になる場合があります。
TrueForgeはオープンソースであり、MITライセンスで提供されています。一方、TrueFoundryのAI Gatewayは、個別エージェントから本番環境へ移行する際に必要な運用レイヤー(一元化されたモデルアクセス、バジェット、ガードレール、クレデンシャル管理、統合トレース)を追加します。
Claude Managed Agentsとより柔軟な構成が可能なアーキテクチャを比較している場合、エージェントランタイム自体に加えてモデルの柔軟性、インフラストラクチャの制御、エージェントコストの最適化が重要であれば、TrueFoundryは検討する価値があります。
ここがコストに直結する重要なポイントです。コンテキストエンジニアリングとは、各ターンでモデルに何を見せるかを決定する技術であり、長期間稼働するエージェントではターンを重ねるごとにその影響が蓄積されます。
よくある失敗: 5つのMCPサーバーを接続した結果、起動時にすべてのツールスキーマがロードされ、エージェントは一度も呼び出さないツールの定義のために数万トークンを消費します。その後のすべてのターンがその重荷を引き継ぐことになります。
すべきこと: ツールスキーマは事前ではなく、オンデマンドでロードします。優れたエージェントコンテキスト管理は、ウィンドウが満杯になった後ではなく、最初のモデル呼び出しの前から始まります。
TrueForgeでの対策: 遅延ツールロードにより、エージェントには軽量なインデックスのみを提供し、そのツールを利用しようとした時に初めて完全なスキーマを取得します。
よくある失敗: ウィンドウが満杯になり、ハーネスが最も古いコンテンツを削除した結果、エージェントは3ターン目に与えられた制約を静かに忘れてしまいます。エラーは出ません。ただ精度が低下し、出力が一見もっともらしく見えるため、失敗の特定が難しくなります。
すべきこと: 古い履歴を構造化された記録に要約し、その要約を保持します。圧縮が圧迫下で行われるのではなく、計画通りに行われるよう、限界よりも低いしきい値を設定します。
TrueForgeでの対策: モデルのコンテキスト長の80%で圧縮が実行され、古い履歴が構造化された要約に置き換わります。短いサポートエージェントであれば切り捨てでも問題ありませんが、数時間に及ぶタスクでは致命的な悪影響を及ぼします。
知っておくべき注意点が1つあります。ポリシーや制約が会話の中にしか存在しない場合、圧縮自体にリスクが伴います。圧縮がどのようにガバナンスを損なうか、そしてなぜ強制力をコンテキストウィンドウの外に置くべきなのかについて解説した記事をご参照ください。
よくある失敗: ツールが200KBのJSONペイロードを返し、そのすべてがコンテキストウィンドウに入り込みます。しかし、エージェントが必要としていたのはその中の3つのフィールドだけでした。
すべきこと: ペイロードをエージェントがアクセスできる場所に書き込み、内容そのものではなく参照を渡します。
TrueForgeでの対策: 大きなツールレスポンスのオフロード機能により、レスポンスをサンドボックスファイルに書き込み、パスとプレビューに置き換えます。Code Modeはさらに進んでおり、エージェントが1つのサンドボックススクリプト内で複数のツール呼び出しを連携させ、出力された結果のみをコンテキストに入力できます。5回の往復が1つの要約にまとめられます。
よくある失敗: サブエージェントが親のスレッド全体を継承して作業を行い、推論トレース全体を親のコンテキストに返します。その結果、同じ履歴に対して二重にコストを支払い、メインスレッドを汚染することになります。
すべきこと: 委譲によって親のコンテキストは拡大するのではなく、縮小すべきです。
TrueForgeでの対策: サブエージェントは自身のクリーンなコンテキストで実行され、結果のみを返します。
試してみる: npx @truefoundry/trueforgeを使用すると、これら4つすべての機能をデフォルトで有効にしたハーネスを、ローカルで約1分で実行できます。GitHubでStarを付ける。
よくある失敗: エージェントがコードを実行するかどうかに関わらず、ハーネスがすべてのセッションをコンテナでラップします。テキストのみの会話に対してもコンテナの実行費用を支払うことになり、1台のサーバーでホストできる並行エージェントの数が大幅に減少します。
すべきこと: エージェントが実際に何かを実行する必要が生じた時にのみ、サンドボックスをプロビジョニングします。エージェントのサンドボックス化は影響範囲の隔離が目的であり、毎ターンコストを支払うことなく同じ隔離レベルを得ることができます。
TrueForgeでの対策: サンドボックスはツールとして扱われ、エージェントがコードを実行する必要がある場合にのみ起動されます。そのため、1台のサーバーで多くのエージェントを処理でき、コードに触れないターンは安価に抑えられます。サンドボックスプロバイダーは自由に持ち込み可能です。
ゼロから設計する場合は、モデルを自由に徘徊させずに実行させる方法についての詳細な考察を一読する価値があります。
よくある失敗: チームは承認に対して2つの極端なアプローチのいずれかを採りがちです。何も制限せず、最終的にエージェントがデータを削除してしまうか、すべてを制限し、人間が読むのをやめるまで1時間に40回も承認をクリックさせられるかのどちらかです。
すべきこと: 不可逆性に基づいてゲートを設定します。メールの送信、本番環境への書き込み、金銭の消費、データの削除などです。読み取りや下書きは制限なしで実行させます。また、システムプロンプトにコンプライアンス要件を記述して成功を祈るような実装は避けてください。プロンプトは単なる提案に過ぎませんが、すべてのツール呼び出しを検査するガードレールは確実な制御手段です。
TrueForgeでの対策: コアサーバーは実行を一時停止し、呼び出しが送信された後ではなく、送信される前に機密性の高いアクションに対する承認を待ちます。
そのゲートがどこに存在するかも、ゲートが存在するかどうかと同様に重要です。これについてはゲートウェイ境界でのMCPツール承認の設計で解説しています。
よくある失敗: ノートPCがスリープ状態になったり、ロードバランサーが接続をリサイクルしたりすることで、40分間のエージェントの作業が消失します。1時間稼働するタスクでは、これはもはや例外的なケースではありません。
すべきこと: 接続が切断されても再起動するのではなく再開できるように、セッション状態を永続化します。
TrueForgeでの対策: セッションは再接続や再起動を挟んでも維持されます。再開可能性(Resumability)は、設計レビューでは誰も求めないものの、運用2週間目には誰もが必要とする性質の代表例です。
よくある失敗: モデル呼び出しごとのトークン数とレイテンシは把握できているものの、60ステップの実行のうちどのステップで問題が発生したのかが全く分かりません。デバッグがまるで考古学のようになってしまいます。
すべきこと: すべてのステップで構造化イベントを発行し、実行結果がログの山ではなくタイムラインとして参照できるようにします。深刻なデバッグに直面する前に、ループ自体が観察可能(Observable)であることを確認してください。
TrueForgeでの対策: すべてのステップがリアルタイムでストリーミングされ、エージェントイベントランタイムコントラクトが公開されているため、独自のツールで利用することができます。
ループエンジニアリングの考え方はここでも役立ちます。ループはミドルウェアであるため、インフラストラクチャとして扱う必要があります。
よくある失敗: エージェントが特定のプロバイダーのSDKや癖に依存して記述されています。より安価で優れたモデルが登場しても、切り替えにコードの書き換えが必要となるため、切り替えを諦めてしまいます。
すべきこと: OpenAI互換のインターフェースを介してモデルと通信し、プロバイダー固有のロジックをエージェントのロジックから排除します。
TrueForgeでの対策: モデル、MCPサーバー、サンドボックスプロバイダーはすべてオープンなインターフェースを介して持ち込み可能です。これは機微な価値ではありません。同じベンチマークで、Opus 4.8の代わりにGLM-5.2でTrueForgeを実行した場合、実行あたり$8.50に対して$2.90で同じ14個中約11個のタスクを解決しました。このようなコスト削減は、切り替えが設定変更だけで済む場合にのみ実現可能です。
よくある失敗: 各チームが独自にモデルキーやMCPクレデンシャルを保持しています。誰も支出を上限設定できず、PIIマスキングも不統一で、監査の質問に答えるために9つのサービスからログを継ぎ接ぎしなければなりません。
すべきこと: エージェントと呼び出し先のすべてのリソースの間にゲートウェイを配置します。
TrueForgeでの対策: これは意図的にハーネスの役割から除外されています。セルフホストの場合、キーの持ち込みと管理は自分で行う必要があり、これは少数のエージェントを運用している間は機能します。しかし多数のエージェントを運用する段階になったら、TrueFoundryのAI Gatewayに接続してください。これにより、単一のvCPU上で約3〜4msの追加レイテンシと350+ RPSの性能を維持しながら、1,000以上のLLMを1つのOpenAI互換APIの背後に集約し、RBAC、バジェット、ガードレール、クレデンシャルのローテーション、Grafana/Datadog/PrometheusへのOpenTelemetryトレースを提供します。
多数のエージェントを運用していますか? AI Gatewayがどのようにそれらを一元管理するかを見るか、ご自身の構成に合わせた導入をご希望の場合はウォークスルーをご予約ください。
10個中9個の機能はハーネス内に備わっています。10番目の機能は意図的に除外されています。コントロールプレーンも兼ねようとするハーネスは、結果として両方の機能で不十分になりがちだからです。
既存のループを再構築すること。 Plan-Act-Observeのループをゼロから書いている場合は、既存のハーネスがそれをすでに提供していないか確認してください。エージェントハーネスの自作に時間をかける価値があるのは、固有の特殊な課題がある場合のみです。
プロンプトのみで制御しようとすること。 コンプライアンスステップ、支出上限、承認ゲートはコードまたはゲートウェイレベルで実装すべきです。丁寧に依頼して従うモデルは、誘導によって簡単に言いくるめられてしまいます。
すべてをサンドボックス化すること。 すべてのターンで分離環境を維持することは無駄なコストを生み出し、コードを実行しないターンでは何のメリットももたらしません。
実行全体ではなくモデル単体で測定すること。 タスク完了あたりの総コストが静かに3倍に膨れ上がっている一方で、呼び出しごとのトークン数は問題ないように見えることがあります。実行全体を測定してください。
Q: エージェントハーネスのベストプラクティスとは何ですか?
A: 最も重要なのはコンテキストに関するプラクティスです。ツールスキーマをオンデマンドでロードし、履歴を切り捨てるのではなく圧縮し、大きなツールレスポンスをファイルにオフロードし、サブエージェントのコンテキストを親から分離することです。その上で、コード実行時のみサンドボックスをプロビジョニングし、不可逆なアクションをゲート化し、再接続を跨いでセッションを永続化し、全ステップで構造化イベントを発行します。私たちのベンチマークでは、これらの決定により同一タスクにおける実行あたりのトークン数に4倍以上の差が生じました。
Q: 長時間のタスクでエージェントのコンテキストが不足するのを防ぐにはどうすればよいですか?
A: 切り捨てではなく圧縮を使用します。モデルのコンテキスト長の80%程度のしきい値で古い履歴を構造化された記録に要約し、エージェントが文脈を静かに失うことなく把握し続けられるようにします。これに加えて遅延ツールロードとレスポンスオフロードを組み合わせることで、そもそもウィンドウが埋まる速度を遅くすることができます。
Q: すべてのエージェントセッションをサンドボックス化すべきですか?
A: いいえ。セッション全体ではなく、コード実行をサンドボックス化してください。会話全体でコンテナを開いたままにすると、コードを実行しないすべてのターンで費用が発生し、1台のサーバーで処理できるエージェント数が制限されます。オンデマンドでのプロビジョニングにより、わずかなコストで同等の隔離レベルを実現できます。
Q: 自社のVPCやオンプレミス環境でエージェントハーネスを実行できますか?
A: はい、セルフホストオプションを利用可能です。TrueForgeはローカルで単一のnpxコマンドから実行できるほか、Postgres、Redis、レプリカ、OIDCログインを備えたチームデプロイ用のDocker ComposeやHelmを介してデプロイできます。TrueFoundryの管理プラットフォームもセルフホスト、オンプレミス、エアギャップ、ハイブリッド環境で動作するため、データが自社のドメイン外に出ることはありません。
Q: TrueFoundryはMCPや他のフレームワークのエージェントをサポートしていますか?
A: はい。プラットフォームにはMCP Gateway、Agent Gateway、ツールレベルのアクセス制御を備えたレジストリが含まれています。LangGraph、CrewAI、AutoGen、またはカスタムフレームワークで構築されたエージェントも同じレイヤーを通じてガバナンスを適用できるため、これらのプラクティスを導入するために単一のスタックに絞り込む必要はありません。
エージェントハーネスのベストプラクティスは、1つの習慣に集約されます。モデルが何を見て何を行うことが許可されているかを意図的に決定し、個別呼び出しではなく実行全体を測定することです。これを実践するチームは、コストを4分の1に抑えつつ、原因を診断可能な形で失敗を制御できるエージェントを構築しています。
数値について私たちの言葉をそのまま鵜呑みにする必要はありません。TrueForgeはMITライセンスで提供されており、ベンチマーク手法も公開されているため、独自のタスクに対して実行して確認することができます。
約1分で試すにはnpx @truefoundry/trueforgeを実行するか、ドキュメントを読むか、ご自身のスタックへの適用方法を確認したい場合はウォークスルーをご予約ください。
TrueFoundry AI Gateway delivers ~3–4 ms latency, handles 350+ RPS on 1 vCPU, scales horizontally with ease, and is production-ready, while LiteLLM suffers from high latency, struggles beyond moderate RPS, lacks built-in scaling, and is best for light or prototype workloads.


























