



novembre 20, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Published: novembre 20, 2026

Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Si vous avez atteint les rate limits d'OpenRouter, la cause n'est généralement pas votre volume de trafic. OpenRouter limite les requêtes par clé et par compte, et la marge de manœuvre qui vous est accordée dépend directement du volume de crédits que vous avez acheté. Un solde faible implique donc une rate limit basse. Il s'agit d'un mécanisme de facturation détourné en contrôle de disponibilité, et c'est le premier indice montrant que le modèle de coût d'OpenRouter et celui d'une équipe plateforme ont été conçus pour des publics différents.
Cet article traite du volet contrôle et optimisation des coûts de notre série TrueFoundry vs OpenRouter : rate limits, budgets et leur comportement (avertissement ou blocage), quotas et fenêtres de réinitialisation, routage sensible aux coûts et maintien des grilles tarifaires, caching, ainsi qu'attribution pour le chargeback. Il s'adresse à l'ingénieur chargé de réduire les coûts d'API LLM ainsi qu'au responsable plateforme qui doit en rendre compte, et chaque affirmation s'appuie sur la documentation publique des deux fournisseurs. Pour comprendre où se situe une LLM gateway dans ce paysage, commencez par notre guide d'introduction.
OpenRouter applique des rate limits basées sur le nombre de requêtes, et ces limites sont liées à votre solde. Les variantes de modèles gratuits sont plafonnées à 20 requêtes par minute ; les comptes ayant acheté moins de 10 $ de crédits au cours de leur existence bénéficient de 50 requêtes gratuites par jour, ce quota passant définitivement à 1 000 par jour une fois le seuil des 10 $ franchi, sachant que les requêtes échouées peuvent tout de même être décomptées du plafond. Au-delà du tier gratuit, les rate limits sur les modèles gratuits dépendent des crédits achetés. Ainsi, la capacité de traitement disponible découle du solde du compte plutôt que d'un quota publié par tenant. Les limites basées sur les tokens et sur la concurrence ne sont pas documentées. Les dépassements de rate limits sont rejetés immédiatement, sans mise en file d'attente.
Deux conséquences en découlent. Premièrement, une limite de crédit OpenRouter fait à la fois office de contrôle des dépenses et de contrôle de disponibilité : si le solde diminue, la rate limit se durcit d'autant ; s'il tombe à zéro, le trafic s'arrête. Deuxièmement, les crédits étant définis au niveau du compte tandis que les workspaces se situent en dessous, le trafic d'un workspace consomme potentiellement la marge réservée à l'ensemble des autres workspaces de l'organisation, sans qu'aucun mécanisme dans le produit ne permette de cloisonner ces usages.
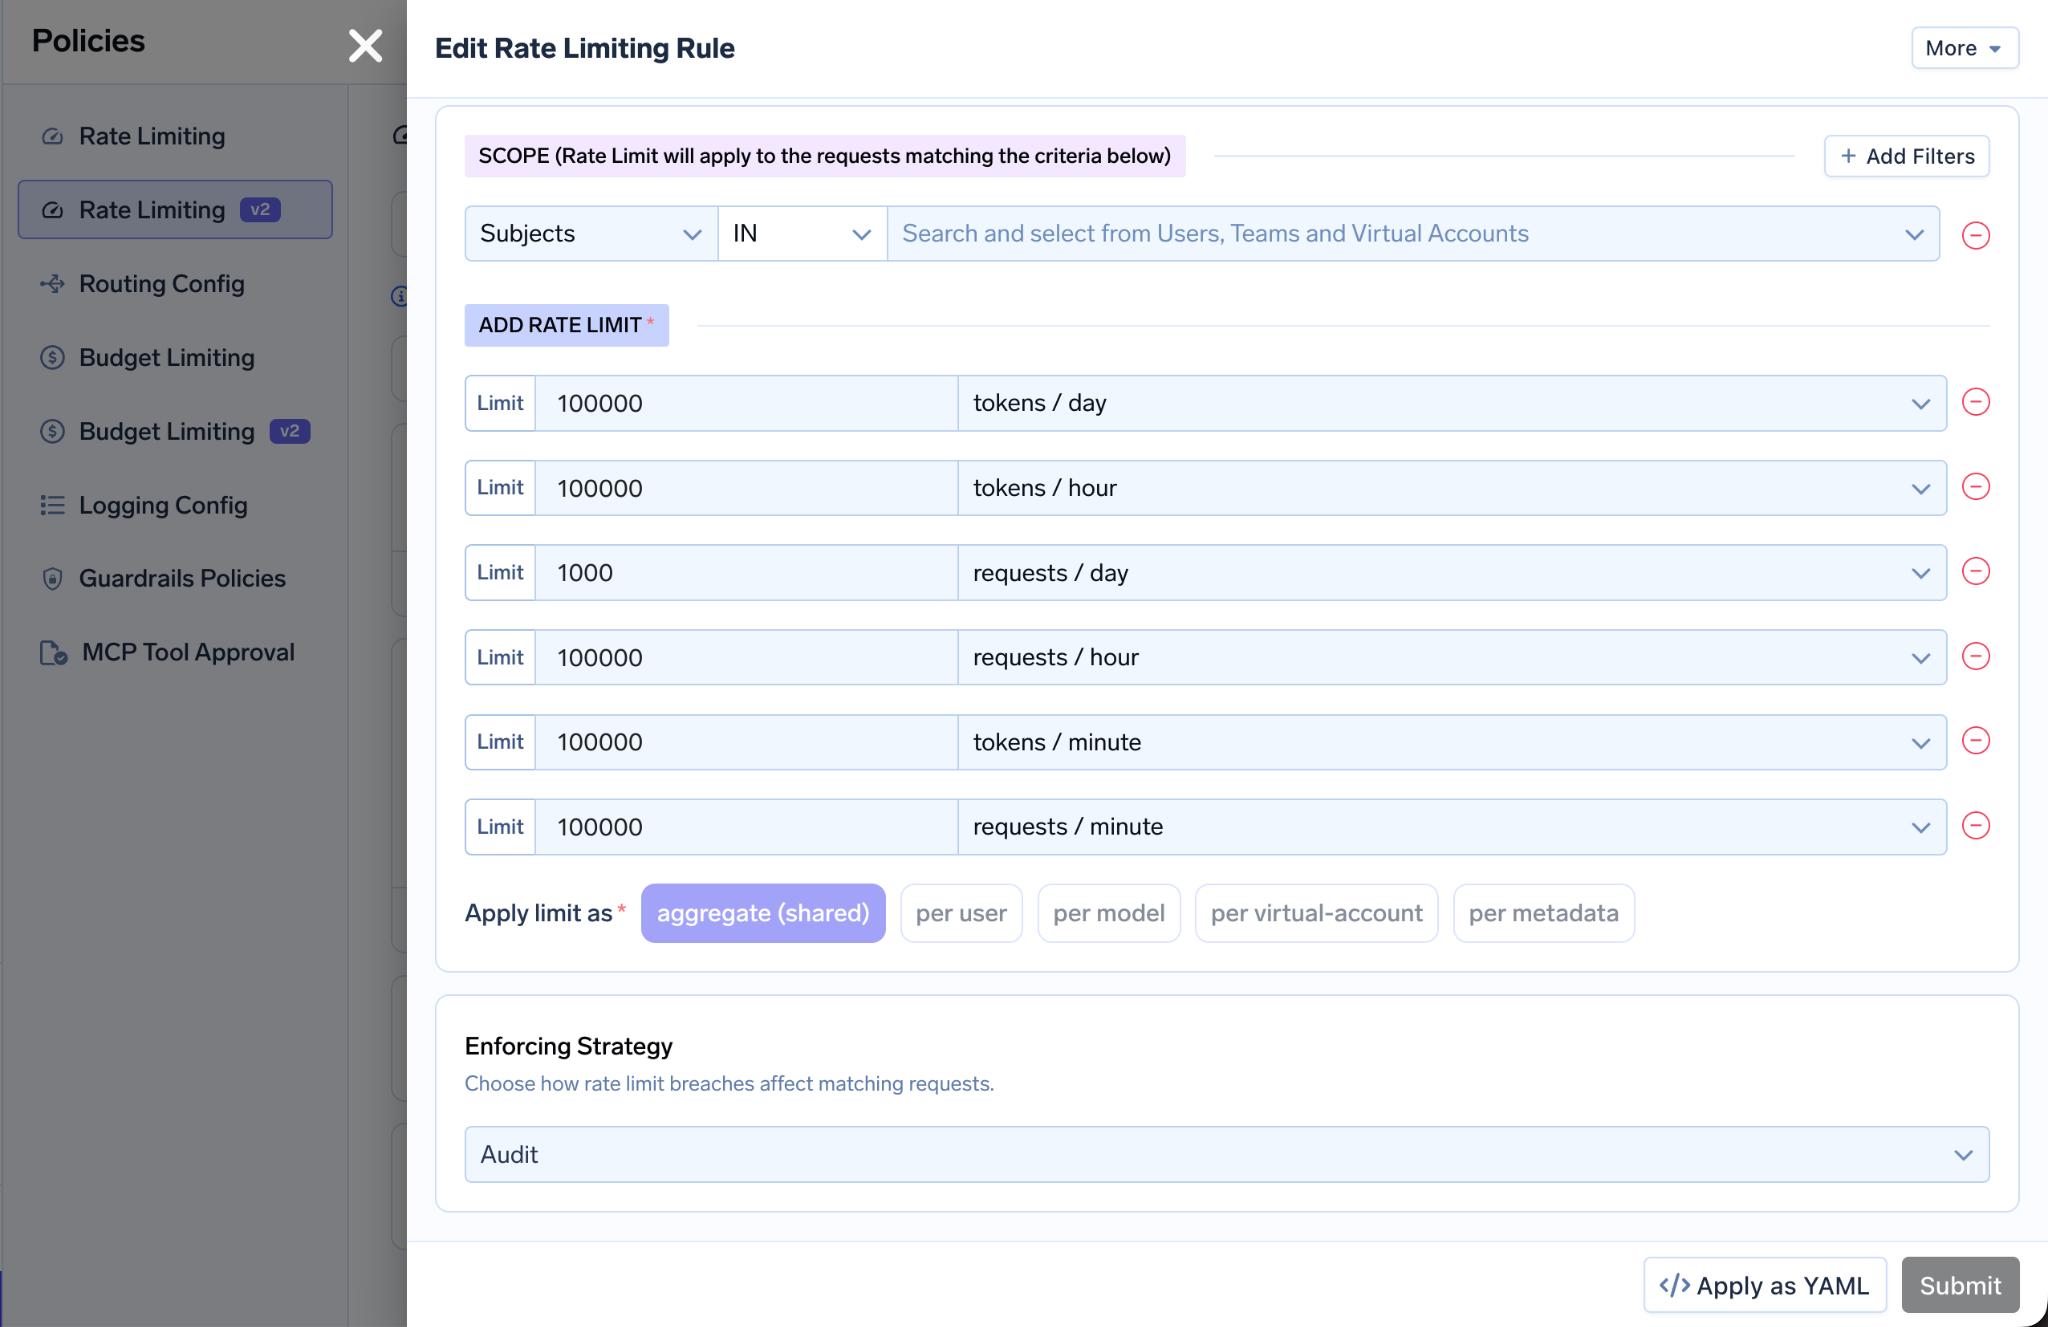
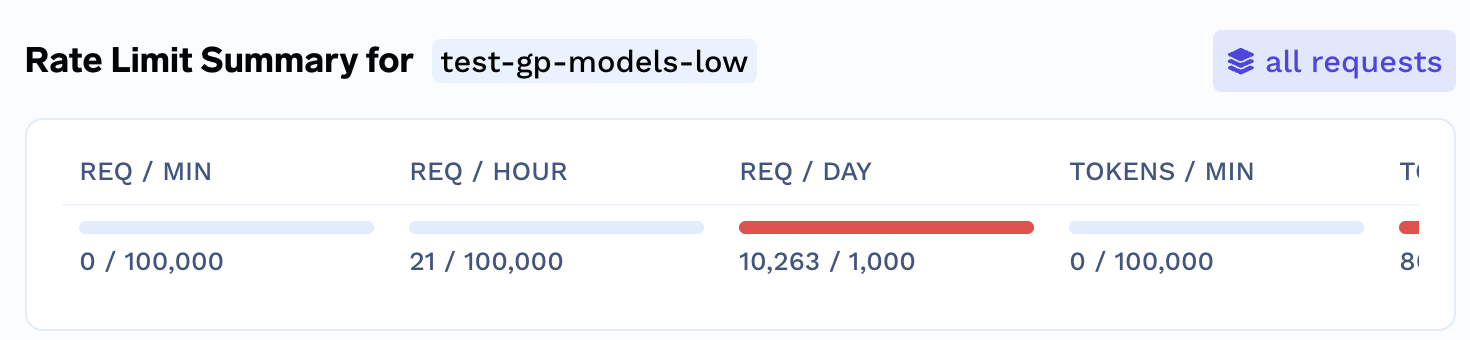
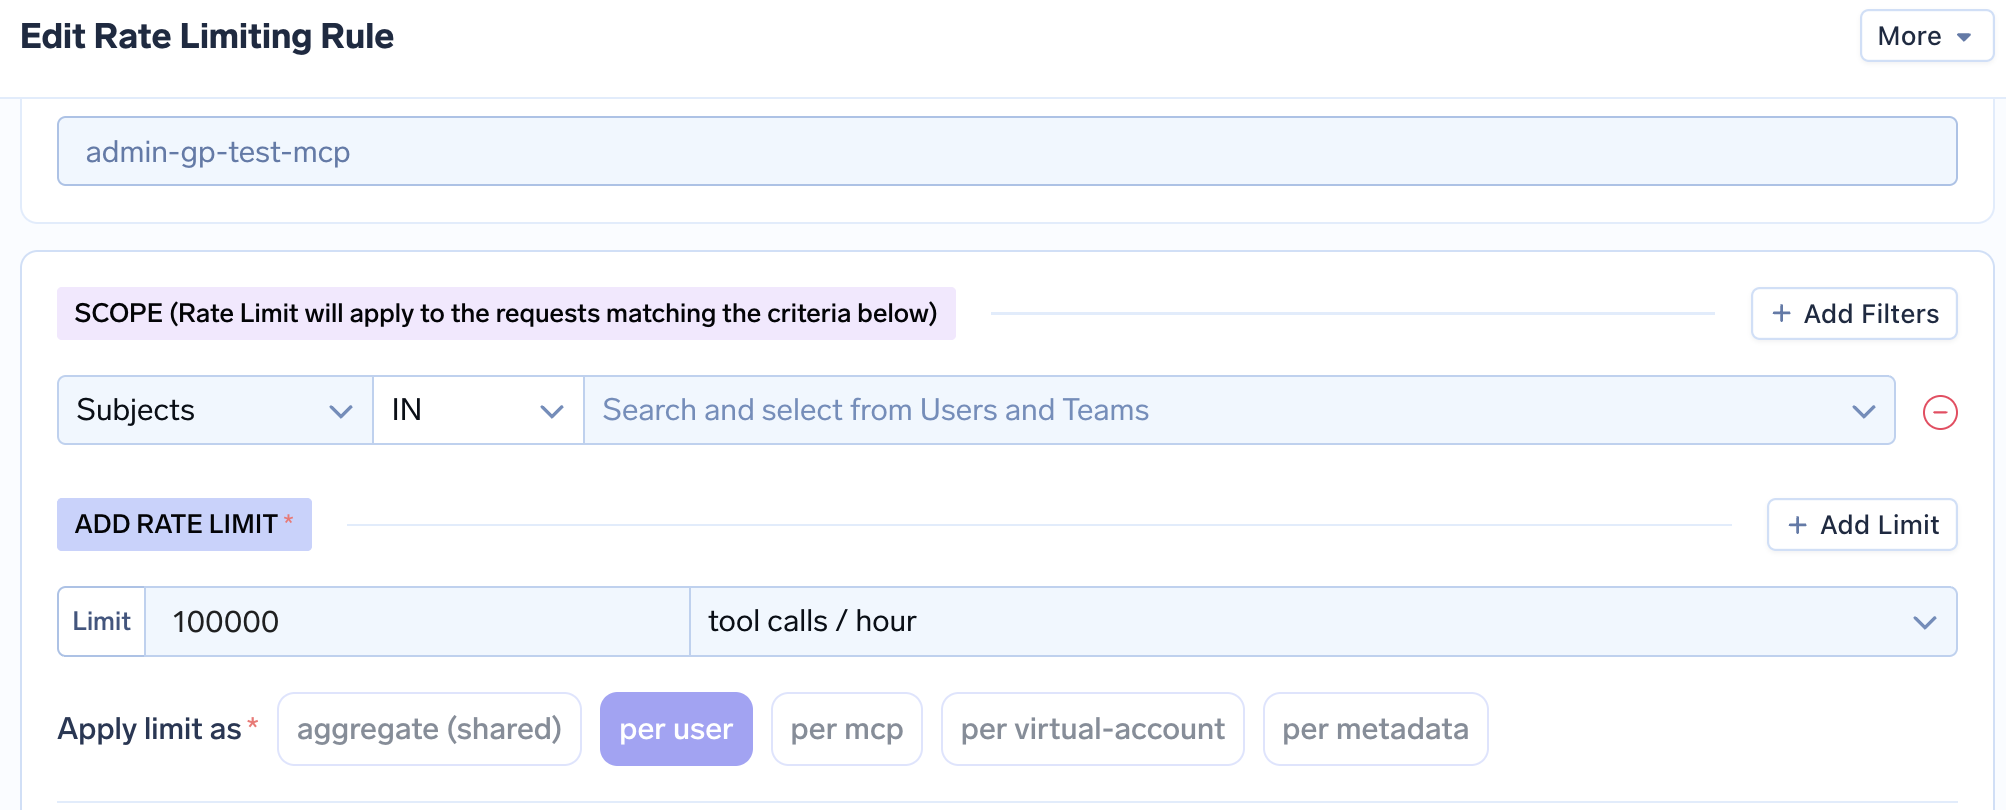
TrueFoundry applique des rate limits basées sur les requêtes et sur les tokens, par minute, heure ou jour, avec des règles définies par utilisateur, équipe, compte virtuel, modèle ou métadonnées de requête, selon une sémantique où la première règle correspondante s'applique (rate limiting). Les limites sont totalement indépendantes de vos paiements envers nous et du trafic des autres équipes, car la gateway conserve les règles en mémoire et ne consulte jamais un solde financier pour traiter une requête. Les limites de concurrence ne sont pas documentées de notre côté non plus ; c'est le seul point pour lequel il convient de tester les deux produits plutôt que de se fier à la documentation. Notre guide sur le rate limiting dans une LLM gateway explique comment dimensionner ces règles.
Un budget OpenRouter s'articule à trois niveaux. Par clé, une limite de crédit intégrant une réinitialisation optionnelle quotidienne, hebdomadaire ou mensuelle à minuit UTC, avec désactivation automatique en cas de dépassement. Par membre et par workspace, des garde-fous qui appliquent des budgets attribuables aux clés ou aux membres, la politique au niveau du compte servant de plafond que le workspace ne peut que restreindre. La fonctionnalité Workspace Budgets est native et dispose de sa propre API, avec des intervalles imbriqués (lifetime, mensuel, hebdomadaire, quotidien), des limites qui doivent strictement diminuer à mesure que l'intervalle se réduit, ainsi qu'un commutateur include_byok_in_budgets déterminant si l'inférence avec vos propres clés (BYOK) est décomptée.
Trois choix d'architecture méritent d'être soulignés. Les budgets ne sont jamais mutualisés : un même garde-fou de budget quotidien appliqué à trois membres attribue ce budget individuellement à chacun d'eux, et une requête est décomptée simultanément du budget de la clé et de celui du membre propriétaire. Il n'existe aucun mécanisme direct par modèle ou par application ; un budget par application ne fonctionne que si l'application correspond à la clé. Enfin, les budgets s'appliquent en arrêt ferme (hard-stop) sans alerte préalable : aucun mode warning-only n'est documenté, et toute requête dépassant la limite renvoie un code HTTP 403, moyen par lequel une équipe découvre généralement que son budget est épuisé.
La fonctionnalité Budget Limiting V2 de TrueFoundry permet de définir des règles au niveau du tenant ou de l'équipe, filtrées par utilisateurs, équipes, comptes virtuels, modèles (concrets ou virtuels), comptes providers et métadonnées de requête via l'en-tête X-TFY-METADATA. Ainsi, la création d'un budget par application s'effectue simplement via un compte virtuel ou un tag de métadonnées (budget limiting v2). Les règles s'exécutent en mode enforce (requête bloquée) ou warn-only (avertissement seul) ; plusieurs règles s'associent via des opérateurs logiques ET ; les limites s'appliquent de manière globale ou par utilisateur, compte virtuel, modèle ou valeur de métadonnée ; et les périodes peuvent être quotidiennes, hebdomadaires, mensuelles, trimestrielles ou lifetime, avec possibilité de cumul au sein d'une même règle (par exemple 0,50 $ par jour et 2 $ par trimestre, tout dépassement déclenchant le blocage). Des alertes d'étape sont envoyées à 75, 90, 95 et 100 % par e-mail, webhook Slack ou bot Slack. Point d'attention à noter en toute transparence : le suivi débute à la création de la règle et non au début de la période, ce qui signifie que les dépenses antérieures ne sont pas comptabilisées rétroactivement.
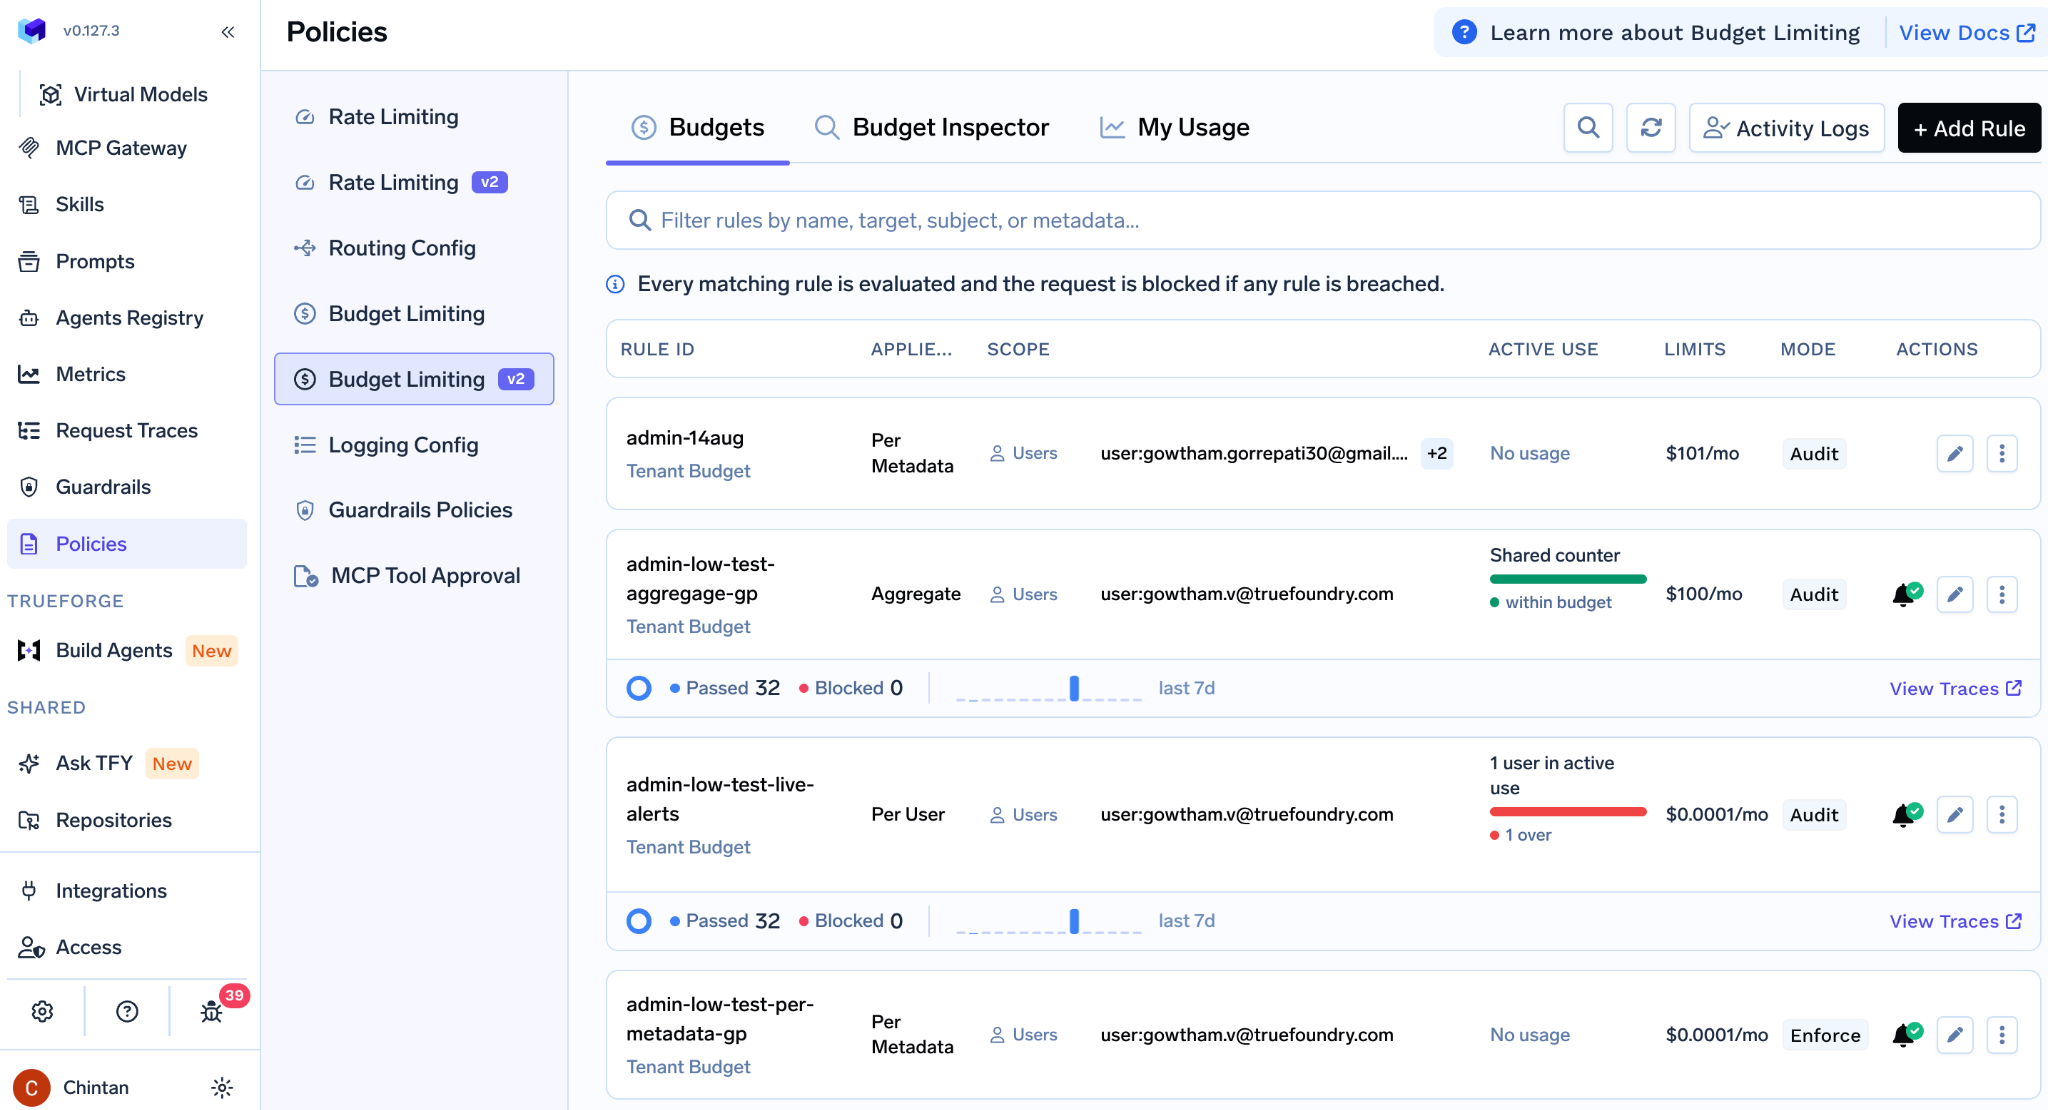
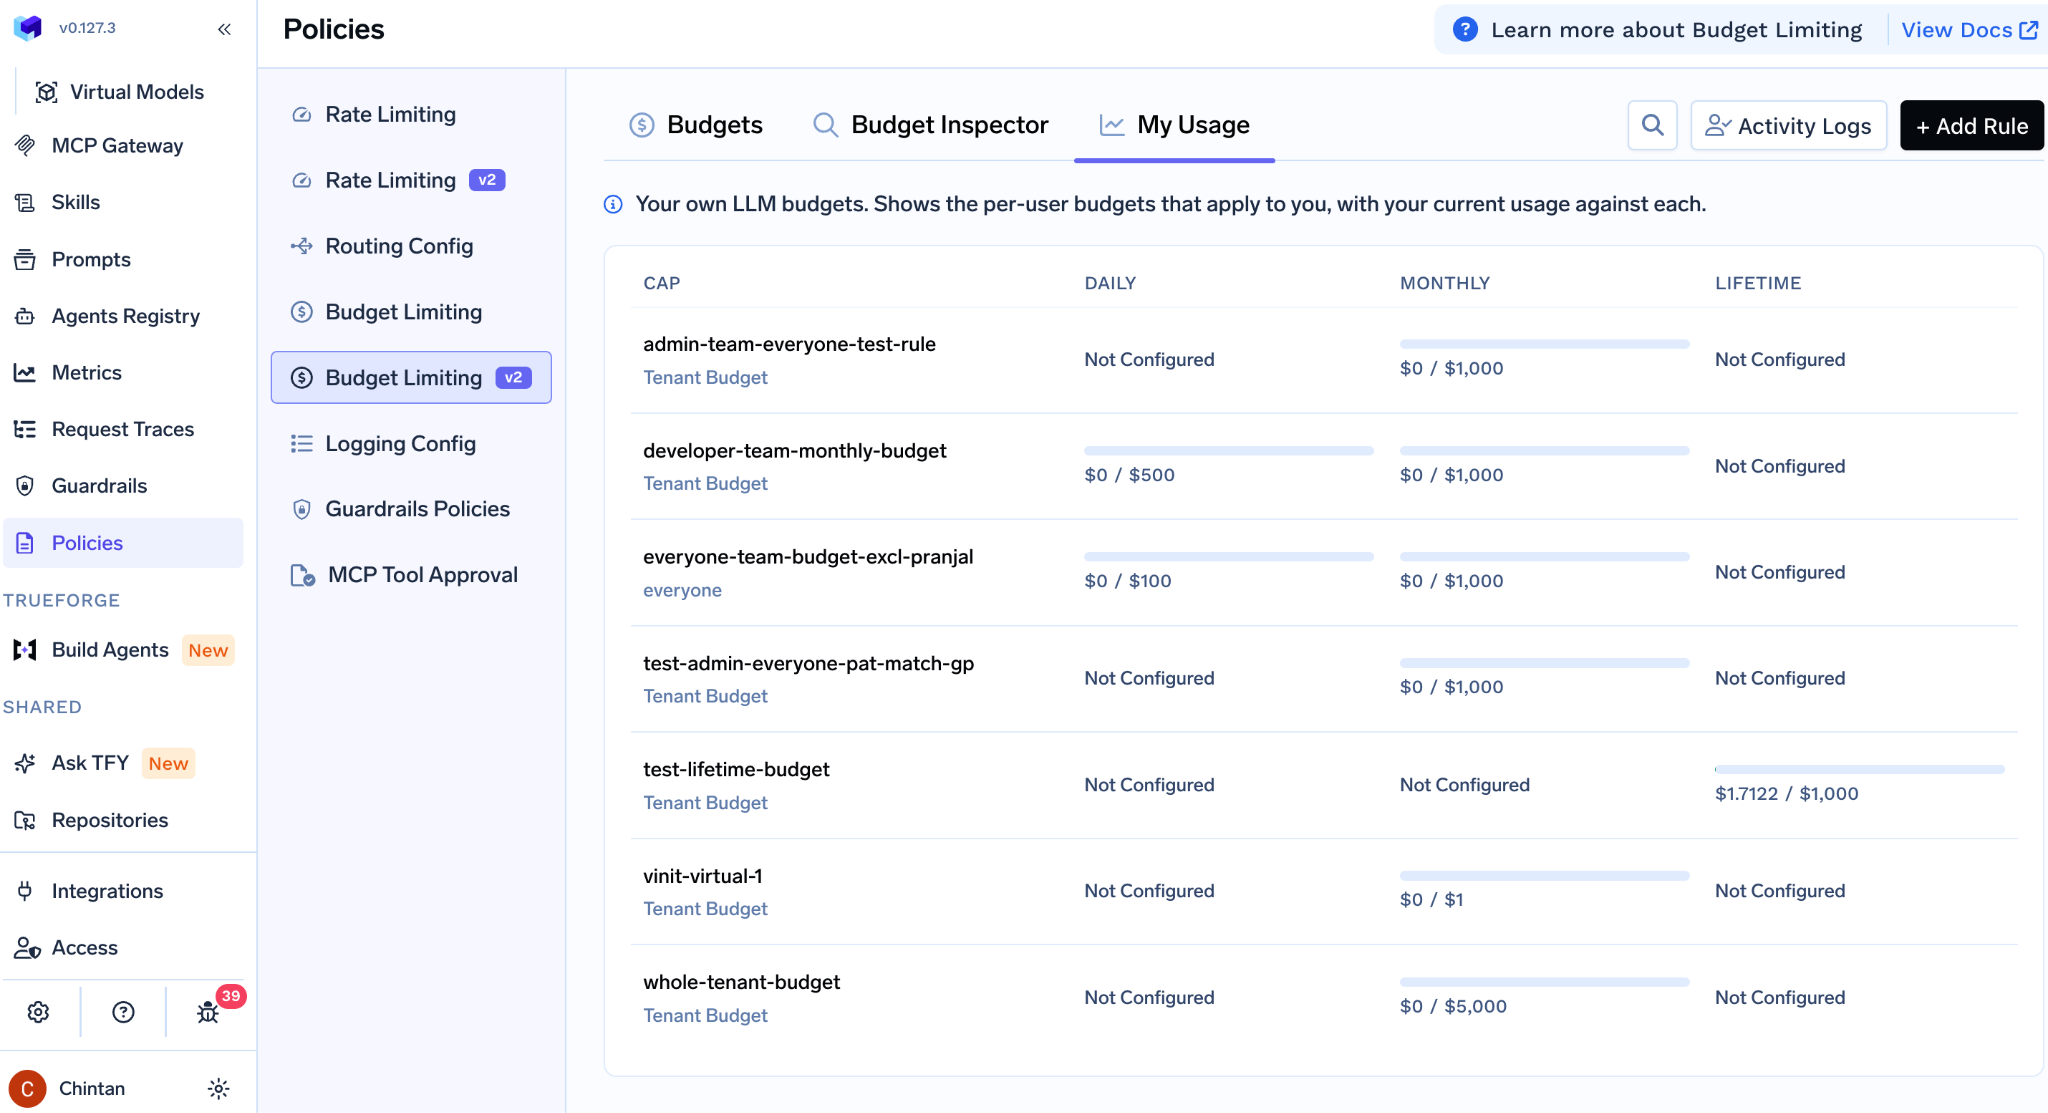
Dans la pratique : sur TrueFoundry, une équipe est avertie dès 75 % d'utilisation et peut continuer à travailler au-delà de 100 % si la règle est configurée en mode warn-only ; sur OpenRouter, l'équipe découvre le dépassement lorsque ses requêtes commencent à renvoyer des erreurs 403.
Deux concepts distincts sont désignés ici sous le terme de caching, et leur confusion constitue l'erreur la plus fréquente lors des révisions de coûts.
Le prompt caching côté provider correspond à la réduction tarifaire accordée par le fournisseur de modèle sur les tokens d'entrée en cache. OpenRouter transmet cette réduction et adapte son routage en conséquence : la lecture du cache coûte environ 0,1x à 0,5x le tarif normal d'entrée selon le provider, et le paramètre session_id permet de maintenir la session sur le provider conservant le cache actif. TrueFoundry répercute également le prompt caching du provider, et notre documentation explique explicitement comment le combiner avec le caching au niveau de la gateway (caching). Aucun des deux fournisseurs n'a inventé cette capacité ; tous deux vous permettent d'en bénéficier.
Le response caching au niveau de la gateway consiste pour la gateway à répondre directement à la requête, sans solliciter le provider. Le Response Caching d'OpenRouter, actuellement en bêta, repose sur une correspondance exacte : deux requêtes ne sont considérées comme identiques que si elles partagent la même clé API, le même modèle, le même type d'endpoint, le même mode de streaming et un corps de requête rigoureusement identique. Il s'active à la demande par requête via l'en-tête X-OpenRouter-Cache: true, fonctionne indépendamment du modèle, prend en charge les endpoints chat completions, Responses, Messages et embeddings, mais exclut les endpoints legacy completions, TTS, STT, rerank ou vidéo. En cas de hit, la réponse est renvoyée sans facturation ni consommation de tokens. Deux caractéristiques sont à porter à son crédit : les hits de cache ne sont pas décomptés des rate limits du provider, et ils sont visibles dans le journal Activity. Une contrainte en limite toutefois la portée : le cache OpenRouter est restreint à une seule clé API. Ainsi, des clés différentes au sein d'un même compte ne le partagent pas, et un ensemble de services disposant chacun de sa propre clé ne tire aucun bénéfice du trafic des autres. Le caching sémantique n'est pas proposé. Lors de nos propres tests, nous avons mesuré un taux de hit de 100 % sur des requêtes strictement identiques, avec un temps de réponse de 58,5 ms sur un hit contre 2 866,8 ms sur un miss, et une durée de vie (TTL) comprise entre deux et cinq minutes.
TrueFoundry propose le caching exact ainsi que le caching sémantique au niveau de la gateway, en s'appuyant sur Redis. Un hit renvoie la réponse complète avec zéro appel au provider et zéro coût associé, quel que soit le provider. Le cache est partagé entre l'ensemble des appelants au lieu d'être cloisonné par clé, ce qui permet à une seconde équipe posant une question similaire de bénéficier des requêtes de la première. Une stratégie de LLM avec cache sémantique s'avère essentielle pour les charges de travail où la correspondance exacte ne produit aucun hit : assistants de support client, recherche interne ou modèles de prompts contenant des variables. Nous ne publions pas de taux de hit mesurés, car ils dépendent entièrement de votre trafic ; le test le plus pertinent consiste à évaluer le système pendant une semaine avec vos propres prompts.
Sans aucune directive de routage configurée, OpenRouter optimise nativement le prix en trois étapes : déprioriser les providers ayant subi des interruptions significatives au cours des 30 dernières secondes, sélectionner parmi les acteurs stables ceux offrant le coût le plus bas en les pondérant par l'inverse du carré du prix, et conserver les autres en secours. Des contrôles explicites s'y superposent : la directive provider.sort: "price" ou le raccourci de slug :floor routent vers le moins cher en priorité, :nitro route en fonction du débit, provider.max_price définit un plafond strict en dollars par million de tokens qui se combine avec le tri, tandis que provider.only, ignore et les préférences de quantification permettent de restreindre la liste des candidats. La grille tarifaire ne risque pas de devenir obsolète car OpenRouter est le vendeur : son catalogue de tarifs fait foi. Deux limites objectives : il s'agit d'un arbitrage de providers pour un modèle donné et non d'une substitution de modèles, et le routage trié par prix se fait au détriment de la constance de qualité, dans la mesure où les providers les moins chers peuvent exécuter des quantifications différentes d'un même modèle.
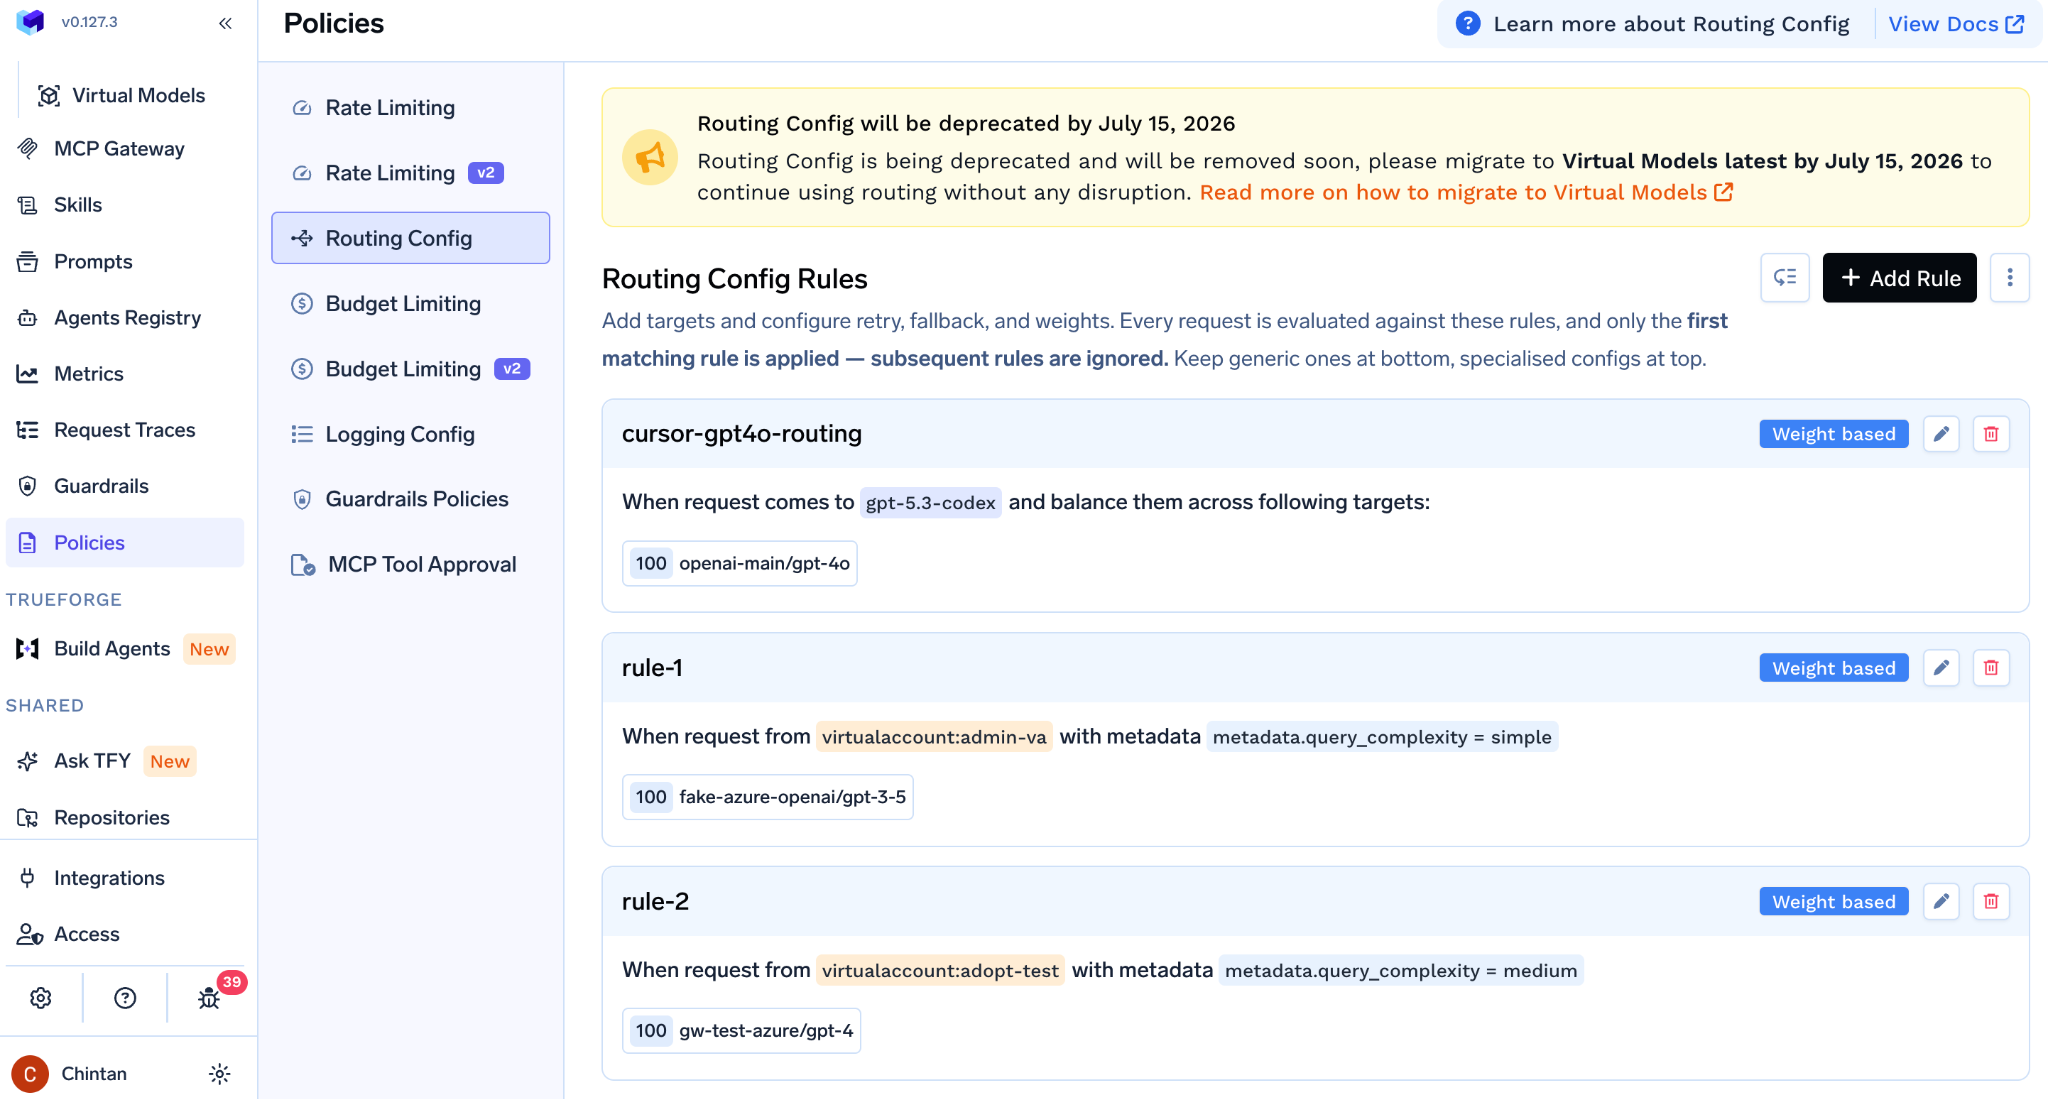
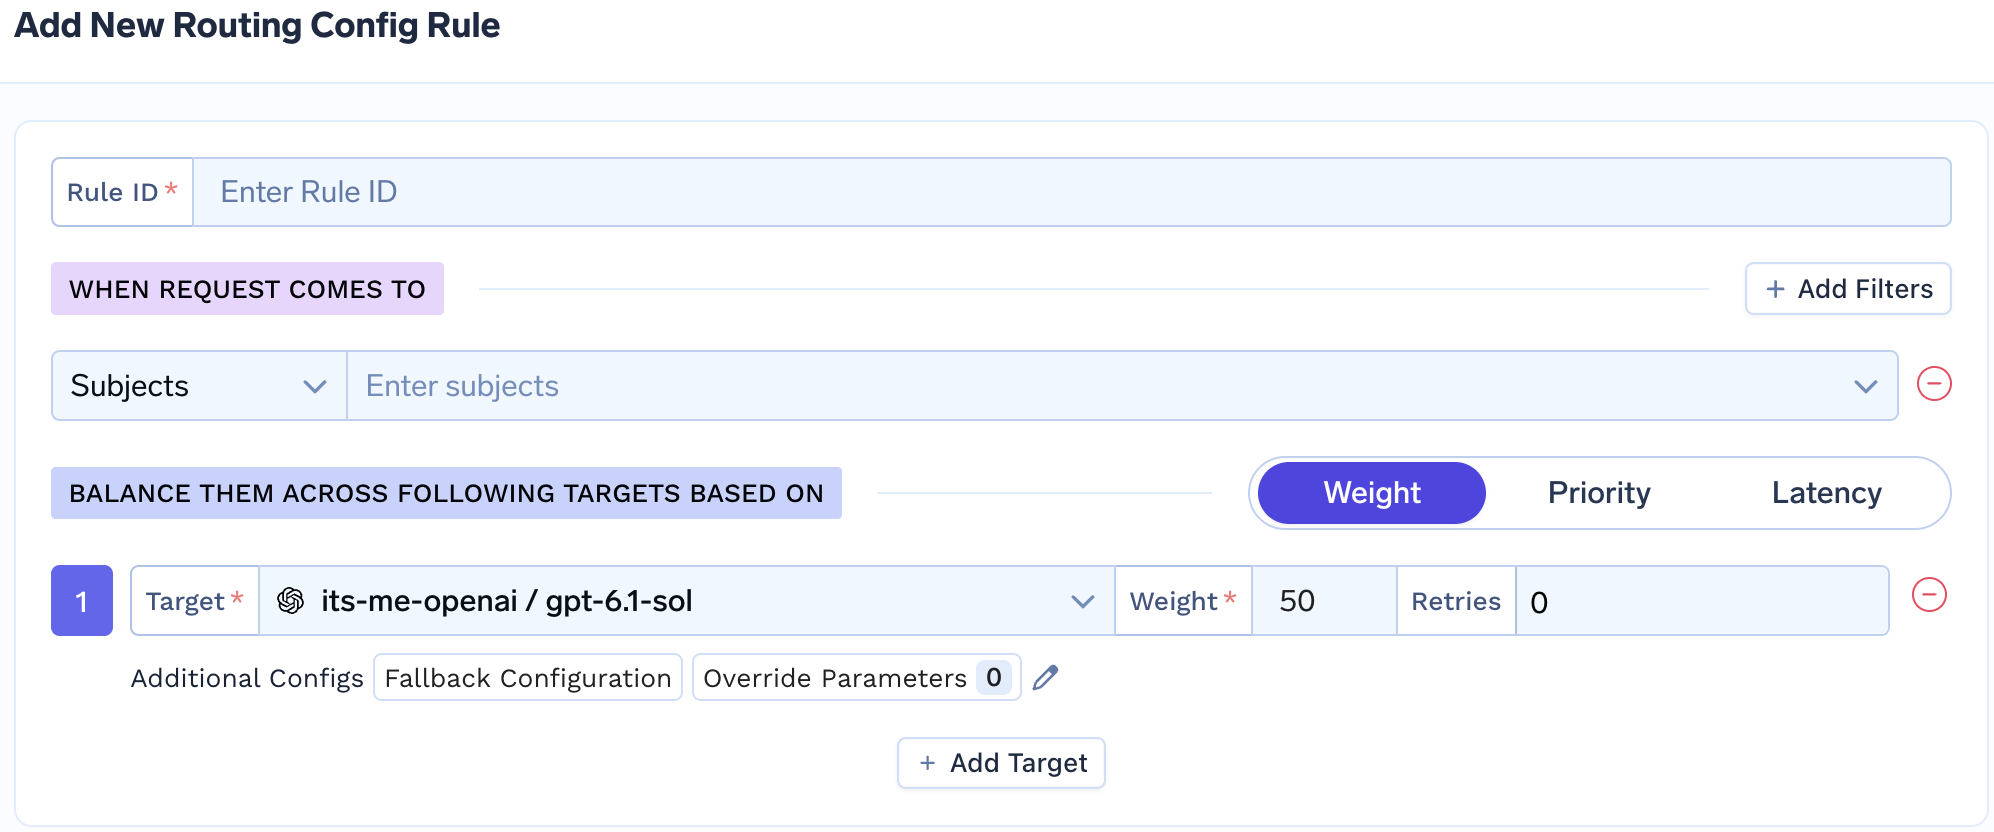
TrueFoundry n'effectue pas d'arbitrage de providers basé sur une grille tarifaire. Nous proposons un routage basé sur la complexité : la gateway classifie chaque requête comme simple, moyenne ou complexe et la route vers le modèle que vous avez configuré pour ce niveau, tout en conservant des sessions persistantes. Vous choisissez ainsi le modèle économique par niveau et la gateway sélectionne le niveau approprié (auto routing). À cela s'ajoute un load balancing basé sur le poids, la latence et la priorité entre les cibles, ainsi qu'une chaîne de secours sur modèles virtuels qui contourne toute cible dont le budget est dépassé, faisant office de coupe-circuit financier. Les données de prix proviennent d'un catalogue open source complété par vos tarifs privés pour les contrats négociés et les modèles fine-tunés (cost tracking). Le constat s'impose donc dans les deux sens : modèle acceptable le moins cher, oui ; provider le moins cher pour ce modèle précis, non. L'intégration de ces deux approches dans une architecture de routage est détaillée dans notre guide explicatif sur le LLM router.
La gouvernance des dépenses implique de savoir précisément qui consomme les ressources. TrueFoundry attribue les coûts et les tokens par utilisateur, équipe, compte virtuel, modèle, compte provider et clés de métadonnées personnalisées ; l'en-tête X-TFY-METADATA sert de point d'ancrage pour le chargeback, permettant à une requête marquée d'un identifiant d'application ou de centre de coûts d'être comptabilisée sous cette entité. Les tableaux de bord ventilent les dépenses selon chacune de ces dimensions, et les API de budget fournissent l'état de la consommation ainsi qu'un classement des plus grands consommateurs (cost tracking, budgets API). Le plan d'exécution de la gateway qui applique ces règles en mémoire maintient un overhead d'environ 3 à 4 ms pour plus de 350 requêtes par seconde par vCPU sur plus de 1 000 LLM. L'attribution ne se fait donc pas au détriment de la latence. Pour les aspects orientés finance, consultez notre guide consacré aux solutions de suivi des coûts LLM.
OpenRouter effectue l'attribution par clé (avec des libellés descriptifs), workspace, modèle et provider ; les vues Activity et Logs offrent un suivi au niveau du compte avec un filtrage optionnel par workspace, l'en-tête usage: {include: true} renvoie l'utilisation par requête dans le corps de la réponse, la fonctionnalité Activity Export génère des rapports CSV ou PDF groupés par modèle, clé ou membre, et un suivi des utilisateurs ainsi que des classificateurs personnalisés ajoutent des dimensions par utilisateur et par catégorie. La facturation est centralisée sur une facture unique pour l'ensemble des workspaces. L'attribution par application ou par centre de coûts reste réalisable, soit de manière native via des ID utilisateurs et classificateurs personnalisés, soit en aval via la transmission de métadonnées Broadcast vers votre plateforme d'observabilité.
Voilà comment s'articule l'optimisation des coûts LLM de chaque côté. Si l'objectif est de réduire les coûts d'API LLM pour une application unique, le routage d'OpenRouter gère l'essentiel de manière automatique. Si l'objectif est de les réduire à l'échelle d'une organisation, vous devez identifier l'équipe contributrice, l'avertir avant toute coupure et router les requêtes simples vers le modèle le plus économique, ce qui correspond à l'approche de TrueFoundry.
Les capacités de TrueFoundry sont issues de notre documentation ; celles d'OpenRouter reflètent ses fonctionnalités publiques documentées au moment de la rédaction.
Ni l'un ni l'autre ne documentent de fonctionnalités de prévision des dépenses ou de détection d'anomalies ; TrueFoundry mentionne les alertes d'anomalies comme « à venir » sur sa feuille de route de gouvernance des agents, tandis qu'OpenRouter propose une fonction Notifications dont les types d'alertes ne sont pas détaillés. Prévoyez un outil FinOps dans les deux cas, et consultez notre guide sur les alternatives à OpenRouter pour une vue plus large du marché.
Les rate limits, budgets et mécanismes de caching d'OpenRouter ont été pensés pour un développeur gérant une clé unique : des limites indexées sur le solde, des budgets qui bloquent au lieu d'avertir, un cache propre à la clé, avec en contrepartie le meilleur arbitrage automatique de providers du marché. Les contrôles de coûts de TrueFoundry sont conçus pour une équipe plateforme rendant des comptes à la finance : des limites en requêtes et en tokens, des budgets qui avertissent avant de bloquer et qui s'étendent aux équipes, modèles et applications, un cache sémantique partagé entre tous les appelants, ainsi qu'un chargeback natif par centre de coûts. Aucun des deux ne propose de prévisions ni de détection d'anomalies, un aspect à anticiper dans votre architecture. La frontière pratique réside dans le profil de la personne qui consulte le rapport de budget : un développeur ou un partenaire financier.
Pour découvrir la configuration des budgets, limites et caching dans le cadre d'un déploiement multi-équipes, explorez la TrueFoundry AI Gateway, ou réservez une démo si vous dimensionnez actuellement vos contrôles de coûts pour la production.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception





