



novembre 20, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Published: novembre 20, 2026

Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
LiteLLM a mérité sa popularité. Sous licence MIT, il prend en charge plus de 100 fournisseurs derrière une seule API compatible OpenAI, s'installe en quelques minutes et permet à une petite équipe de passer de "l'appel de trois fournisseurs avec trois SDK" à "l'appel d'un seul point de terminaison" pratiquement sans effort. Pour de nombreux projets, c'est le bon choix initial, et rien dans cet article ne soutient le contraire.
Les raisons pour lesquelles les équipes s'en éloignent sont structurelles et apparaissent à une échelle prévisible. Lorsqu'une douzaine d'ingénieurs devient une centaine, qu'une application devient trente, que "nous devrions probablement suivre les dépenses" devient "la finance a besoin du coût par équipe" et "la sécurité a besoin d'un journal d'audit", un proxy Python mono-processus commence à s'épuiser face à des tâches pour lesquelles il n'a jamais été conçu. Ajoutez à cela les incidents survenus en 2026 dans la chaîne d'approvisionnement de LiteLLM, et la conversation passe de "ça fonctionne" à "qui contrôle l'accès à nos modèles, et comment le prouver ?"
Il s'agit d'un guide de migration, pas d'une démolition. Il nomme les signaux spécifiques indiquant que vous avez dépassé LiteLLM, mappe chaque concept LiteLLM à son équivalent dans une passerelle gouvernée, et définit une bascule étape par étape à faible risque précisément parce que les deux parties utilisent l'API compatible OpenAI. Dans la plupart des cas, le code de votre application ne change que d'une ligne : l'URL de base.
Vous dépassez les capacités de LiteLLM ? Découvrez comment un simple changement d'URL de base vous fait passer à une passerelle gouvernée. Réservez une démo.
Soyez précis sur les déclencheurs. Les histoires floues du type "ça ne passait pas à l'échelle" ne vous aident pas à planifier ; les modes de défaillance spécifiques, oui.
Le plafond de débit lié au GIL. Le proxy de LiteLLM est en Python. Le Global Interpreter Lock de Python signifie qu'un seul processus exécute le bytecode Python sur un seul thread à la fois. Pour un proxy limité par les E/S qui attend principalement les réponses des fournisseurs, cela reste tolérable à faible concurrence. Cependant, à mesure que le volume de requêtes concurrentes augmente, la gestion des requêtes, la sérialisation, la journalisation et les vérifications de politiques se disputent ce verrou unique : la latence grimpe et le débit plafonne, quelle que soit la quantité de matériel ajoutée. Vous pouvez fractionner sur plusieurs processus et instances, mais vous devenez alors responsable de l'orchestration et du problème d'état partagé que cela crée.
Concentration des secrets et surface d'attaque. Le proxy détient les clés API de chaque fournisseur qu'il intègre. C'est le principe même d'un proxy, mais cela signifie qu'un seul proxy compromis, ou une seule configuration qui fuite, expose OpenAI, Anthropic, vos points de terminaison de modèles cloud, absolument tout à la fois. Sans gestion centralisée des secrets, rotation et accès restreint, la surface d'attaque de tout incident englobe l'ensemble du système.
Dispersion des déploiements et gestion des correctifs. Parce qu'il est très simple à exécuter, LiteLLM finit par s'exécuter partout : une copie sur le portable de chaque développeur, une dans la CI, plusieurs en production. Lorsqu'une vulnérabilité apparaît, vous devez trouver et corriger chaque instance. Il n'y a pas de plan de contrôle unique affirmant que "chaque appelant passe par ce point de terminaison gouverné unique", donc "corriger le proxy" devient une chasse au trésor.
Fardeau de la HA auto-hébergée. Exécuter un seul proxy est facile. L'exécuter avec basculement, mises à niveau sans interruption, contrôle de santé et mise à l'échelle horizontale sous SLA représente un travail d'infrastructure dont vous devenez entièrement responsable. De nombreuses équipes atteignent un point où cette tâche non différenciée ne vaut plus la peine.
Deux événements survénus en 2026 ont transformé ces préoccupations structurelles en priorités urgentes, et il convient de les exposer clairement, sans alarmisme.
En mars 2026, une compromission de la CI a entraîné la publication de versions malveillantes de LiteLLM (versions 1.82.7 et 1.82.8) sur PyPI. Les paquets malveillants volaient les identifiants des systèmes qui les installaient. L'image Docker officielle n'a pas été affectée. En octobre 2026, un second incident a vu une version malveillante (1.107.0) être poussée à la fois sur PyPI et Docker à l'aide de jetons GitHub volés. Séparément, LiteLLM a fait l'objet de plusieurs CVE, notamment une répertoriée dans le catalogue KEV (Known Exploited Vulnerabilities) de la CISA (une trajectoire d'exécution de code à distance exploitable par les détenteurs d'une clé API) et un problème où une session MCP pouvait être établie avec n'importe quel jeton porteur.
Le modèle de remédiation dans chaque cas était le même : verrouiller les versions, reconstruire à partir d'une version saine connue et effectuer la rotation de tous les secrets. La leçon à en tirer n'est pas que "LiteLLM n'est pas sûr" ; les projets open-source sont ciblés précisément parce qu'ils sont largement utilisés. La leçon est que la concentration des secrets associée à la dispersion des versions transforme tout événement isolé de la chaîne d'approvisionnement en un incident à l'échelle du parc applicatif. C'est un argument fort en faveur d'un plan de contrôle gouverné où la version, les secrets et les accès sont gérés de manière centralisée et auditable. Une dépendance compromise est beaucoup plus facile à confiner lorsque chaque appelant passe déjà par un point de terminaison gouverné avec des identifiants restreints, renouvelés et un journal d'audit complet.
Une passerelle IA gouvernée conserve tout ce que LiteLLM vous offrait (un point de terminaison unique compatible OpenAI pour plusieurs fournisseurs) et ajoute la couche sur laquelle un proxy léger ne se concentre pas :
TrueFoundry fournit cela sous la forme d'un plan de contrôle unique et, point crucial, se déploie en SaaS, dans votre VPC, sur site ou dans un environnement cloisonné (air-gapped), le plan de données restant au sein de votre réseau. "Gouverné" ne signifie donc pas "confier votre trafic à un tiers". Pour l'ensemble des critères de sélection, consultez comment choisir une passerelle IA, et pour le cadre architectural, ce qu'est et fait un proxy LLM.
Découvrez comment TrueFoundry mappe vos clés, budgets et modèles LiteLLM vers une politique gouvernée. Réservez une démo.
La migration est volontairement progressive. Vous ne faites jamais basculer toute l'organisation d'un coup.
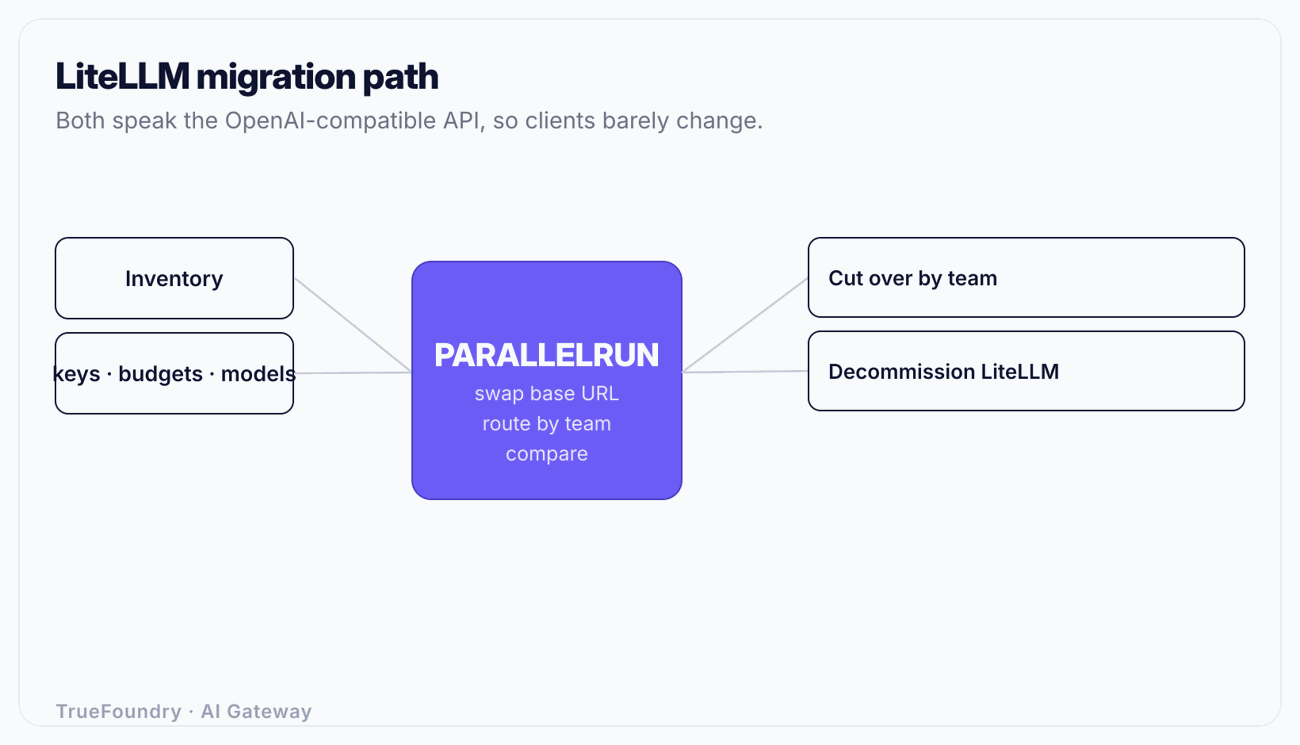
Avant de toucher à quoi que ce soit, cataloguez ce que LiteLLM fait pour vous aujourd'hui :
L'inventaire des appelants est l'étape que les équipes sautent et finissent par regretter. Vous ne pouvez pas faire basculer un trafic dont vous ignoriez l'existence. Effectuez un grep dans vos bases de code et votre infrastructure pour trouver le nom d'hôte du proxy.
Vous ne reconstruisez pas ; vous traduisez. Chaque concept LiteLLM a un équivalent dans la passerelle gouvernée.
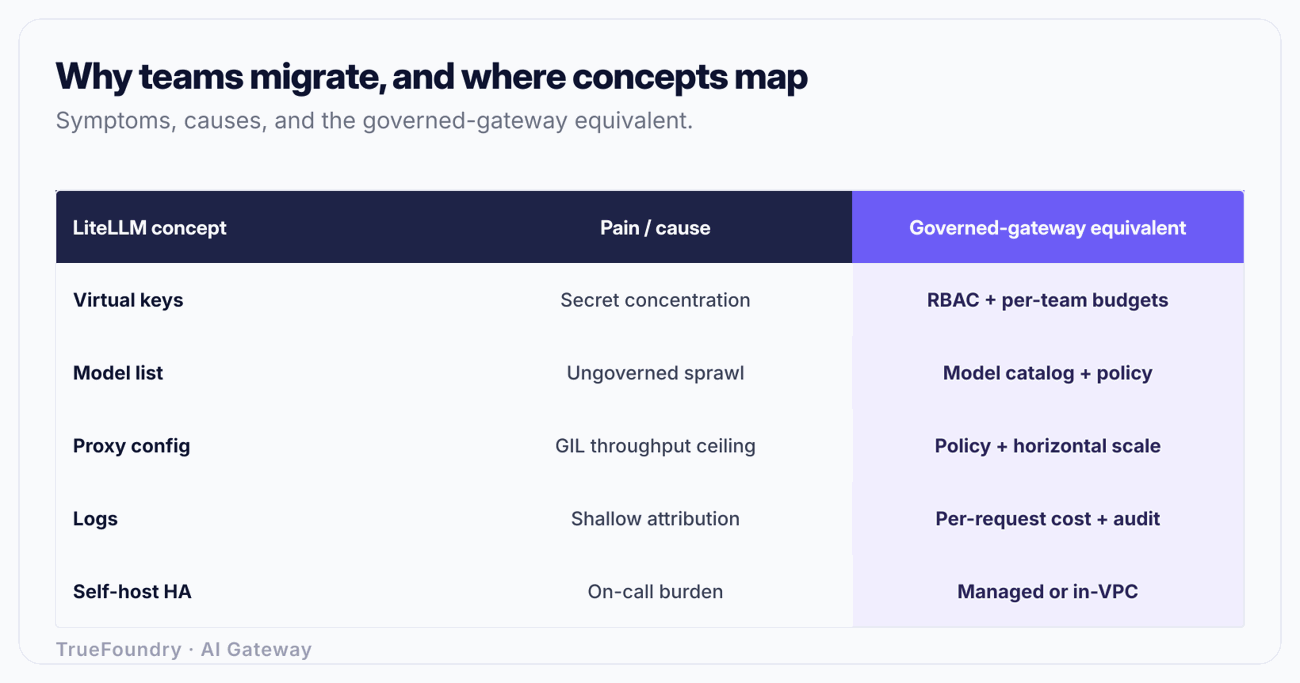
La traduction est principalement une réorganisation mentale : LiteLLM raisonne en clés et en fichier de configuration ; une passerelle gouvernée raisonne en identités, équipes, catalogues et politiques. Les fonctionnalités se recoupent largement, c'est pourquoi la migration présente un faible risque.
C'est l'étape qui sécurise l'ensemble du processus. LiteLLM et la passerelle gouvernée exposent tous deux une API compatible OpenAI. Cela signifie que la seule modification dont le client a besoin est l'URL de base, en passant de l'URL du proxy LiteLLM au point de terminaison de la passerelle. Pas de changement de SDK, pas de réécriture de la structure des requêtes, pas de modification de l'analyse des réponses.
Déployez la passerelle gouvernée à côté de LiteLLM. Orientez un seul service à faible risque vers la nouvelle URL de base. Vérifiez que les réponses sont identiques, que l'observabilité affiche le trafic avec une attribution correcte des coûts, et que les budgets ainsi que les garde-fous se comportent comme configuré. Les deux points de terminaison étant actifs, vous pouvez les comparer directement et faire revenir un service à l'ancienne URL de base en quelques secondes si quelque chose semble anormal.
Un exemple concret : supposons que votre service d'inférence lisent OPENAI_API_BASE à partir d'une variable d'environnement. La migration pour ce service consiste à modifier une variable d'environnement et à redémarrer ; faire machine arrière consiste à la remettre comme avant. C'est l'ensemble de la surface d'impact côté client de cette migration lorsque les deux parties utilisent la même API.
Faites maintenant basculer le trafic par vagues, organisées par équipe ou par application, et non tout en même temps :
Changer d'infrastructure équipe par équipe vous offre une limite de restauration nette et permet de définir correctement les budgets et les accès par équipe au fur et à mesure, plutôt que de migrer un écheveau de clés partagées lors d'un saut unique et risqué. Cela répartit également le travail de vérification : chaque équipe confirme que son propre trafic fonctionne correctement avant que vous ne passiez à la suite.
Une fois que chaque appelant pointe vers la passerelle et s'y exécute depuis suffisamment longtemps pour que vous ayez toute confiance, démantelez LiteLLM : arrêtez les instances du proxy, supprimez les secrets des fournisseurs de sa configuration et, surtout, effectuez la rotation de ces identifiants de fournisseurs afin que les copies de l'ancien proxy soient inactives. Supprimez le proxy des configurations de CI et des environnements de développement pour éviter que la dispersion des déploiements ne réapparaisse discrètement. La migration est terminée lorsqu'il existe exactement un chemin gouverné vers chaque modèle et aucun proxy orphelin contenant des clés actives.
Migrer des clés partagées au lieu de redéfinir les accès par équipe. Les déploiements LiteLLM accumulent des clés virtuelles partagées que plusieurs équipes utilisent. Les porter telles quelles recrée la même dispersion non gouvernée que vous cherchez à fuir. Profitez de la bascule pour définir les accès par équipe via votre fournisseur d'identité : c'est l'un des objectifs principaux de cette migration.
Omettre l'inventaire des appelants. Les équipes migrent les applications dont elles se souviennent et laissent un notebook, une tâche cron ou une étape de CI pointant vers l'ancien proxy. Elles démantèlent ensuite LiteLLM et un composant tombe en panne dans l'ombre. Effectuez un grep global pour retrouver l'ancien nom d'hôte avant d'éteindre le proxy.
Oublier de renouveler les secrets lors du démantèlement. Si vous arrêtez LiteLLM tout en laissant actives les clés de fournisseurs qu'il détenait, ces identifiants restent valides et se retrouvent dans un système démantelé et non surveillé, ce qui correspond exactement au risque lié aux secrets obsolètes exploité lors des incidents de 2026. Effectuez la rotation de chaque identifiant détenu par l'ancien proxy.
Traiter le changement d'URL de base comme l'ensemble de la migration. Le changement d'URL de base simplifie la partie client, mais la gouvernance (RBAC, budgets, définition du périmètre du catalogue, audit) reste la raison d'être de cette migration. Changer les URL sans configurer la gouvernance vous laisse avec un nouveau proxy et les mêmes anciens problèmes.
Bascule globale instantanée ("Big bang"). Faire basculer toute l'organisation en une seule modification supprime votre possibilité de restauration ciblée. L'exécution en parallèle et la bascule équipe par équipe existent pour que tout problème soit limité à une seule équipe et réversible par un simple retour à l'ancienne URL de base. Ne vous en passez que si vous appréciez les appels de crise en plein incident.
Dépasser les capacités de LiteLLM est un signe de réussite, pas une erreur de choix initial. Les déclencheurs sont spécifiques et structurels : le plafond de débit d'un proxy Python en situation de concurrence, chaque secret de fournisseur concentré au même endroit, la dispersion des copies entre les environnements, le poids de la haute disponibilité auto-hébergée et une année 2026 marquée par des incidents sur la chaîne d'approvisionnement qui ont rendu la concentration des secrets et la dispersion des versions beaucoup moins abstraites.
La migration elle-même présente un faible risque car les deux solutions utilisent l'API compatible OpenAI ; la modification côté client se résume donc généralement à une URL de base. Inventoriez l'existant, mappez les clés vers le RBAC et les budgets, la liste des modèles vers un catalogue, la configuration vers une politique, exécutez les deux systèmes en parallèle, basculez équipe par équipe et démantelez le tout avec une rotation complète des secrets. Procéder ainsi vous permet de troquer un proxy pratique contre un plan de contrôle gouverné sans réécriture, tout en reprenant le contrôle des accès, des coûts et de l'audit.
Migrez depuis LiteLLM avec un minimum de modifications applicatives. Réservez une démo.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception





