



novembre 20, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Published: novembre 20, 2026

Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Le Model Context Protocol offre à un LLM une méthode standard pour appeler des outils, lire du contexte et réutiliser des prompts quel que soit le client compatible. Créer un serveur qui l'implémente n'est pas difficile ; en construire un qui soit correct, sécurisé lors de son exposition et agréable à utiliser pour un modèle nécessite quelques décisions supplémentaires par rapport aux tutoriels d'introduction. Ce guide couvre l'ensemble du parcours : ce qu'expose un serveur, quel transport choisir et pourquoi, comment définir un outil que le modèle utilisera efficacement, comment authentifier un serveur distant, comment le tester et ce qui change lors du passage de votre ordinateur portable à la production.
Les exemples utilisés sont du pseudocode structuré dans un style proche de Python. Ils illustrent la structure exacte (noms, schémas, signatures de gestionnaires) sans vous lier à une version spécifique d'un SDK, car c'est cette structure qui importe. Si vous souhaitez d'abord acquérir les bases conceptuelles, l'article qu'est-ce qu'un serveur MCP couvre le modèle ; ce post est consacré à la construction.
Vous avez construit un serveur MCP ? Placez-le derrière une passerelle pour l'authentification, le registre et l'audit. Réservez une démo.
Un serveur MCP offre trois types de capacités à un client. Faire correctement la distinction lors de la conception vous évite l'erreur la plus courante, qui consiste à tout faire tenir dans des tools.
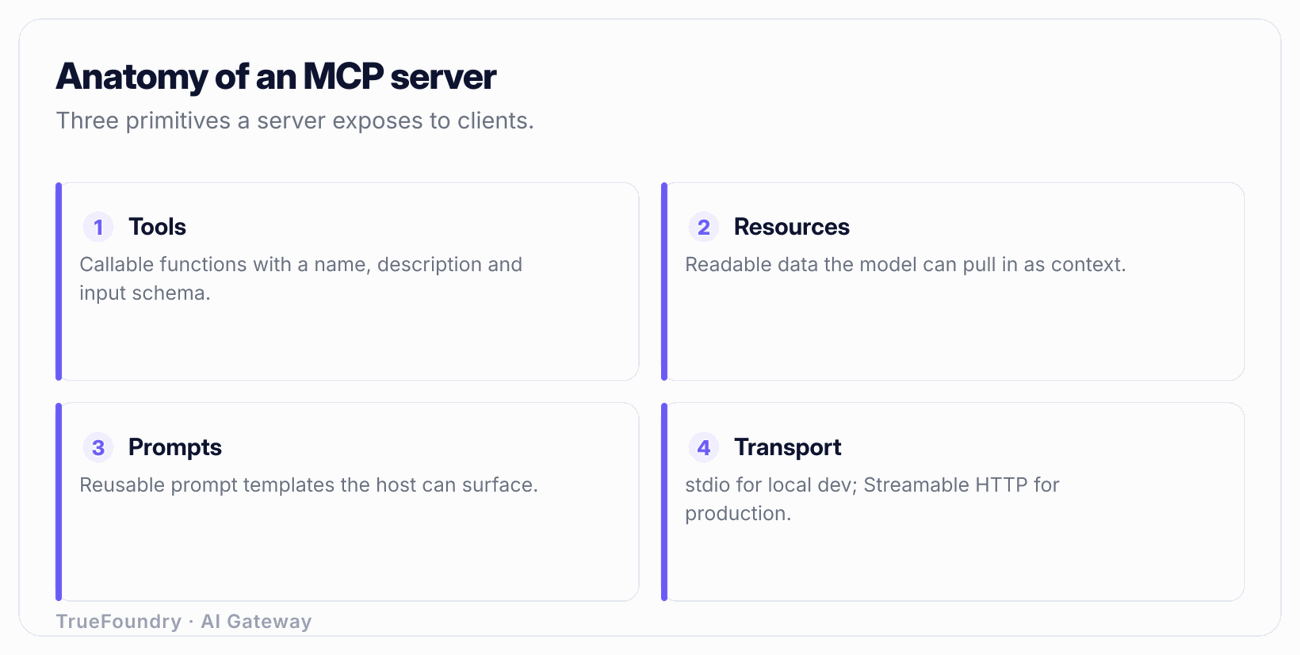
Les tools sont des fonctions invoquées par le modèle. Le modèle décide, au cours d'une conversation, d'appeler un outil pour accomplir une tâche : interroger une base de données, créer un ticket, envoyer une requête à une API interne. Les tools peuvent avoir des effets de bord. C'est la primitive à utiliser lorsque le modèle doit agir. Un tool possède un nom, une description et un JSON Schema pour ses entrées, et il renvoie du contenu structuré.
Les resources sont du contexte en lecture seule géré par l'application et identifié par une URI. Une resource est une donnée que le client peut lire et transmettre au modèle comme contexte : un fichier, un document de configuration, le contenu actuel d'un enregistrement. La différence clé par rapport à un tool réside dans le contrôle et l'intention. Une resource est en lecture seule et est généralement sélectionnée par l'application ou l'utilisateur (« joindre ce document »), et non invoquée par le modèle en plein raisonnement pour déclencher un effet. Si l'élément que vous exposez ne modifie jamais d'état et se résume à « voici du contexte à lire », il s'agit d'une resource, pas d'un tool.
Les prompts sont des modèles invoqués par l'utilisateur. Un prompt est un message paramétrable et réutilisable (ou une séquence de messages) qu'un utilisateur déclenche explicitement, souvent présenté dans un client sous la forme d'une commande slash ou d'un élément de menu. « Résumer cette PR selon notre style interne » avec un paramètre pr_url est un prompt. Les prompts sont contrôlés par l'utilisateur, et non choisis de manière autonome par le modèle.
Une règle pratique : si le modèle doit décider quand l'utiliser, construisez un tool. Si l'utilisateur ou l'application décide du contexte à charger, construisez une resource. Si l'utilisateur souhaite une instruction préconfigurée et répétable, construisez un prompt. La plupart des serveurs n'intègrent légitimement que des tools, mais un serveur qui expose, par exemple, vos procédures internes est mieux modélisé avec des resources qu'avec un tool get_runbook que le modèle devrait deviner comment appeler.
Le protocole définit la manière dont un client et un serveur échangent des messages JSON-RPC. Deux transports importent, et ce choix conditionne presque tout le déploiement.
Le mode stdio local exécute le serveur en tant que sous-processus du client et échange des messages via l'entrée et la sortie standard. C'est le choix adapté pour le développement et pour les clients desktop comme un IDE ou un assistant local, où le serveur s'exécute sur la même machine que l'utilisateur. Il n'y a pas de réseau, pas d'authentification à configurer, et le client gère le cycle de vie du processus. Pour exécuter des serveurs locaux à l'intérieur d'un client de code spécifiquement, consultez les serveurs MCP dans Claude Code. La limitation est évidente : stdio ne dessert qu'un seul utilisateur local et ne peut être partagé, équilibré ou atteint via un réseau.
Le mode Streamable HTTP distant exécute le serveur en tant que service réseau accessible par les clients via HTTP, avec du streaming du serveur vers le client pour les notifications et la progression. C'est le transport requis pour tout ce qui est multi-utilisateur, hébergé ou en production. La révision du protocole du 2026-07-28 est ici essentielle : Streamable HTTP prend en charge un mode stateless (sans état), dans lequel le serveur n'a pas besoin d'associer un client à une session persistante sur une instance spécifique. Le fonctionnement stateless est ce qui vous permet de faire tourner de multiples répliques identiques derrière un équilibreur de charge et d'assurer une mise à l'échelle horizontale sans sessions denses (sticky sessions), ce qui constitue la propriété la plus importante pour un hébergement en production. Cette même révision a standardisé les en-têtes Mcp-Method et Mcp-Name sur les requêtes, qui exposent la méthode JSON-RPC et le nom du tool ou de la resource au niveau de la couche HTTP. Cela peut paraître secondaire, mais ça ne l'est pas : cela signifie qu'une passerelle, un proxy ou un équilibreur de charge peut router, limiter le débit, autoriser et enregistrer les logs par tool sans parser le corps JSON-RPC, ce qui est exactement ce dont vous avez besoin pour gouverner un serveur à grande échelle.
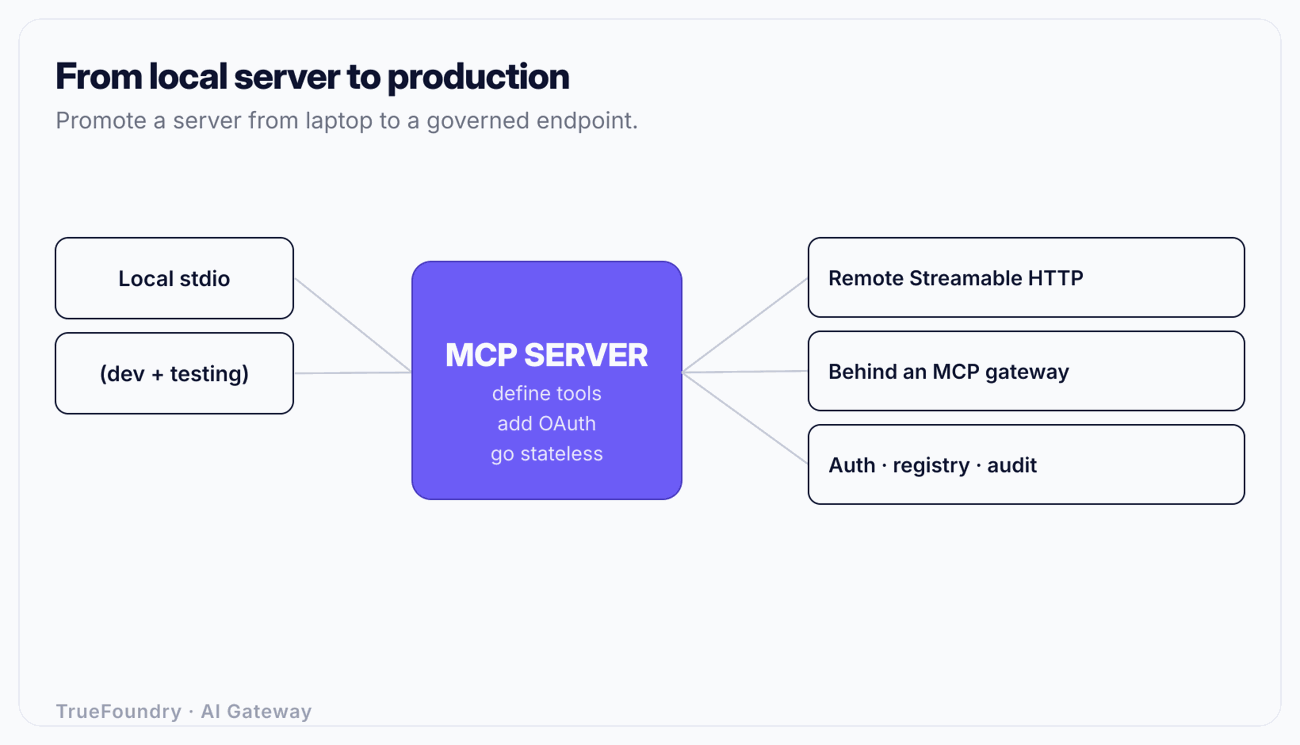
Développez et déboguez sur stdio ; déployez sur Streamable HTTP. En concevant votre serveur pour que le transport reste une couche externe fine (des gestionnaires qui ne se soucient pas de la manière dont ils ont été atteints), vous pourrez basculer de l'un à l'autre sans réécrire la logique métier.
La définition d'un outil comporte trois parties, et le comportement du modèle est régi par l'ensemble de ces trois éléments. C'est de là que proviennent la plupart des problèmes du type « mon serveur ne fonctionne pas ».
# Structural pseudocode — shape, not a specific SDK version.

@server.tool()
def search_orders(
    customer_id: str,        # required
    status: str = "any",     # enum: open | shipped | cancelled | any
    limit: int = 20,         # 1..100
) -> list[Order]:
    """Search a customer's orders by status.

    Use this when the user asks about the state, history, or
    contents of orders for a known customer_id. Returns up to
    `limit` orders, newest first. Does NOT create or modify
    orders. If the customer_id is unknown, ask the user for it
    rather than guessing.
    """
    ...
Les trois parties :
Nom. Court, commençant par un verbe, non ambigu. search_orders, et non orders ou do_order_stuff. Le modèle lit le nom en premier lorsqu'il choisit parmi des dizaines d'outils disponibles.
Description. C'est le texte le plus important que vous rédigerez, et il relève du prompt engineering, pas de la documentation. Le modèle décide s'il doit appeler l'outil et comment remplir ses arguments quasi exclusivement à partir de la description. Indiquez ce que fait l'outil, quand l'utiliser, quand ne pas l'utiliser, ce qu'il renvoie et comment gérer les entrées manquantes. L'exemple ci-dessus précise au modèle qu'il est en lecture seule (« Ne crée NI ne modifie ») et lui donne un comportement de secours (« demander à l'utilisateur plutôt que de deviner »). Des descriptions floues amènent le modèle à appeler le mauvais outil, à appeler le bon outil avec de mauvais arguments ou à l'appeler alors qu'il ne le devrait pas. Traitez chaque description comme un mini prompt système.
Schéma d'entrée. Un JSON Schema précis. Marquez les champs requis comme obligatoires. Utilisez des enums pour les ensembles fermés (status est l'une des quatre valeurs) afin que le modèle ne puisse pas inventer "in_progress". Définissez des limites (limit entre 1 et 100). Ajoutez une description à chaque champ. Un schéma strict contraint le modèle et permet au serveur, ou à une passerelle placée devant lui, de valider les entrées avant l'exécution de tout gestionnaire.
Deux pièges classiques :
create_refund) doit tolérer d'être appelé deux fois avec les mêmes entrées sans doubler l'effet. Acceptez une clé d'idempotence ou rendez l'opération naturellement idempotente. Concevez votre système pour une livraison au moins une fois (at-least-once), car c'est ce qui se produira.Un serveur stdio local hérite de la confiance accordée à la machine de l'utilisateur et ne nécessite aucune authentification. Dès que vous exposez un serveur via HTTP, il a besoin d'une véritable authentification, et le protocole est très précis sur ce qu'implique une « vraie » authentification.
Le modèle d'autorisation MCP s'appuie sur OAuth 2.1. Deux éléments sont particulièrement importants. Premièrement, le serveur est une ressource protégée par OAuth : les clients obtiennent un jeton d'accès auprès d'un serveur d'autorisation et le présentent sous forme de jeton porteur (bearer token). Deuxièmement, et c'est un point souvent omis, la spécification exige des indicateurs de ressources (RFC 8707) afin qu'un jeton soit lié au serveur MCP spécifique pour lequel il a été émis (la ressource) au lieu d'être un jeton à usage général. Sans indicateurs de ressources, un jeton généré pour un serveur A peut être rejoué sur un serveur B qui fait confiance au même serveur d'autorisation, ce qui crée un problème de « confused deputy » (député confus). Avec ces indicateurs, le serveur d'autorisation émet un jeton restreint à la ressource visée, et chaque serveur rejette les jetons qui ne lui sont pas destinés.
En pratique, vous n'avez pas à développer cela vous-même. Vous placez le serveur derrière un composant qui gère correctement OAuth et valide l'audience de chaque jeton. C'est l'un des rôles d'une passerelle MCP. Le fonctionnement détaillé, la validation des jetons, les scopes et les failles de type confused deputy sont abordés dans l'article l'authentification MCP. La règle de ce guide : un serveur MCP distant protégé par une clé API statique partagée n'est pas authentifié, il est simplement obscurci. Utilisez OAuth 2.1 avec des jetons liés à une audience.

Découvrez comment TrueFoundry héberge et gouverne vos serveurs MCP distants. Réservez une démo.
Avant d'exposer quoi que ce soit, testez le serveur via un client MCP et observez l'échange réel de messages.
Le test piloté par le modèle à l'étape 3 est celui que les équipes négligent le plus souvent, alors qu'il est le plus important. Un serveur techniquement correct mais qui décrit mal ses outils échouera d'une manière particulièrement difficile à déboguer à partir des logs : le modèle se contentera de l'utiliser de façon incorrecte.
Un serveur qui s'exécute sur votre ordinateur via stdio et un serveur prêt à être exposé à un trafic réel sont deux objets distincts. Voici ce que comporte cet écart.
Hébergement et cycle de vie. Le serveur devient un service que vous déployez, surveillez, mettez à jour et restaurez. Il nécessite des vérifications d'état (health checks), des limites de ressources et une cible de déploiement. L'article l'hébergement de serveur MCP détaille les options et les arbitrages.
Mise à l'échelle stateless. Pour exécuter plusieurs répliques derrière un équilibreur de charge, conservez le serveur sans état par requête, ce à quoi est destiné le mode stateless Streamable HTTP de la révision 2026-07-28. Tout état de session doit résider dans un espace de stockage partagé et non dans la mémoire de l'instance, sous peine de voir échouer la requête suivante d'un client routée vers une autre réplique.
Authentification et autorisation. OAuth 2.1 avec indicateurs de ressources pour l'authentification, puis l'autorisation : quels utilisateurs et quels agents peuvent appeler quels outils. Traitez l'agent comme une identité de premier plan, et pas seulement l'humain derrière lui ; l'identité des agents IA et une autorisation fine par outil évitent qu'un serveur puissant ne devienne une vulnérabilité.
Découverte via un registre. Les clients et les équipes plateforme doivent pouvoir trouver le serveur, connaître sa version et savoir ce qu'il expose. Un registre est le catalogue qui rend les serveurs détectables et gouvernables à l'échelle d'une organisation ; voir qu'est-ce qu'un registre MCP. Sans registre, chaque équipe redécouvre et reconfigure les mêmes serveurs manuellement.
Observabilité. Vous avez besoin d'une visibilité par appel : qui a appelé quel outil, avec quels arguments, combien de temps cela a pris, si une erreur est survenue et quel en a été le coût. Les serveurs bruts n'émettent aucune de ces données de manière standardisée.
Garde-fous (guardrails). Les entrées et sorties des outils peuvent contenir des PII, des secrets ou des injections de prompts dissimulées dans le contenu retourné. L'inspection de ces données est une problématique transversale que vous ne souhaitez pas réimplémenter dans chaque serveur.
La méthode efficace consiste à ne pas réinventer cette couche pour chaque serveur. Concevez votre serveur pour qu'il accomplisse sa tâche unique de manière optimale via Streamable HTTP, et placez-le derrière une passerelle MCP qui fournit de façon uniforme l'authentification, l'autorisation, le registre, l'observabilité et les garde-fous. C'est ce qui fait la différence entre exposer un serveur brut et exploiter une flotte de serveurs. L'article Qu'est-ce qu'une passerelle MCP détaille ce modèle, et la gouvernance MCP en entreprise couvre les exigences de contrôle, d'audit et d'accès associées. TrueFoundry propose cette solution sous la forme d'une passerelle MCP et d'un registre avec contrôle d'accès (RBAC, SSO, SCIM) et garde-fous, déployable en SaaS, in-VPC, on-premise ou en environnement air-gapped afin que le plan de données reste au sein de votre réseau.
Elles transforment tout en tool. Du contexte en lecture seule se retrouve encapsulé dans des tools get_* que le modèle doit deviner comment appeler, alors qu'il devrait s'agir d'une resource rattachée par l'application. Des instructions répétitives sont codées en dur, alors qu'elles devraient être des prompts déclenchés par l'utilisateur. Modélisez scrupuleusement les trois primitives.
Elles rédigent des descriptions d'outils sommaires. Une description d'une seule ligne laisse le modèle deviner quand et comment appeler l'outil, et il devine mal. La description régit le comportement ; rédigez-la comme un prompt système, en précisant également quand ne pas utiliser l'outil.
Elles déploient un serveur distant derrière une clé partagée. Une clé API statique ne constitue pas une authentification. Les serveurs distants nécessitent OAuth 2.1 avec des jetons liés à une audience (indicateurs de ressources) afin qu'un jeton destiné à un serveur ne puisse pas être rejoué sur un autre. Négliger ce point crée une faille de type confused deputy.
Elles ignorent l'idempotence. Les clients, les réseaux et le basculement des passerelles effectuent tous des réessais. Un outil générant des effets de bord qui n'est pas idempotent entraînera des facturations en double, des créations en double ou des envois multiples dans des conditions de réessai parfaitement normales. Concevez pour une livraison au moins une fois.
Elles confondent « ça tourne » et « c'est en production ». Un serveur fonctionnel n'est que le début. L'hébergement, la mise à l'échelle stateless, l'authentification, le registre, l'observabilité et les garde-fous constituent le véritable travail requis pour sécuriser son exposition, et recréer cette couche pour chaque serveur conduit les organisations à accumuler des dizaines d'endpoints non gouvernés.
La construction d'un serveur MCP commence par une étape rapide et s'étend sur une longue phase d'optimisation. L'étape rapide correspond au démarrage : choisir un transport, enregistrer un outil avec un nom, une description et un schéma, puis le tester avec un client. Vous pouvez obtenir un serveur fonctionnel en une après-midi. La phase d'optimisation englobe tout ce qui garantit sa viabilité et sa sécurité : modéliser délibérément les tools par rapport aux resources et aux prompts, rédiger des descriptions exploitables par le modèle, rendre idempotents les outils à effets de bord, authentifier l'accès distant avec OAuth 2.1 et des indicateurs de ressources, et assurer une mise à l'échelle stateless.
L'étape que la plupart des équipes sous-estiment est le passage de « tourne sur mon portable » à « exposé à un trafic réel ». Ce passage implique l'hébergement, l'authentification, l'autorisation, la découverte, l'observabilité et les garde-fous, et le véritable levier consiste à ne pas reconstruire cette couche pour chaque serveur. Développez le serveur pour qu'il exécute sa tâche via Streamable HTTP, placez-le derrière une passerelle et un registre MCP pour la gouvernance, et vous obtiendrez un système réellement exploitable plutôt qu'un endpoint isolé que personne ne peut sécuriser ni localiser.
Faites passer votre serveur MCP du local à une production gouvernée. Réservez une démo.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception





