


novembre 21, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.


Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Les tchats de support client laissent fuiter des numéros de sécurité sociale dans les prompts. Les développeurs internes collent des clés d'accès AWS dans un assistant de code. Une réponse toxique glisse jusqu'à l'utilisateur final. Chacun de ces événements est une défaillance réelle dans les opérations LLM — et chacun d'eux peut être intercepté par un petit classifieur local en quelques millisecondes, sans aucun aller-retour avec le LLM. La question la plus difficile est de savoir comment brancher ces vérifications sur des centaines d'applications et des dizaines de fournisseurs de modèles, en ligne avec chaque requête, sans réinventer une stack de validation différente pour chaque application. L'intégration entre Guardrails AI et TrueFoundry AI Gateway apporte la réponse en un seul endroit.
Toute application propulsée par LLM au sein d'une organisation finit par se poser la même question : où les contrôles de sécurité doivent-ils résider ? Intégrés à la hâte dans chaque application, ils se fragmentent à chaque déploiement et dérivent entre les équipes. Placés en amont de chaque fournisseur de modèles, ils se multiplient selon les vendors et ratent les applications qui les contournent. TrueFoundry AI Gateway résout la question en devenant l'unique couche d'exécution par laquelle passe tout le trafic LLM — elle expose l'API compatible OpenAI en entrée, se déploie vers chaque fournisseur de modèles en sortie, et gère tous les besoins transversaux (authentification, rate-limiting, observabilité, politiques) au milieu. Un seul pod gère 250+ RPS sur 1 vCPU avec environ 3 ms de latence ajoutée, sans état et limité par le CPU, avec une configuration synchronisée via NATS pour que le chemin de requête ne passe aucun appel externe.
La centralisation du chemin de requête est ce qui permet aux guardrails de s'intégrer naturellement. Le gateway expose quatre hooks — llm_input, llm_output, mcp_pre_tool, mcp_post_tool — et un nombre illimité de guardrails peut se rattacher à chacun d'eux. Le gateway les exécute en parallèle sur la même requête, de sorte qu'un détecteur de PII, un scanner de secrets et un classifieur de toxicité évaluent tous le même prompt en même temps sans accumuler de latence sérielle. Les input rails s'exécutent en concurrence avec l'appel au modèle, et si l'un d'eux bloque, l'appel au modèle en cours est annulé avant que des tokens ne soient facturés — une véritable propriété d'économie de coûts lorsque les validators interceptent de véritables violations de politique sur le trafic client. Un plugin HTTP personnalisé permet à n'importe quel vendor ou service interne de participer tant qu'il respecte le contrat de verdict du gateway, ce qui correspond exactement à la surface sur laquelle s'interface Guardrails AI.
Guardrails AI est un framework Python open-source pour valider les entrées et sorties des LLM. Sa principale abstraction est le Guard — un enrobeur autour d'un ou plusieurs validators issus du Guardrails Hub, un registre d'implémentations de contrôles préconçus. Le catalogue du Hub couvre la détection de PII, la détection de secrets, la classification de la toxicité, les filtres de profanité, la restriction de sujet, le grounding d'hallucination, et plus encore. La plupart des validators sont des heuristiques locales ou de petits classifieurs ; un sous-ensemble fait appel à un LLM externe lors de la validation.
Le bundle v1 pour cette intégration utilise quatre local validators : DetectPII (un wrapper Microsoft Presidio pour les e-mails, numéros de téléphone, SSN US, cartes de crédit, IBAN, passeports US / permis de conduire / ITIN), SecretsPresent (le detect-secrets de Yelp pour les clés AWS, tokens OpenAI, tokens GitHub, JWT, clés privées), ToxicLanguage (le classifieur Detoxify d'Unitary provenant de Hugging Face), et ProfanityFree (un filtre par liste de mots pour les réponses de l'assistant). Aucun d'entre eux ne nécessite d'appel LLM. La latence de validation médiane sur un pod chaud est inférieure à 100 ms par validator.
L'intégration traite Guardrails AI comme une bibliothèque, l'enrobe dans un service FastAPI, et enregistre le service en tant que guardrail HTTP personnalisé dans TrueFoundry. Pour éviter un comportement particulier connu de la v0.9.3 où les appels Guard.use() enchaînés s'écrasent mutuellement, le wrapper expose un endpoint POST par validator et par direction — /detect-pii-input, /secrets-present-output, /toxic-language-input, et ainsi de suite — et exécute chaque Guard de manière isolée. Les opérateurs choisissent les validators à rattacher à chaque modèle dans le dashboard.

Les validators du Hub s'installent au moment du build Docker via un argument de build qui transporte le token du Hub. Le token est consommé dans la couche de build et n'est pas présent dans l'environnement d'exécution. Les versions des validators sont figées sur ce que le Hub fournissait au moment du build ; rafraîchir le bundle nécessite une modification du Dockerfile et un redéploiement.
La structure de réponse du wrapper est :
Ce que dit le wrapperCe qu'interprète le gatewayHTTP 200 + {"verdict": true}Autoriser — le validator ne s'est pas déclenchéHTTP 200 + {"verdict": false, "message": "<validator>: ..."}Bloquer — le gateway propage le messageHTTP 5xxÉchec réel — routé via la politique Fail on error du dashboard
Le statut HTTP signale "terminé vs erreur" ; le verdict réside dans le JSON. Les blocages par rail et les pannes temporaires sont distinguables, faisant de Fail on error: false l'option par défaut sécurisée.
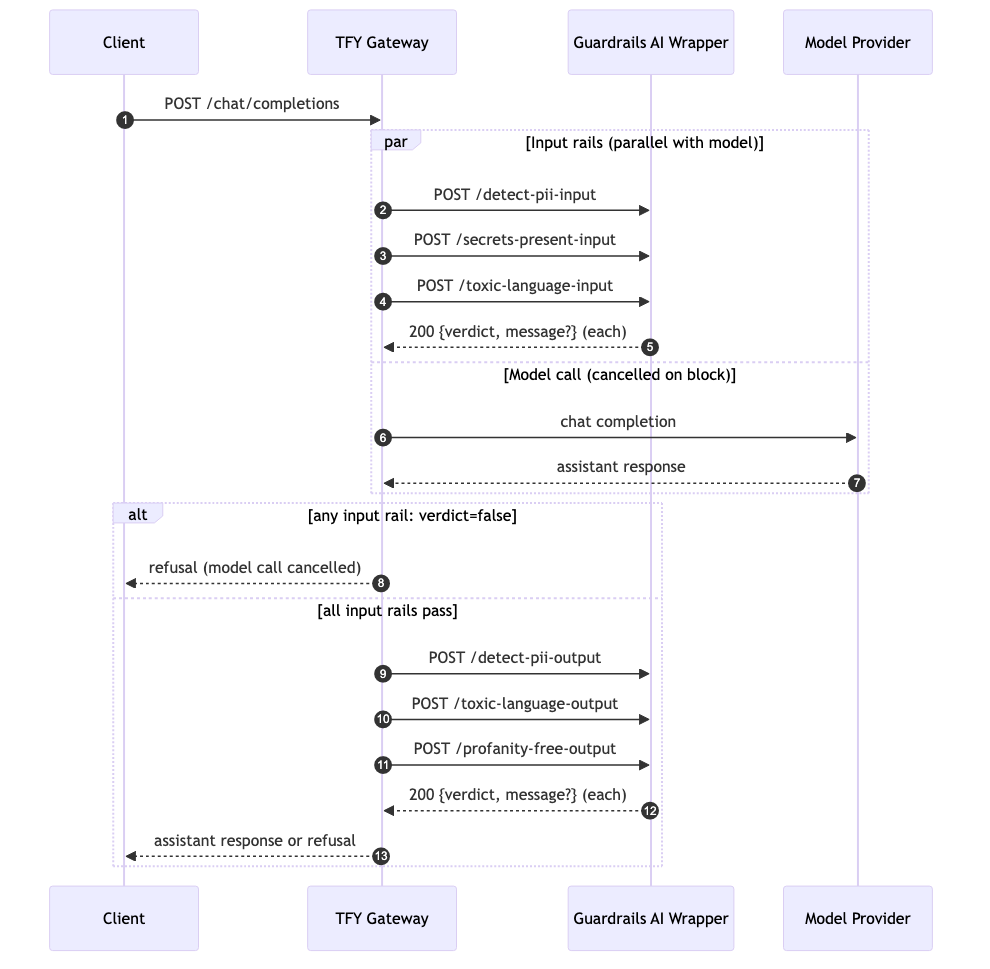
X-TFY-GUARDRAILS).{"verdict": false, "message": "<validator>: <reason>"} ; tous ceux qui réussissent renvoient {"verdict": true}.Puisqu'aucun validator ne fait appel à un LLM externe, la latence ajoutée par rail est principalement dominée par l'exécution Python et l'inférence du classifieur — généralement bien en dessous de 100 ms sur un pod chaud, sans aucune dépendance externe susceptible d'échouer.
Le wrapper est livré sous la forme d'un service FastAPI unique déployable via le SDK Python standard de TrueFoundry. Configurez l'URL du wrapper et la clé bearer en tant que Custom Guardrail par validator dans le dashboard, rattachez les rails à un modèle ou sélectionnez-les par requête, et les validators s'exécuteront en ligne sur chaque appel. L'implémentation de référence se trouve dans le répertoire integrations/guardrails-ai/ du dépôt integrations-custom-guardrails ; consultez la documentation sur les guardrails personnalisés TrueFoundry pour le flux dans le dashboard et le catalogue Guardrails Hub pour d'autres validators.
Le principe architectural repose sur la séparation nette entre la complexité des validators et l'exécution du gateway. Le gateway reste sans état, limité par le CPU et exempt de dépendances externes dans le chemin de requête. Les analyseurs Presidio, les plugins detect-secrets et l'inférence Hugging Face résident tous derrière une seule frontière HTTP. Remplacer un moteur de validator par un autre à l'avenir nécessitera simplement une modification du wrapper — la configuration du dashboard, le contrat et les applications appelantes resteront strictement identiques.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception















