



novembre 20, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Published: novembre 20, 2026

Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
Les comparaisons directes de modèles posent généralement la mauvaise question. « Terra ou Flash ? » implique que vous devez vous engager avec l'un d'eux. Pourtant, GPT-6.1 Terra et Gemini 3.6 Flash occupent le même échelon : des modèles de code intermédiaires, à grand contexte, performants mais non-flagship, vendus à des prix très proches. Lorsque deux modèles sont aussi proches et substituables, l'erreur coûteuse est d'en choisir un et de le coder en dur. L'approche économique et résiliente consiste à router entre eux, à utiliser chacun là où il est meilleur ou moins cher, et à basculer vers l'autre en fallback lorsqu'un fournisseur rencontre des difficultés.
Cet article compare les deux modèles sur les dimensions essentielles (prix, contexte, code, vitesse), toutes rapportées et sous réserve, puis présente le véritable argument : traitez-les comme des cibles interchangeables dans une politique de routage, avec un modèle flagship au-dessus pour les tâches les plus complexes.
Note sur la précision : à l'exception des chiffres de Claude utilisés comme référence, toutes les spécifications ci-dessous proviennent de rapports tiers datant de novembre 2026, et certaines sources se contredisent. Vérifiez auprès des pages officielles d'OpenAI et de Google avant de vous appuyer sur ces chiffres.
Vous souhaitez router entre des modèles intermédiaires par tâche et par prix, avec fallback automatique ? Réservez une démo.
GPT-6.1 Terra aurait été publié vers le 26 octobre 2026, en tant que membre de la gamme intermédiaire GPT-6.1 d'OpenAI. Profil rapporté : 1 $ par million de tokens d'entrée, 5 $ par million de tokens de sortie, une fenêtre de contexte d'environ 1,05M, et un Coding Index d'environ 48. Sa caractéristique remarquable est son prix : à un tarif rapporté de 1 $ / 5 $, il atteint environ la moitié du coût par token de GPT-6.1 Sol (rapporté à 2 $ / 10 $) tout en conservant, selon les rapports, une grande partie des capacités de code de Sol.
Gemini 3.6 Flash aurait été publié vers juillet 2026 en tant que modèle intermédiaire d'optimisation de vitesse de Google. Profil rapporté : 1,50 $ par million de tokens d'entrée, 7,50 $ par million de tokens de sortie, une fenêtre de contexte de 1M, un débit proche de 280 tokens par seconde, un Intelligence Index proche de 50 et un SWE-Bench Pro d'environ 58,7 %. Sa caractéristique remarquable est la combinaison de capacités en code et de vitesse à un prix intermédiaire.

Tarifs/benchmarks tels que rapportés en novembre 2026 ; vérifiez auprès de la page de tarification officielle de chaque fournisseur avant de vous y fier — les caractéristiques des modèles changent fréquemment. Les chiffres de Claude, lorsqu'ils sont mentionnés ailleurs, sont les seules données confirmées par l'éditeur.
Quelques avertissements importants sur la lecture de ce tableau :
La conclusion vers laquelle tend le tableau n'est pas « Terra gagne » ou « Flash gagne ». C'est que ces deux modèles sont suffisamment proches pour être substituables, et des modèles substituables sont exactement ce entre quoi vous voulez router.
Lorsque deux modèles sont substituables, s'engager sur un seul ne vous apporte rien et vous coûte deux choses : vous perdez la capacité d'utiliser le modèle le plus adapté par tâche, et vous subissez le risque de panne d'un fournisseur unique. Router entre eux résout ces deux problèmes.
Le prix rapporté plus bas de Terra en fait le choix par défaut pour le trafic à forte émission de tokens de sortie et sensible aux coûts : génération en masse, longues conversations, code quotidien à fort volume. L'avantage rapporté de Flash en matière de code et de vitesse en fait la cible privilégiée pour les requêtes à forte composante de code ou les parcours sensibles à la latence où un débit de ~280 tokens/sec importe. Vous n'avez pas à choisir de manière globale ; vous choisissez par classe de tâche. C'est ce qu'on appelle la sélection de modèles basée sur le coût et la qualité, et le mécanisme sous-jacent est un LLM router.
Puisqu'ils sont substituables, chacun constitue un fallback naturel pour l'autre. Configurez Terra comme modèle principal avec Flash en fallback (ou l'inverse), et une erreur de fournisseur, un timeout ou une limite de débit sur l'un est absorbé par l'autre. L'utilisateur constate une réponse légèrement plus lente, et non un échec. C'est la valeur centrale du LLM fallback : deux modèles intermédiaires interchangeables vous offrent une redondance de fournisseur presque gratuite, car vous alliez de toute façon utiliser l'un d'entre eux.
Aucun des deux n'est un modèle flagship. Pour le code agentique à long horizon ou le raisonnement profond, tous deux doivent escalader vers une catégorie flagship (Claude Opus 5.5 est une valeur sûre confirmée ; GPT-6.1 Sol et Gemini 3.1 Pro sont des équivalents rapportés). Le duo intermédiaire gère le gros du volume ; le flagship traite la partie complexe. La transition se fait via une règle de routage.
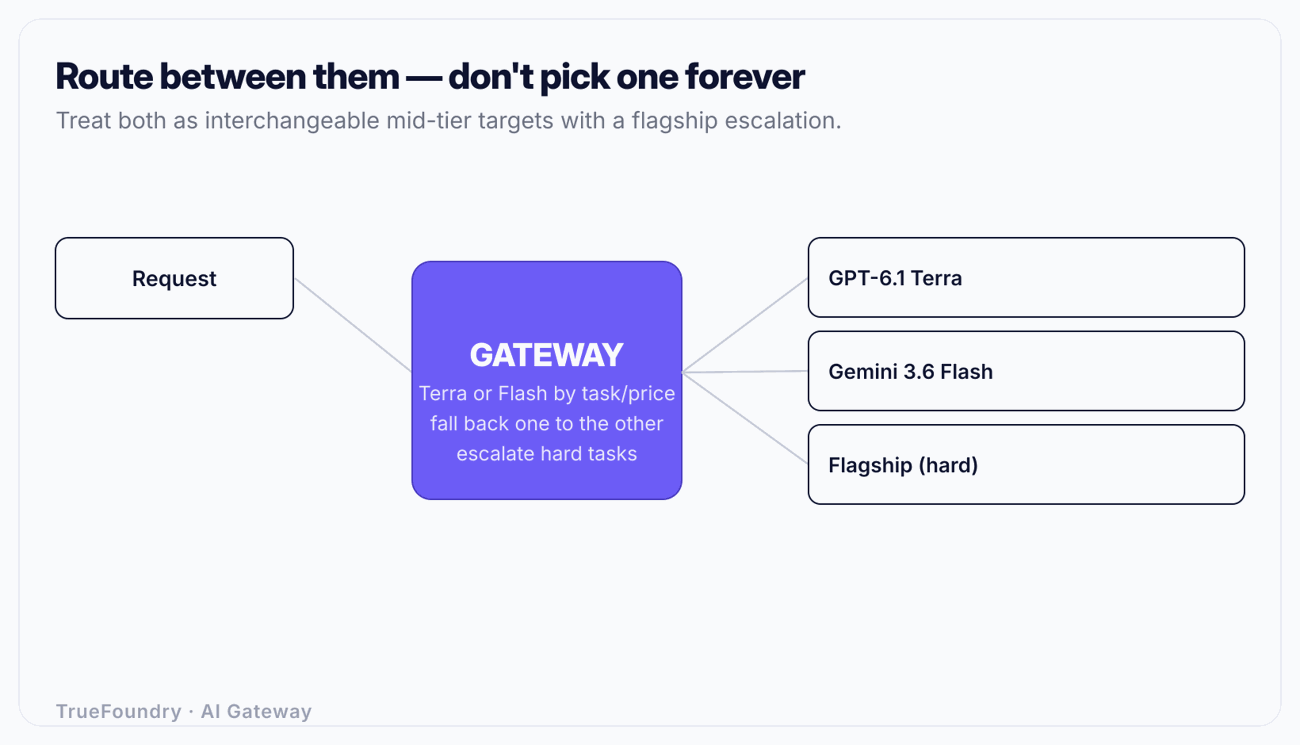
Découvrez comment TrueFoundry traite les modèles interchangeables dans une politique de routage unique. Réservez une démo.
Tarifs/benchmarks tels que rapportés en novembre 2026 ; vérifiez auprès de la page de tarification officielle de chaque fournisseur avant de vous y fier — les caractéristiques des modèles changent fréquemment.
Remarquez que la plupart des lignes associent les deux modèles en tant que principal et fallback plutôt que de choisir l'un à l'exclusion de l'autre. C'est l'objectif de cette conception : vous ne choisissez pas un gagnant, vous attribuez des rôles qui peuvent s'inverser.
La politique ci-dessus n'est utile que s'il est simple de la définir et de la modifier. Une passerelle AI dotée d'une API unifiée et compatible OpenAI vous offre cette flexibilité. Votre application appelle un alias stable ; la passerelle décide si la requête arrive sur Terra, sur Flash ou sur un flagship, et gère le comportement en cas d'erreur.
Comme les deux modèles utilisent des alias, l'arrivée de GPT-6.2 ou Gemini 3.7, ou une baisse de prix sur l'un d'eux, nécessite une simple modification de configuration. Votre politique de routage s'adapte ; votre application ne change pas.
Prenons un outil pour développeurs envoyant 4M de requêtes de code intermédiaires par mois, avec une forte émission de tokens de sortie à environ 600 tokens d'entrée et 1 500 tokens de sortie par requête (la génération de code produit beaucoup de tokens).
La sortie prédomine ici, le prix de sortie est donc le levier principal. Au tarif rapporté de Terra de 5 $ / 1M de tokens de sortie, 1 500 tokens de sortie par requête coûtent environ 0,0075 $ par requête en sortie. Au tarif rapporté de Flash de 7,50 $ / 1M, la même requête coûte environ 0,01125 $ en sortie, soit environ 50 % de plus. Sur 4M de requêtes, cette différence est substantielle.
Cependant, Flash obtiendrait de meilleurs résultats en code et s'exécuterait plus rapidement. La politique n'est donc pas « tout sur Terra ». Elle consiste à : router le gros de la génération de routine vers Terra pour bénéficier de l'avantage sur le prix de sortie, router les requêtes de code plus complexes ou sensibles à la latence vers Flash, et basculer sur l'autre en cas d'erreur. Vous suivez ensuite le coût et la qualité par modèle dans l'outil d'observabilité et ajustez la répartition. Si la qualité de Terra se maintient sur votre trafic, vous augmentez sa part ; si l'avantage de Flash en code se traduit par moins de tentatives supplémentaires, cela modifie le calcul. La seule façon de le savoir est de mesurer, c'est pourquoi le routage et l'observabilité forment un système unique.
Les tentatives supplémentaires modifient ce calcul d'une manière que les tableaux de prix bruts ne montrent pas. Si la sortie de Terra est 33 % moins chère mais produit une réponse erronée qui nécessite un second appel 5 % plus souvent que Flash, ce taux de nouvelle tentative consomme une partie de l'avantage tarifaire, car une requête réessayée est payée deux fois. C'est pourquoi une comparaison de prix bruts peut être trompeuse et qu'il faut mesurer le coût effectif par réponse réussie, et non le coût par appel. Un modèle nominalement moins cher mais nécessitant plus de reessais peut s'avérer plus coûteux sur du trafic réel, et la seule façon de le constater est d'utiliser une observabilité par modèle qui suit à la fois le coût et le taux d'échec sur vos propres requêtes.
Pour éviter qu'un chemin d'escalade ne génère des dépenses excessives sans contrôle, limitez le niveau flagship avec le limiteur de débit de tokens et de budget afin qu'une escalade incontrôlée renvoie une erreur HTTP 429 plutôt qu'une facture imprévue.
GPT-6.1 Terra et Gemini 3.6 Flash ne s'affrontent pas dans un duel avec un unique vainqueur. Ce sont deux modèles intermédiaires interchangeables, dont les prix s'écartent de moins d'un tiers, intégrant tous deux ~1M de contexte, avec chacun un léger avantage rapporté que l'autre n'a pas : Terra sur le prix, Flash sur le code et la vitesse. Quand des modèles sont aussi proches, la question n'est pas de savoir lequel couronner, mais comment utiliser les deux.
Routez entre eux par tâche et par coût, basculez de l'un à l'autre pour obtenir une redondance de fournisseur quasi gratuite, et n'escaladez vers un flagship que pour les tâches les plus complexes. Définissez l'ensemble comme une politique sur une passerelle derrière une API unique compatible OpenAI, et la prochaine version ou baisse de tarif de l'un des fournisseurs deviendra une modification de configuration plutôt qu'une migration. C'est ainsi que vous tirez le meilleur parti des deux sans engager toute votre architecture sur un seul.
Routez entre Terra et Flash au lieu de devoir en choisir un seul. Réservez une démo.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception





