



novembre 20, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Published: novembre 20, 2026

Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
La plupart des équipes n'ont pas un problème de modèle phare. Elles ont un problème de modèle par défaut. Le modèle qui répond à la requête médiane, celui qui gère la longue traîne du chat, du résumé, du codage quotidien et des réponses basées sur le RAG, est celui où la facture s'accumule réellement, car c'est là que se trouve le volume. Gemini 3.6 Flash est précisément intéressant parce qu'il est conçu pour cette place par défaut : suffisamment performant pour que les utilisateurs ne remarquent pas de baisse de qualité par rapport à un modèle phare, et suffisamment bon marché pour que vous puissiez lui envoyer tout votre trafic.
Cet article détaille ce qu'est Gemini 3.6 Flash (tel que rapporté en novembre 2026), où il se situe entre les petits modèles d'entrée de gamme et les modèles phares, quand le choisir et quand l'éviter, ainsi que le schéma de passerelle qui vous permet d'en faire votre choix par défaut tout en escaladant les requêtes qui nécessitent réellement plus de capacités.
Une précision concernant l'exactitude des données : à l'exception des chiffres de Claude, les spécifications ci-dessous proviennent de rapports tiers et de sources qui se contredisent parfois. Considérez-les comme un point de départ et vérifiez-les auprès des pages officielles des modèles et des tarifs de Google avant toute implémentation. Les spécifications des modèles évoluent fréquemment.
Vous souhaitez router la majeure partie de votre trafic vers un modèle de classe Flash et n'escalader que les requêtes difficiles ? Réservez une démo.
Gemini 3.6 Flash aurait été lancé vers juillet 2026 en tant que modèle intermédiaire optimisé pour la vitesse dans la gamme Gemini 3.x de Google. Le profil rapporté est le suivant :
En résumé : un modèle qui vous offre l'essentiel de l'utilité quotidienne d'un modèle phare, à un tarif intermédiaire, avec un contexte de classe phare et un débit élevé. Cette combinaison définit exactement ce que doit être un modèle par défaut.
Tarifs/benchmarks tels que rapportés en novembre 2026 ; vérifiez auprès de la page de tarification officielle de chaque fournisseur avant de vous appuyer dessus — les spécifications des modèles changent fréquemment.
Si votre compte ou votre région n'affiche pas encore 3.6 Flash, l'alternative sûre et disponible de manière générale est Gemini 3.5 Flash. Considérez 3.6 comme la cible et 3.5 GA comme la solution de secours jusqu'à ce que vous ayez confirmé l'accès direct à 3.6.
La façon la plus utile de penser à Flash est de le voir comme le barreau central d'une échelle à trois niveaux. En dessous se trouve l'entrée de gamme. Au-dessus se trouvent les modèles phares. Chaque barreau a un rôle précis.
Entrée de gamme (environ 0,10 $ à 0,25 $ en entrée). Claude Haiku 5.5 est confirmé à partir de 0,10 $ / 0,50 $. GPT-6 Luna (rapporté) se situe à 0,10 $ / 0,50 $ et Gemini 3.1 Flash-Lite vers 0,25 $ / 1,50 $. Ces modèles sont destinés à la classification, l'extraction, le routage et d'autres tâches courtes et non ambiguës. Sur le prix d'entrée, ils sont environ 15 fois moins chers que Flash. Ils ne sont pas aussi performants, et ce n'est d'ailleurs pas leur objectif.
Modèle de travail de classe Flash (environ 1 $ à 2 $ en entrée). Gemini 3.6 Flash à un tarif rapporté de 1,50 $ / 7,50 $, aux côtés d'équivalents comme Claude Sonnet 5.5 (confirmé à 2 $ / 10 $) et GPT-6.1 Terra (rapporté à 1 $ / 5 $). C'est le niveau par défaut : chat, résumé, réponses RAG, codage quotidien, tout ce qui nécessite une réelle compétence sans exiger le raisonnement le plus profond.
Modèles phares (environ 2 $ à 10 $ en entrée, coût de sortie élevé). Gemini 3.1 Pro (rapporté à 2 $ / 12 $), Claude Opus 5.5 (confirmé à 4 $ / 20 $), GPT-6 Astra rapporté à (10 $ / 50 $). Ils ne justifient leur prix que sur la tranche complexe : codage agentique à long terme, raisonnement profond, analyses difficiles.

L'intérêt de cette échelle est que chaque niveau est séparé d'environ un ordre de grandeur en prix ou en performance. Envoyer une requête au mauvais niveau est donc coûteux dans un sens et médiocre en qualité dans l'autre. Flash est le niveau auquel appartient la majeure partie de votre trafic.
Flash est le bon choix par défaut, mais pas la réponse adaptée à tous les besoins. Voici comment décider.
Tarifs/benchmarks tels que rapportés en novembre 2026 ; vérifiez auprès de la page de tarification officielle de chaque fournisseur avant de vous appuyer dessus — les spécifications des modèles changent fréquemment. Les chiffres de Claude sont confirmés par l'éditeur.
Découvrez comment TrueFoundry utilise par défaut des modèles économiques et bascule automatiquement en cas d'erreur. Réservez une démo.
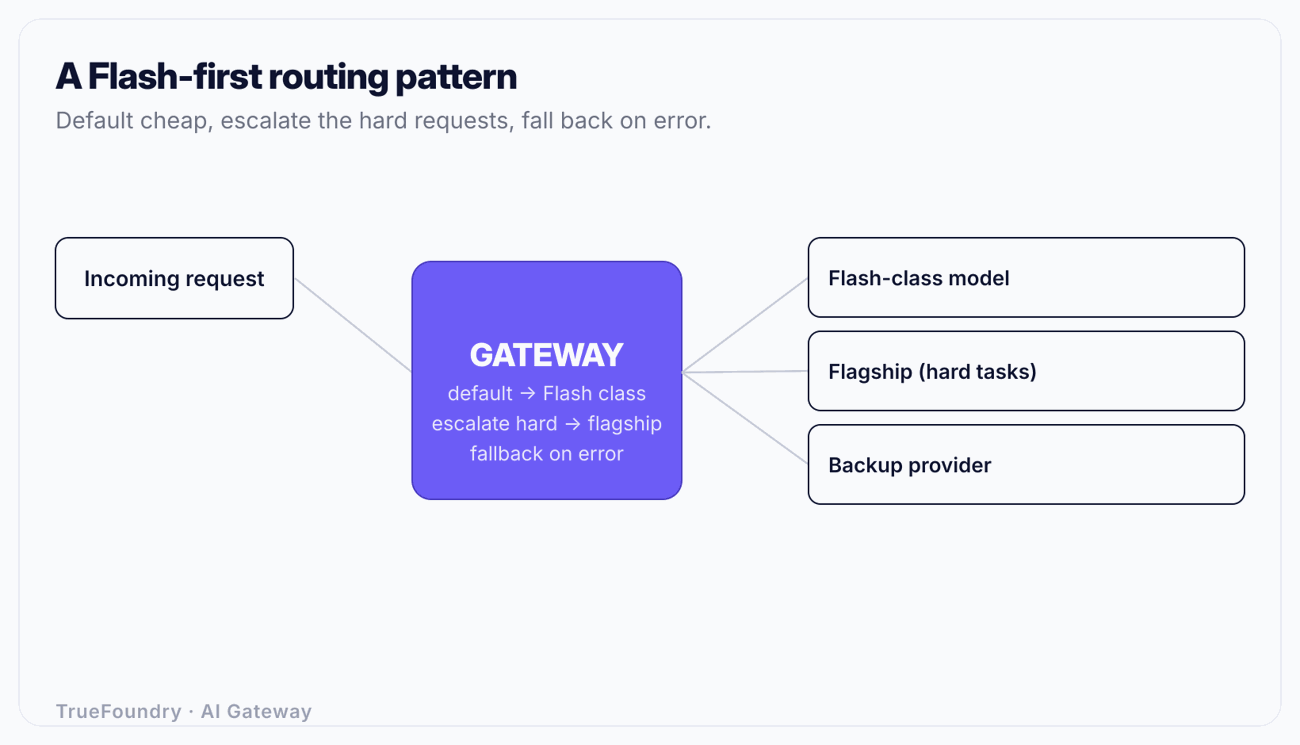
Savoir que Flash doit être votre modèle par défaut ne suffit pas. Il vous faut un mécanisme qui envoie l'essentiel du trafic vers Flash, identifie les requêtes nécessitant plus de ressources, n'escalade que celles-ci, et ne flanche pas lorsque Google subit une panne de cinq minutes. Ce mécanisme est une passerelle AI dotée d'une API unifiée compatible OpenAI.
Voici le schéma en quatre étapes.
1. Configurez Flash comme route par défaut. Associez un alias de modèle (par exemple, default-chat) à Gemini 3.6 Flash dans la configuration de la passerelle. Votre application appelle default-chat ; elle n'écrit jamais en dur "gemini-3.6-flash". Lorsque vous souhaitez tester Sonnet 5.5 ou Terra par défaut à la place, vous modifiez une seule ligne de configuration et basculez un pourcentage du trafic, sans aucun déploiement d'application. C'est l'application pratique de la sélection de modèles axée sur le coût et la qualité, et le concept sous-jacent à ce que fait un routeur LLM.
2. Escaladez les requêtes complexes. Marquez les requêtes qui nécessitent plus de capacités (un signal de complexité de votre application, un endpoint spécifique, un nouvel essai après une réponse à faible confiance) pour que la passerelle les achemine vers un alias de modèle phare. La majeure partie du trafic reste sur Flash ; seule la fine tranche complexe paie les tarifs des modèles phares. Ce contrôle est une règle de routage, et non des branches de code dispersées dans vos services.
3. Basculez en cas d'erreur. Configurez Flash pour qu'il bascule vers un second fournisseur lorsque Google renvoie une erreur ou expire. Une requête destinée à la classe Flash peut basculer sur Claude Sonnet 5.5 ou GPT-6.1 Terra. Les re-tentatives au sein de la requête et le basculement entre fournisseurs garantissent qu'un incident chez un prestataire devient une légère hausse de latence, et non une interruption de service. Voir ce qu'est le basculement (fallback) LLM.
4. Mettez en cache et mesurez. La mise en cache exacte et sémantique vous évite de payer Flash pour répondre deux fois à la même question ; voir la mise en cache sémantique. Chaque appel est enregistré avec ses tokens, sa latence et son coût étiquetés par utilisateur, équipe et modèle, vous permettant de prouver que Flash absorbe le volume et que le modèle phare ne traite que la tranche complexe. Voir les outils d'observabilité LLM.
Prenons un produit traitant 5 millions de requêtes par mois, principalement du chat et du RAG, avec une traîne de raisonnement complexe. Supposons la répartition suivante : 75 % de tâches quotidiennes (adaptées à Flash), 20 % de tâches triviales (adaptées à l'entrée de gamme), 5 % de tâches complexes (adaptées aux modèles phares), avec une moyenne de 800 tokens d'entrée et 400 tokens de sortie.
Si tout s'exécute sur un modèle phare à 2 $ / 12 $, vous payez le tarif de sortie du modèle phare sur l'ensemble des 5 millions de requêtes, y compris les 3,75 millions auxquelles Flash aurait répondu de manière identique et le million auquel un modèle à 0,10 $ aurait répondu exactement de la même façon.
Si vous routez par niveau à la place :
La tranche triviale de 20 % voit son coût d'entrée divisé par environ 15 en délaissant Flash pour le niveau d'entrée de gamme. La tranche quotidienne de 75 % passe de la sortie du modèle phare (12 $) à la sortie de Flash (7,50 $), soit une réduction de près de 40 % sur le composant de coût principal. La tranche complexe de 5 % conserve le modèle phare. L'effet net sur la plupart des flux de tokens réels est une réduction de la facture de nettement plus d'un tiers, sans aucune perte de qualité, car chaque requête est traitée par un modèle dimensionné pour elle. Vous ne pouvez confirmer ce chiffre qu'en mesurant le coût par niveau, c'est pourquoi les briques d'observabilité et d'attribution des coûts comptent tout autant que le routage.
Pour éviter que le niveau phare n'impacte l'enveloppe budgétaire en silence, fixez un plafond avec la limitation de débit de tokens et les budgets : la passerelle renvoie un code HTTP 429 lorsqu'une équipe ou un modèle dépasse sa limite, empêchant ainsi une trajectoire d'escalade d'engendrer des surcoûts incontrôlés.
Gemini 3.6 Flash est conçu pour l'emplacement où se situe la majeure partie de vos dépenses : la requête médiane. Rapporté à 1,50 $ / 7,50 $ avec une fenêtre de contexte de 1M et un débit élevé, il vous offre la plupart des capacités quotidiennes d'un modèle phare sans en payer le prix, et se situe nettement au-dessus du niveau d'entrée de gamme qui doit continuer à gérer vos tâches triviales. Le bon modèle mental est une échelle, et Flash est le barreau auquel appartient la majeure partie du trafic.
Faites-en votre modèle par défaut sur une passerelle, n'escaladez que les requêtes difficiles vers un modèle phare, basculez vers un second fournisseur lorsque Google rencontre un problème, et mesurez le coût par modèle pour vérifier l'efficacité de la répartition. Ce faisant, l'utilisation de Gemini 3.6 Flash cesse d'être une décision ponctuelle pour devenir une politique de routage que vous pouvez ajuster dès qu'un nouveau modèle ou une baisse de prix survient.
Routez vers le modèle le moins cher qui soit suffisamment performant. Réservez une démo.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception





