



novembre 20, 2026
|
5 min de lecture


Accédez instantanément à un environnement TrueFoundry en direct. Déployez des modèles, acheminez le trafic LLM et explorez la plateforme complète : votre sandbox est prête en quelques secondes, aucune carte de crédit n'est requise.



Published: novembre 20, 2026

Une méthode incroyablement rapide pour créer, suivre et déployer vos modèles !
« Quel est le meilleur LLM pour le codage ? » est la mauvaise question, car elle n'a pas de réponse stable. Le modèle qui écrit la fonction de 40 lignes la plus propre n'est pas celui que vous voulez voir consommer des tokens sur un refactoring de 30 fichiers, et le modèle qui résout un bug de concurrence complexe est surdimensionné pour autocompléter un getter. Les benchmarks changent toutes les quelques semaines. Une équipe qui code en dur un modèle unique dans son outillage en janvier remet en question cette décision dès avril.
La meilleure question est : pour cette classe de tâche de codage, avec ce budget, vers quel modèle dois-je orienter les requêtes — et comment garder les dépenses et la sécurité sous contrôle lorsque cent développeurs répondent chacun différemment à cette question ? C'est la question à laquelle répond cet article. Nous passons en revue les concurrents selon ce pour quoi ils sont réellement doués, nous vous fournissons un cadre de décision tâche-modèle qui survit à n'importe quel benchmark individuel, puis nous couvrons la partie que la plupart des équipes négligent : la couche de routage et de gouvernance qui fait du choix de modèle une valeur de configuration plutôt qu'une réécriture de code.
Une note de précision d'emblée. La tarification de Claude d'Anthropic ci-dessous est vérifiée en date de novembre 2026. Les chiffres des benchmarks concurrents sont des données rapportées ou agrégées ; nous les attribuons et les datons, et vous devriez les re-vérifier auprès de chaque fournisseur avant de leur engager du budget.
Vous souhaitez un suivi des coûts par développeur et des guardrails sur chaque modèle de codage ? Réservez une démo.
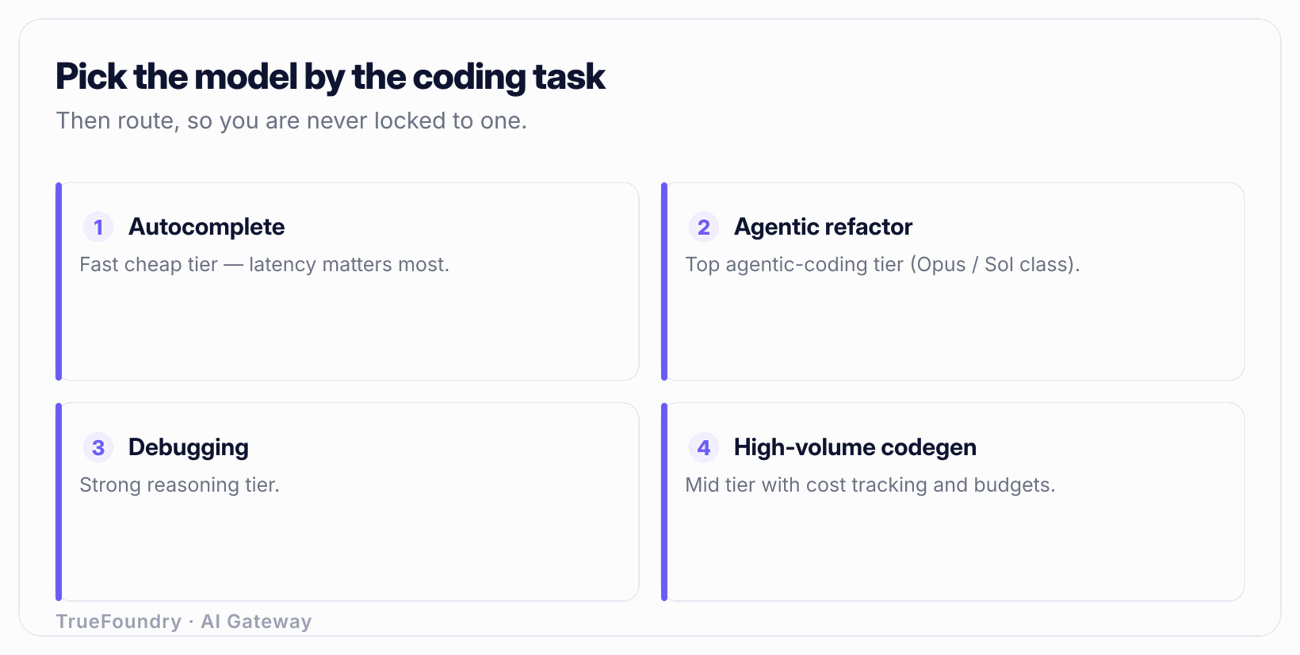
Avant de pouvoir choisir un modèle, vous devez nommer la tâche. La plupart des comparaisons du « meilleur LLM de codage » échouent parce qu'elles établissent des moyennes entre des tâches aux exigences opposées. Divisez le codage en quatre formes et le choix devient beaucoup plus clair.
Saisie semi-automatique / complétion inline. Le modèle prédit les quelques lignes suivantes pendant que vous tapez. La latence fait tout — tout ce qui dépasse environ 300 à 500 ms rompt le flux de travail. Le contexte est restreint (le fichier actuel plus quelques fichiers voisins). Vous effectuez des milliers de ces appels par développeur et par jour, le coût unitaire domine donc. Vous voulez un modèle rapide et bon marché, pas le plus intelligent.
Refactoring agentique multi-fichiers. Le modèle planifie, lit de nombreux fichiers, en modifie plusieurs, exécute des tests et itère — une boucle qui peut s'exécuter pendant plusieurs minutes et consommer des centaines de milliers de tokens en une seule tâche. C'est là que la profondeur de raisonnement, la cohérence sur de longs contextes et la capacité à s'en tenir au plan sur de nombreuses étapes portent leurs fruits. C'est aussi là qu'un modèle faible coûte le plus cher, car il brûle des tokens à hésiter pour finalement vous livrer un diff cassé.
Débogage approfondi. Un problème difficile : une race condition, une fuite de mémoire, un heisenbug qui ne s'affiche qu'en charge. Le volume est faible, mais la valeur d'une résolution correcte est élevée. Vous recherchez une qualité de raisonnement maximale et êtes prêt à la payer au cas par cas.
Codegen à grand volume. Structuration, code boilerplate, stubs de test, scripts de migration, docstrings — de grandes quantités de code simple. Les exigences de qualité sont modérées ; le débit et le coût par génération dominent. Un modèle de milieu de gamme l'emporte généralement sur le coût total de possession.
Ces quatre formes correspondent rarement à un seul modèle. Le même développeur, au cours de la même heure, souhaite un modèle rapide et bon marché pour les complétions, un modèle de raisonnement approfondi pour le bug sur lequel il est bloqué, et un modèle agentique puissant pour le refactoring qu'il a lancé en arrière-plan. C'est la raison structurelle pour laquelle la standardisation sur un modèle unique échoue.
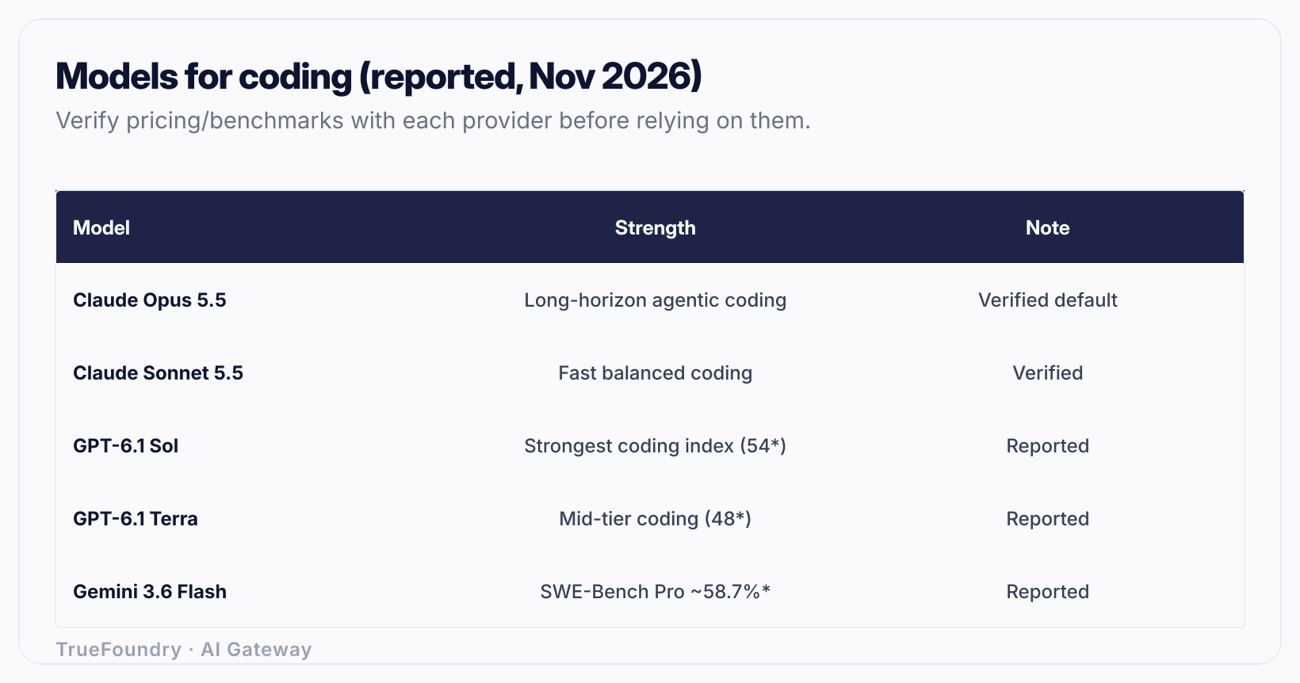
Voici l'état des lieux honnête en date de novembre 2026. Les prix pour Claude sont vérifiés ; le reste est rapporté et doit être réinventorié.
La génération 5.5 de Claude se répartit clairement selon les formes de tâches ci-dessus :
Le schéma pratique est une stratégie de segmentation par niveaux au sein même de Claude — Haiku pour les complétions et le traitement de masse, Sonnet pour la plupart des travaux d'agent, Opus pour les refactorings difficiles et les sessions de débogage bloquées.
À compter de novembre 2026, les rapports placent GPT-6.1 Sol au sommet des capacités générales de codage, avec un « Coding Index » agrégé d'environ 54, et GPT-6.1 Terra un cran derrière à environ 48. Sol est positionné comme un modèle de codage de frontière ; Terra comme une tranche plus rapide et plus économique. Traitez les chiffres de l'index comme des ordres de grandeur — ils proviennent d'agrégations tierces, et non d'un banc d'essai standardisé unique, et les prix ainsi que les noms de niveaux d'OpenAI doivent être confirmés sur leur site avant d'engager du budget.
Gemini 3.6 Flash est rapporté à environ 58,7 % sur SWE-Bench Pro, un benchmark qui mesure les corrections réelles de type pull-request par rapport à de véritables dépôts. Si ce chiffre se confirme, Flash est compétitif sur des tâches pratiques d'ingénierie logicielle à un niveau positionné pour la vitesse et le coût. Encore une fois : données rapportées en novembre 2026, à vérifier auprès de Google.
SWE-Bench et les indices de codage mesurent la capacité d'un modèle à produire un patch correct sur des problèmes sélectionnés. Ils ne mesurent pas la façon dont un modèle se comporte au sein de votre agent, sur votre codebase, avec vos outils et vos limites de contexte. Un modèle qui obtient deux points de plus sur un benchmark public peut perdre lourdement en pratique s'il est plus lent, a une fenêtre de contexte effective plus restreinte, ou gère moins bien votre langage et votre framework. Utilisez les benchmarks pour établir une pré-sélection, puis exécutez votre propre évaluation sur des tâches qui ressemblent à votre travail réel.
Voici le paysage rapporté dans un tableau. Lisez la ligne de mise en garde en dessous avant de citer l'un de ces chiffres.
Mise en garde : Les prix de Claude sont vérifiés en date de novembre 2026. Tous les chiffres des concurrents sont des données tierces rapportées ou agrégées en date de novembre 2026 et ne sont pas directement comparables sur des bancs d'essai différents — ré-vérifiez les spécifications, la disponibilité et les prix auprès de chaque fournisseur avant de vous appuyer dessus.
Au lieu de choisir « le meilleur modèle », choisissez une option par défaut par forme de tâche et un parcours d'escalade. C'est la partie qui reste vraie lorsque le classement du mois prochain est remanié.
La logique : commencez chaque tâche au niveau le moins cher qui réussit de manière fiable, et n'escaladez que sur un signal concret — les tests échouent, le diff est trop important, l'agent tourne en boucle. Un refactoring qu'un modèle de milieu de gamme raterait en dix itérations coûteuses revient moins cher sur un modèle de premier plan qui le réussit en deux. Une complétion qu'un modèle haut de gamme réussirait reste un mauvais endroit où dépenser, car vous passez cet appel dix mille fois par jour.
Remarquez ce que ce cadre exige sur le plan opérationnel : la capacité d'envoyer différentes requêtes à différents modèles en fonction du type de tâche et des signaux, sans réécrire l'application. C'est le rôle du routage, et c'est là qu'intervient une gateway. Consultez la sélection de modèles axée sur les coûts et la qualité pour savoir comment cette logique est encodée, et ce qu'est un routeur LLM pour les aspects mécaniques.
Découvrez comment TrueFoundry achemine le trafic de codage et plafonne les dépenses par développeur. Réservez une démo.
Imaginez une entreprise de 200 développeurs. Certains travaillent dans Cursor, d'autres dans Claude Code, quelques-uns jurent par Copilot dans VS Code, et l'équipe data appelle directement les modèles depuis des notebooks. Chaque outil utilise par défaut des modèles différents, et chaque développeur a ses préférences. Même si vous imposiez un modèle aujourd'hui, un meilleur modèle sortira dans six semaines et vos meilleurs ingénieurs trouveront un moyen de contourner la directive.
Il ne s'agit pas d'un manque de discipline. C'est l'état final logique. Différentes tâches nécessitent différents modèles, différents outils exposent différents modèles et la frontière évolue chaque mois. Lutter contre cette fragmentation est une bataille perdue d'avance. La décision gagnante consiste à cesser d'essayer de standardiser le modèle pour plutôt standardiser le point de contrôle devant les modèles.
Concrètement, cela signifie que chaque agent de codage de l'organisation — Claude Code, Cursor, Copilot, scripts maison — pointe vers un point d'accès unique compatible OpenAI au lieu d'appeler directement l'API de chaque fournisseur. Derrière ce point d'accès, vous décidez du routage, vous voyez chaque requête et vous appliquez votre politique. Le modèle devient une valeur de configuration. Remplacer Sonnet par un modèle plus récent, ou ajouter GPT-6.1 Sol comme escalade de débogage, est une modification de configuration, pas une migration de code sur l'ensemble du parc.
Une AI gateway se place entre vos agents de codage et les fournisseurs de modèles, exposant une API unifiée compatible OpenAI. Pour le codage en particulier, quatre capacités sont essentielles.
Attribution des coûts par développeur, équipe et modèle. Les agents de codage sont gourmands en tokens d'une manière qui surprend la finance. Un refactoring agentique peut consommer plus de 300 000 tokens en une seule tâche. Sans attribution, vous obtenez une facture globale indifférenciée du fournisseur sans savoir si la dépense provient des refactorings de l'équipe plateforme ou de la boucle folle d'un développeur. La gateway étiquette chaque requête avec l'utilisateur, l'équipe et le modèle, afin que vous puissiez répondre à la question « qui a dépensé quoi sur quel modèle » jusqu'à la requête individuelle. C'est le fondement de l'attribution des coûts et des budgets d'équipe et du FinOps pour l'IA en général.
Budgets et limites de débit par développeur ou équipe. Définissez un budget mensuel en dollars par équipe et une limite de débit de requêtes par développeur. Lorsqu'une limite est dépassée, la gateway renvoie un code HTTP 429 au lieu de laisser monter la facture en silence. C'est ce qui empêche un agent mal configuré qui tourne en boucle de se transformer en une surprise à cinq chiffres du jour au lendemain. Le fonctionnement est détaillé dans la section sur le rate limiting des tokens et les budgets.
Guardrails contre les fuites de secrets. Les agents de codage lisent votre code source. Le code source contient des identifiants codés en dur, des noms d'hôtes internes, des données clients dans des jeux de test (fixtures) et des PII dans des fichiers de test. Chacun de ces éléments peut être envoyé à un fournisseur de modèles dans un prompt. Une gateway peut analyser les requêtes sortantes à la recherche de secrets et de PII et les bloquer ou les caviarder avant qu'elles ne quittent votre réseau. Pour une organisation réglementée, c'est souvent la différence entre « approuvé » et « interdit ». Consultez la page sur les AI guardrails pour connaître les types de détection.
Audit et observabilité. Une piste d'audit unique pour chaque requête — qui, quel modèle, combien de tokens, latence, coût, réussite/échec des guardrails. Lorsque la sécurité demande « est-ce que notre code a fui vers un modèle externe au trimestre dernier », vous avez une réponse précise plutôt qu'un haussement d'épaules. Associez les logs de la gateway à vos outils d'observabilité LLM pour le suivi de la latence et de la qualité dans le temps.
L'AI gateway de TrueFoundry fournit exactement cette couche de contrôle — une API unifiée compatible OpenAI avec routage par latence/poids/priorité, basculement automatique et réessais intégrés, mise en cache exacte et sémantique, budgets et limites de débit par utilisateur/équipe/modèle, observabilité complète par requête et guardrails PII/secret/prompt-injection. Elle se déploie en SaaS, dans votre VPC, on-premise ou en environnement air-gapped, de sorte que le plan de données transportant votre code source reste à l'intérieur de votre réseau.
Rendons cela concret. Trois développeurs, une semaine, des travaux différents :
Trois développeurs, trois types de tâches, trois niveaux et une dépense hebdomadaire combinée proche de 40 $ — le refactoring complexe du développeur C coûtant environ 14 fois les complétions du développeur A. Imaginez maintenant 200 développeurs et aucune attribution : vous voyez une seule facture et ne pouvez pas distinguer le trafic légitime des dérives. Avec la gateway, vous voyez que le refactoring du développeur C était coûteux mais justifié, que les complétions du développeur A sont efficientes, et si l'agent d'un quatrième développeur commence à tourner en boucle à 2 heures du matin, le plafond budgétaire l'arrête avec un code 429 avant que cela ne devienne problématique.
Les chiffres ci-dessus utilisent les prix vérifiés de Claude et des chiffres arrondis à titre d'illustration ; vos volumes réels de tokens varieront. L'important est la structure : le type de tâche détermine le niveau, le niveau détermine le coût, et l'attribution est ce qui transforme un total global inquiétant en un poste budgétaire maîtrisé.
Courir après les classements. Les équipes choisissent à nouveau leur « modèle de codage unique » à chaque mise à jour d'un benchmark, en réécrivant l'outillage à chaque fois. L'écart du benchmark est généralement plus faible que le coût du changement. Choisissez des options par défaut par type de tâche, acheminez le trafic et laissez la gateway absorber les changements de modèles sous forme de configuration.
Tout acheminer vers le modèle haut de gamme. Utiliser Opus 5.5 ou GPT-6.1 Sol pour la saisie semi-automatique semble sûr mais s'avère discrètement ruineux — vous payez le prix fort sur les appels les plus fréquents et à plus faible valeur ajoutée. Adaptez le niveau à la tâche. Le modèle le moins cher qui réussit de manière fiable est le bon.
Pas d'attribution des coûts avant l'arrivée de la facture. De nombreuses équipes ne découvrent les dépenses liées aux agents de codage que lorsque la finance tire la sonnette d'alarme. Il est alors impossible de savoir quelle équipe ou quel comportement en est l'origine. L'attribution doit être en place avant de multiplier les accès, pas après.
Ignorer les fuites de secrets et de PII depuis le code. Le plus grand risque avec les agents de codage n'est pas le mauvais code, c'est la fuite du bon code. Les fichiers sources contiennent des identifiants et des données clients, et les agents les envoient à des modèles tiers. Si vous n'avez pas de guardrail sortant, vous exfiltrez des secrets et ne le découvrez que lors d'un bilan d'incident.
Traiter le choix du modèle comme une problématique applicative. Coder en dur les noms de modèles et les clés API dans chaque outil et service signifie que chaque changement de modèle nécessite un déploiement. Placez le choix derrière un point d'accès de gateway et la sélection du modèle devient une décision stratégique, prise une seule fois et appliquée partout.
Le « meilleur LLM pour le codage » est une cible mouvante, et chercher à l'atteindre en permanence est une course sans fin. La stratégie durable consiste à cesser de choisir un modèle unique pour gérer plutôt un portefeuille : un niveau rapide et économique pour les complétions et le volume, un niveau équilibré pour le travail d'agent au quotidien, et un niveau haut de gamme pour les refactorings difficiles et le débogage approfondi — avec un signal d'escalade clair entre eux. La répartition Opus/Sonnet/Haiku de Claude correspond presque parfaitement à ce cadre aujourd'hui, et les chiffres rapportés pour GPT-6.1 et Gemini vous offrent des options d'escalade et de comparaison que vous pouvez intégrer par simple configuration.
Ce qui rend ce portefeuille gouvernable, c'est la couche située devant lui. Acheminez chaque agent de codage via une AI gateway unique et le choix du modèle devient une valeur de configuration, le coût devient attribuable par développeur et par équipe, les budgets stoppent les dépenses incontrôlées avec des erreurs 429, et les guardrails empêchent les secrets de votre code source de fuiter vers un fournisseur. C'est ainsi que vous restez à la pointe sans perdre le contrôle de la facture ni de la zone d'impact.
Gouvernez l'utilisation des modèles de vos agents de codage depuis une seule gateway. Réservez une démo.
TrueFoundry AI Gateway offre une latence d'environ 3 à 4 ms, gère plus de 350 RPS sur 1 processeur virtuel, évolue horizontalement facilement et est prête pour la production, tandis que LiteLM souffre d'une latence élevée, peine à dépasser un RPS modéré, ne dispose pas d'une mise à l'échelle intégrée et convient parfaitement aux charges de travail légères ou aux prototypes.





Les dernières nouvelles, articles et ressources envoyés dans votre boîte de réception





