


noviembre 20, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



Published: noviembre 20, 2026

¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
La mayoría de los equipos descubren que necesitan una plataforma de evaluación de la misma manera: un cambio en un prompt que parecía correcto en un notebook sufre una regresión silenciosa en producción, un cliente hace una captura de pantalla de una respuesta con alucinaciones y nadie puede decir si la nueva versión del modelo es realmente mejor que la anterior o simplemente diferente. La pregunta "¿es buena esta aplicación de LLM?" no tiene respuesta hasta que no se ha construido la maquinaria para medirla.
Esa maquinaria es lo que proporcionan las plataformas de evaluación de LLM. Sin embargo, este campo genera mucho ruido. Algunas herramientas están centradas prioritariamente en las evals con tracing añadido. Otras priorizan la observabilidad con evals superpuestas. Algunas son librerías de código abierto que alojas tú mismo; otras son SaaS gestionados. Y la complicación más reciente son los agentes: evaluar un único par de prompt y finalización es un problema, pero evaluar un agente de diez pasos que llama a herramientas, recupera documentos y realiza bucles es un reto mucho mayor.
Esta guía aborda tres aspectos. Define el ciclo de vida de eval para que sepas qué capacidades necesitas realmente. Repasa las principales plataformas (Langfuse, Arize Phoenix, Braintrust, LangSmith, Comet Opik, Maxim, Helicone) detallando en qué destaca y en qué falla cada una. Y explica cómo encaja un AI gateway, ya que las trazas y los datos de costes que genera un gateway son la materia prima que consumen la mayoría de las plataformas de eval.
¿Quieres trazas por petición, costes y guardrails alineados junto con tus evals? Reserva una demo.
La evaluación no es un paso único que se ejecuta antes del lanzamiento. Es un bucle de cuatro etapas, y una plataforma seria debe dar soporte a todas ellas.
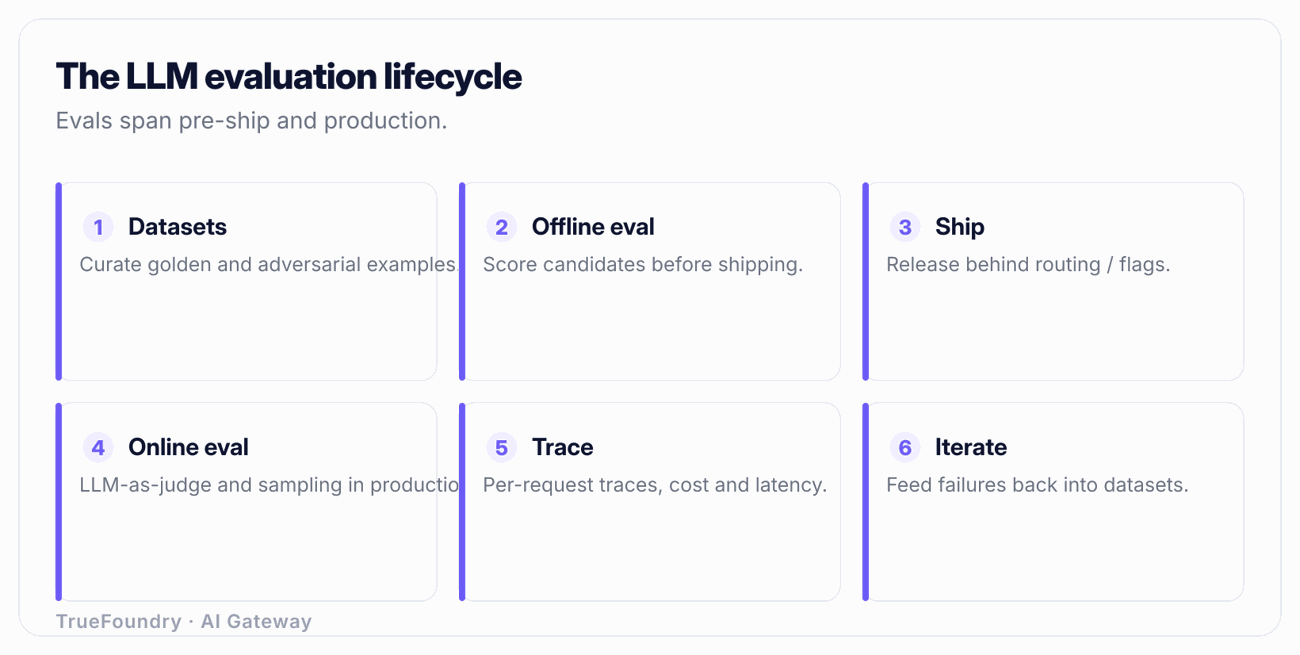
1. Datasets. Todo empieza con los ejemplos. Un dataset es un conjunto de entradas, opcionalmente con salidas esperadas o respuestas de referencia, que representa el trabajo que realiza tu aplicación. Los mejores datasets no son sintéticos, sino que se extraen de producción: las preguntas reales que hicieron los usuarios, especialmente aquellas en las que algo falló. Un equipo maduro reincorpora continuamente al dataset las trazas de producción con fallos o puntuaciones bajas para que el conjunto de evals se vuelva más exigente con el tiempo en lugar de quedar congelado con la dificultad del primer día.
2. Evaluación offline. Antes de desplegar un cambio en un prompt, modelo o recuperación, lo ejecutas contra el dataset y puntúas las salidas. Los métodos de puntuación van desde los deterministas (coincidencia exacta, regex, validez de esquemas JSON, si el código SQL se ejecuta) hasta los calificados por modelo (LLM-as-judge para corrección, relevancia, tono). La eval offline es tu puerta de control previa a la fusión de código: responde a la pregunta "¿este cambio ha mejorado o empeorado las cosas en casos que ya conozco?"
3. Evaluación online. Los datasets offline nunca cubren todo lo que la producción te puede presentar. La evaluación online ejecuta calificadores sobre el tráfico en directo, habitualmente sobre una muestra, para detectar regresiones y modos de fallo emergentes que tu dataset no incluyó. Aquí es donde mides métricas como la tasa de alucinación en producción, la relevancia de las respuestas y las violaciones de guardrails en sesiones de usuarios reales.
4. Tracing y observación. Como base de ambas etapas se encuentra el tracing: capturar cada paso de una ejecución en forma de spans estructurados. Para un chatbot sencillo, esto se reduce a prompt de entrada, finalización de salida, más recuento de tokens y latencia. Para un agente, se trata de un árbol: el paso de planificación, cada llamada a herramienta con sus argumentos y resultado, cada recuperación con los fragmentos devueltos y cada llamada al modelo con su prompt y salida. Sin este árbol, puedes puntuar la respuesta final de un agente, pero no puedes determinar por qué fue errónea, si falló la recuperación, si la herramienta devolvió un error o si el modelo ignoró un buen contexto.
El bucle se cierra cuando los hallazgos de las etapas 3 y 4 vuelven a la etapa 1. Una buena plataforma permite hacer esto con un solo clic: ver una traza defectuosa en producción, añadirla al dataset y volver a ejecutar la eval offline contra ella para siempre.
La evaluación de agentes añade dos problemas. En primer lugar, la trayectoria importa, no solo la respuesta final. Un agente puede llegar a una respuesta correcta a través de un camino defectuoso (tres llamadas a herramientas redundantes, una recuperación que devolvió basura que el modelo ignoró por suerte) y esa fragilidad te afectará más adelante. Tienes que puntuar los pasos, no solo el resultado. En segundo lugar, la falta de determinismo se acumula. Un agente de diez pasos donde cada paso tiene cierta variabilidad produce ejecuciones enormemente diferentes a partir de la misma entrada, por lo que necesitas múltiples ejecuciones por caso y puntuaciones agregadas, en lugar de un único resultado de aprobado o suspenso.
Para cualquier salida abierta (resúmenes, respuestas de chat, campos extraídos con corrección difusa) no se puede escribir una expresión regular. El calificador práctico es otro LLM configurado mediante un prompt para evaluar la salida: LLM-as-judge.
Funciona, pero con matices que diferencian a los equipos que confían en sus evals de los que sufren problemas:
Todas las plataformas que se analizan a continuación ofrecen LLM-as-judge. Las diferencias residen en la facilidad que ofrecen para la calibración, la definición de rúbricas y el mantenimiento del control de versiones del juez.
No existe una única herramienta ganadora para todos los casos. A continuación se presenta un análisis honesto.
Langfuse. De código abierto (autoalbergable o nube gestionada), es la opción OSS más completa. Combina tracing, evals, gestión de prompts y datasets en un solo sistema. Es idónea para equipos que quieren autoalojar por motivos de residencia de datos y obtener observabilidad y evaluación sin tener que conectar tres herramientas distintas. Su modelo de tracing es flexible e independiente del framework. Si buscas una única plataforma de código abierto que cubra la mayor parte del ciclo de vida, suele ser la primera opción a probar. Consulta nuestra visión general sobre herramientas de observabilidad de LLM para ver cómo se sitúa en el panorama general de la observabilidad.
Arize Phoenix. De código abierto y nativa de OpenTelemetry, lo que constituye su rasgo distintivo. Phoenix utiliza las convenciones semánticas de OTel para spans de LLM, por lo que las trazas se integran en infraestructuras que quizás ya utilices y evitas quedar atado a un formato de traza propietario. Es destacable en la depuración de recuperación y RAG (inspección de embeddings y fragmentos). Si tu organización se ha estandarizado en OpenTelemetry, Phoenix es la opción natural. Arize también vende un producto empresarial gestionado sobre el núcleo OSS.
Braintrust. Gestionada y centrada principalmente en las evals. Su propuesta radica en enfocar las evals como integración continua (CI): integras la evaluación en tu bucle de desarrollo para que cada cambio de prompt o código se ejecute automáticamente sobre los datasets, comparando las puntuaciones como si fueran resultados de tests. Ofrece una excelente experiencia de usuario para la experimentación al comparar variantes de prompts y modelos en paralelo. Es la mejor opción para equipos cuyo principal problema es "cambiamos los prompts constantemente y no tenemos un control de regresión". Es menos fuerte en la parte de autoalojamiento y observabilidad completa que Langfuse.
LangSmith. Gestionada, desarrollada por el equipo de LangChain y profundamente integrada con LangChain y LangGraph. Si tu stack ya utiliza LangChain, el tracing es casi automático, la instrumentación se incluye sin esfuerzo adicional y las vistas de trayectoria de agentes son muy completas. El contrapunto es que su experiencia óptima asume el uso del ecosistema de LangChain; fuera de él, sigue siendo utilizable, pero no representa una ventaja tan clara.
Comet Opik. De código abierto, procedente de la trayectoria de Comet (seguimiento de experimentos de ML). Cubre tracing, evals y destaca por incluir comprobaciones de tipo guardrail junto con la evaluación. Se adapta bien a equipos que ya utilizan Comet para el seguimiento de experimentos de ML clásico y quieren mantener su trabajo con LLM en el mismo entorno, o a quienes buscan una herramienta de eval OSS con comprobaciones de moderación integradas.
Maxim AI. Una plataforma de eval y observabilidad que también incluye Bifrost, un AI gateway de código abierto. Su propuesta combinada es "evaluar, observar y enrutar con un solo proveedor". El problema con el que se encuentran los compradores es que las evals y el gateway son efectivamente productos independientes en lugar de un plano de control único, el precio del gateway no es público (requiere solicitar acceso) y se trata de un proveedor más reciente cuyos benchmarks son mayoritariamente autorreportados. Si estás evaluando específicamente Maxim o su gateway Bifrost, analiza por separado la profundidad de la eval y la del gateway y su gobernanza, ya que pocas herramientas son las mejores de su clase en ambos campos.
Helicone. De código abierto, orientada a observabilidad y proxy. Se sitúa como un proxy ligero delante de tus llamadas al modelo y captura registros, latencia y costes con una integración mínima (basta con cambiar una URL base). Incluye evals, pero son más sencillas que las de una plataforma dedicada. Es ideal cuando la prioridad es una observabilidad rápida y económica con un coste de configuración bajo y la evaluación profunda se considera secundaria.
A continuación se ofrece la comparativa resumida:
Descubre cómo TrueFoundry añade observabilidad y gobernanza a tu stack de eval. Reserva una demo.
Elegir entre la lista anterior se reduce a un conjunto de ejes clave. Evalúa a los candidatos en función de estos puntos en lugar de guiarte por el número de características anunciado en su marketing.
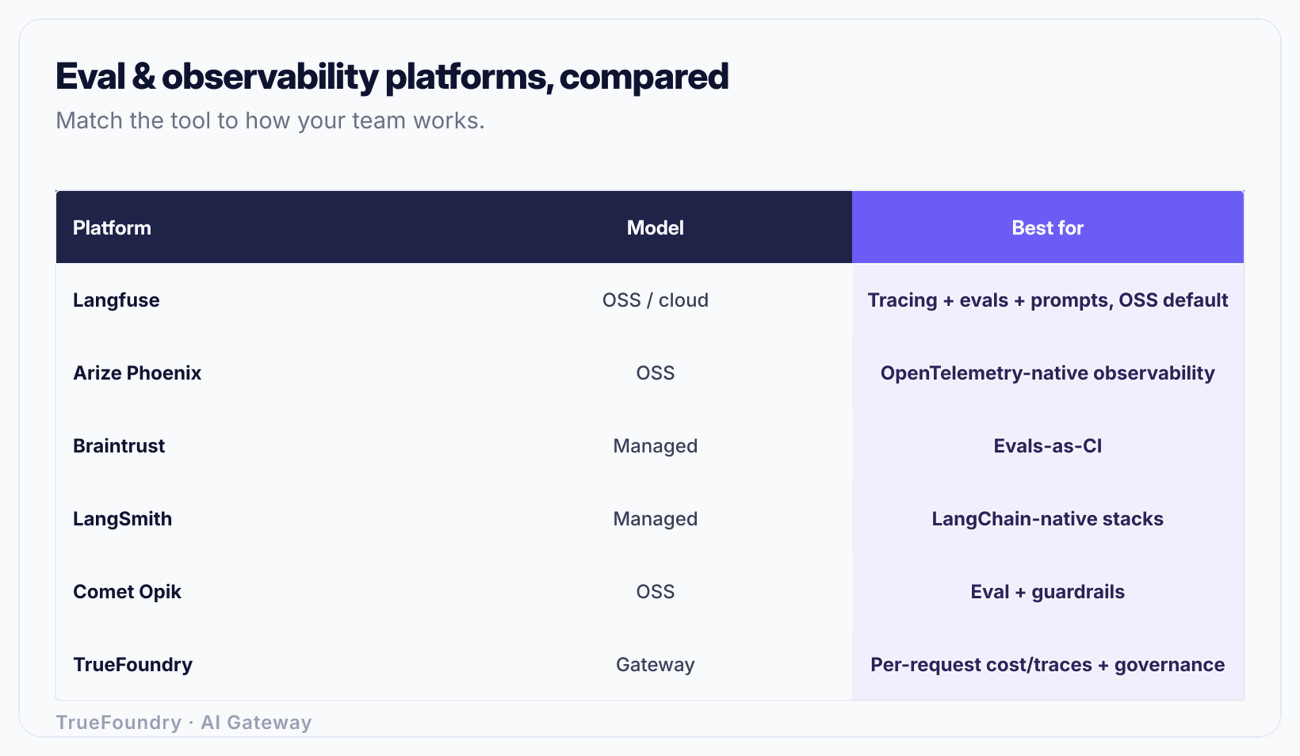
Una forma concreta de utilizar esta matriz: si tu restricción obligatoria es "los datos de los clientes no pueden salir de nuestra VPC", habrás reducido la lista de inmediato a las opciones OSS autoalbergables (Langfuse, Phoenix, Opik) o a un plan empresarial con despliegue en VPC, descartando las herramientas exclusivamente gestionadas sin importar lo buena que sea su experiencia de usuario. Empieza por tus requisitos no negociables y optimiza sobre las opciones restantes.
Una plataforma de eval necesita datos para analizar: trazas, prompts, finalizaciones, recuentos de tokens, latencias y coste por llamada. ¿De dónde proceden esos datos? En una sola aplicación, se instrumentan directamente. En una organización con docenas de aplicaciones y agentes conectados a múltiples proveedores de modelos, la fuente más limpia es la capa por la que ya pasa cada llamada: el AI gateway.
Un gateway como TrueFoundry se sitúa por delante de todo el tráfico de modelos y proveedores tras una API unificada compatible con OpenAI. Dado que cada petición pasa a través de él, emite observabilidad por petición: tokens de entrada y salida, latencia, modelo y proveedor utilizados, y coste, todo etiquetado por usuario, equipo y aplicación. Ese es exactamente el flujo de datos que una plataforma de eval necesita ingerir, y se obtiene sin tener que instrumentar cada aplicación individualmente porque el gateway lo genera de forma centralizada.
El gateway también ejecuta guardrails alineados en el momento de la llamada (detección de PII, comprobaciones de inyección de prompts, escaneo de secretos), lo cual es una tarea distinta a la evaluación offline. Los guardrails bloquean o marcan una petición o respuesta defectuosa en tiempo real; las evals puntúan la calidad a posteriori frente a datasets y muestras de producción. Se necesitan ambas capas. El guardrail evita el daño evidente en la ruta de la petición; la plataforma de eval indica si la tendencia de la calidad de las respuestas sube o baja a lo largo de las semanas.
La división del trabajo es clara: el gateway gestiona la ruta de la petición (enrutamiento, fallback, caché, presupuestos, guardrails alineados y emisión de trazas); la plataforma de eval gestiona el bucle de medición (datasets, puntuación offline u online, LLM-as-judge, comparativa de experimentos). TrueFoundry proporciona el gateway y el flujo de observabilidad; una plataforma de eval dedicada de la lista anterior se encarga de consumirlos. Para las organizaciones que buscan estandarizar costes y gobernanza a través de múltiples modelos, combinar ambas soluciones es mejor que intentar forzar a cualquiera de las herramientas a realizar el trabajo de la otra. Nuestra guía sobre las mejores plataformas de observabilidad de IA para LLM en 2026 profundiza específicamente en la parte de observabilidad.
Tratar LLM-as-judge como la verdad absoluta. El juez es un modelo con sus propios sesgos y modos de fallo. Los equipos que despliegan un juez sin calibrarlo previamente frente a etiquetas humanas terminan optimizando su aplicación para complacer a un evaluador descalibrado, lo cual es peor que no tener ninguna eval porque da una falsa sensación de rigor. Mide siempre primero la coincidencia entre el juez y los criterios humanos.
Evaluar únicamente la respuesta final de un agente. Una respuesta correcta procedente de una trayectoria defectuosa es un error latente. Si nunca puntúas los pasos intermedios, no notarás que tu agente llega a la respuesta correcta a través de tres llamadas a herramientas innecesarias y una recuperación que ignoró, hasta que un pequeño cambio provoque un fallo sin que sepas la razón.
Mantener el dataset congelado desde el lanzamiento. Un conjunto de eval estático mide la dificultad del día del lanzamiento para siempre mientras la producción evoluciona por debajo. Sin un bucle que incorpore continuamente al dataset las trazas con fallos de producción, tu panel de evals en verde dejará gradualmente de tener sentido.
Adquirir una herramienta de eval para un problema que debería resolver un guardrail. Si tu necesidad real es "bloquear PII e inyección de prompts en la ruta de la petición", eso requiere guardrails alineados en el gateway, no un conjunto de evals offline. Del mismo modo, ejecutar datasets offline para detectar ataques en tiempo real es demasiado lento. Elige la herramienta adecuada según si la comprobación se realiza en la propia ruta o a posteriori.
Ignorar la residencia de datos hasta la fase de compras. Hay equipos que eligen una herramienta de eval gestionada basándose en la experiencia de usuario y luego descubren en la revisión de seguridad que los prompts de producción que contienen datos de clientes no pueden salir de la VPC. Define primero la cuestión entre OSS y gestionado junto con el modelo de despliegue; esto descarta opciones más rápido que cualquier comparativa de características.
La evaluación es la disciplina que convierte la sensación de "la IA parece funcionar mejor ahora" en una cifra que se puede defender. Las plataformas no se diferencian tanto en si realizan evals —todas lo hacen—, sino en cómo gestionan el ciclo de vida completo: curación de datasets, control offline, monitorización online, tracing de trayectorias de agentes y evaluadores LLM-as-judge calibrados. Comienza analizando tus restricciones obligatorias (residencia de datos, framework existente, OSS frente a gestionado), puntúa a los candidatos usando la matriz de selección y exige el bucle completo en lugar de un entorno de pruebas aislado.
Y recuerda que la evaluación no funciona de manera aislada. El gateway situado delante de tus modelos ya genera las trazas y datos de costes que necesita tu plataforma de eval, además de aplicar guardrails en la ruta de la petición que las evals offline no pueden ejecutar. Combina una plataforma de eval sólida con un gateway que proporcione observabilidad limpia por petición y controles alineados, y obtendrás tanto la red de seguridad en tiempo real como la señal de calidad a largo plazo para mantener la fiabilidad de tu producto basado en LLM.
Combina tus evals con un gateway gobernado. Reserva una demo.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada




