


noviembre 20, 2026
|
5 minutos de lectura


Obtenga acceso instantáneo a un entorno TrueFoundry en vivo. Implemente modelos, dirija el tráfico de LLM y explore la plataforma completa: su sandbox estará listo en segundos, sin necesidad de tarjeta de crédito.



Published: noviembre 20, 2026

¡Una forma increíblemente rápida de crear, rastrear e implementar sus modelos!
La mayoría de los equipos que evalúan un AI gateway parten del mismo temor: "Si pongo un proxy delante de cada llamada al modelo, estoy añadiendo un salto (hop), y ese salto cuesta latencia". Es un instinto razonable y una mala razón para prescindir de la pasarela. El instinto se equivoca en la magnitud. Una llamada a un LLM puntero tarda desde 300 milisegundos para una completación corta hasta 20 segundos o más para una respuesta de razonamiento larga. Un gateway diseñado competentemente añade de unos pocos milisegundos a un par de decenas de milisegundos de procesamiento propio por encima de eso. La cuestión nunca es "si la pasarela añade latencia" (lo hace, de forma trivial), sino "si puedo medir el overhead con precisión y si se mantiene bajo en las colas (tail) y bajo carga".
El problema es que casi nadie hace benchmarks de esto correctamente. Los equipos ejecutan un bucle de 100 peticiones a través del gateway, miran el tiempo medio de reloj, lo comparan con 100 llamadas directas y concluyen algo sobre el "rendimiento" que está dominado por la varianza del proveedor y el jitter de la red. La señal que les importa, la contribución propia del gateway, se queda sepultada dentro de segundos de tiempo de modelo y nunca se aísla.
Esta publicación es un método neutral respecto a proveedores para realizar un benchmark adecuado de un AI gateway: qué métricas importan, cómo aislar el overhead del gateway de la latencia del proveedor, cómo probar en las colas de distribución (tails) y bajo carga, cómo gestionar el streaming y la caché, y qué aspecto tiene un "buen" resultado. Cada ejemplo numérico aquí es una plantilla ilustrativa, no un resultado medido. Deberías rellenar las tablas con los números de tus propias ejecuciones.
¿Quieres medir el overhead real del gateway con tu propio tráfico? Reserva una demo.
Un AI gateway se sitúa en la ruta de la petición entre tu aplicación y uno o más proveedores de modelos. En el caso de TrueFoundry, es una API unificada y compatible con OpenAI que gestiona el enrutamiento, fallbacks y reintentos, caché exacta y semántica, presupuestos y límites de tasa (rate limits), guardrails y observabilidad por petición. Cada una de esas funciones realiza un trabajo, y el trabajo requiere tiempo. Hacer benchmarks es la disciplina de atribuir el tiempo al lugar correcto.
Una sola petición sin streaming tiene un presupuesto de latencia con este aspecto:
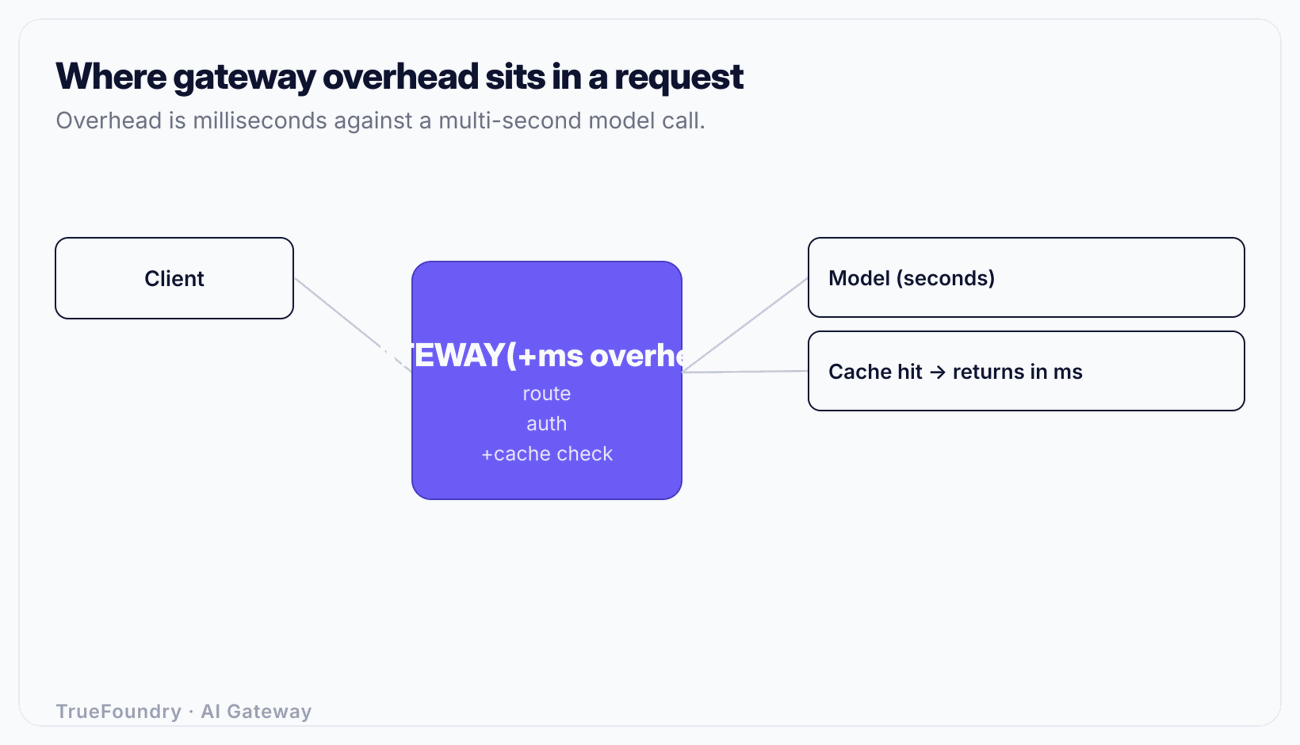
Desglosa el tiempo total de reloj de una petición en cuatro partes:
La métrica principal del benchmark es la latencia añadida: (2) más (4), aislada de (1) y (3). Si tu herramienta solo informa del tiempo de extremo a extremo, estás midiendo al proveedor, no al gateway.
Seis números describen el rendimiento de un gateway. Registra los seis; un único promedio no es un benchmark.
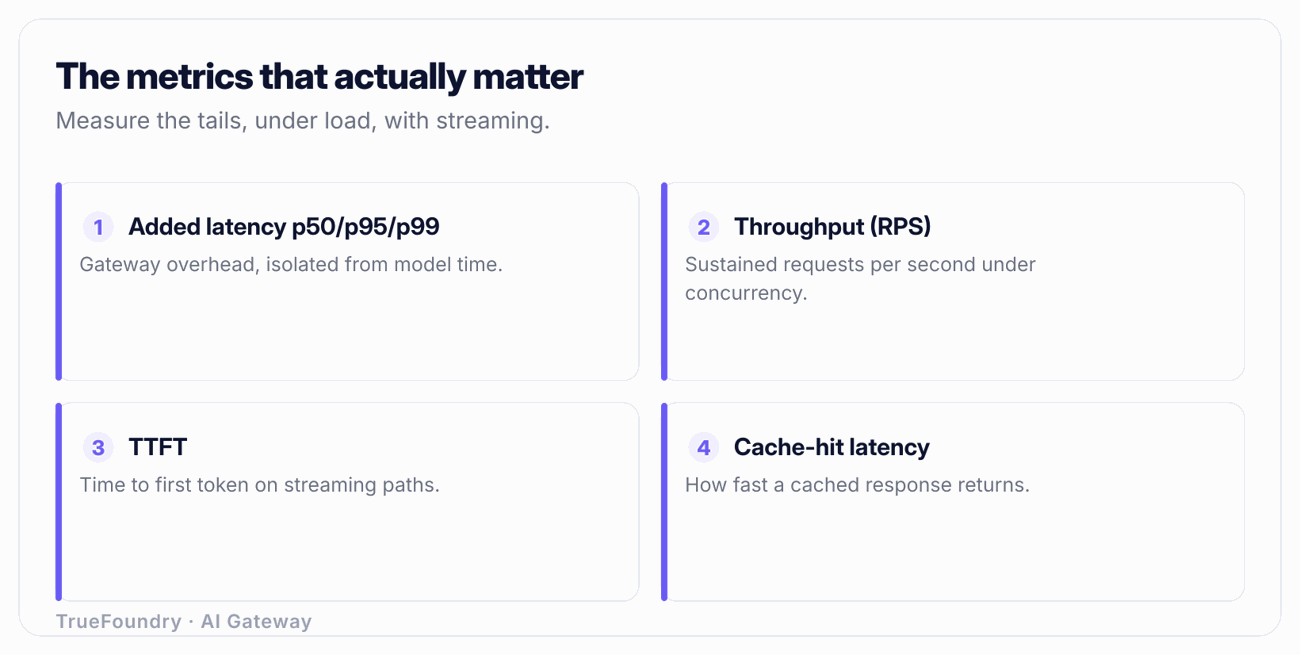
Las dos métricas de la cola (tail) merecen un énfasis especial. En una carga de trabajo basada en agentes, una sola acción de usuario puede ramificarse (fan out) en 10 a 50 llamadas a modelos dentro de un bucle de razonamiento. Si cada llamada tiene un 1 % de probabilidades de caer en una ruta lenta p99, un bucle de 30 llamadas caerá en esa ruta aproximadamente una de cada tres o cuatro acciones de usuario. La cola de la distribución no es un caso aislado a escala de agentes; es el caso habitual.
El movimiento metodológico central es la resta, y la trampa es que la latencia del proveedor es ruidosa, por lo que una resta ingenua da un overhead ruidoso.
Opción A: peticiones emparejadas. Para cada iteración de la prueba, envía la misma petición directamente al proveedor y a través del gateway, tan juntas en el tiempo como sea posible, idealmente intercaladas. Resta el tiempo directo del tiempo del gateway por cada par. El emparejamiento controla que la carga del proveedor no varíe durante la prueba, porque ambas mitades de un par ven aproximadamente las mismas condiciones del proveedor. Recopila miles de pares y luego calcula los percentiles de la diferencia. Esto mide la latencia añadida real, incluida la llamada aguas arriba del gateway, pero es sensible al jitter del proveedor entre las dos mitades del par.
Opción B: métricas de tiempo internas del gateway. Un buen gateway registra su propio tiempo de procesamiento por petición, el intervalo entre la aceptación de la petición y el despacho de la llamada aguas arriba, más el trabajo en el lado de la respuesta. La observabilidad por petición de TrueFoundry expone la latencia desglosada de esta manera, etiquetada por usuario, equipo y modelo. Esto te da el overhead directamente, sin restas y sin ruido del proveedor, y es la cifra en la que debes confiar cuando la tienes. Valídala una vez contra mediciones de peticiones emparejadas y luego confía en la métrica interna para la monitorización continua.
Opción C: simular (mockear) al proveedor. Apunta el gateway a un stub local que devuelva una respuesta predefinida con un retraso fijo y conocido (por ejemplo, 200 ms). Ahora el tiempo del proveedor es una constante que has elegido, y todo lo que esté por encima es overhead del gateway más la red. Esta es la forma más limpia de estresar las propias rutas de código del gateway a elevadas RPS sin pagar ni sufrir límites de tasa de un proveedor real, y es la herramienta adecuada para encontrar el codo de throughput. No captura el comportamiento real del proveedor, así que utilízala para el overhead y el throughput, no para el realismo de extremo a extremo.
Utiliza las tres. La Opción C encuentra el límite de throughput, la Opción A valida la latencia añadida en el mundo real y la Opción B te da el número que vigilarás en producción. Para saber más sobre dónde se sitúa el gateway en relación con tu aplicación y por qué esa ubicación gobierna la latencia, consulta control plane vs data plane y el marco más amplio en cómo elegir un AI gateway.
Un benchmark ejecutado a concurrencia 1 te muestra el suelo y nada sobre la producción. Los gateways reales atienden cientos o miles de peticiones concurrentes en vuelo, y el comportamiento interesante es cómo se degrada el overhead a medida que aumenta la concurrencia.
Diseña la prueba de carga como una rampa. Empieza con una concurrencia baja, mantén, sube un escalón, mantén, y sigue subiendo escalones hasta que la latencia añadida p95 cruce tu umbral. En cada escalón, registra la latencia añadida p50, p95, p99 y las RPS alcanzadas. El resultado es una curva, no un punto. Hay tres formas habituales:
Dos detalles de la generación de carga cambian los números más de lo que la gente espera. Primero, utiliza un modelo de carga de bucle abierto (open-loop) donde las peticiones llegan según una programación independientemente de si las anteriores han terminado, no un modelo de bucle cerrado (closed-loop) donde un pool fijo de workers espera a cada respuesta. Las pruebas de bucle cerrado ocultan la acumulación de colas porque las respuestas lentas frenan la carga ofrecida, lo que favorece falsamente tus cifras en las colas de distribución. Segundo, genera carga desde suficientes conexiones de clientes para que el propio cliente no sea el cuello de botella; un solo proceso cliente con un pool de conexiones pequeño reportará una latencia de "gateway" que en realidad es una cola en el lado del cliente.
Para cargas de trabajo de chat y de agentes, la mayoría de las respuestas se emiten en streaming. El streaming invierte la métrica que realmente importa: el usuario percibe el tiempo hasta el primer token, y el tiempo total es casi irrelevante para la velocidad percibida.
Un gateway correctamente diseñado reenvía los fragmentos (chunks) en streaming a medida que llegan, añadiendo solo un pequeño overhead constante por fragmento. Uno mal construido almacena en búfer toda la respuesta aguas arriba, aplica el procesamiento de la respuesta y solo entonces comienza el streaming hacia el cliente, lo que convierte una respuesta en streaming de 3 segundos en una espera de 3 segundos seguida de una descarga instantánea. El benchmark de TTFT detecta esto de inmediato: mide el intervalo desde el envío de la petición hasta la recepción del primer byte del primer fragmento de contenido, tanto a través del gateway como de forma directa. El overhead de TTFT del gateway debería estar cerca de su overhead sin streaming, un par de milisegundos, no cientos.
Los guardrails de respuesta complican esto honestamente. Si ejecutas un guardrail de salida que debe inspeccionar la respuesta completa (ciertas comprobaciones de PII o políticas), no puedes emitir en streaming y escanear el texto completo al mismo tiempo sin tomar una decisión de diseño: emitir en streaming de forma optimista y retractarte, o almacenar en búfer y retrasar. Realiza benchmarks de ambos modos si utilizas guardrails de salida y reporta el coste de TTFT de cada uno. No dejes que un proveedor te cite un TTFT de streaming medido con los guardrails desactivados para luego activarlos en producción.
Descubre cómo TrueFoundry mantiene la latencia añadida en milisegundos de un solo dígito. Reserva una demo.
No necesitas elegir un gateway por su lenguaje de implementación, pero deberías entender por qué el lenguaje y la arquitectura dan forma a la curva de throughput, porque eso te dice qué debes estresar.
Un gateway escrito sobre un bucle de eventos de un solo hilo gestiona una concurrencia enorme para trabajos limitados por I/O (esperar al proveedor), pero serializa cualquier trabajo limitado por CPU en la ruta crítica. Si el análisis de peticiones, el conteo de tokens o la expresión regular de un guardrail se ejecutan de forma alineada (inline), esos pasos compiten por el único hilo y se manifiestan como un p99 creciente bajo carga. Un entorno de ejecución con un bloqueo global del intérprete (GIL) tiene una limitación parecida: incluso con un pool de hilos, las secciones limitadas por CPU no se ejecutan verdaderamente en paralelo dentro de un proceso, por lo que escalas ejecutando más procesos, y tu benchmark debe tener en cuenta la duplicación de memoria y de pools de conexiones por proceso. Los entornos de ejecución compilados y multihilo (Go, Rust) paralelizan el trabajo de CPU entre núcleos dentro de un mismo proceso, lo que suele empujar el codo de throughput más arriba por instancia, a costa de un perfil operativo diferente.
La conclusión práctica no es "Go supera a Python". Es: identifica qué se ejecuta en la ruta crítica y mídela bajo concurrencia. Contar tokens en un contexto de 100.000 tokens, ejecutar un clasificador de inyecciones de prompts o calcular un embedding para caché semántica son tareas de CPU. Si se ejecutan inline, curvarán tu gráfica en la cola. Si se ejecutan fuera de la ruta crítica o detrás de una ruta rápida, no lo harán. Haz pruebas con tamaños de prompt representativos, no con juguetes de 10 tokens, porque la longitud del contexto impulsa el coste de CPU de estos pasos precisamente. El trabajo del gateway como LLM proxy es mantener ese trabajo por petición pequeño y predecible.
El único escenario que le da la vuelta por completo a la narrativa de "los gateways añaden latencia" es el almacenamiento en caché, y es el escenario que los equipos olvidan evaluar.
TrueFoundry admite tanto la caché exacta (peticiones idénticas devuelven la respuesta almacenada) como la semantic caching (una petición cuyo embedding está dentro de un umbral de similitud del coseno respecto a una petición anterior devuelve esa respuesta). En un acierto (hit), la llamada al modelo nunca llega a producirse. La latencia de la petición se reduce desde los cientos de milisegundos o segundos del modelo hasta el tiempo de búsqueda propio del gateway: el cálculo del embedding (para la semántica) más una búsqueda vectorial o por clave, típicamente de un solo dígito a decenas bajas de milisegundos.
Haz un benchmark de esto como un escenario independiente:
Un ejemplo práctico, solo ilustrativo: supongamos que una llamada directa al modelo para tu carga de trabajo tarda 1.200 ms en p50. Un acierto de caché exacta podría devolver la respuesta en 6 ms, y un acierto semántico en 22 ms (dominado por el paso del embedding). Con una tasa de aciertos del 40 %, el p50 combinado es aproximadamente 0,6 × 1.200 + 0,4 × 15 ≈ 726 ms, una reducción del 40 % en la latencia típica y una reducción del 40 % en el gasto de tokens, ambas generadas por el gateway. Reportado como un promedio de extremo a extremo, el gateway parece dramáticamente más rápido que las llamadas directas. Por eso "el gateway añade latencia" es un titular equivocado: en tráfico almacenado en caché, resta latencia. Rellena tus propios números; la estructura se mantiene independientemente de los detalles específicos.
Ejecuta esta lista antes de confiar en cualquier afirmación sobre la latencia de un gateway, incluida la tuya propia.
La tabla a continuación es una plantilla para rellenar con tus propias ejecuciones. Los números son marcadores de posición que muestran la forma y el orden de magnitud esperados, no resultados medidos de ningún producto. Reemplaza cada celda con las cifras que hayas medido en tus modelos, regiones y tráfico.
Trata cualquier fila individual de forma aislada como algo sin sentido. El valor reside en la comparación: cache-hit frente a miss, streaming frente a no streaming, carga baja frente al codo de la curva.
Reportan latencia de extremo a extremo y la llaman rendimiento del gateway. El modelo domina el tiempo de reloj, por lo que el "benchmark" mide principalmente al proveedor y a la red. Aísla el overhead o no habrás medido nada sobre el gateway.
Hacen benchmarks sobre la media y lanzan a producción con eso. El p50 parece excelente y el p99 agota el tiempo de espera de sus bucles de agentes en producción. Con la ramificación (fan-out) de los agentes, la cola de la distribución determina la experiencia real. Reporta siempre el p95 y el p99.
Hacen pruebas a concurrencia 1. El overhead en una sola petición en vuelo no dice nada sobre el comportamiento a 500. La curva de degradación, y su codo, son todo el propósito. Aumenta la carga progresivamente.
Olvidan medir la caché. El almacenamiento en caché es la única función que hace que el gateway sea más rápido que las llamadas directas, y es el escenario que más se omite. Mide la latencia de los aciertos y la latencia combinada a tu tasa de aciertos real, o estarás subestimando el valor del gateway en todo el beneficio de la caché.
Confían en la cifra de un proveedor sin reproducirla. Una cifra de latencia en una diapositiva se midió en el modelo, región, tamaño de prompt y configuración de guardrails de otra persona. Hasta que no la reproduzcas con tu tráfico, es solo marketing. Ejecuta la lista de verificación tú mismo.
El temor de que un AI gateway añada una latencia inaceptable se mantiene porque los equipos miden lo equivocado. El tiempo total de reloj de extremo a extremo está dominado por el modelo, por lo que no te dice casi nada sobre la pasarela. Aísla el overhead, infórmalo en la cola de la distribución y el escenario se invierte: un gateway competente añade unos pocos milisegundos a una petición que ya tarda segundos, y en tráfico almacenado en caché hace que la petición sea significativamente más rápida al tiempo que reduce el gasto en tokens.
Haz el benchmark tú mismo. Utiliza la lista de verificación, rellena la plantilla con tus propias ejecuciones, aumenta la concurrencia para encontrar el codo y mide la latencia p99 y de los cache hits como métricas de primer nivel en lugar de ideas secundarias. Un gateway que supera ese listón te aporta enrutamiento, fallback, caché, presupuestos, guardrails y observabilidad por petición por un coste de latencia que resulta insignificante en comparación con el modelo, y la única forma de probarlo es midiéndolo en tu tráfico.
Evalúa un gateway que se vuelve más rápido con la caché activada. Reserva una demo.
TrueFoundry AI Gateway ofrece una latencia de entre 3 y 4 ms, gestiona más de 350 RPS en una vCPU, se escala horizontalmente con facilidad y está listo para la producción, mientras que LitellM presenta una latencia alta, tiene dificultades para superar un RPS moderado, carece de escalado integrado y es ideal para cargas de trabajo ligeras o de prototipos.





Las últimas noticias, artículos y recursos enviados a tu bandeja de entrada




