



November 6, 2026
|
Lesedauer: 5 Minuten


Erhalten Sie sofortigen Zugriff auf eine TrueFoundry-Live-Umgebung. Stellen Sie Modelle bereit, leiten Sie den LLM-Verkehr weiter und erkunden Sie die gesamte Plattform — Ihre Sandbox ist in Sekundenschnelle einsatzbereit, ohne dass eine Kreditkarte erforderlich ist.


Unglaublich schnelle Methode zum Erstellen, Verfolgen und Bereitstellen Ihrer Modelle!
Teil 1 hat das Problem benannt: Tokenmaxxing, die neue Codezeilen-Metrik, bei der Entwickler das AI-Nutzungsvolumen optimieren, weil es die gemessene Zahl ist. Teil 2 hat die architektonische Lösung vorgeschrieben: Identität, Policy, Sicherheit und Observability, die bei jeder Anfrage direkt am Gateway ansetzen. Dieser letzte Teil verwandelt diese Architektur in etwas, das eine Organisation Woche für Woche tatsächlich betreiben kann.
Die folgenreichste Designentscheidung in dieser Schicht wird auch am leichtesten übersehen. Das Dashboard, das Sie bauen, wird Verhalten formen. Ein Leaderboard erzeugt sozialen Druck, Token zu verbrennen. Ein Control Room hilft Platform-, Sicherheits-, Finanz- und Engineering-Verantwortlichen, schwierigere Fragen zu beantworten und auf der Grundlage der Antworten zu handeln.
Die Fragen, auf die es wirklich ankommt: Welche Workflows schaffen Wert pro Dollar? Welche Agenten befinden sich in Endlosschleifen? Welche Teams nutzen AI an Stellen zu wenig, an denen sie echten Nutzen stiften würde? Welche Nutzung von Premium-Modellen ist gerechtfertigt und welche ist rein dekorativ? Welche Guardrail-Ereignisse sind Rauschen und welche signalisieren echte Risiken?
Gestalten Sie die Panels richtig, und diese Fragen werden zu Routinefragen der operativen Praxis, die im täglichen Standup beantwortet werden. Gestalten Sie sie falsch, trainiert selbst Ihr präzisestes Dashboard stillschweigend genau das manipulierte Verhalten, das Sie verhindern wollten.
Vor den Panels kommen die Designregeln. Jedes Prinzip ist die direkte Antwort auf ein Fehlverhalten, das Leaderboards hervorrufen.
Das Adoptions-Panel beantwortet eine täuschend einfache Frage: Wie viele Entwickler nutzen an einem bestimmten Tag tatsächlich AI-Tools?
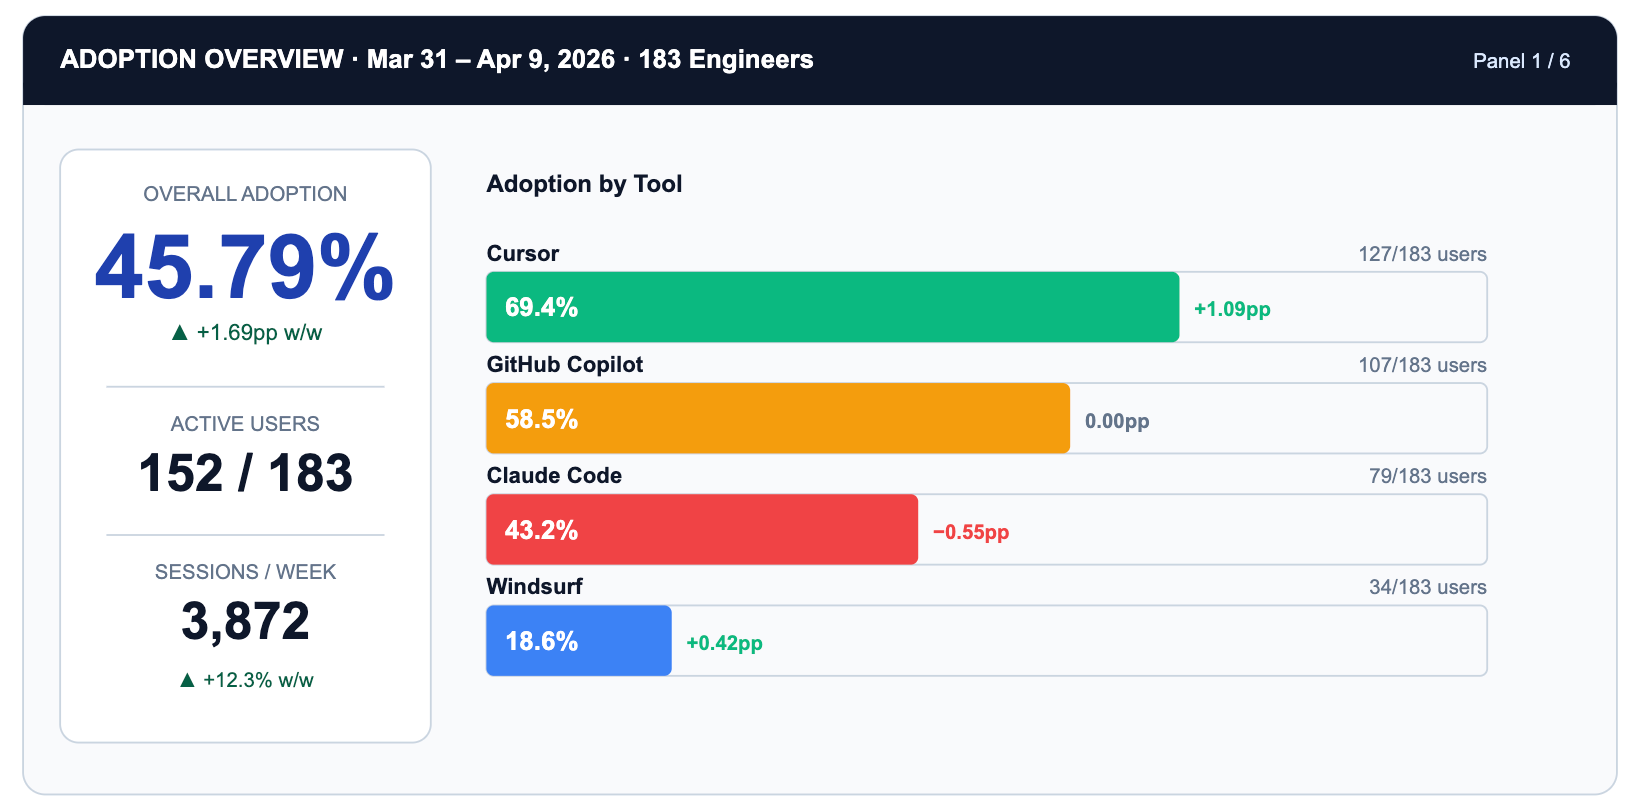
Beachten Sie, was das Panel nicht zeigt: individuelle Rankings. Die Einheit ist Anbieter x Team x Tag. Die daraus resultierende Handlung ist nicht „Alex gratulieren“, sondern „Die Adoption von Claude Code liegt 26 Prozentpunkte hinter Cursor. Liegt es an Reibungsverlusten beim Tooling oder an der Eignung für den Anwendungsfall?“ Das ist eine Frage, die einen Sprint wert ist.
TrueFoundry ermöglicht dies über den X-TFY-METADATA-Header, der jeder Gateway-Anfrage beigefügt wird. Der Header enthält ein als String formatiertes JSON-Objekt, dessen Felder Benutzeridentität, Teammitgliedschaft, Tool-Name, Projekt-Tag und Session ID umfassen.
→ TrueFoundry Request and Response Headers Reference
→ Analytics Dashboard Overview
Die Adoption sagt Ihnen, wer AI nutzt. Die Burn-Rate sagt Ihnen, wohin das Geld fließt. Das sind unterschiedliche Fragen, die in unterschiedliche Panels gehören.
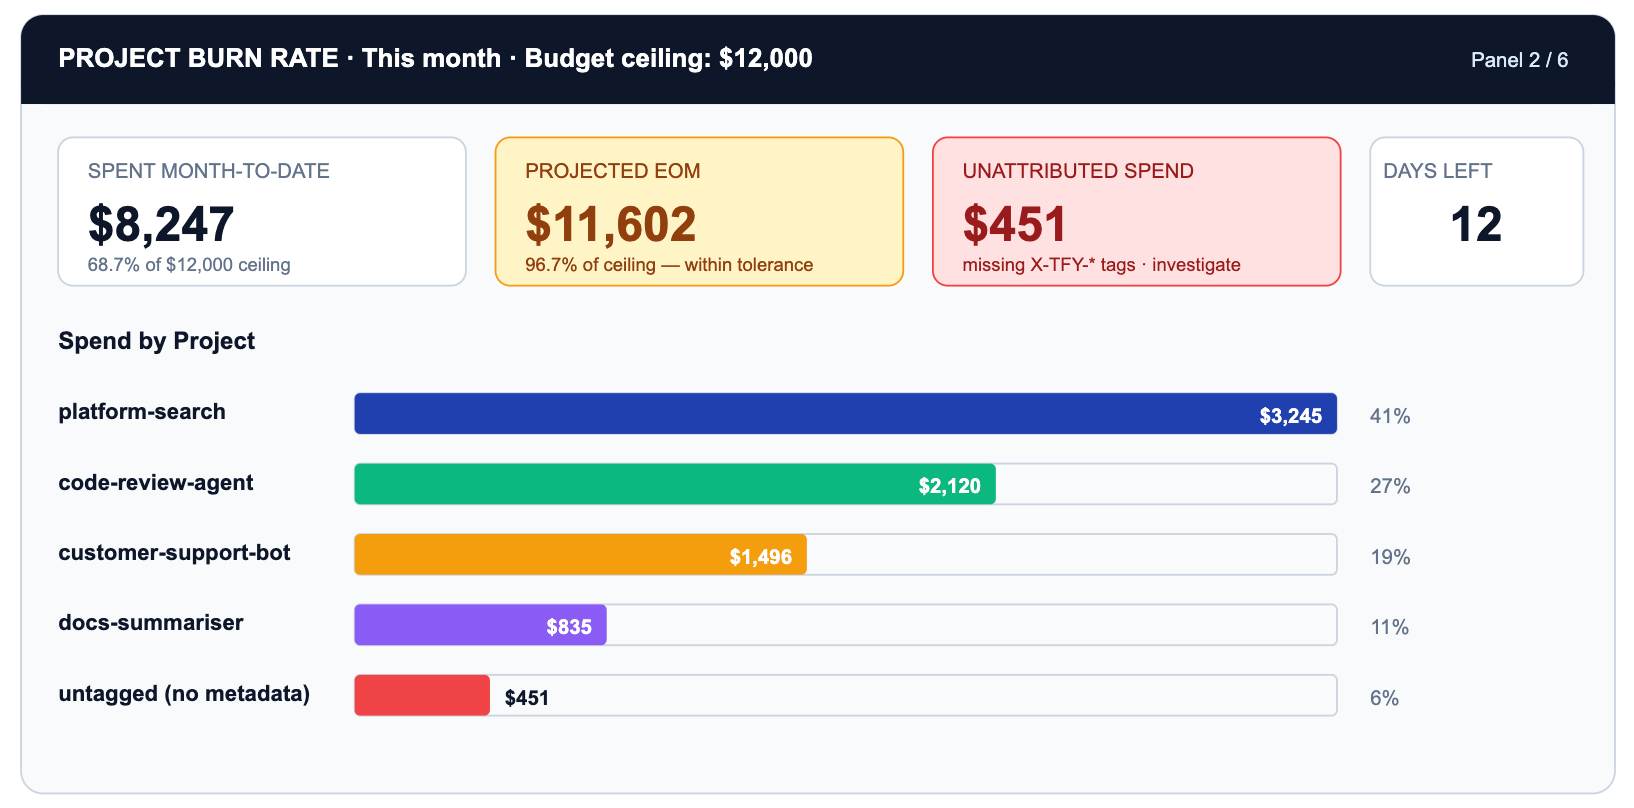
Die kritische Zeile ist UNTAGGED. Ausgaben in Höhe von 451 $ enthalten keine Projekt-Metadaten. Das ist eine Lücke in der Gateway-Konfiguration, kein Ausgabenproblem. Jede nicht getaggte Anfrage kann weder einem Geschäftsergebnis zugeordnet, noch von einer Budget-Policy gesteuert werden, noch erscheint sie in einem nützlichen Burn-Rate-Diagramm.
TrueFoundry Budget Limiting ermöglicht Ihnen das Festlegen harter Obergrenzen pro Projekt, pro Team, pro Modellfamilie oder pro Zeitfenster. Wenn platform-search 100 % seiner monatlichen Obergrenze von 4.000 $ erreicht, geben Anfragen basierend auf Ihrer konfigurierten Policy den Status 429 zurück oder weichen auf ein günstigeres Modell aus.
→ Budget Limiting — Fenster, Obergrenzen und Alerts
→ Rate Limiting — pro Benutzer, pro Modell, pro Metadaten-Tag
Fehlverhalten im Zusammenhang mit Agenten zeigt sich am teuersten in Endlosschleifen: Ein Agent versucht es unendlich oft erneut, weil seine Abbruchbedingung nie erfüllt wird oder weil das von ihm aufgerufene Tool fortlaufend Fehler zurückgibt. Ein einzelner in einer Schleife gefangener Agent kann in einer Stunde so viele Token verbrauchen wie ein ganzes Entwicklerteam an einem Tag.
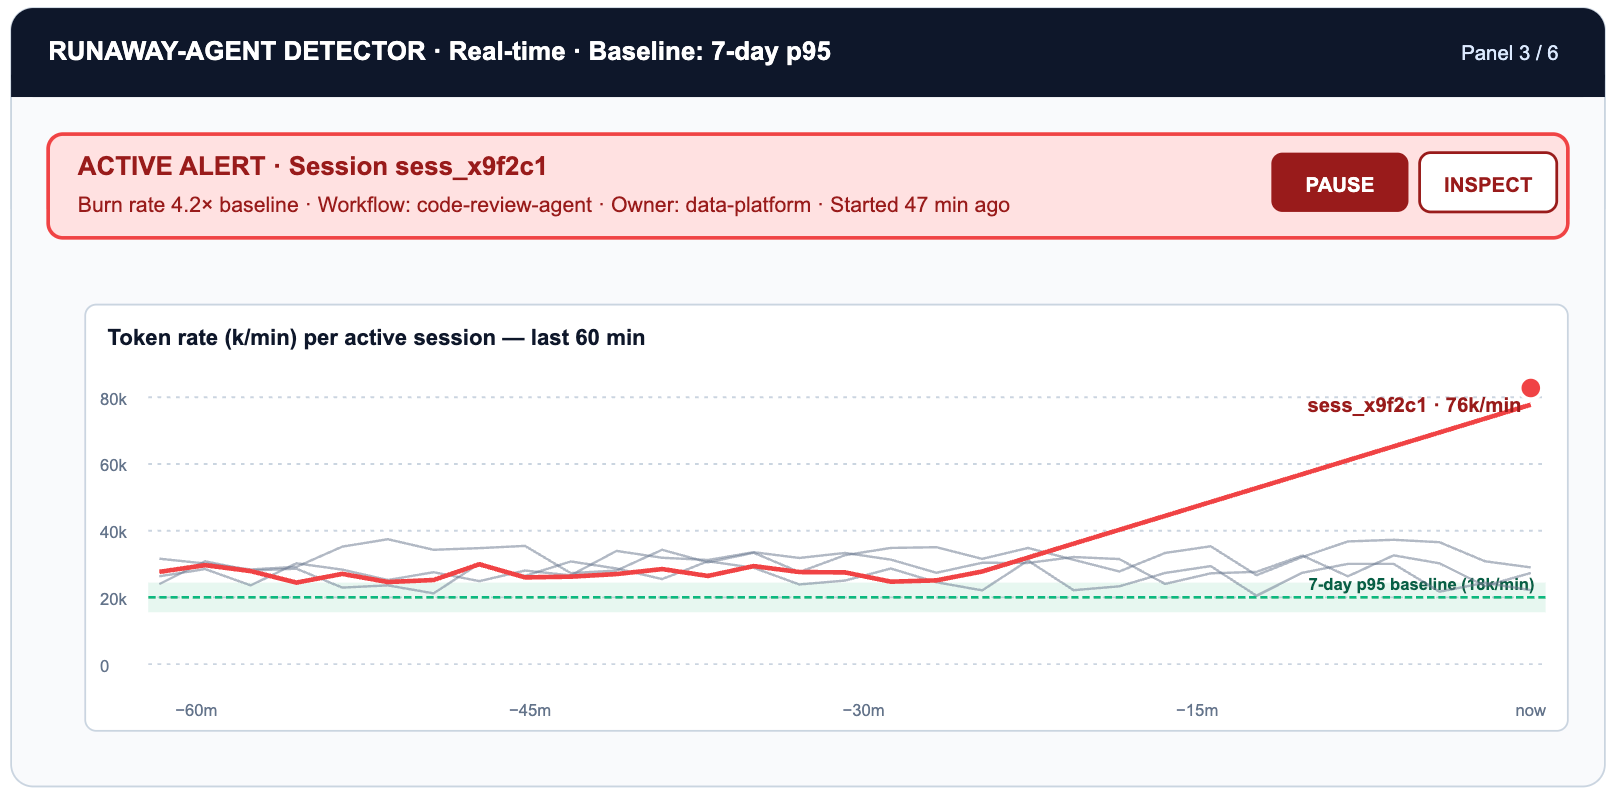
Dieses Panel erfordert das OTEL-Signal, das TrueFoundry exportiert: Token-Rate pro Session im Zeitverlauf (nicht nur reine Anfragezahlen) zur Unterstützung von AIOps-Praktiken wie Anomalienerkennung und proaktiver Problemerkennung. Die p95-Baseline wird aus den Sessions der letzten sieben Tage für jedes Workflow-Tag berechnet. Alles, was das 3-fache dieser Baseline überschreitet, löst ein Pager-Ereignis und optional den Abbruch der Session über den Durchsetzungspfad des Rate Limiting aus.
→ Export OpenTelemetry Data — Traces, Spans, Token-Zähler
→ Rate Limiting — Durchsetzung von Obergrenzen pro Session
Nicht jede Aufgabe, die ein Frontier-Modell erreicht, rechtfertigt auch den Einsatz eines solchen. Die Weiterleitung einer E-Mail-Klassifizierungsaufgabe an Claude Opus 4.7 für 5 $/25 $ pro Million Token, wenn Haiku 4.5 für 1 $/5 $ die Aufgabe mit einer Genauigkeit innerhalb von 2 Prozentpunkten lösen würde, bedeutet, das 5-Fache für eine Leistung zu bezahlen, die Sie gar nicht nutzen. Diese Entscheidung bleibt unsichtbar, bis sie über Tausende täglicher Anfragen hinweg aggregiert wird – und genau das tut dieses Panel.
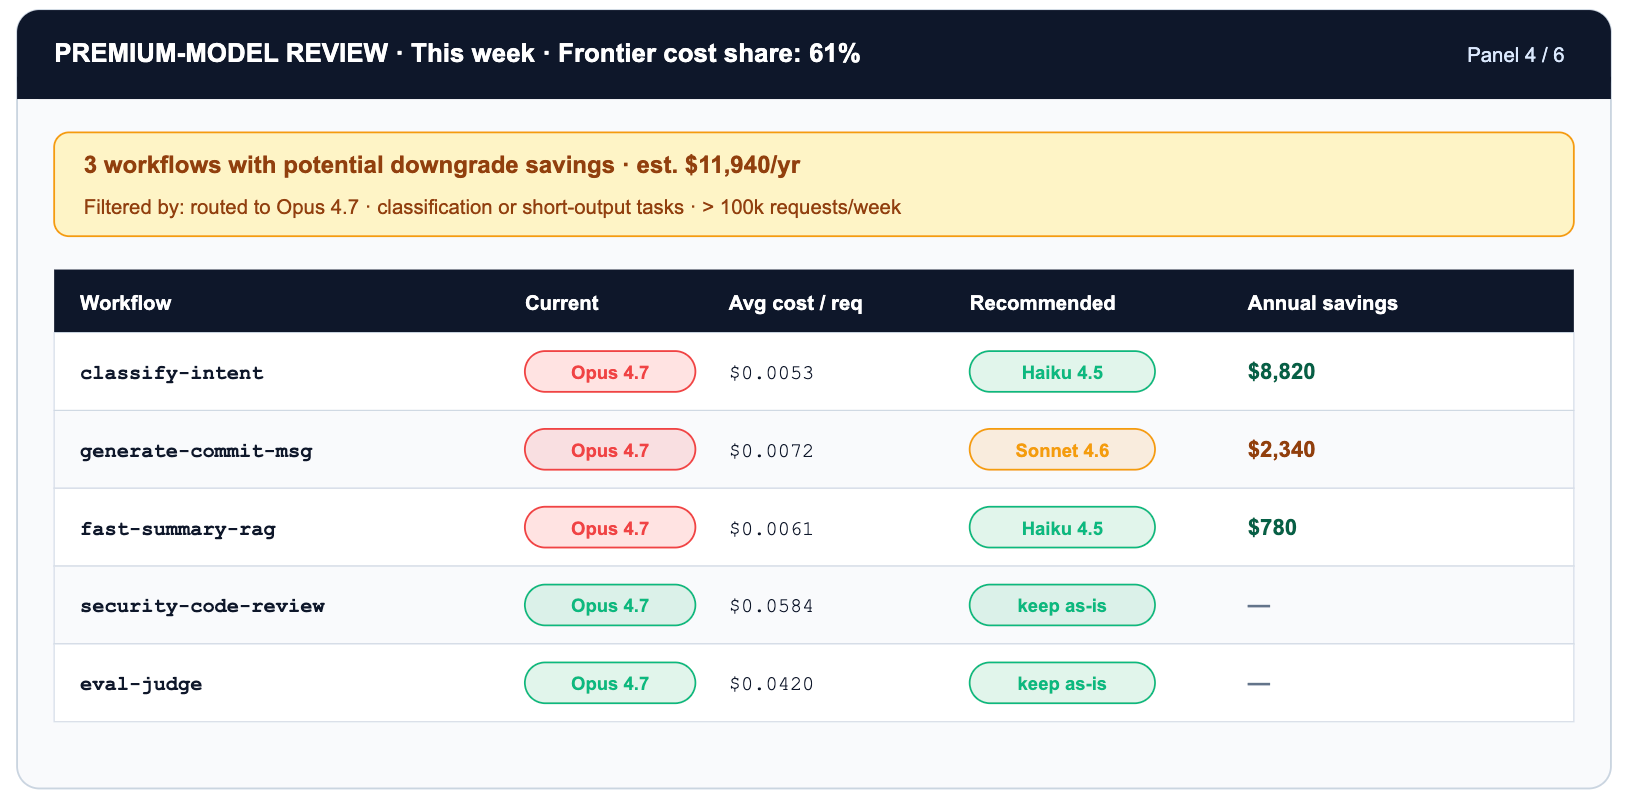
In diesem Panel greifen zwei mehrschichtige Optimierungen ineinander. Das Routing von classify-intent von Opus 4.7 auf Haiku 4.5 entspricht einer 5-fachen Reduzierung der Token-Kosten. Wenn Sie zusätzlich das Prompt Caching für den System-Prompt aktivieren, sinkt die Zahl der gecachten Input-Token um weitere 90 % – ein kumulierter Rabatt, der einen Workflow von 3.200 $/Monat auf etwa 50 $/Monat reduziert, ohne dass sich die Genauigkeit ändert.
Es gibt auch eine versteckte Variante dieses Panels: Tokenizer-Drift. Als Anthropic Opus 4.7 veröffentlichte, erzeugte der neue Tokenizer für denselben Input bis zu 35 % mehr Token im Vergleich zu Opus 4.6. Die regulären Preisangaben änderten sich nicht. Die effektiven Kosten pro Anfrage hingegen schon. Die einzige Möglichkeit, dies zu erkennen, sind Token-Telemetry-Daten pro Modellversion auf dem Gateway. Die einzige Möglichkeit zu reagieren besteht darin, das virtuelle Modell-Alias zurückzusetzen – was bei TrueFoundry ein YAML-Diff ist und kein ganzer Sprint.
Das virtuelle Modell-Routing von TrueFoundry macht das Handeln auf Basis dieses Panels reibungslos. Sie konfigurieren einen logischen Modellnamen wie 'code-review-fast', der je nach Workflow-Tag, Tageszeit oder Last auf verschiedene physische Endpunkte routet – ohne den Anwendungscode anzupassen. Das A/B-Testing eines günstigeren Modells ist ein YAML-Diff, kein eigener Sprint.
→ Routing Overview — Gewichtung, Priorität, Fallback, Prompt Caching
Die Aufgabe des Sicherheits-Panels ist die Priorisierung. Die meisten Guardrail-Ereignisse sind Rauschen: Test-Traffic, Experimente von Entwicklern, erwartete Edge-Cases in der Produktion. Nur wenige stellen ein echtes Risiko dar: PII-Leaks über einen Prompt, ein Secret in agentengeneriertem Code, ein Prompt-Injection-Versuch in Benutzereingaben.
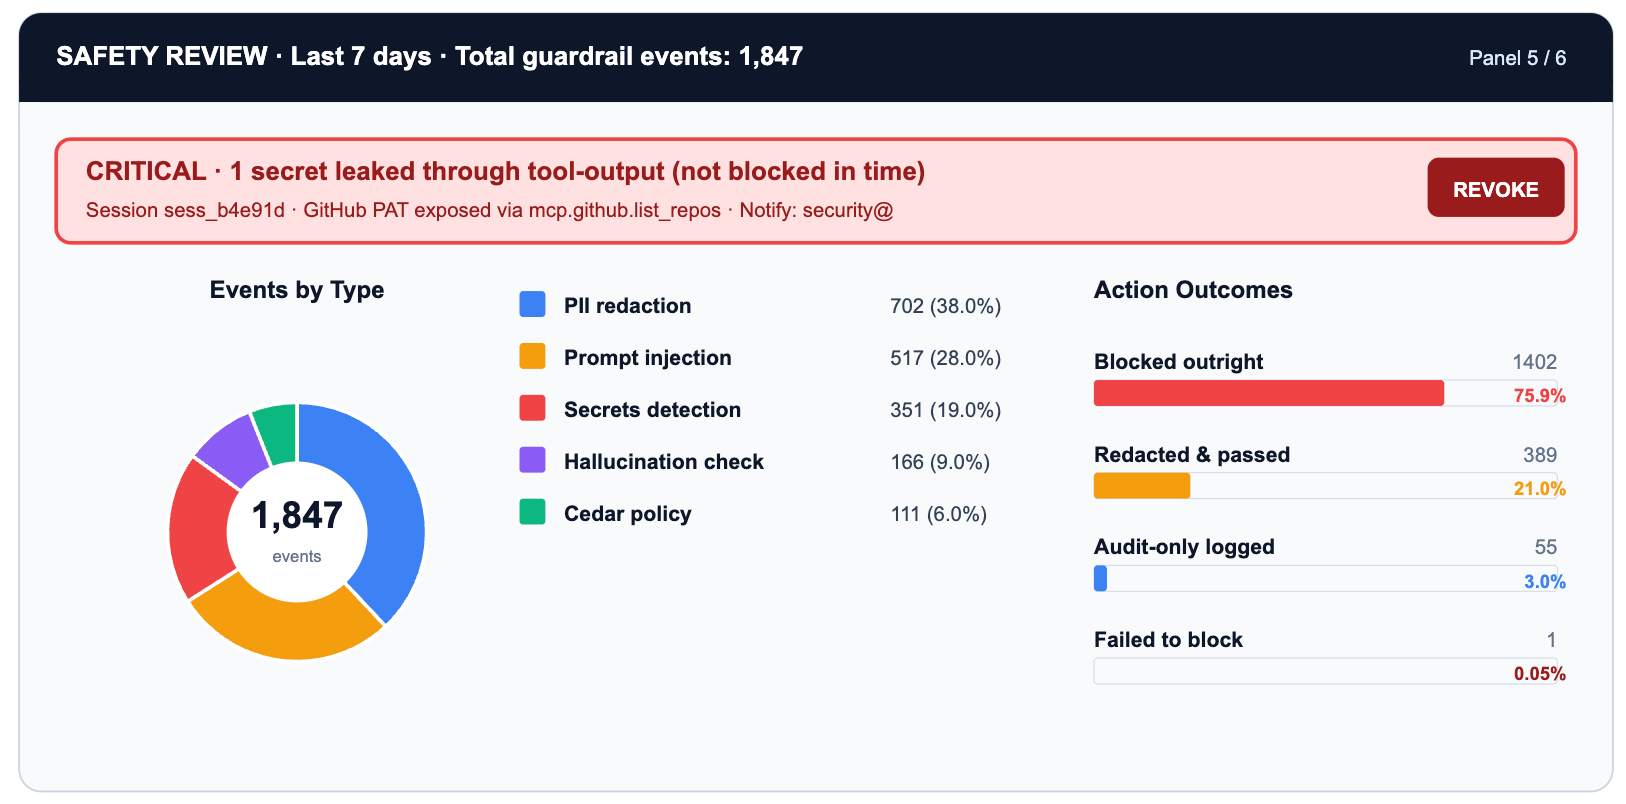
Das eine durchgesickerte Secret in der Zeile secrets-scan ist die Zelle, die sofortiges Handeln erfordert. Alles andere dient der Information: nützlich, um die Empfindlichkeit von Guardrails einzustellen, Signal von Rauschen zu trennen und Prüfern die Einhaltung von Compliance-Vorgaben nachzuweisen.
Das Vier-Hook-Guardrail-Modell von TrueFoundry (request-input, request-output, tool-input, tool-output) bedeutet, dass jede Ereigniszeile einem spezifischen Abfangpunkt im Anfrage-Lebenszyklus zugeordnet ist. Die PII-Erkennung bei request-input erfasst Benutzerdaten, bevor sie das Modell erreichen. Das Scannen nach Secrets bei tool-output erfasst Zugangsdaten, bevor sie nachgelagerte Systeme erreichen.
→ Guardrails Overview — Vier Hooks, Dekomposition von Bedrohungsflächen
→ PII/PHI Detection — Anonymisierungsmodi und Hook-Platzierung
→ Secrets Detection — Validate- vs. Mutate-Modus
Dies ist das am schwersten zu bauende und zugleich wichtigste Panel. Alle fünf vorherigen Panels beschreiben die AI-Nutzung. Dieses beantwortet die Frage, ob die Nutzung auch zu Ergebnissen geführt hat.
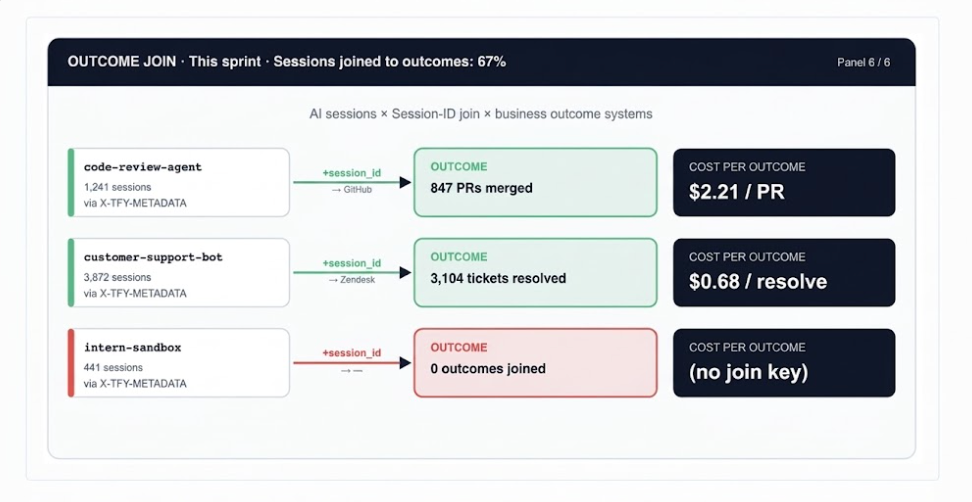
Der Verknüpfungsschlüssel ist das Feld session_id in X-TFY-METADATA, das von TrueFoundry über jede Anfrage in einer mehrstufigen Agenten-Session hinweg weitergeleitet wird. Wenn dieselbe Session ID in Ihrer GitHub-Webhook-Nutzlast oder den Zendesk-Metadaten auftaucht, können Sie den Kreis schließen: Diese Session hat 2,21 $ gekostet und zu einem gemergeten Code-Review-PR geführt.
→ Analytics — Kosten- und Nutzungsansichten auf Session-Ebene
Die sechs Panels speisen sich aus drei verschiedenen Metrikschichten. Der häufigste Fehler bei Dashboards besteht darin, diese zu vermischen: Eine Executive-Ansicht sollte keine Anzahl von Wiederholungsversuchen enthalten, und eine On-Call-Ansicht sollte keine Eval-Bestehensquoten zeigen.
Sobald die drei Schichten eingerichtet sind, liegt die Versuchung nahe, sie in einem Score pro Entwickler zusammenzufassen und ein Ranking zu veröffentlichen. Widerstehen Sie dem. Die folgende Funktion dient explizit der Diagnose: ein Werkzeug, um Workflow-Muster zu finden, die Investitionen, Redesigns oder neue Guardrails verdienen. Aggregieren Sie nach workflow_tag, nicht nach user_id.
Dashboards steuern keine Organisationen. Rituale tun es. Der minimale operative Rhythmus für eine gesteuerte AI-Nutzung:
Jeder Alert sollte einem Runbook-Schritt zugeordnet sein, nicht nur einem Pager-Ereignis. Das folgende YAML definiert das Mindestset an Alert-Regeln für den Control Room, das auf Basis des OTEL-Exports von TrueFoundry ausgeführt wird:
Prüfen Sie das Feld workflow_tag in den X-TFY-METADATA der Anfrage für das zuständige Team
Prüfen Sie das Feld workflow_tag in den X-TFY-METADATA der Anfrage für das zuständige Team
→ tfy apply — GitOps-basierte Bereitstellung von Alerts und Policies
→ Export OpenTelemetry Data — OTEL-Metrik-Endpunkte
Bevor Sie Ihren AI Control Room als betriebsbereit erklären, überprüfen Sie diese acht Bedingungen. Jede lässt sich einer spezifischen TrueFoundry-Funktion zuordnen:
Die Tokenmaxxing-Trilogie hat eine Argumentation über drei Schichten aufgebaut. Jede Schicht ist notwendig; keine ist für sich allein ausreichend.
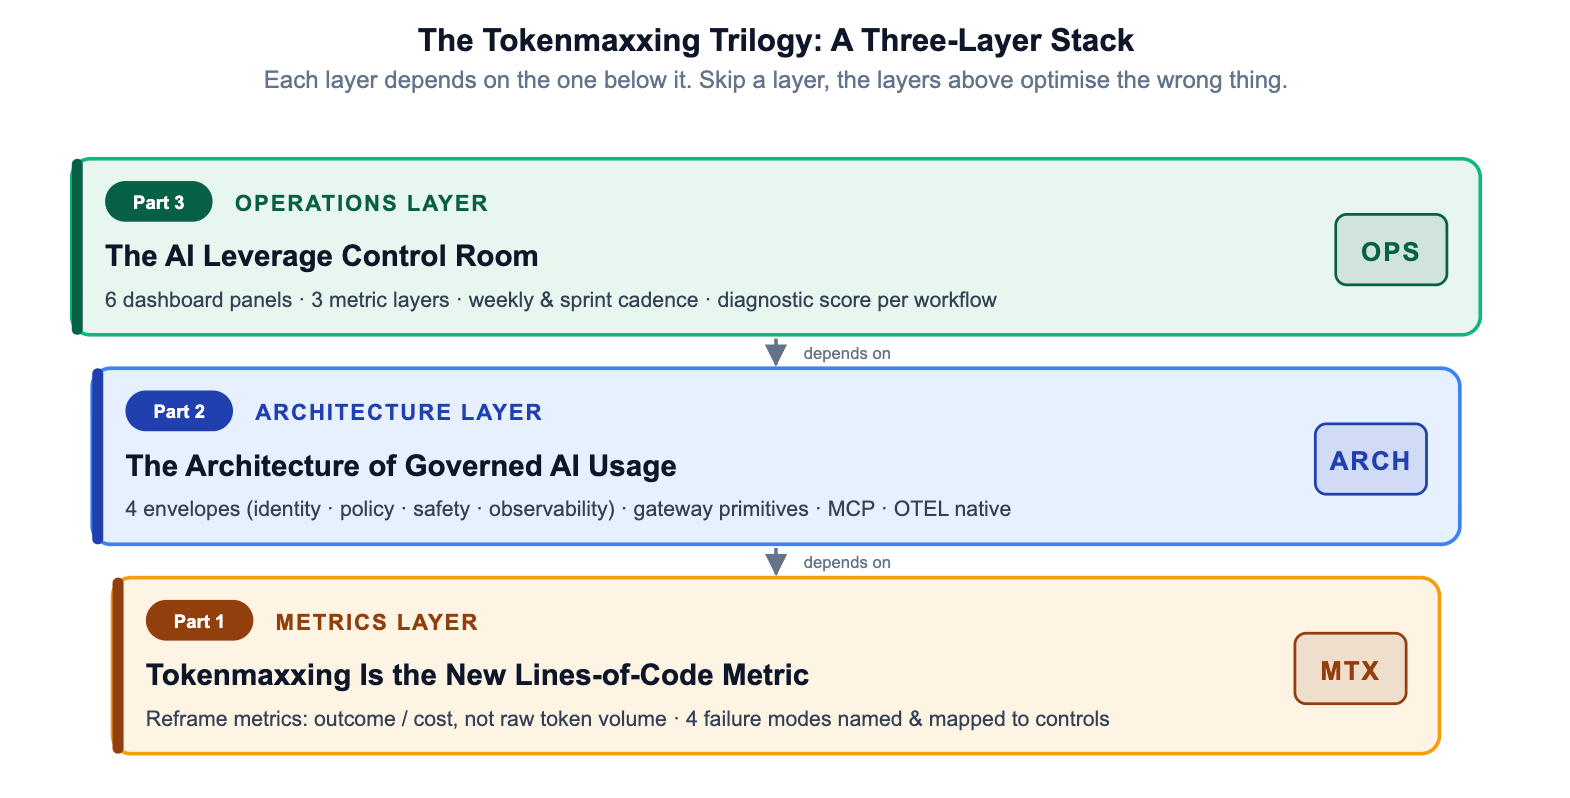
Organisationen, die bei Schicht 1 stehen bleiben, haben ein Narrativ, aber keine Durchsetzung. Diejenigen, die bei Schicht 2 aufhören, haben eine Durchsetzung, aber keine Feedbackschleife. Der Control Room schließt diesen Kreis – und macht die gesteuerte AI-Nutzung nicht zu einer reinen Compliance-Maßnahme, sondern zu einer operativen Disziplin, die sich im Laufe der Zeit auszahlt.
TrueFoundry AI Gateway bietet eine Latenz von ~3—4 ms, verarbeitet mehr als 350 RPS auf einer vCPU, skaliert problemlos horizontal und ist produktionsbereit, während LiteLM unter einer hohen Latenz leidet, mit moderaten RPS zu kämpfen hat, keine integrierte Skalierung hat und sich am besten für leichte Workloads oder Prototyp-Workloads eignet.





Die neuesten Nachrichten, Artikel und Ressourcen werden in Ihren Posteingang gesendet



















